
Guida all'uso
Ricette di prompt Vidu Q3 Ad reference-to-video: prompt pubblicitari pronti da copiare e clip reali
Quattro ricette pubblicitarie testate sul campo — rotazione hero del prodotto, mascotte del brand on-model, ripresa UGC a doppio riferimento e scena retail a triplo riferimento, ciascuna con una clip reale generata su q3-ad.
TL;DR
- Quattro ricette di prompt reference-to-video pronte da copiare per vidu-q3-ad/reference-to-video, ciascuna con una clip reale generata su hiapi — vere immagini di prodotto in input, vere clip pubblicitarie in output, nessun materiale stock.
- Q3 Ad è il livello di riferimento ottimizzato per la pubblicità di Vidu: fornisci 1–7 immagini di prodotto/soggetto più un prompt e lui renderizza una ripresa in stile pubblicitario da 3–15 secondi, a risoluzione 720p o 1080p (4K non supportato). È più economico e più veloce di Q4 Preview — la scelta predefinita sensata per annunci di prodotto e social.
- Le ricette sono organizzate per intento pubblicitario: rotazione hero di un singolo prodotto, mascotte del brand on-model, UGC a doppio riferimento con "prodotto in mano" e scena retail a triplo riferimento.
- Una trappola confermata dai test: nonostante il modello riporti l'etichetta "Native Audio", ogni mp4 che abbiamo ottenuto da
/v1/tasksè solo video (senza audio) — anche le clip di esempio della piattaforma sono mute. Dovrai aggiungere musica/voce in post-produzione. - Lo schema di input di q3-ad usa l'enum
size(nonaspect_ratio+resolution) e rifiutareference_audio_urls— a differenza di Q4. Copia il blocco JSON, sostituisci i tuoi URL di riferimento, fai POST su/v1/tasks.
Cosa fa realmente vidu-q3-ad/reference-to-video
Vidu Q3 Ad (di Shengshu Technology) è il livello pubblicitario della linea reference-to-video di Vidu. "Reference-to-video" significa che fornisci un set di immagini fisse — un prodotto, un personaggio, un oggetto di scena, una superficie — e il modello le compone e le anima in una ripresa in movimento. Il campo corrispondente è reference_image_urls, che accetta 1–7 immagini.
Il posizionamento "Ad" è proprio il punto: è ottimizzato per rotazioni di prodotto, mascotte coerenti nel soggetto e scene lifestyle, non per la narrazione cinematografica generica. Se hai letto le nostre ricette reference-to-video di Vidu Q4 Preview, ecco le differenze concrete emerse dai test:
| q3-ad (questa pagina) | q4-preview | |
|---|---|---|
| Immagini di riferimento | 1–7 | 1–15 |
| Riferimenti voce/audio | Non supportati (reference_audio_urls viene rifiutato) |
Fino a 3 clip audio |
| Risoluzione massima | 1080p | 4K |
| Campo dimensione | enum size |
resolution + aspect_ratio |
| Durata clip | 3–15 secondi | 3–16 secondi |
| Ideale per | Annunci di prodotto e social, con budget limitato | Riprese hero 4K premium, conduttori parlanti |
Quindi scegli q3-ad quando vuoi clip pubblicitarie pulite, coerenti, economiche e in grandi volumi; passa a Q4 solo quando hai davvero bisogno di 4K o di riferimenti vocali. Se ti serve una durata fino a 16 secondi o un mix più impegnativo con più soggetti, esiste un modello affine, vidu-q3-mix/reference-to-video, anch'esso con budget di 1–7 immagini.
Schema di input confermato dai test (sonda live su /v1/tasks, ottobre 2026):
| Campo | Obbligatorio | Valori |
|---|---|---|
prompt |
Sì | Testo libero; riferisci ogni soggetto tramite indice |
reference_image_urls |
Sì | Array, 1–7 URL pubblici di immagini |
duration |
No | Intero 3–15 secondi (il default varia in base a size) |
size |
No | 1280*720 · 1280*960 · 1280*1280 · 960*1280 · 720*1280 (fascia 720) · 1920*1080 · 1920*1440 · 1808*1808 · 1440*1920 · 1080*1920 (fascia 1080) |
duration deve essere un intero (4.5 viene rifiutato con il messaggio "want integer"). Il modello non ha i campi aspect_ratio, resolution o reference_audio_urls — passarli restituisce 400 "additional properties not allowed", l'errore più comune quando si migra da una richiesta Q4.
Il prezzo è una tariffa fissa al secondo determinata dalla fascia di size (quindi una clip da 5 secondi costa il prezzo al secondo moltiplicato per 5). A ottobre 2026, su hiapi, le cinque dimensioni della fascia 720 vengono fatturate a $0.149/secondo e le cinque della fascia 1080 a $0.18/secondo; per i numeri in tempo reale vedi la pagina dei prezzi. Flusso di lavoro pratico: prima blocca il prompt su una dimensione della fascia 720, poi rieseguilo a 1080p per la versione definitiva — il prompt non cambia, cambia solo il moltiplicatore.
Come abbiamo eseguito questi esempi (così puoi riprodurli)
Ogni clip qui sotto è stata generata su hiapi tramite l'API a task asincrono. Il flusso è sempre lo stesso:
- Le immagini di riferimento devono essere raggiungibili pubblicamente. Abbiamo generato le immagini con
gpt-image-2/text-to-image, le abbiamo caricate su un bucket statico e poi passato quegli URL — va bene qualsiasi immagine ospitata. - Esegui
POST /v1/taskscon il body della richiesta mostrato in ogni ricetta. - Esegui polling su
GET /v1/tasks/{taskId}finchéstatusnon diventasuccess, poi scaricaoutput[0].url(è un link a scadenza — salvalo subito).
La configurazione completa è nella guida rapida di hiapi. Una richiesta minima è questa — nota size, non aspect_ratio/resolution:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q3-ad/reference-to-video",
    "input": {
      "prompt": "...",
      "reference_image_urls": ["https://.../product.jpg"],
      "duration": 4,
      "size": "1280*720"
    }
  }'
Ora passiamo alle ricette.
Ricetta 1 — Rotazione hero di un singolo prodotto
Ideale per: l'annuncio di prodotto di base più comune — trasformare una singola immagine fissa e pulita del prodotto in una ripresa hero in rotazione con una striscia di luce che la attraversa. Inizia da qui.
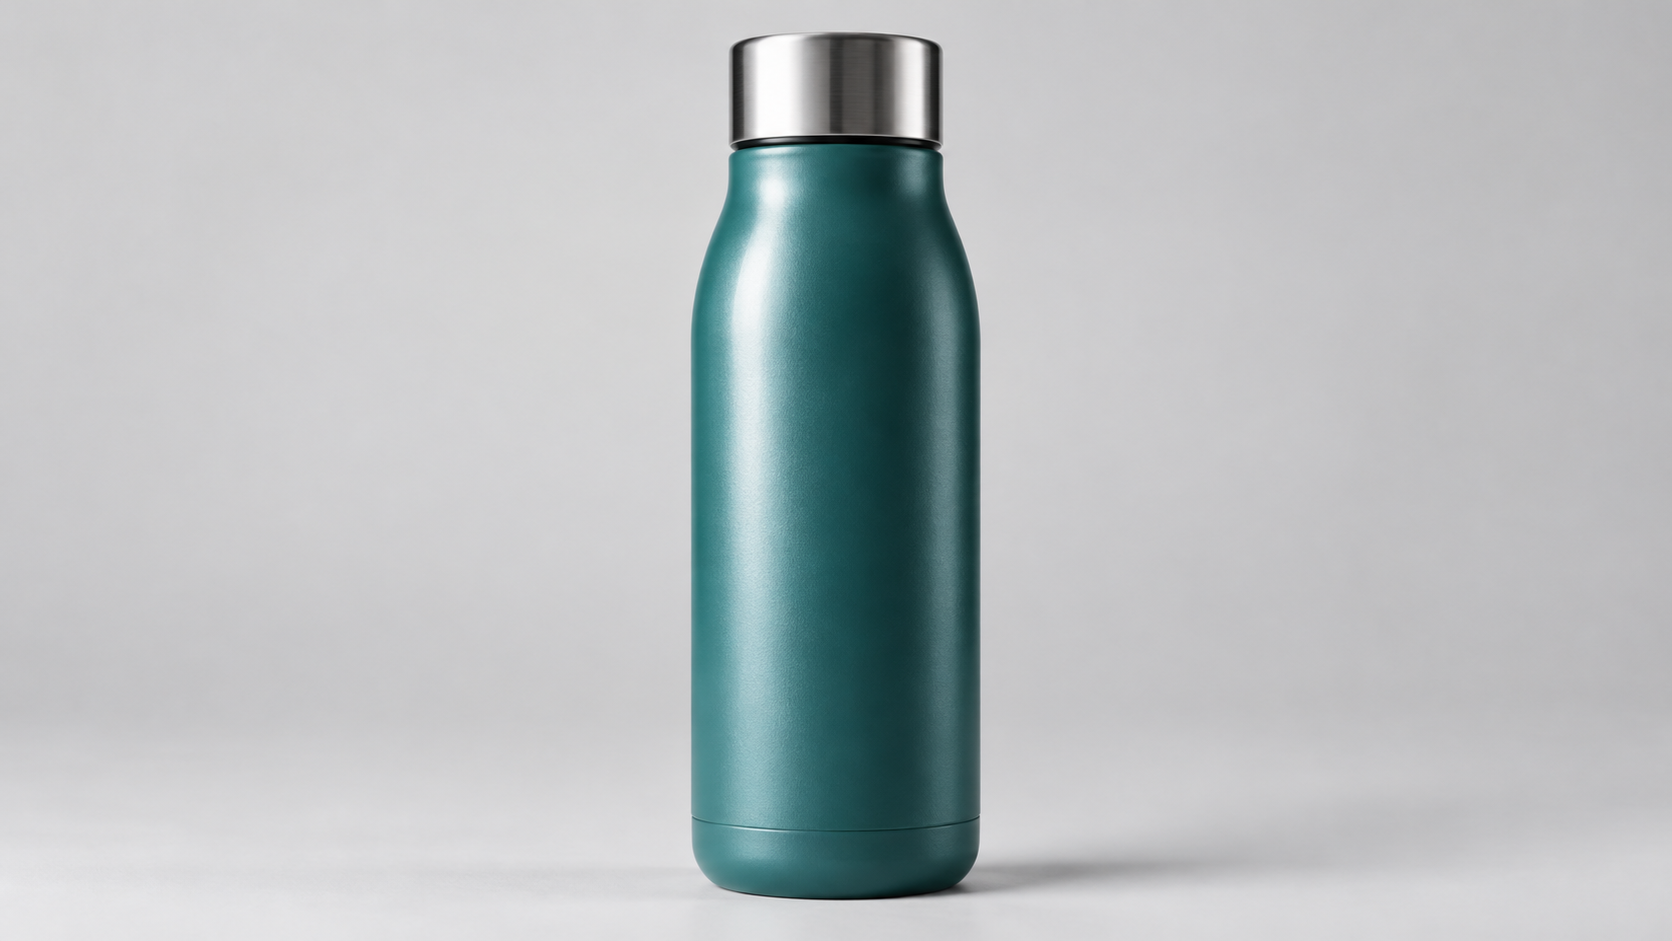
Immagine di riferimento in input:
Output reale (720p, 4 secondi):
{
  "model": "vidu-q3-ad/reference-to-video",
  "input": {
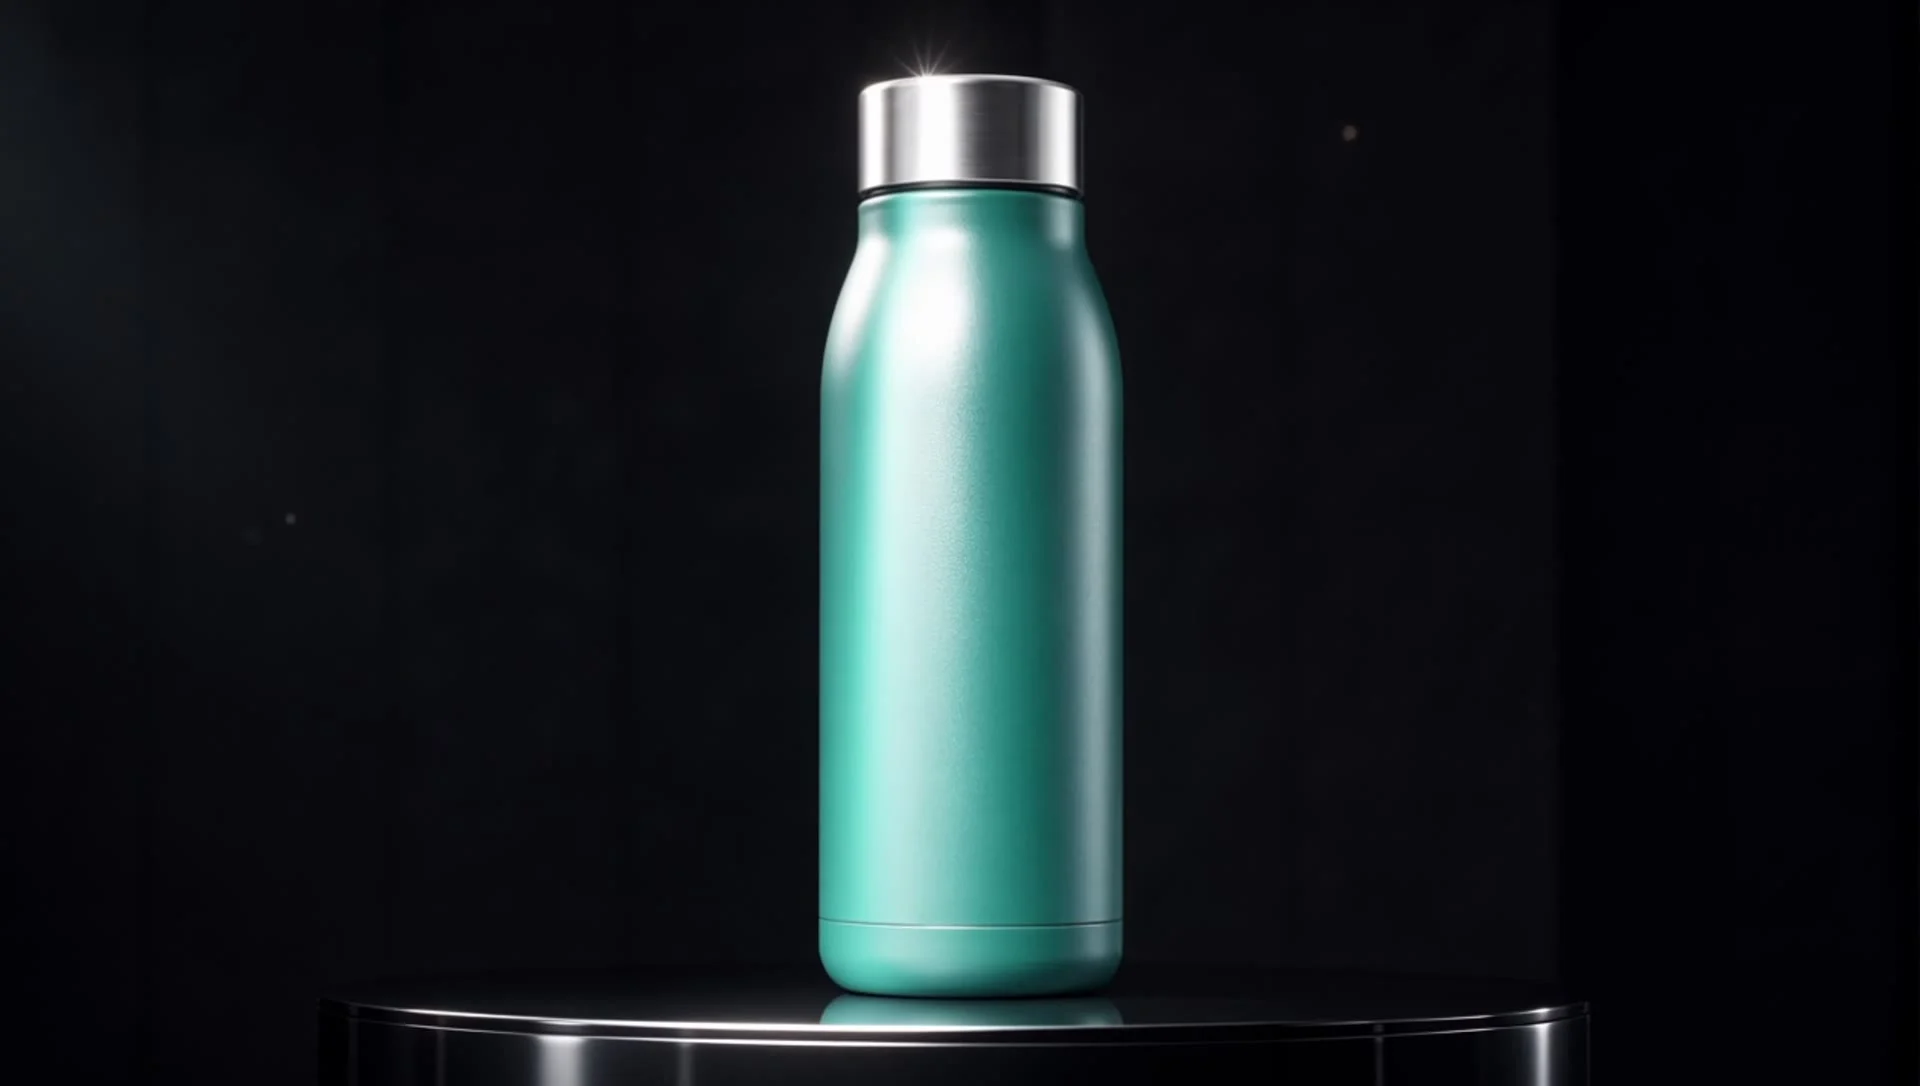
    "prompt": "Un annuncio premium del tumbler termico color ottanio opaco dell'immagine di riferimento 1. Ruota lentamente su un piedistallo scuro riflettente mentre una striscia di luce dura attraversa il corpo opaco da sinistra a destra, il coperchio in metallo spazzolato cattura un riflesso luminoso, soffici particelle di luce fluttuano sullo sfondo scuro, la camera mantiene un'angolazione hero bassa e si avvicina leggermente. Illuminazione da studio commerciale, alto contrasto, dettaglio macro.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/tumbler.jpg"],
    "duration": 4,
    "size": "1280*720"
  }
}
Perché funziona: nominare il soggetto — "il tumbler termico color ottanio opaco dell'immagine di riferimento 1" — ancora il prodotto esatto, così il modello anima quella bottiglia, inclusa la superficie opaca e il coperchio spazzolato, invece di inventarne una simile. La frase sulla striscia di luce ("una striscia di luce dura che attraversa ... da sinistra a destra") trasforma una semplice rotazione in qualcosa che sembra uno spot. Una singola intenzione di camera (rotazione + leggero avvicinamento) viene renderizzata in modo pulito in 4 secondi. A $0.149/secondo, questa clip costa circa $0.60.
Ricetta 2 — Mascotte del brand on-model
Ideale per: materiali di marketing ripetibili in cui il personaggio deve mantenere esattamente lo stesso aspetto in ogni clip — cosa che l'animazione disegnata a mano e il normale text-to-video faticano a fare.
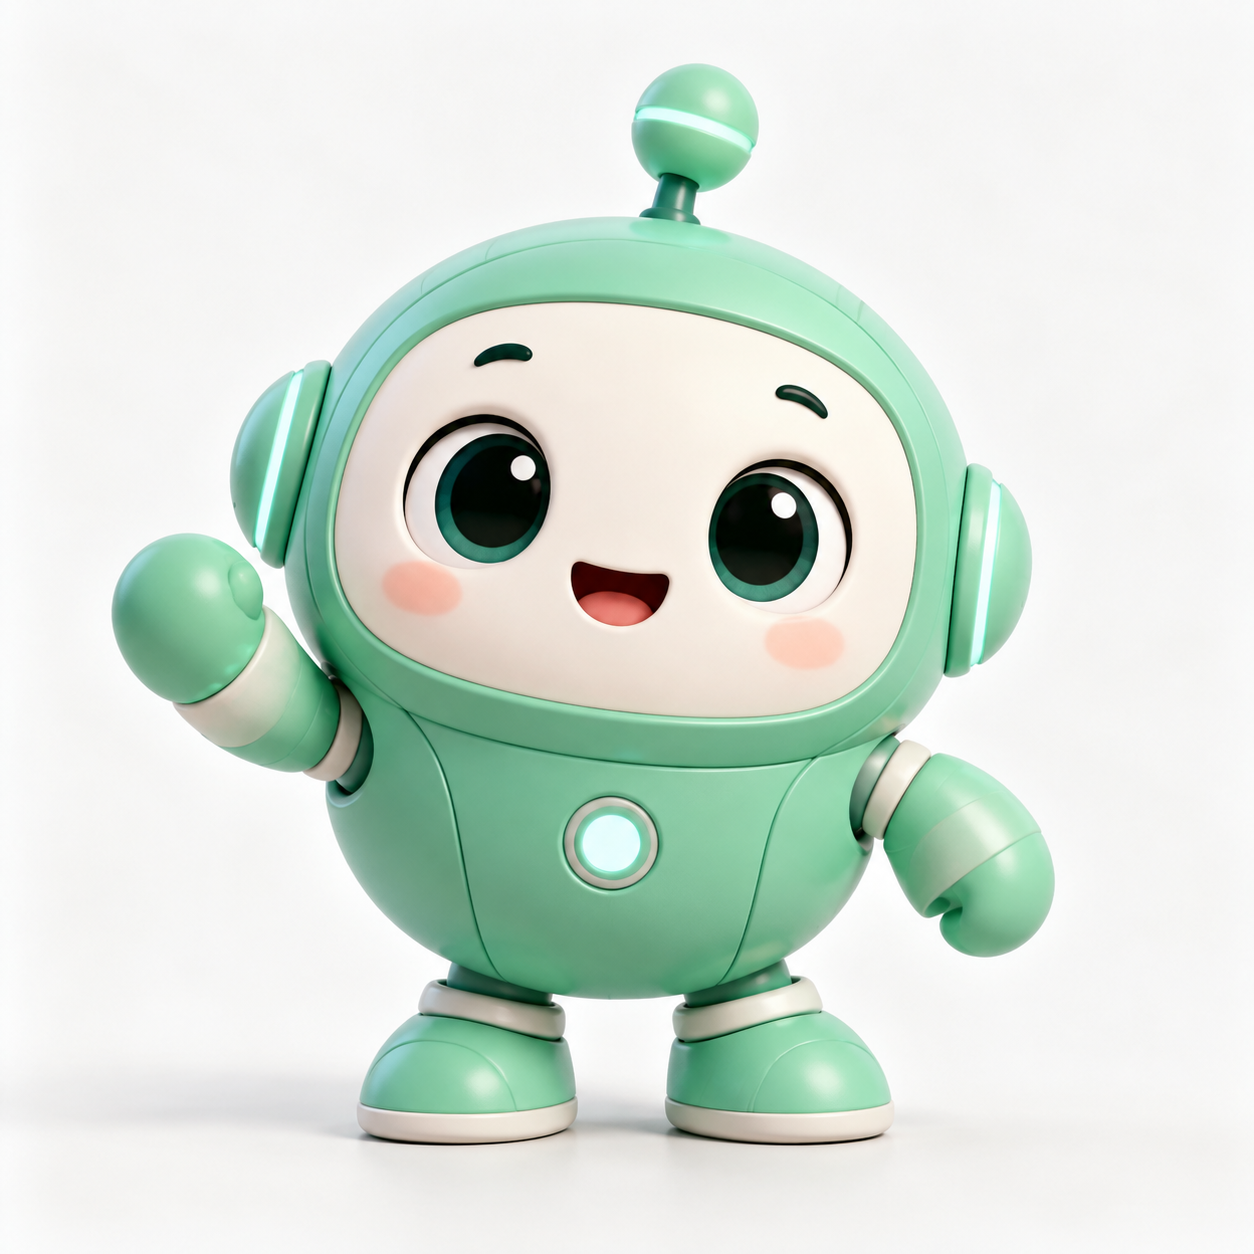
Immagine di riferimento in input:
Output reale (quadrato, 4 secondi):
{
  "model": "vidu-q3-ad/reference-to-video",
  "input": {
    "prompt": "La mascotte robot tonda verde menta dell'immagine di riferimento 1 sta al centro, saluta con la mano sinistra verso la camera, fa un piccolo salto allegro e un cenno gioioso col capo, poi alza il pollice. Sfondo da studio bianco pulito e morbido, illuminazione luminosa e uniforme, animazione elastica e rimbalzante, la sua forma, i colori e il viso restano esattamente on-model per tutto il tempo. Annuncio di mascotte di brand allegro e amichevole.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/mascot.jpg"],
    "duration": 4,
    "size": "1280*1280"
  }
}
Perché funziona: la frase "la sua forma, i colori e il viso restano esattamente on-model per tutto il tempo" dice al modello che il suo compito è la coerenza, non la reinterpretazione — q3-ad mantiene proporzioni, antenne e viso della mascotte durante tutto il movimento. Concatena diversi gesti semplici e nominabili ("saluta... salta... annuisce... pollice in su") invece di un vago "più vivace"; così il modello ha contenuti concreti da associare a ogni battuta. Usiamo il quadrato 1280*1280 (sempre fascia 720, circa $0.60 per 4 secondi), così il materiale si adatta direttamente a un post in feed o a una schermata di avvio di un'app.
Ricetta 3 — UGC "prodotto in mano" (doppio riferimento)
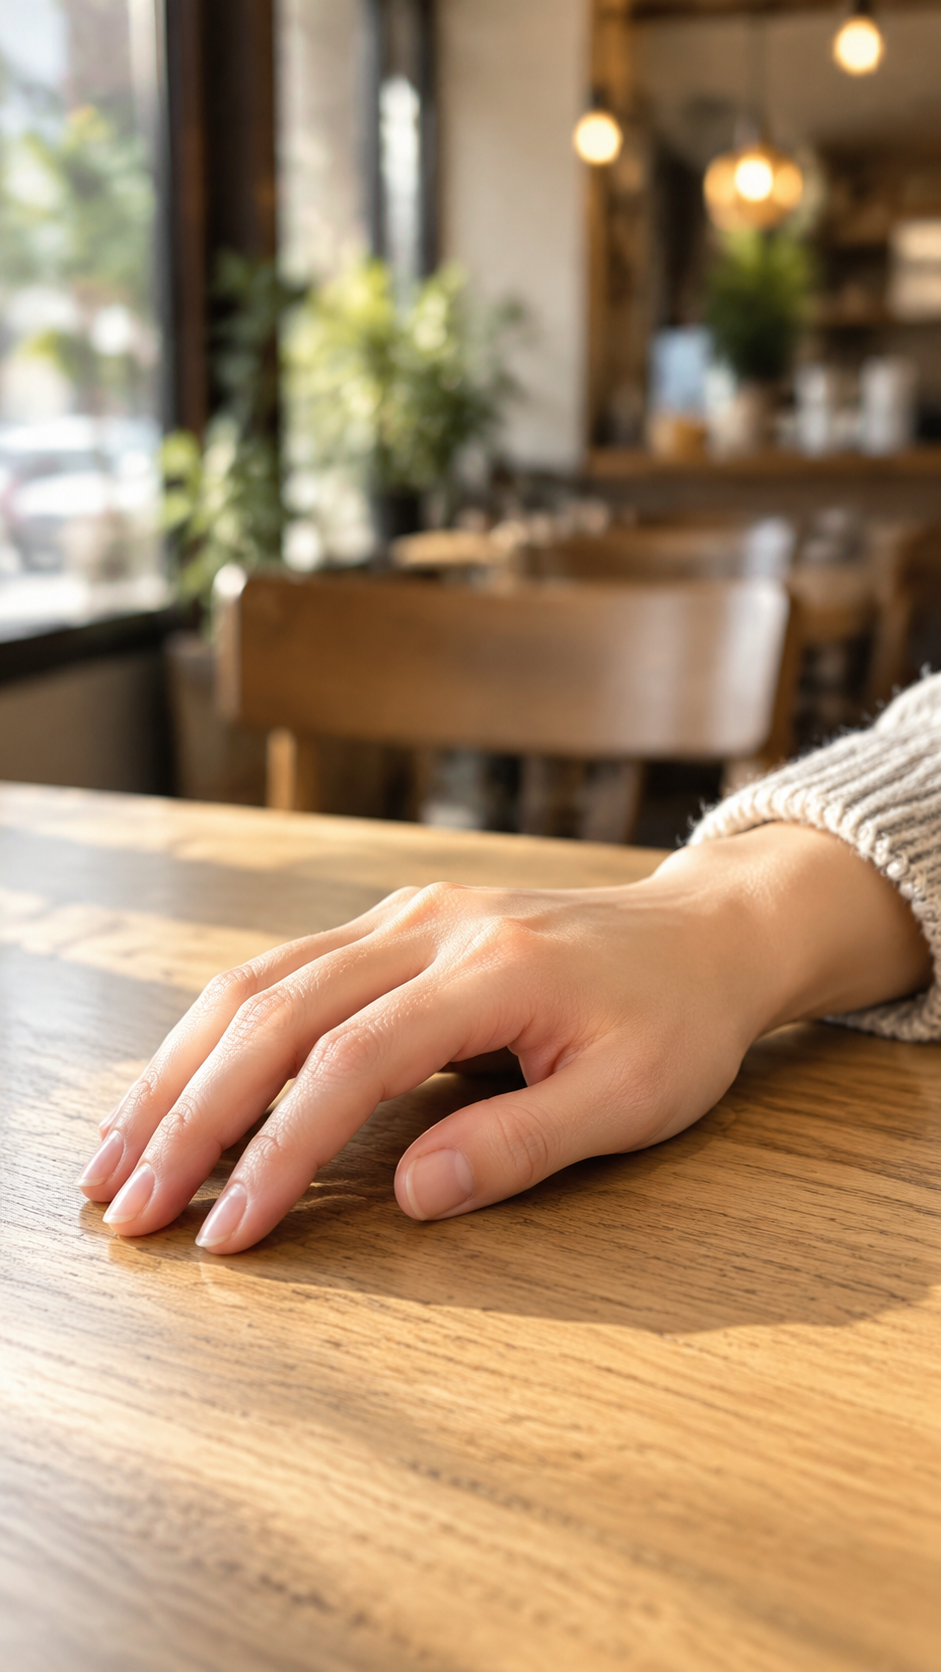
Ideale per: annunci social che fermano lo scroll — una mano vera che solleva il prodotto in scena, in un contesto reale. È qui che il reference-to-video batte l'image-to-video: combini due immagini fisse separate in un'unica ripresa.
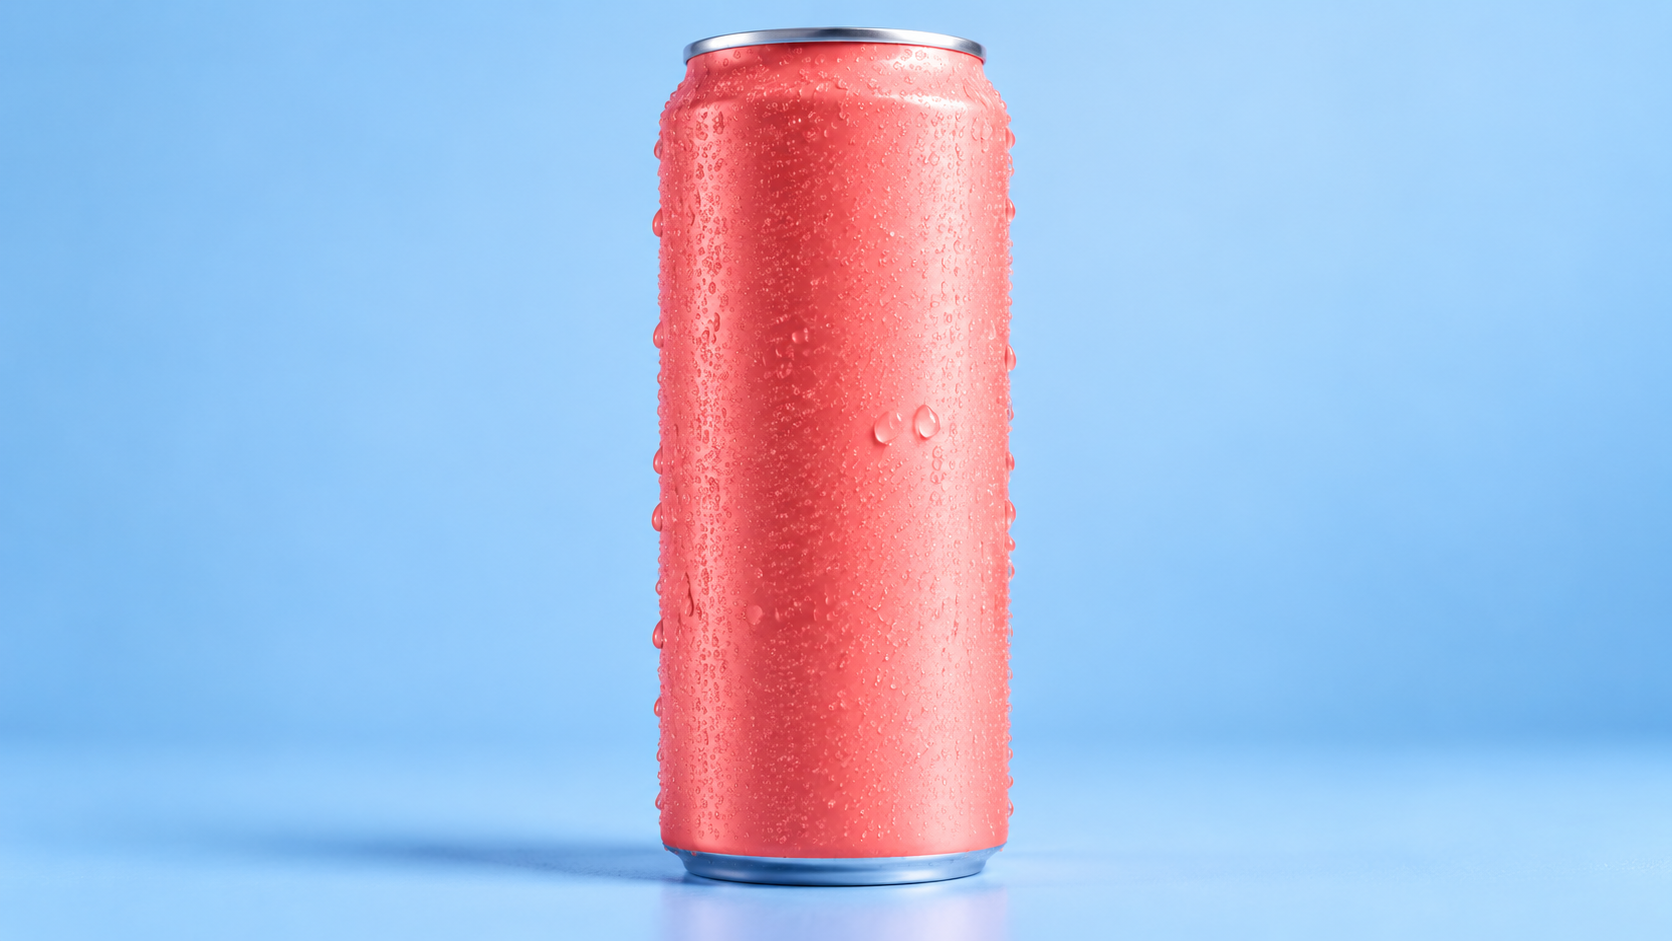
Immagini di riferimento in input (prodotto + scena):
Output reale (verticale 9:16, 5 secondi):
{
  "model": "vidu-q3-ad/reference-to-video",
  "input": {
    "prompt": "Clip pubblicitaria social verticale: sul tavolo da caffè in legno dell'immagine di riferimento 2, la lattina di acqua frizzante rosa corallo dell'immagine di riferimento 1 sta in piedi con fresca condensa fredda. Una mano entra dal fondo dell'inquadratura, afferra la lattina e la solleva verso la camera, con gocce d'acqua che brillano. Movimento naturale a mano libera, bokeh caldo del caffè sullo sfondo, luce morbida dalla finestra, vivace e autentica atmosfera da spot UGC.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/can.jpg", "https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/hand_cafe.jpg"],
    "duration": 5,
    "size": "720*1280"
  }
}
Perché funziona: ogni immagine di riferimento ha un ruolo — l'immagine 1 è il prodotto, l'immagine 2 è l'ambiente — così il modello sa quale fotogramma è il protagonista e quale lo sfondo. Descrivere esplicitamente l'azione e la camera ("una mano entra dal fondo ... la solleva verso la camera ... movimento naturale a mano libera") è ciò che crea la sensazione UGC; altrimenti ottieni una natura morta statica del prodotto sul tavolo. Il formato verticale 720*1280 per 5 secondi (circa $0.75) ti dà un formato Reels/TikTok/Shorts pronto da pubblicare.
Ricetta 4 — Scena retail multi-riferimento (triplo riferimento)
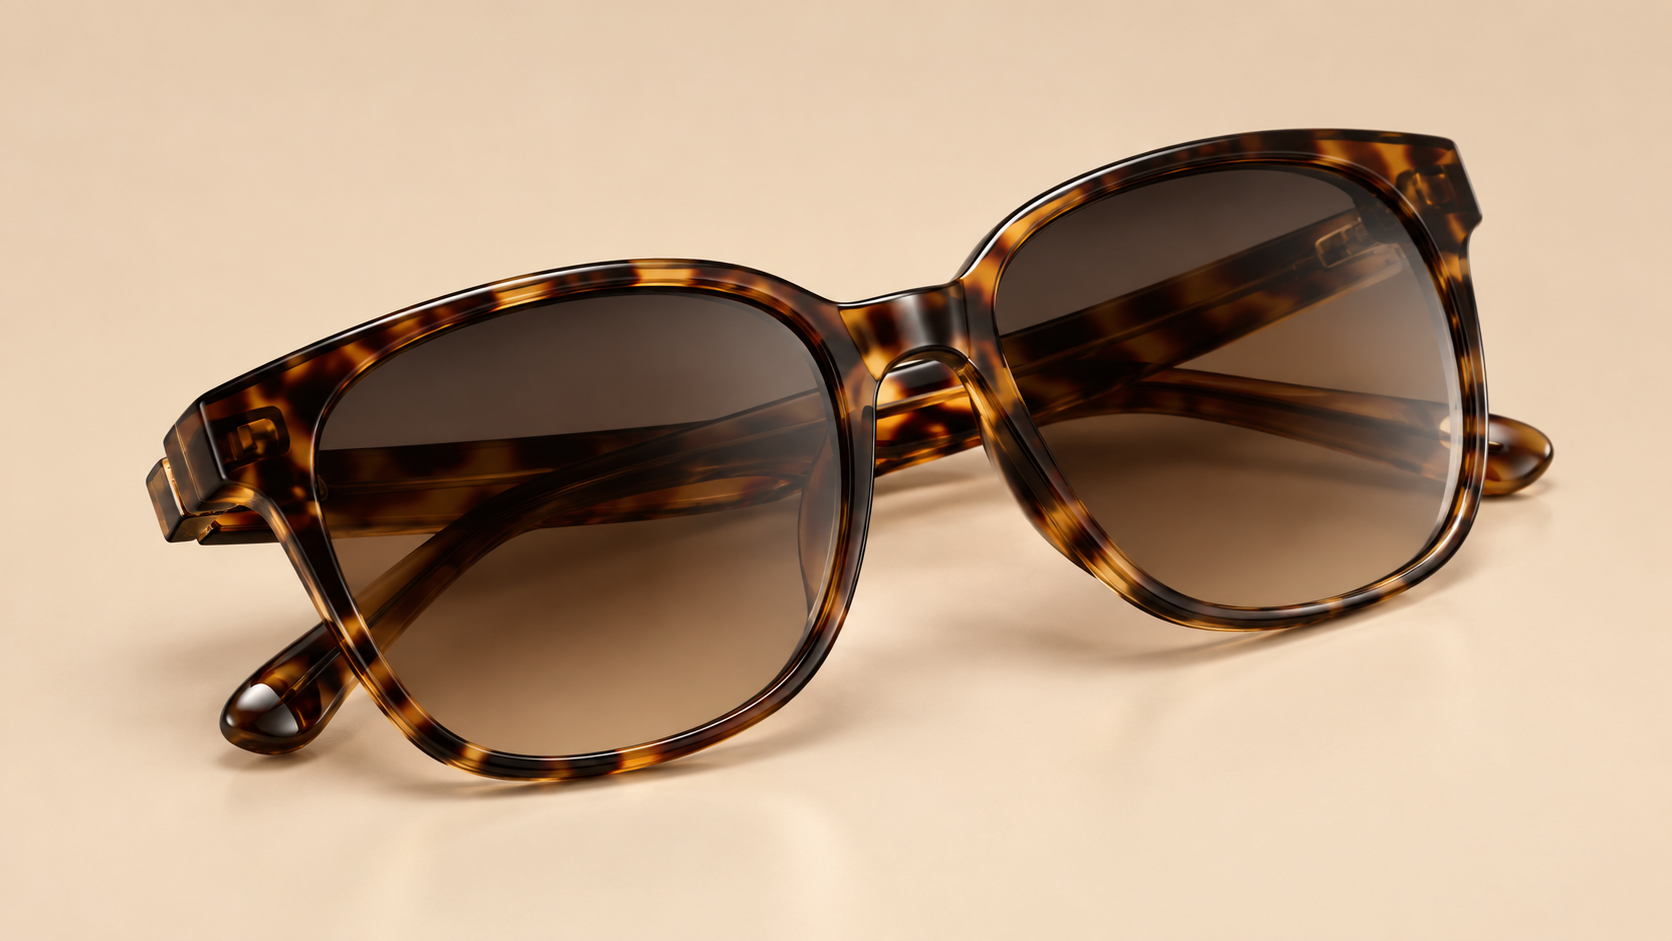
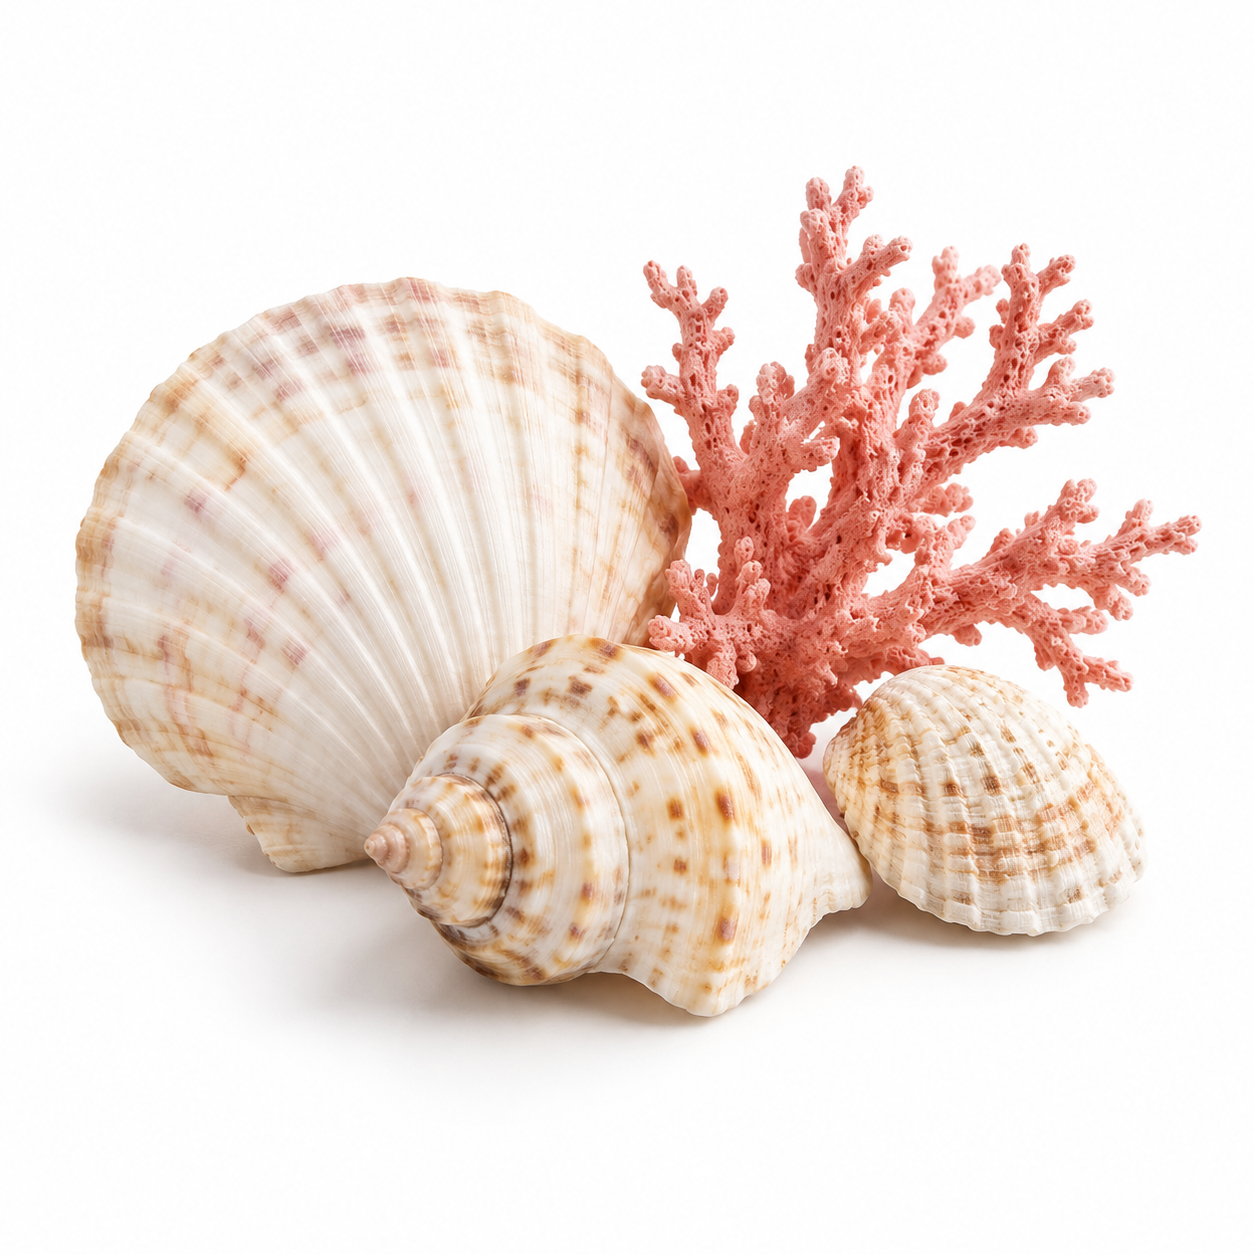
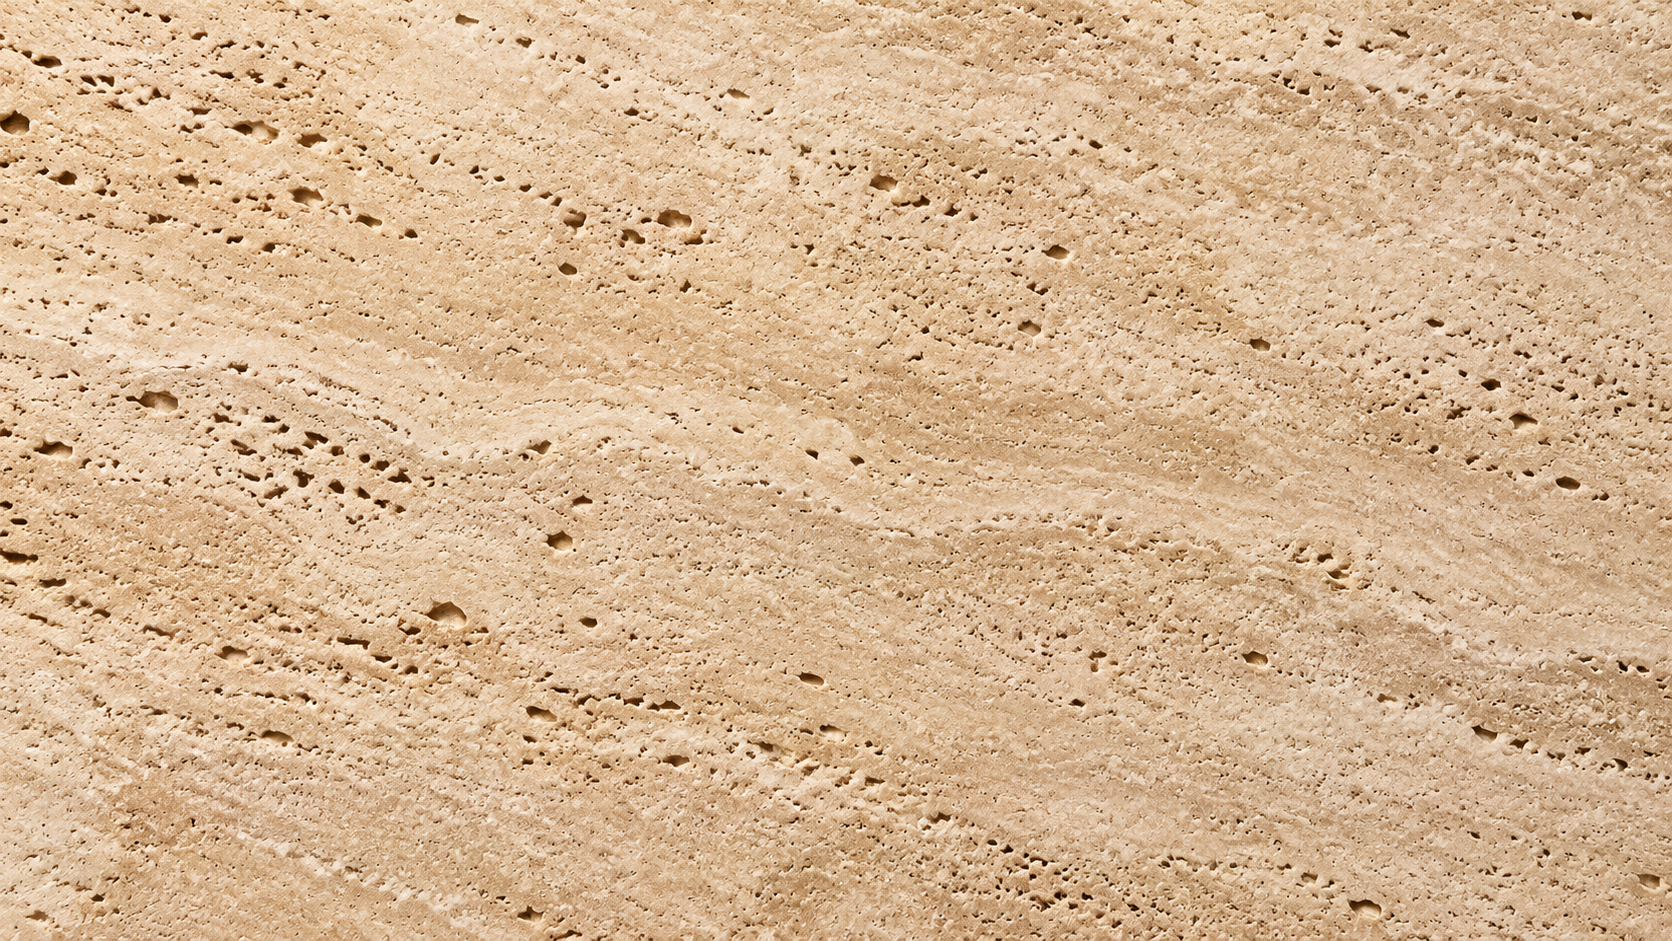
Ideale per: composizioni da catalogo e lifestyle assemblate da immagini fisse separate di prodotti e oggetti di scena — il tipo di still life che è scomodo allestire fisicamente.
Immagini di riferimento in input (prodotto + oggetti di scena + superficie):
Output reale (1080p, 4 secondi):
{
  "model": "vidu-q3-ad/reference-to-video",
  "input": {
    "prompt": "Componi una luminosa scena pubblicitaria retail estiva: posiziona gli occhiali da sole tartarugati dell'immagine di riferimento 1 aperti sulla calda superficie in travertino dell'immagine di riferimento 3, con le conchiglie e il corallo essiccato dell'immagine di riferimento 2 disposti ordinatamente accanto. Lento push-in cinematografico, luce solare naturale e luminosa che proietta ombre morbide in movimento, una leggera brezza, look da spot premium di occhialeria, profondità di campo ridotta.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/sunglasses.jpg", "https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/seashells.jpg", "https://static.hiapi.ai/blog/vidu-q3-ad-reference-to-video-prompt-recipes/refs/travertine.jpg"],
    "duration": 4,
    "size": "1920*1080"
  }
}
Perché funziona: tre immagini fisse pulite e isolate — ogni soggetto su uno sfondo a tinta unita — danno al modello componenti chiari e non ambigui da assemblare. Il prompt specifica esplicitamente la disposizione spaziale ("sul travertino ... accanto a loro") e nomina ogni immagine con l'indice esatto; quando le immagini di riferimento sono disordinate o ti limiti a dire "combina queste", la fusione tende a sballare. È anche qui che usi la fascia 1080 — a $0.18/secondo, una ripresa da 4 secondi costa circa $0.72, e poiché hai già verificato che la composizione funziona, paghi il supplemento solo per la risoluzione. q3-ad accetta fino a 7 immagini di riferimento, quindi hai margine per aggiungere un secondo oggetto di scena o una card con il logo alla stessa scena.
La verità su "Native Audio" (da leggere prima di pubblicare)
La pagina del modello q3-ad riporta l'etichetta "Native Audio" e pubblicizza i video pubblicitari come dotati di "montaggio intelligente, movimento di camera e suono". In realtà, ogni clip che abbiamo generato per questa pagina è risultata un mp4 solo video, senza traccia audio — l'abbiamo verificato con ffprobe, e anche le clip di esempio fornite dalla piattaforma per questo modello sono mute.
Quindi per ora considera q3-ad un generatore di video pubblicitari senza audio: tutte e quattro le clip qui sopra richiedono l'aggiunta di musica di sottofondo o voce in post-produzione. Per la maggior parte degli annunci di prodotto e social non è un ostacolo (probabilmente avresti comunque aggiunto musica con licenza), ma significa che non puoi affidarti al modello per produrre un mix finito, e non esiste un campo reference_audio_urls per fornire la voce. Se ti serve un conduttore che parla con sincronizzazione labiale, quello è il lavoro di Q4 Preview — vedi le ricette con riferimento vocale lì.
Le regole dei prompt che incidono davvero sull'output
- Numera le immagini di riferimento. "La lattina dell'immagine di riferimento 1 ... sul tavolo dell'immagine di riferimento 2" lega i soggetti agli indici in modo molto più affidabile di "la lattina e il tavolo".
- Assegna un ruolo a ogni immagine fissa nelle riprese multi-riferimento — protagonista vs sfondo vs superficie — e specifica la disposizione spaziale ("sopra", "accanto a", "dietro").
- Descrivi la camera come un unico movimento continuo (rotazione + avvicinamento, entrata + sollevamento). q3-ad renderizza una sola ripresa; impilare stacchi in un unico prompt lo confonde.
- Per le mascotte e i personaggi scrivi "esattamente on-model" per spingere il modello verso la coerenza invece della reinvenzione.
- Mantieni pulite le immagini fisse di riferimento — un soggetto, sfondo a tinta unita. Le immagini di riferimento disordinate sono la causa numero uno delle derive.
- Itera sulla fascia
size720, finalizza a 1080p. Il prompt è identico; cambia solo la tariffa al secondo.
Domande frequenti
Posso usare le foto del mio vero prodotto? Sì — qualsiasi URL di immagine accessibile pubblicamente può fare da riferimento. Abbiamo generato le immagini con gpt-image-2/text-to-image solo per rendere gli esempi riproducibili; le foto di prodotto ospitate sono in realtà ancora meglio, perché il soggetto è già esattamente ciò che vendi.
Quante immagini di riferimento posso passare? Da 1 a 7. Nove falliscono con un errore maxItems; per la rotazione hero una basta.
Perché la mia richiesta restituisce 400 "additional properties not allowed"? Quasi certamente hai inviato aspect_ratio, resolution o reference_audio_urls. q3-ad usa un singolo enum size e non ha input audio — rimuovi quei campi.
Restituisce 4K? No. q3-ad arriva al massimo a 1080p. Se ti serve il 4K usa Vidu Q4 Preview.
Quanto può essere lunga una clip? Da 3 a 15 secondi, come numero intero. I montaggi narrativi più lunghi si assemblano meglio da più riprese brevi.
Inizia a generare
Ottieni la tua chiave, copia qualsiasi ricetta qui sopra, sostituisci i tuoi URL di prodotto e fai POST su /v1/tasks. I dettagli del modello e i limiti in tempo reale sono nella pagina vidu-q3-ad/reference-to-video, il flusso di chiamata passo passo è nella guida rapida, e puoi esplorare il resto della linea video nel catalogo dei modelli. Convalida il prompt prima a 720p, poi riesegui il tuo preferito a 1080p — è tutto qui il flusso di lavoro.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori