
Black Forest Labs
FLUX.1 Schnell
flux-schnell/text-to-image
Modello di sintesi testo-immagine distillato di Black Forest Labs, transformer rectified flow da 12 miliardi di parametri, orientato alla generazione rapida di immagini a bassa latenza, adatto alla creazione in batch di concept art e bozze
Prova flux-schnell/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image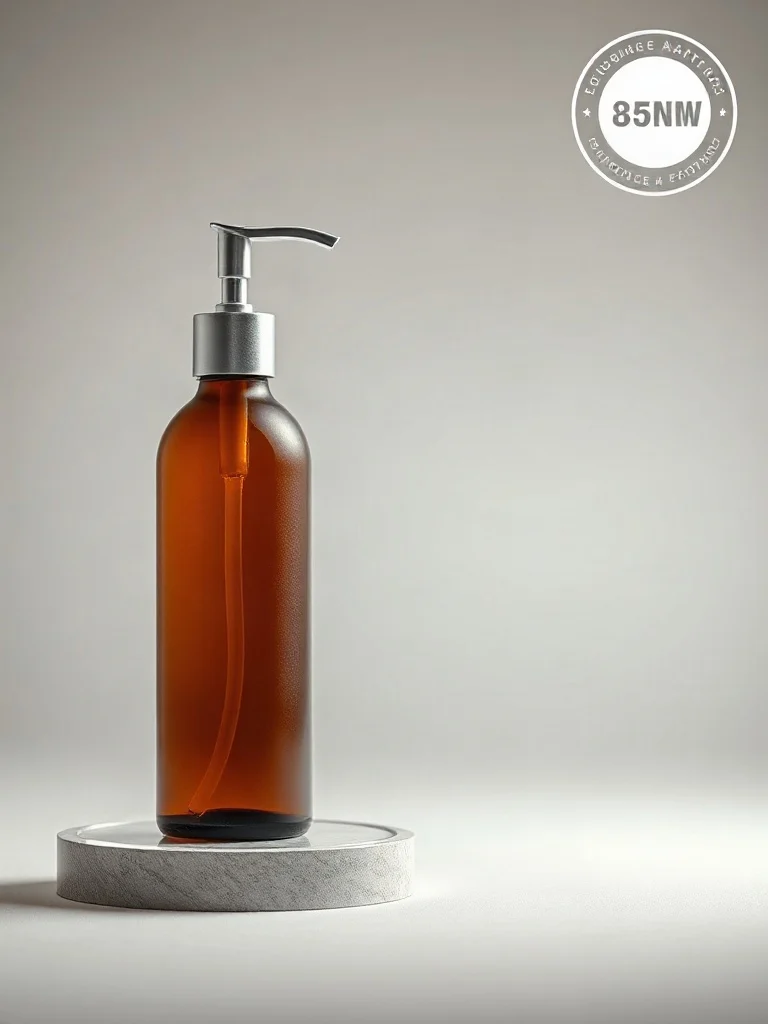
Qualità fotografica di prodotto di livello e-commerce con FLUX.1-schnell
Stile Immagine del prodotto · ecommerce-studio · Luce soffusa
Prompt
Fotografia di prodotto in studio, un flacone con erogatore a pompa in vetro ambrato opaco, con collare in metallo spazzolato, posizionato leggermente a sinistra su uno sfondo continuo grigio chiaro, appoggiato su un discreto rialzo in acrilico. Un softbox in alto a sinistra funge da luce principale, una stretta luce a striscia sul lato destro sfiora il bordo destro creando un riflesso netto sul profilo, un diffusore dall'alto appiattisce i riflessi speculari sul metallo. Obiettivo equivalente 85mm, profondità di campo ridotta, fuoco sull'etichetta, sfumatura morbida verso lo sfondo, bilanciamento del bianco neutro, resa pulita da ritocco commerciale, ampio spazio negativo in alto a destra per il badge e-commerce, composizione 16:9.
Copia il prompt completo e adattalo alla tua generazione.
Tag
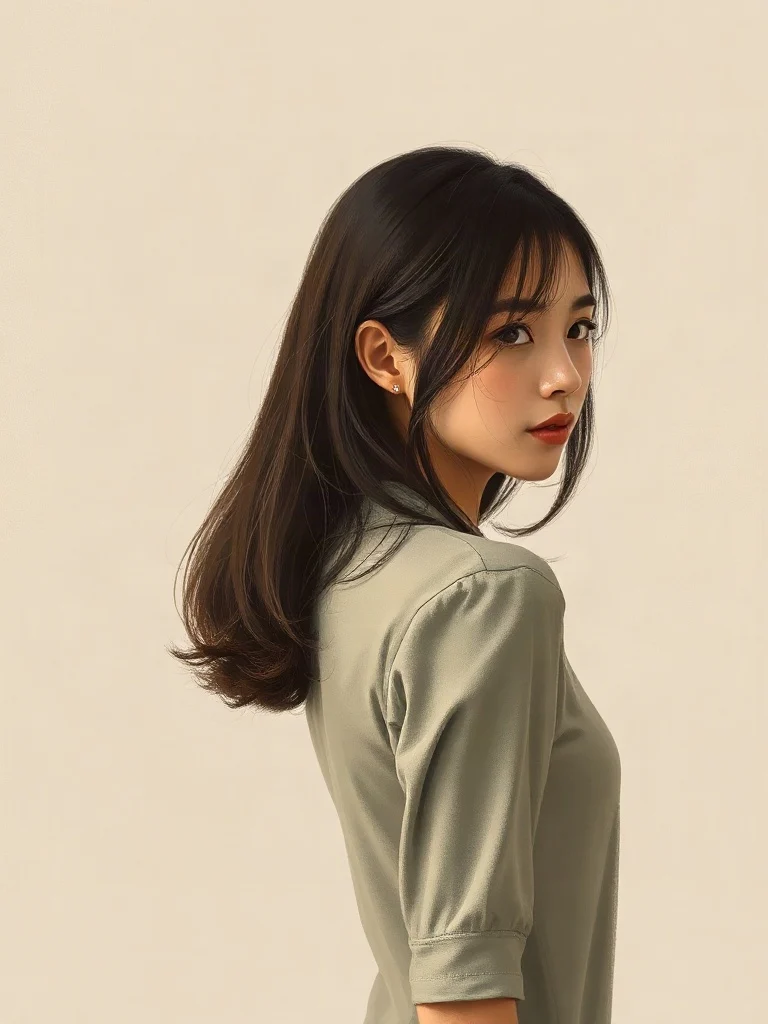
Spettro stilistico di FLUX.1-schnell: dal ritratto realistico a quello piatto di una ragazza
Stile Illustrazione · spettro-di-stile · ritratto-di-personaggio
Prompt
Ritratto a mezzo busto di una giovane donna di profilo che si volta a guardare indietro, morbida luce di finestra proveniente da sinistra, sfondo caldo grigio neutro. Reso in stile pittorico realistico: texture visibile delle pennellate, delicata trasparenza della pelle, capelli filo per filo, pieghe degli abiti con morbide transizioni d'ombra, tonalità naturali a bassa saturazione. Composizione 16:9, figura leggermente decentrata rispetto al centro dell'immagine, ampio spazio negativo a destra.
Copia il prompt completo e adattalo alla tua generazione.
Tag
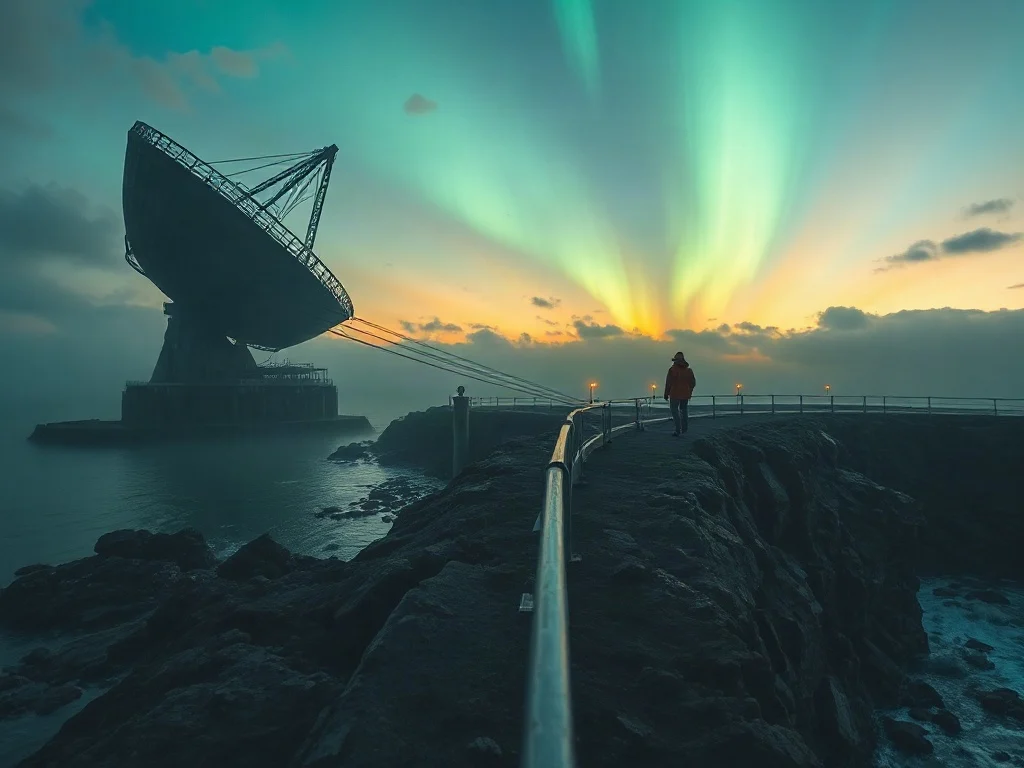
Concept art di scena worldbuilding con FLUX.1-schnell
Stile Concept art · Costruzione del mondo · Fantascienza
Prompt
Inquadratura ampia di establishing shot dal taglio cinematografico, al crepuscolo, una stazione di osservazione costiera abbandonata incastonata in una parete di roccia vulcanica, un'enorme antenna parabolica radio corrosa e mezza immersa in una pozza di marea, sottili cavi tesi tra tralicci di cemento, un'aurora in lontananza che insinua toni verde-violacei nelle basse nuvole temporalesche, basalto umido che riflette la luce calda delle lampade al sodio, una figura solitaria con una giacca di salvataggio arancione consumata dalle intemperie che cammina sul molo come riferimento di scala, strati di foschia atmosferica e schiuma marina, palette morbida verde acqua e ambra, luce di contorno fredda, raggi volumetrici sacri, architettura hard-surface ad alto dettaglio e texture rocciose organiche, concept art fotorealistica, resa da obiettivo anamorfico 35mm, profondità di campo ridotta sulla ringhiera in primo piano, composizione 16:9, orizzonte nel terzo inferiore dell'inquadratura
Copia il prompt completo e adattalo alla tua generazione.
Tag
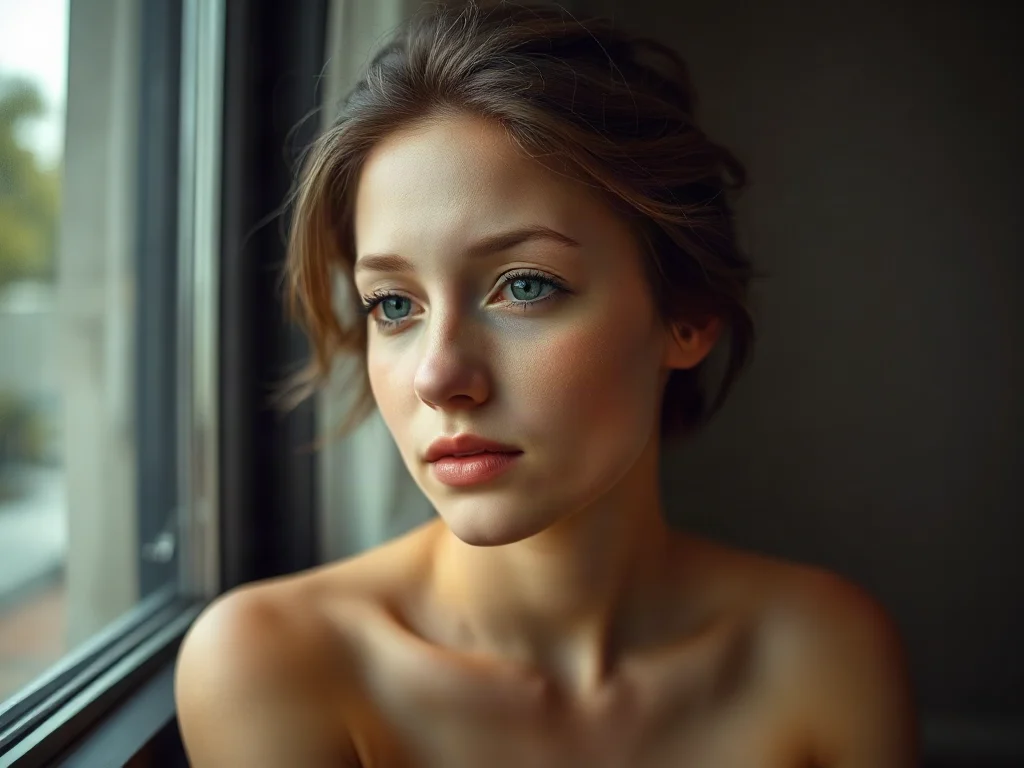
Demo di stili ritratto con FLUX.1-schnell: confronto tra realismo e resa artistica
Stile Ritratto e fotografia · Fotorealistico · Riferimento ai prompt
Prompt
Ritratto di una giovane donna seduta accanto a una grande finestra, vista di tre quarti, sguardo calmo verso l'obiettivo, texture della pelle naturale, pori visibili e capelli finemente definiti, luce diurna diffusa e morbida proveniente da sinistra, transizione graduale e soffice verso uno sfondo interno dai toni caldi e grigio attenuato, profondità di campo ridotta, resa da obiettivo 85mm, color grading stile Kodak Portra, grana sottile della pellicola, esposizione equilibrata, dettagli ricchi negli occhi e nelle labbra, nessuna ritocco pesante, composizione verticale 3:4, fotografia.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
flux-schnell/text-to-image per image
| Prezzo unitario | $0.005 |
|---|
Panoramica della posizione
FLUX.1-schnell è un modello text-to-image lanciato da Black Forest Labs, basato su un'architettura rectified flow transformer da 12 miliardi di parametri e ottimizzato tramite distillazione: genera immagini di alta qualità con un numero ridotto di passaggi di inferenza, offrendo un buon equilibrio tra aderenza ai prompt e resa dei dettagli. Il modello è richiamabile tramite l'interfaccia unificata di HiAPI.ai ed è adatto a sviluppatori e scenari di creazione di contenuti che necessitano di produrre rapidamente concept visivi e materiali grafici.
Punti di forza principali
- Architettura distillata, generazione rapida con pochi passaggi — la documentazione ufficiale consiglia da 1 a 4 passaggi di inferenza per completare la denoising e la generazione, ideale per scenari interattivi che richiedono tempi di risposta contenuti.
- Buon equilibrio tra aderenza ai prompt e resa dei dettagli — basato su un rectified flow transformer da 12 miliardi di parametri, offre buone prestazioni sia nei dettagli dell'immagine sia nell'allineamento con il prompt.
- Controllo flessibile di proporzioni e formato di output — supporta cinque rapporti d'aspetto (1:1, 4:3, 3:4, 16:9, 9:16) e output in jpeg o png, per adattarsi a diverse esigenze di impaginazione.
Descrizione delle capacità
Generazione di immagini da testo: basta inserire un prompt testuale per generare l'immagine corrispondente, ideale per trasformare rapidamente descrizioni creative in materiali visivi.
Regolazione dei passaggi di inferenza e del coefficiente di guida: è possibile impostare da 1 a 12 passaggi di inferenza (consigliati 1-4 dalla documentazione ufficiale) e un coefficiente di guida da 1 a 20, bilanciando velocità e aderenza al prompt in base alle esigenze.
Riproducibilità dei risultati tramite seed fisso: specificando un seed casuale è possibile riprodurre i risultati di generazione con gli stessi parametri, facilitando il debug e la coerenza nei task in batch.
Interruttore per il filtro di sicurezza dei contenuti: il controllo di sicurezza è attivo per impostazione predefinita e può essere disattivato all'occorrenza, per regolare con flessibilità le politiche sui contenuti in ambienti controllati.
Scenari d'uso
- Generazione rapida di schizzi concettuali da parte dei designer — inserendo descrizioni di scene o stili, si producono rapidamente più concept per la comunicazione creativa iniziale e la selezione delle direzioni.
- Sviluppo di applicazioni text-to-image da parte degli sviluppatori — integrando il modello nei flussi di lavoro del proprio prodotto, è possibile generare in tempo reale immagini di accompagnamento o materiali visivi in base agli input degli utenti.
- Generazione di immagini di accompagnamento per la creazione di contenuti — per articoli, social media e altri scenari, si generano in batch immagini con proporzioni e formati specificati, pronte per la pubblicazione.
Limiti e consigli per la scelta
Il modello supporta esclusivamente la generazione di immagini da testo e non copre altre modalità come video o testo. Essendo una versione distillata, in scenari con prompt complessi o requisiti di alta precisione i risultati potrebbero essere inferiori a quelli di modelli non distillati; l'output effettivo dipende dalla qualità del prompt, dai parametri di campionamento e dall'ambiente di esecuzione. Se sono necessarie capacità multimodali o una generazione di immagini di maggiore precisione, si consiglia di valutare altri modelli.
Domande frequenti
Vedi tutte le domande →-
Per quali attività è principalmente adatto FLUX.1 [schnell]?
Modello ultra-rapido e a basso costo con 1-4 passaggi, ideale per bozze, generazione di immagini in batch ed esplorazione rapida dei Prompt.
-
FLUX.1 [schnell] supporta immagini di riferimento?
La linea attuale è puramente text-to-image e non accetta immagini di riferimento.
-
Quali specifiche di output sono supportate?
La pagina attuale mostra 1-12 inference steps e 1:1, 16:9, 9:16, 4:3, 3:4; le opzioni finali sono soggette ai parametri del Playground.
-
Come viene fatturato FLUX.1 [schnell]?
La fatturazione si basa sul numero di immagini generate con successo; eventuali differenze tra risoluzioni o livelli di qualità sono mostrate nel prezzo in tempo reale sulla pagina.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: flux-schnell/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per flux-schnell/text-to-image e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionaleSeme casuale per riprodurre i risultati della generazione; passando lo stesso seme si ottiene un output coerente.
promptstringObbligatorioPrompt testuale utilizzato per la generazione dell'immagine.
aspect_ratiostringOpzionalePredefinito: "4:3"Proporzioni dell'immagine di output, predefinito 4:3.
1:14:33:416:99:16output_formatstringOpzionalePredefinito: "jpeg"Formato dell'immagine di output, predefinito jpeg.
jpegpngguidance_scalenumberOpzionalePredefinito: 3.5min 1max 20Controlla quanto il risultato generato aderisce al prompt, predefinito 3.5.
num_inference_stepsintegerOpzionalePredefinito: 4min 1max 12Numero di passi di denoising, predefinito 4; per il modello schnell si consiglia 1-4.
enable_safety_checkerbooleanOpzionalePredefinito: trueIndica se abilitare il filtro di sicurezza dei contenuti, predefinito true.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-schnell/text-to-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "4:3",
    "output_format": "jpeg",
    "guidance_scale": 3.5,
    "num_inference_steps": 4,
    "enable_safety_checker": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-schnell/text-to-image",
input: {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-schnell/text-to-image",
"input": {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 GPT Image 2.5 OpenAI $0.017 /immagine
-
 Seedream 4.5 ByteDance $0.045 /immagine
-
 Grok Imagine xAI $0.011 /secondo
-
 Muse Image 1.0 Meta $0.015 per task
-
 Google Virtual Try-On Google $0.107 /immagine
-
 Nano Banana Google $0.021 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 851 Labs Background Remover 851 Labs $0.002 /immagine
-
 Imagen 4 Google $0.030 /immagine
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /immagine
-
 BRIA Eraser Bria $0.058 /immagine
Stesso fornitore
-
 FLUX 3 Max Black Forest Labs $0.061 /secondo
-
 FLUX.2 Black Forest Labs $0.035 /immagine
-
 FLUX 3 Image Black Forest Labs $0.041 /immagine
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /immagine
-
 FLUX 3 Video Black Forest Labs $0.090 /secondo
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /immagine
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /immagine
- FLUX.1 Fill Pro Black Forest Labs $0.071 /immagine
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /immagine