
Meta
Muse Image 1.0
muse-image-1.0/image-to-image
Modello di generazione e modifica di immagini con ragionamento di Meta: scompone prima i prompt complessi e poi esegue il rendering, può integrare più immagini di riferimento e si avvale della ricerca web per garantire l'accuratezza fattuale
Prova muse-image-1.0/image-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image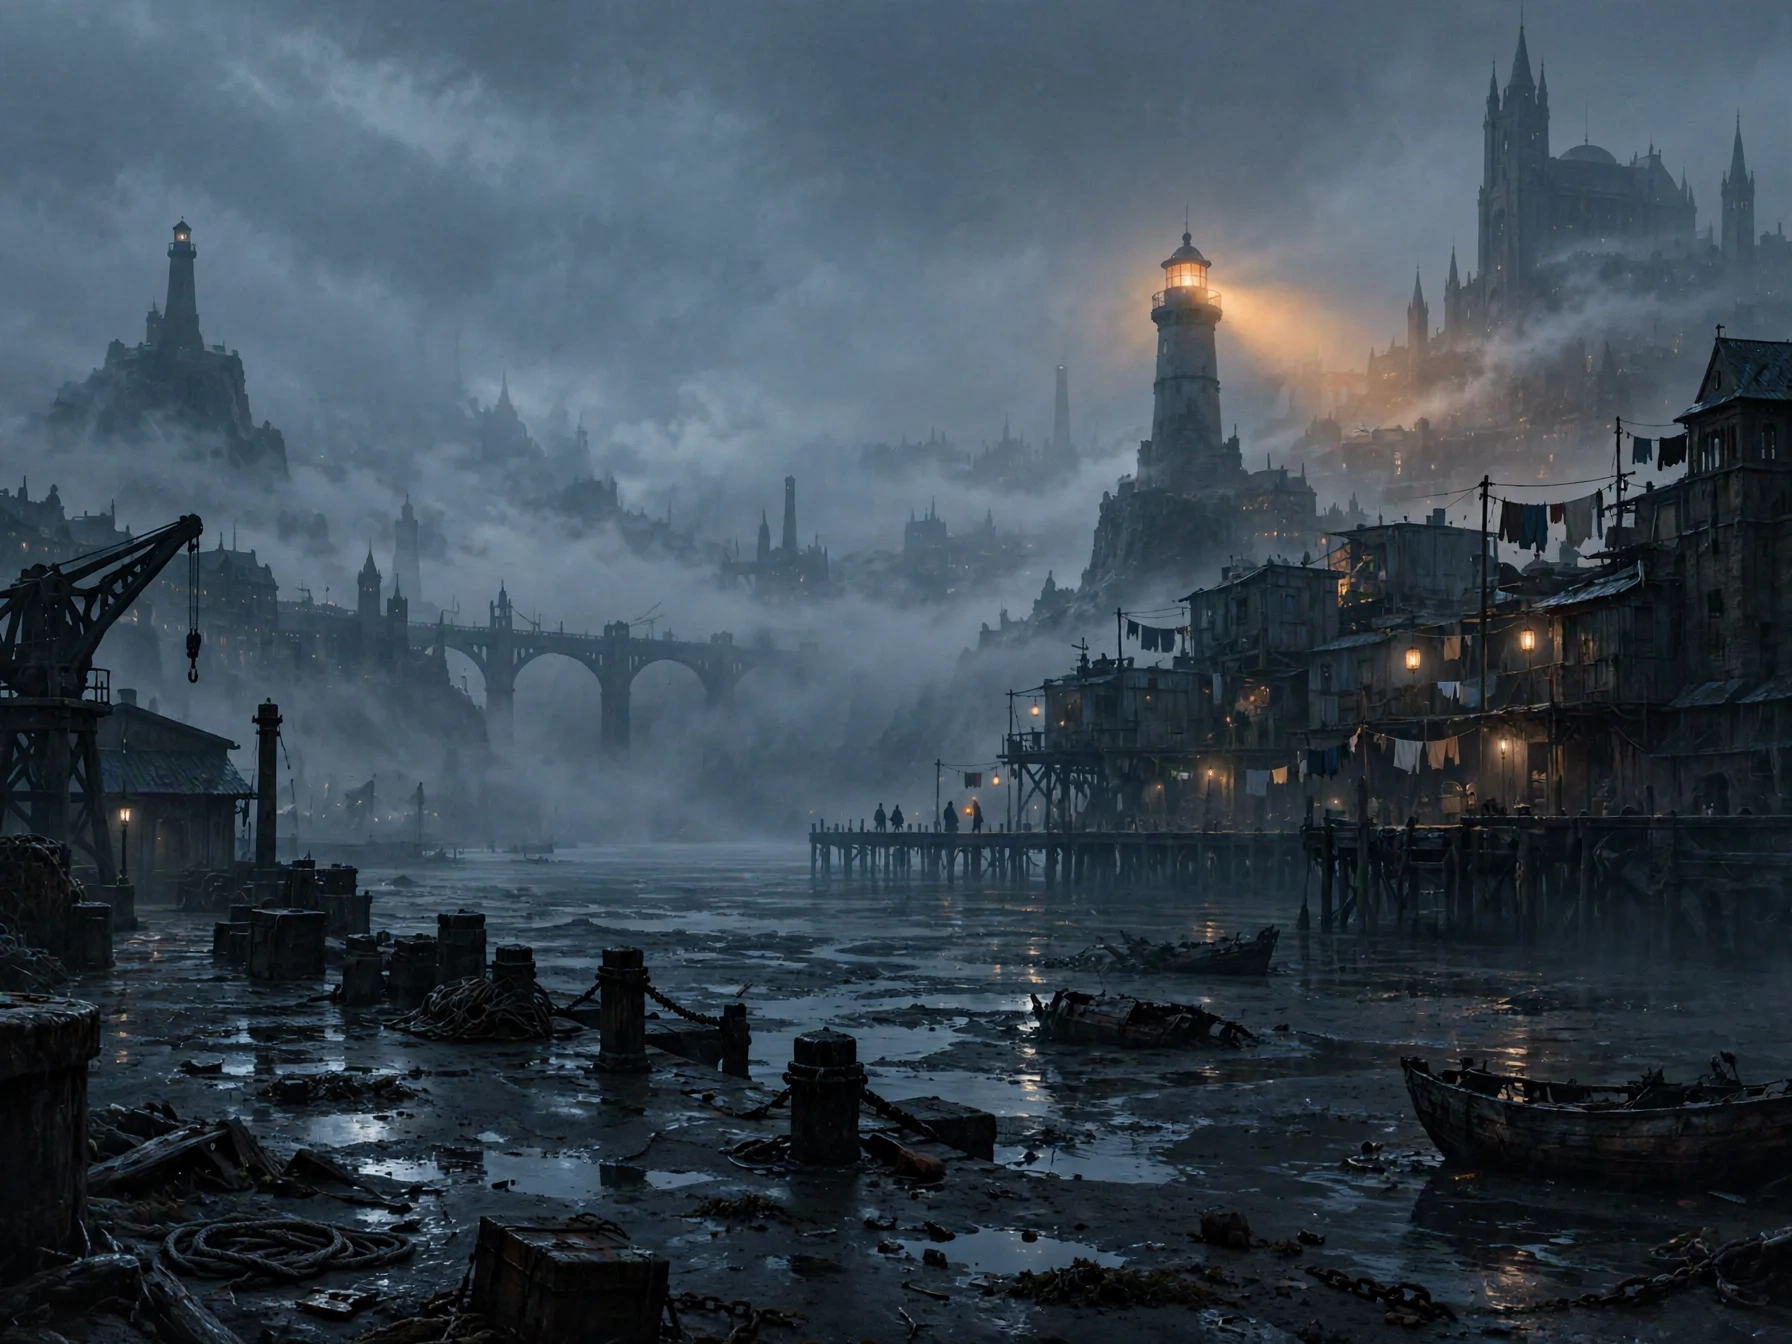
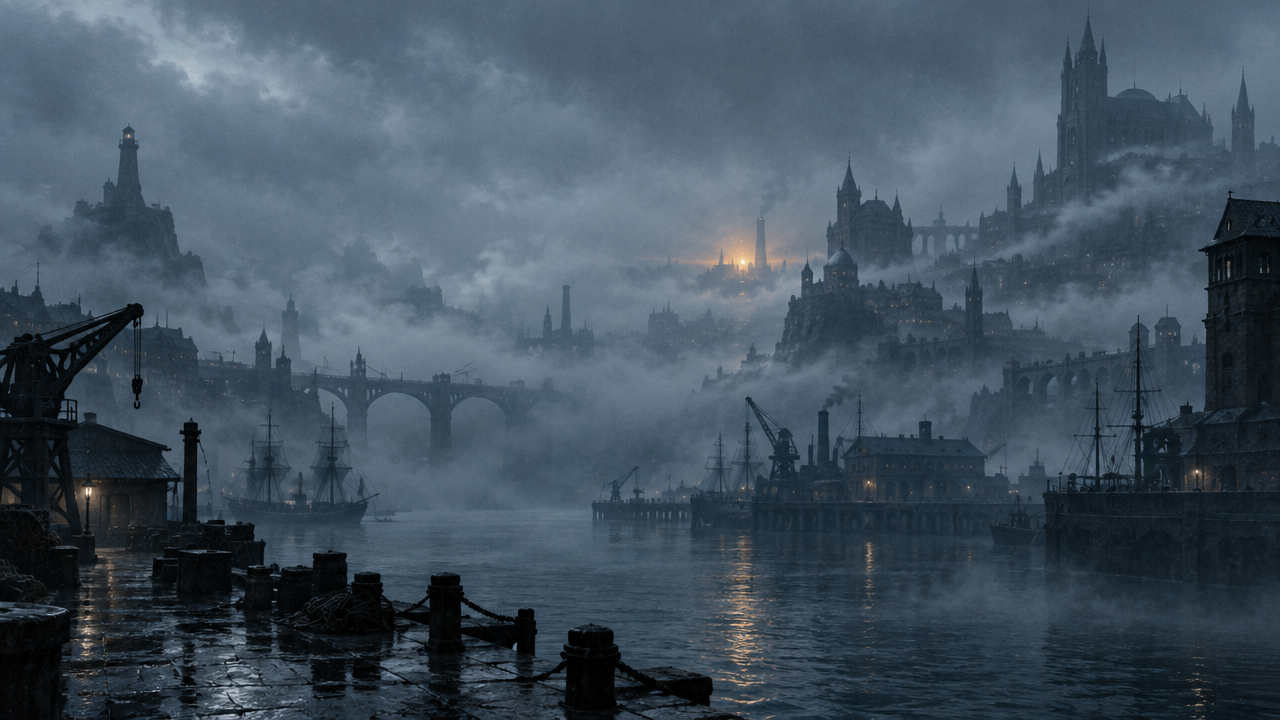
Concetto di worldbuilding: esplorazione atmosferica della Città della Marea di Cenere
Stile Concept art · Costruzione del mondo · Moodboard
Input di riferimento
image_urls
Prompt
Concept art cinematografica di una città costiera durante la bassa marea, composizione widescreen 16:9. Primo piano: strade di sabbia nera bagnata esposte dopo la bassa marea, con scafi e corde ricoperti di croste saline sparsi, sottili riflessi di luce lunare fredda. Piano medio: archi in acciaio incisi dal sale e abitazioni modulari stratificate costruite su palafitte, stendibiancheria e lanterne appese, alcune figure che camminano lungo una passerella di assi. Sfondo: un alto faro di marea, un debole fascio ambra che attraversa una fitta nebbia marina, un molo in rovina in lontananza che si dissolve nella foschia. Mantieni la tonalità blu-grigio fredda, la bassa saturazione e la densità della nebbia atmosferica dell'immagine di riferimento; lascia che i caldi accenti ambra si prolunghino sulle lanterne e sul fascio del faro. Luce volumetrica, grana morbida della pellicola, qualità pittorica da matte painting digitale, dettagli contenuti, contrasto morbido, senza testo, senza loghi.
Copia il prompt completo e adattalo alla tua generazione.
Tag
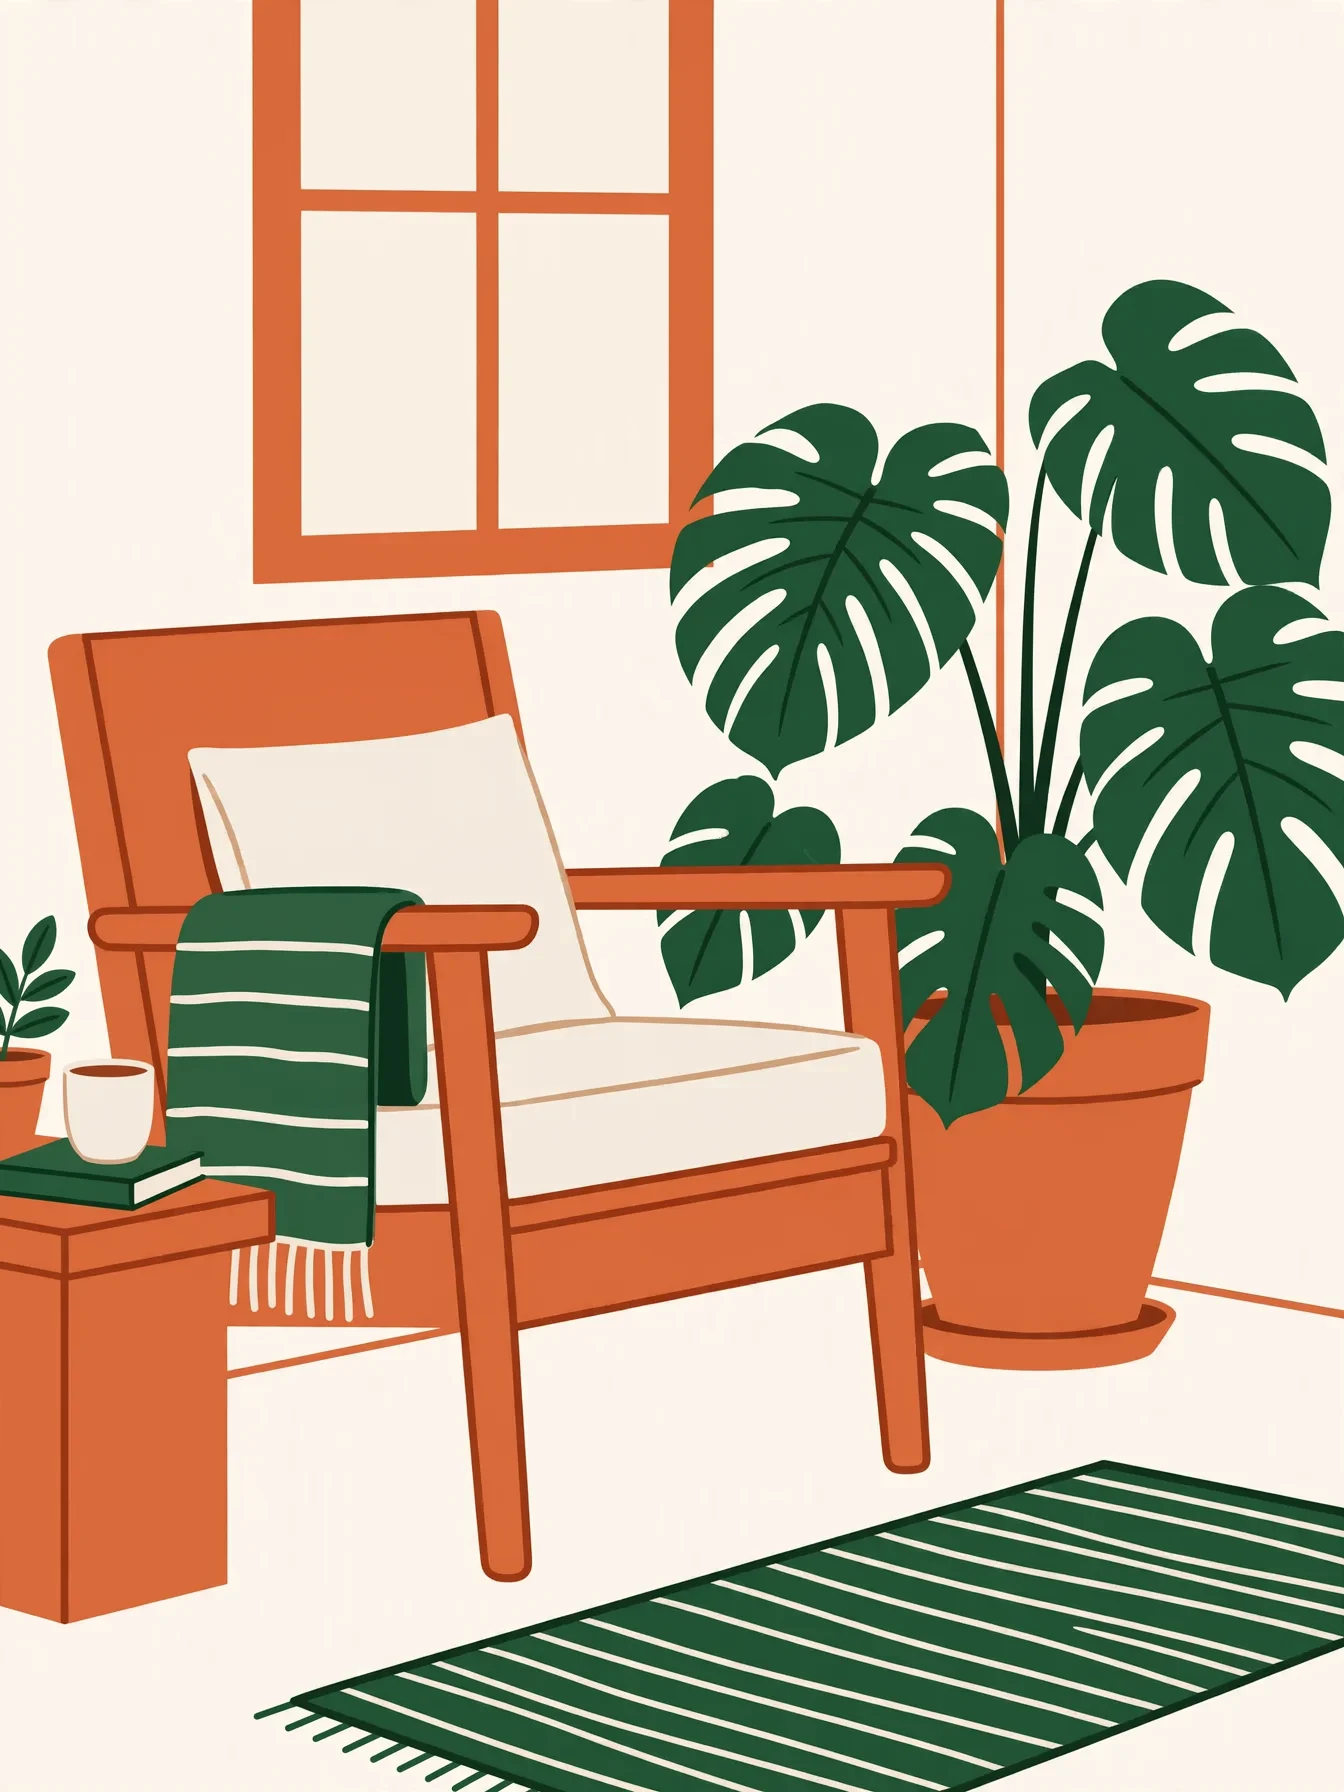
Spettro di stile: traduzione progressiva dalla fotografia realistica all'illustrazione piatta
Stile trasferimento-di-stile · Illustrazione piatta · Guida di riferimento
Input di riferimento
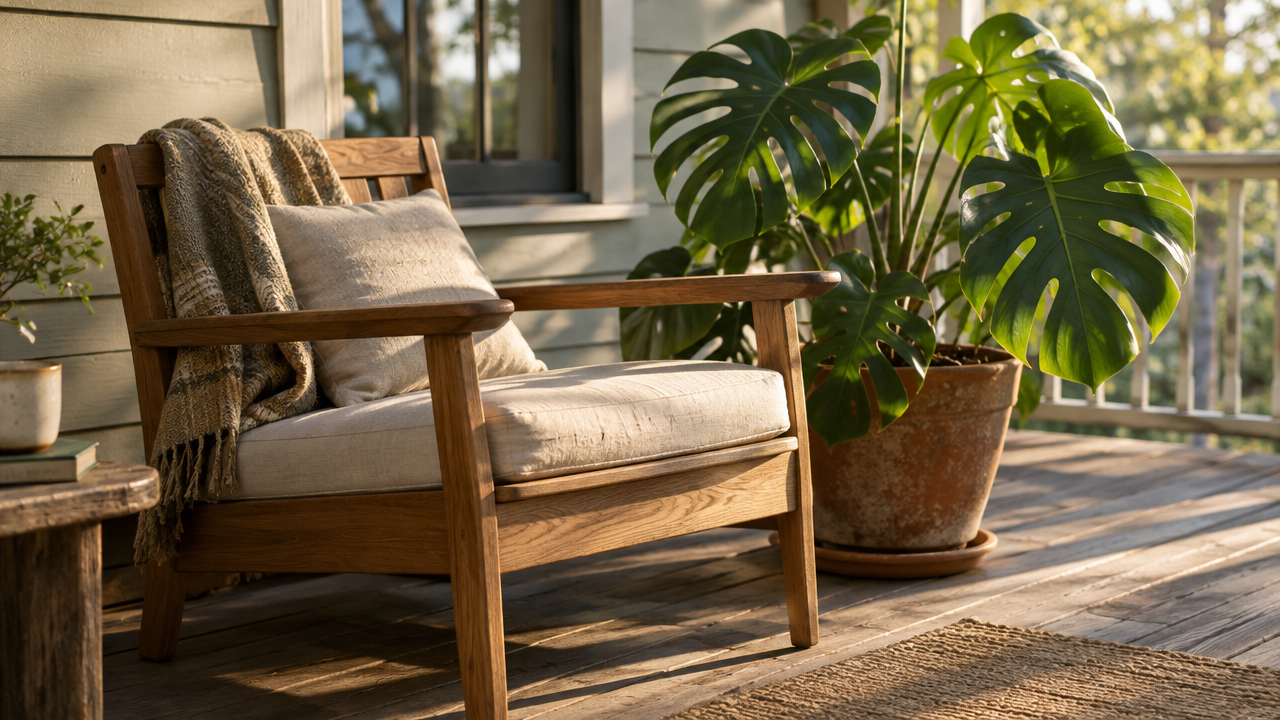
image_urls
Prompt
Illustrazione vettoriale piatta trasformata dalla foto di riferimento: mantieni l'identità del soggetto, il profilo della sedia e la posizione delle piante esattamente identici all'immagine di riferimento, ma appiattisci completamente tutto il resto. Sostituisci l'illuminazione fotografica con due o tre tinte piatte, comprimi la profondità di campo in piani sovrapposti, elimina texture e granulosità, usa contorni puliti e netti e una palette contenuta composta da terracotta caldo, bianco crema e verde scuro. Nessun gradiente, nessuna ombra proiettata, nessun dettaglio fotografico conservato. Composizione centrata, ampio spazio negativo, stile illustrazione editoriale.
Copia il prompt completo e adattalo alla tua generazione.
Tag
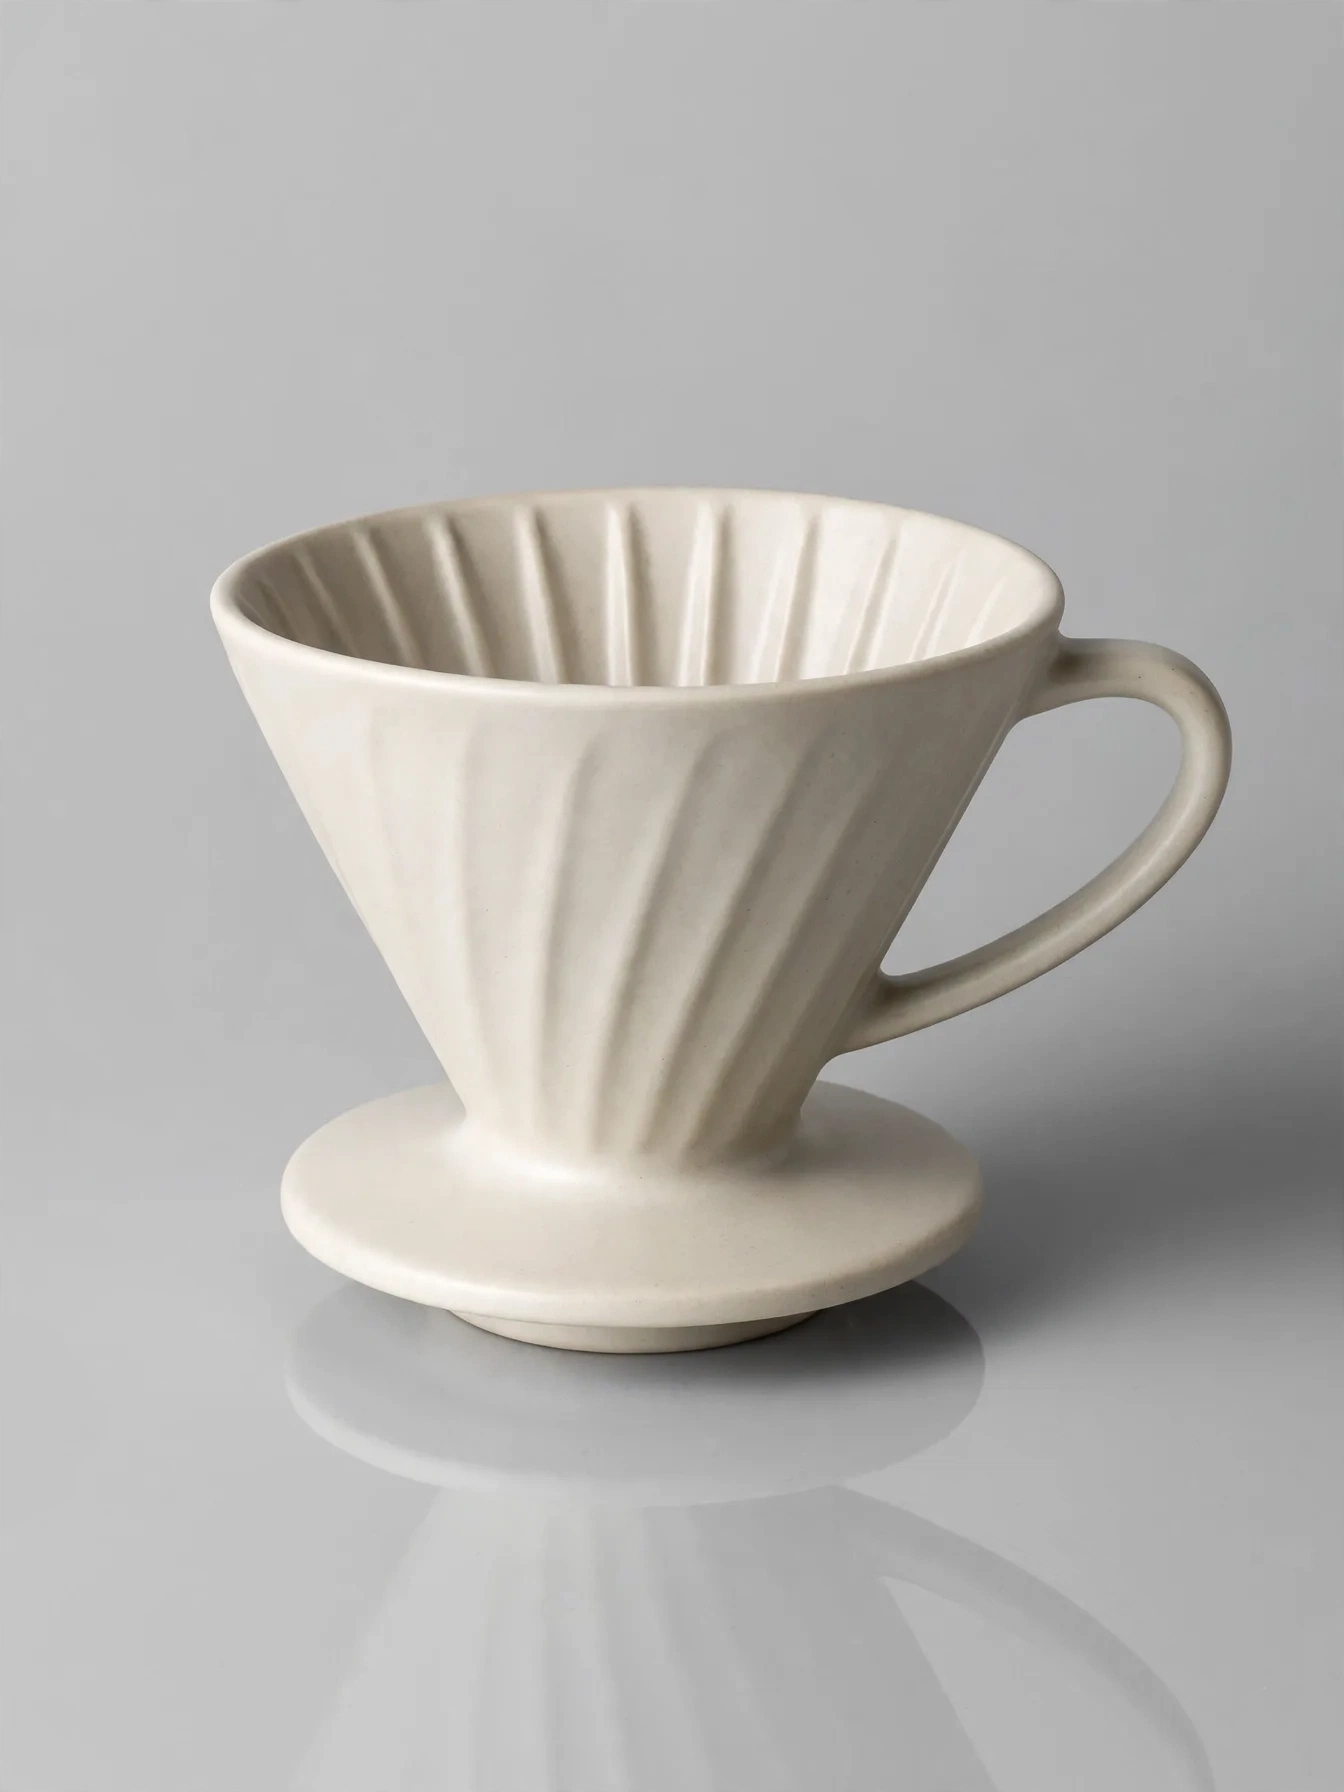
Qualità fotografica di livello e-commerce: da una singola immagine di riferimento a output di livello commerciale
Stile Immagine del prodotto · ecommerce · Illuminazione da studio
Input di riferimento
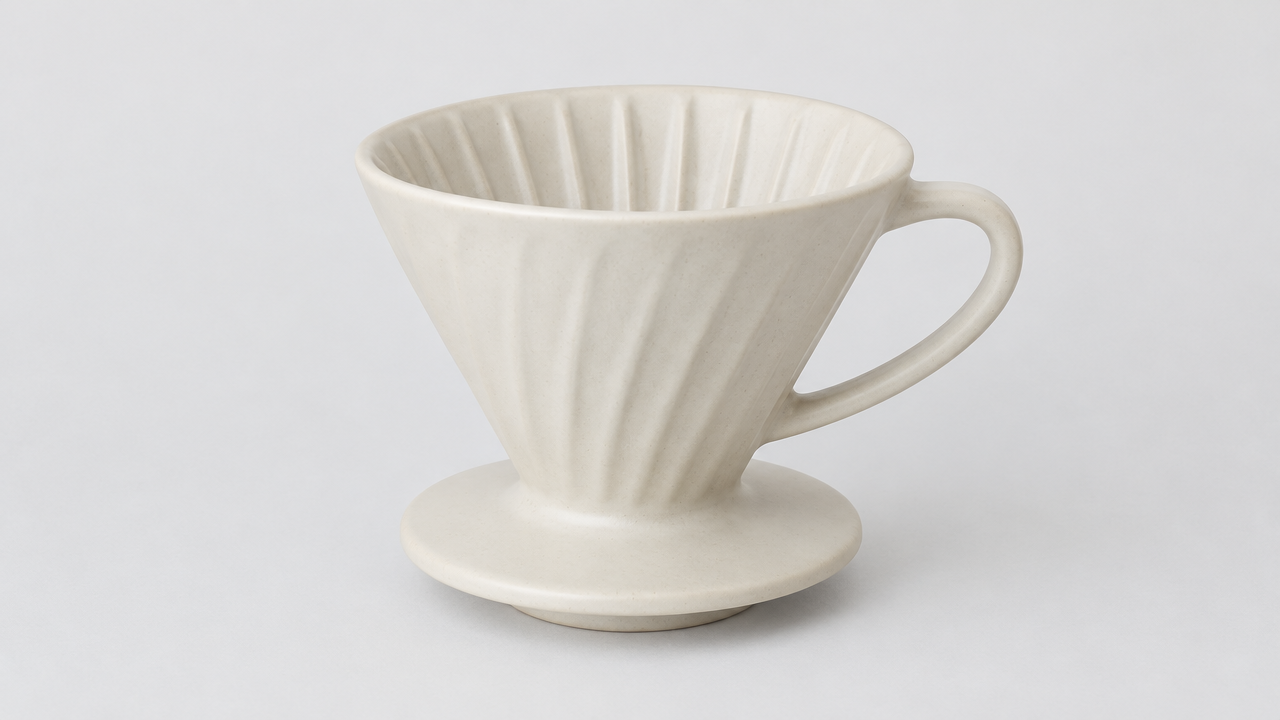
image_urls
Prompt
Ristilizza il prodotto nell'immagine di riferimento come foto di prodotto commerciale per e-commerce. Mantieni la forma esatta, le proporzioni, i colori, la posizione del logo e i dettagli dei materiali del prodotto identici all'immagine di riferimento; non aggiungere, rimuovere o ridisegnare alcuna caratteristica. Collocalo su uno sfondo da studio senza cuciture grigio chiaro opaco, con un sottile riflesso morbido alla base. Illuminazione: luce principale da softbox grande in alto a sinistra, con una morbida attenuazione progressiva verso destra, luce di contorno sottile lungo i bordi del prodotto per separarlo dallo sfondo; nessun punto di luce speculare fastidioso sulle etichette. Fotocamera: obiettivo per prodotto equivalente a 85mm, allineato all'altezza dello sguardo del prodotto, angolazione leggermente a tre quarti, profondità di campo sufficientemente ampia da mantenere nitido l'intero prodotto. Composizione: prodotto centrato, con abbondante spazio negativo pulito, formato orizzontale 16:9, adatto a un banner di negozio. Post-produzione: bordi nitidi, bilanciamento del bianco neutro, colori accurati, senza polvere, senza impronte, senza oggetti di scena, senza sovrapposizioni di testo.
Copia il prompt completo e adattalo alla tua generazione.
Tag
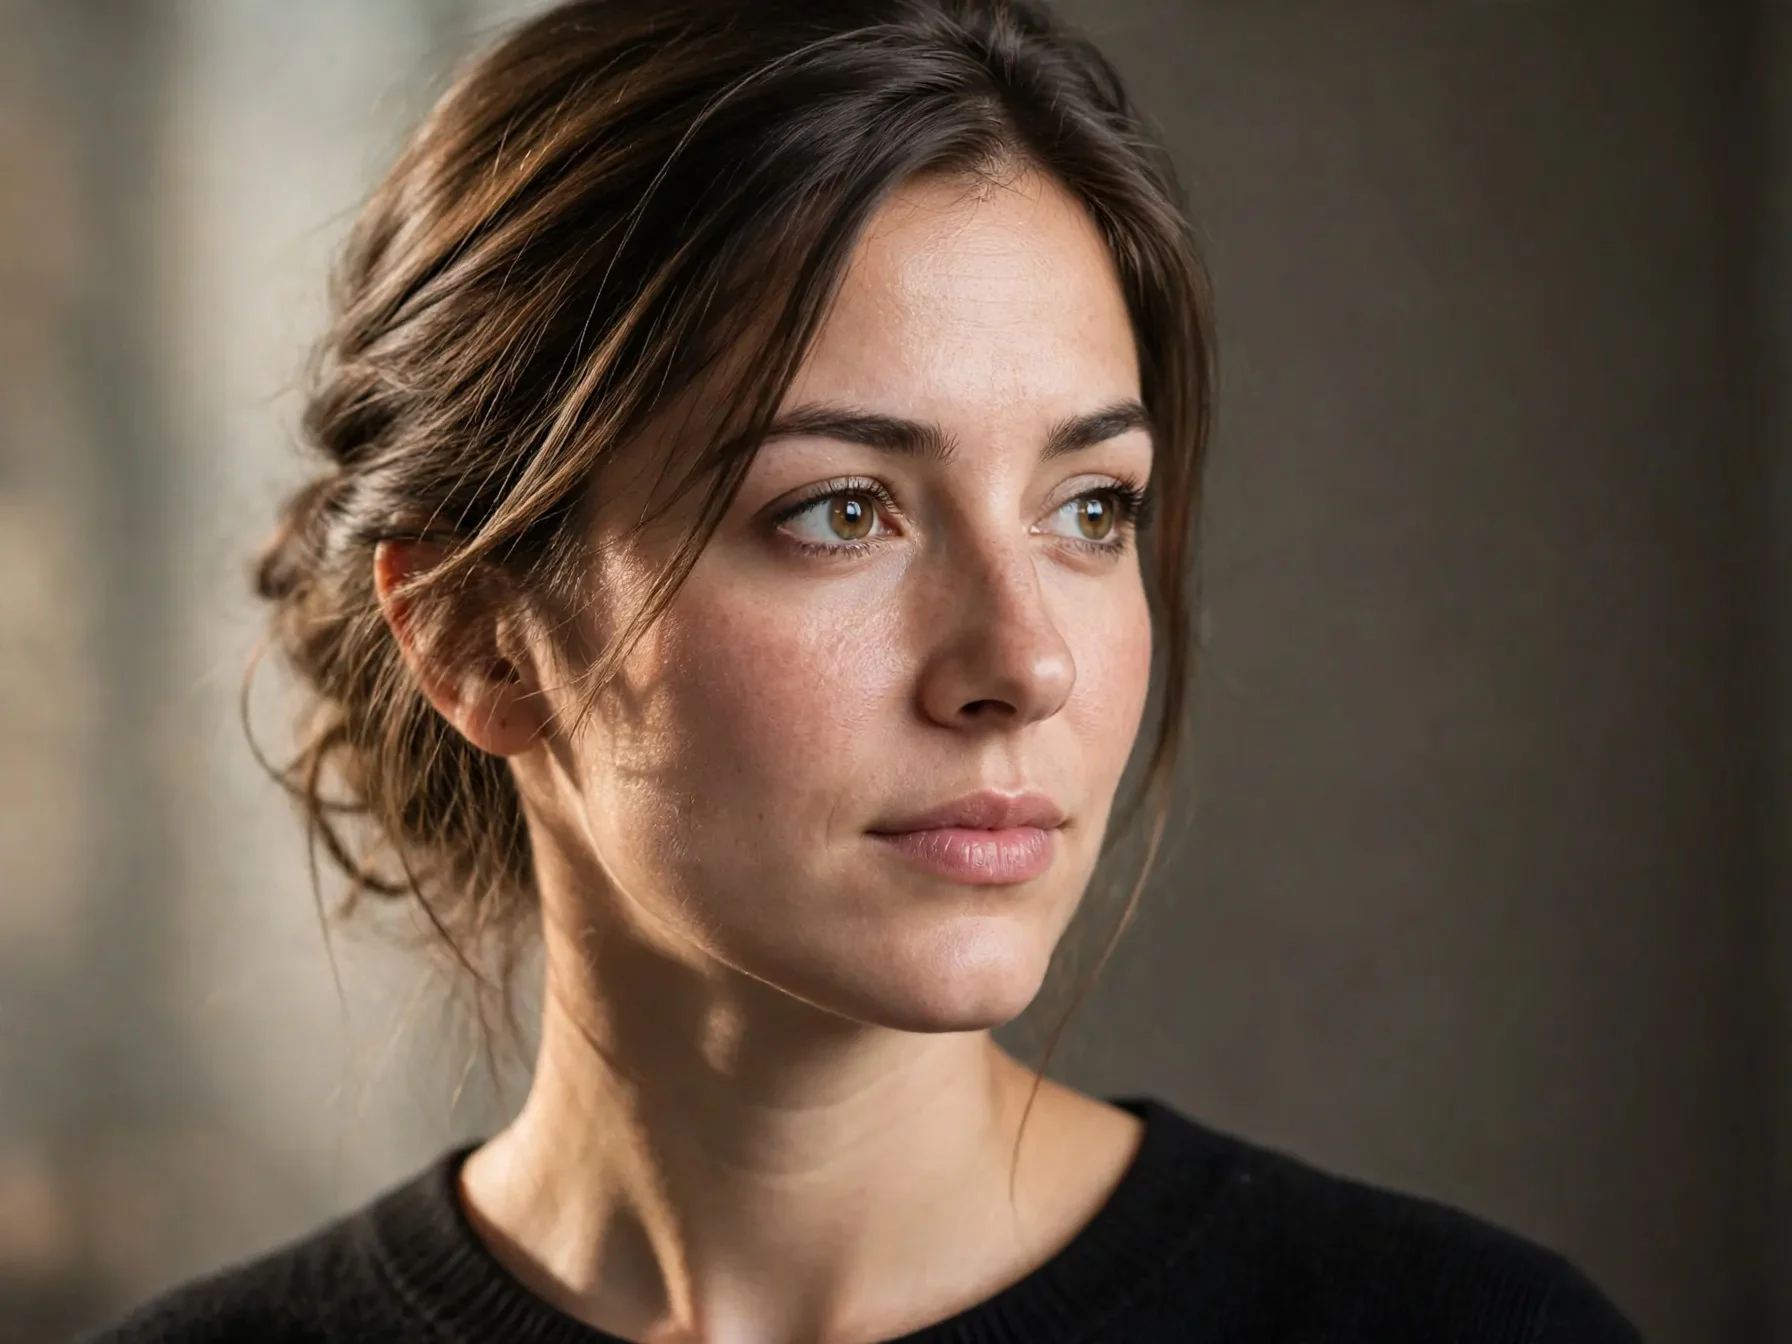
Ritratto realistico e artistico guidato da immagine di riferimento
Stile Ritratto e fotografia · trasferimento-di-stile · Fotorealistico
Input di riferimento
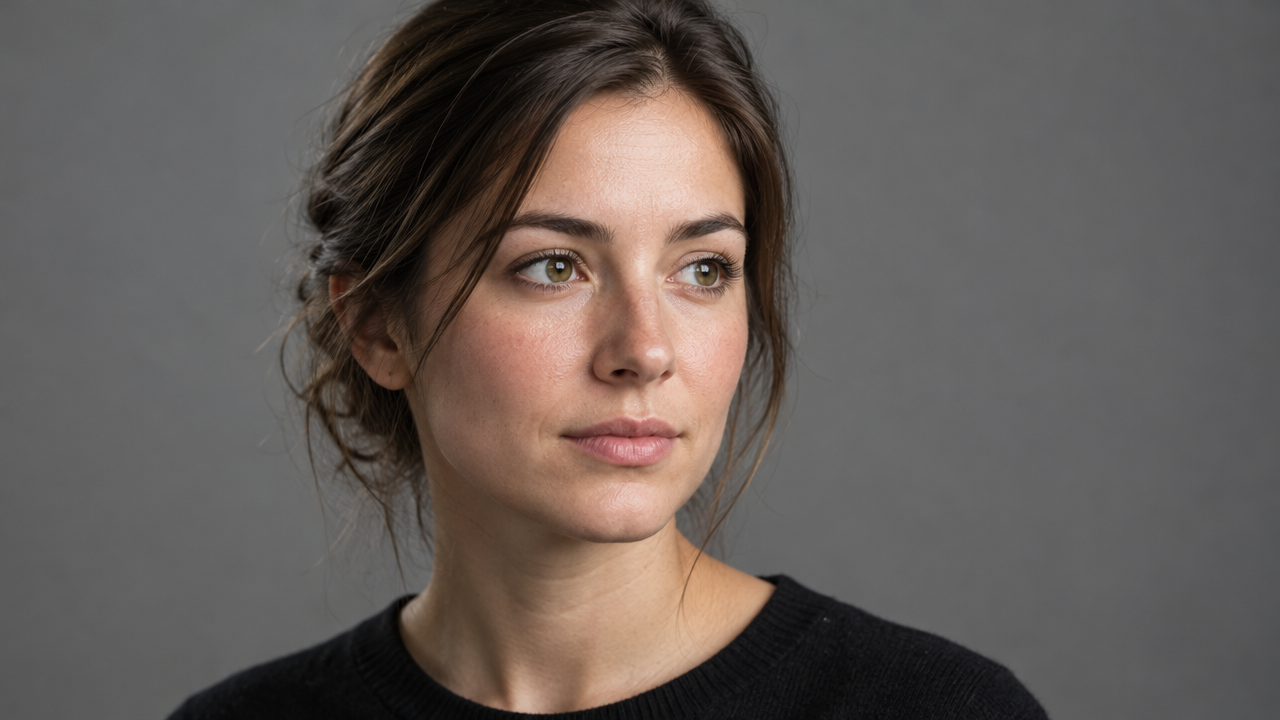
image_urls
Prompt
Stile di ridisegno ritrattistico image-to-image. Utilizzare la fotografia di riferimento fornita come unica fonte per l'identità del soggetto e la composizione: mantenere la stessa struttura facciale, il contorno dei capelli, l'angolazione della testa e la postura delle spalle. Renderizzare un singolo ritratto a piano medio-ravvicinato, composizione verticale 3:4, luce principale direzionale morbida proveniente da sinistra rispetto alla fotocamera, con una transizione delicata verso uno sfondo continuo grigio caldo neutro. Preservare la texture naturale della pelle, con pori e sottili capelli visibili, riflessi speculari sottili sugli zigomi e sul ponte del naso, occhi realistici con punti luce visibili e transizioni cromatiche fedeli. Color grading misurato, con un leggero contrasto dalla resa analogica; nessuna stilizzazione eccessiva, nessuna pelle levigata dall'effetto plastica, nessun oggetto o testo aggiuntivo. Profondità di campo ridotta, messa a fuoco nitida sugli occhi, effetto obiettivo per ritratti 85mm.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
muse-image-1.0/image-to-image per task
| Prezzo unitario | $0.015 |
|---|
Panoramica e posizionamento
muse-image-1.0/image-to-image è un modello di generazione e modifica di immagini guidato da immagini di riferimento, rilasciato da Meta e richiamabile tramite l'interfaccia unificata di HiAPI.ai. Prende in input una o più immagini di riferimento e, insieme a un prompt testuale, realizza la generazione dell'immagine, la sostituzione di elementi e la riscrittura dello stile; inoltre scompone le istruzioni complesse in più segmenti e pianifica il layout prima di eseguire il rendering. È adatto agli sviluppatori che desiderano usare materiali esistenti come base, puntando alla fedeltà al prompt e all'efficienza nella produzione in serie, e può essere impiegato in flussi quali varianti di materiali, immagini di scenario per prodotti e composizioni personalizzate.
Punti di forza principali
- Flusso di generazione che prima ragiona e poi esegue il rendering — prima del rendering scompone i prompt multi-segmento e pianifica il layout, riducendo la probabilità che istruzioni complesse vengano perse in una singola generazione forward.
- Generazione e modifica nello stesso modello — la fusione delle immagini di riferimento e la riscrittura secondo le istruzioni non richiedono l'integrazione di ulteriori toolchain di editing, riducendo i passaggi di chiamata.
- Più immagini di riferimento in una sola richiesta — accetta fino a 10 immagini di riferimento, ciascuna delle quali può avere un ruolo specificato nel prompt come soggetto, stile o composizione.
- Specifiche di output controllate direttamente tramite parametri — è possibile specificare il rapporto d'aspetto e i formati di output jpeg, png e webp, facilitando l'integrazione con le pipeline di materiali a valle.
Descrizione delle capacità
Modifica di immagini guidata da immagini di riferimento: prende in input immagini di riferimento e un prompt testuale e modifica o conserva il contenuto dell'immagine secondo il prompt; è adatta ad ajustamenti mirati su materiali esistenti anziché alla generazione da zero.
Fusione di più immagini: una singola richiesta può includere da 1 a 10 immagini di riferimento, ciascuna annotata nel prompt con un ruolo di soggetto, stile o composizione, per attività di sintesi.
Esecuzione scomposta di prompt complessi: per le descrizioni multi-segmento pianifica prima e poi esegue il rendering, rendendo più facile realizzare completamente prompt che contengono più soggetti e requisiti di layout.
Controllo delle specifiche di output: supporta nove rapporti d'aspetto da 1:1 a 21:9 e consente di scegliere i formati jpeg, png e webp, producendo direttamente secondo le esigenze di diffusione o archiviazione.
Scenari d'uso
- Team pubblicitari e di media buying: generazione in serie di varianti da materiali esistenti — carica un'immagine base del brand e riscrivi contenuto e proporzioni seguendo i prompt dei vari canali, producendo più set di materiali per test A/B e distribuzione multicanale.
- Operatori e-commerce: contestualizzazione delle immagini prodotto — usa le foto reali del prodotto come riferimento, modifica sfondo e scenario tramite prompt e genera immagini da catalogo o immagini di scenario per le pagine di dettaglio del prodotto.
- Composizione personalizzata: integrare le foto degli utenti in nuove immagini — usa le foto caricate dagli utenti come immagini di riferimento per comporre immagini a tema, producendo immagini personalizzate per pagine evento o condivisioni social.
Limiti e consigli per la scelta
I materiali pubblici non divulgano dettagli tecnici come l'architettura del modello e la risoluzione di output; i risultati di generazione vanno valutati in base all'effettivo rendimento. Il ragionamento in più passaggi introduce una latenza aggiuntiva e non è adatto a scenari estremamente sensibili ai tempi di risposta; l'output è limitato alle immagini e non riguarda video o audio. Se l'attività richiede solo la generazione testo-immagine da zero senza immagini di riferimento, si può scegliere la linea text-to-image della stessa famiglia; se invece servono la generazione video o una latenza più bassa, è opportuno considerare altri modelli.
Domande frequenti
Vedi tutte le domande →-
Come scegliere tra generazione di immagini da testo e modifica di immagini?
Scegli la generazione di immagini da testo quando hai solo testo e parti da zero; scegli la modifica di immagini e fornisci un'immagine di riferimento quando devi mantenere un soggetto o un layout esistente.
-
Quante immagini si possono ottenere ogni volta?
Ogni attività restituisce un'immagine, non è possibile scegliere il numero di immagini. Per confrontare un'altra composizione, modifica il prompt e invia una nuova attività.
-
È possibile scegliere 1K, 2K o 4K?
Questa voce non offre livelli di risoluzione. Il formato è a tua scelta, mentre le dimensioni in pixel sono determinate dal modello, di solito circa 2,5 MP; fai riferimento alle dimensioni effettive del file scaricato.
-
Quali formati di file posso scegliere?
Puoi scegliere JPEG, PNG o WebP; se non ne selezioni uno, viene utilizzato WebP. Scegli in base alle esigenze delle successive risorse web o degli strumenti di progettazione.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: muse-image-1.0/image-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per muse-image-1.0/image-to-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 1maxLength 5000Prompt testuale che descrive l'immagine da generare, oppure specifica i contenuti da modificare e conservare nelle immagini di riferimento; quando si usano immagini di riferimento, indica per ciascuna il soggetto, lo stile o il ruolo compositivo.
image_urlsarrayObbligatoriominItems 1maxItems 10Array di immagini di riferimento, i cui elementi sono URL di immagini, utilizzato per fornire le immagini di riferimento necessarie alla generazione da immagine a immagine; si consiglia di indicare nel prompt il soggetto, lo stile o il ruolo compositivo corrispondente a ciascuna immagine.
Array [ string ]
aspect_ratiostringOpzionaleProporzioni (larghezza/altezza) dell'immagine di output; determina solo il rapporto, non le dimensioni esatte in pixel.
1:14:33:416:99:163:22:321:9Mostra tutto (1)
9:21output_formatstringOpzionalePredefinito: "webp"Formato del file per il download dell'immagine; predefinito webp.
jpegpngwebpcallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/image-to-image",
  "input": {
    "prompt": "…",
    "image_urls": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/image-to-image",
input: {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/image-to-image",
"input": {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Ideogram V3 Character Ideogram $0.090 /immagine
-
 FASHN Tryon v1.6 FASHN $0.107 /immagine
-
 FIBO 1.5 Bria $0.058 /immagine
-
 Z-Image Alibaba $0.008 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Grok Imagine xAI $0.011 /secondo
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /immagine
-
 Krea 3 Krea $0.036 /immagine
-
 GPT Image 2 OpenAI $0.007 /immagine
-
 Imagen 4 Google $0.030 /immagine
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /immagine
-
 Ideogram V4 Ideogram $0.050 /immagine