
Alibaba
Qwen Image 2.0
qwen-image-2.0
Modello architetturale unificato di Alibaba per la generazione e l'editing di immagini, specializzato nel rendering di testi cinesi di lunga durata, supporta istruzioni fino a 1000 token e output fino a 2K
Prova qwen-image-2.0
Input
Creazioni
Vedi tutte le creazioniOutput
image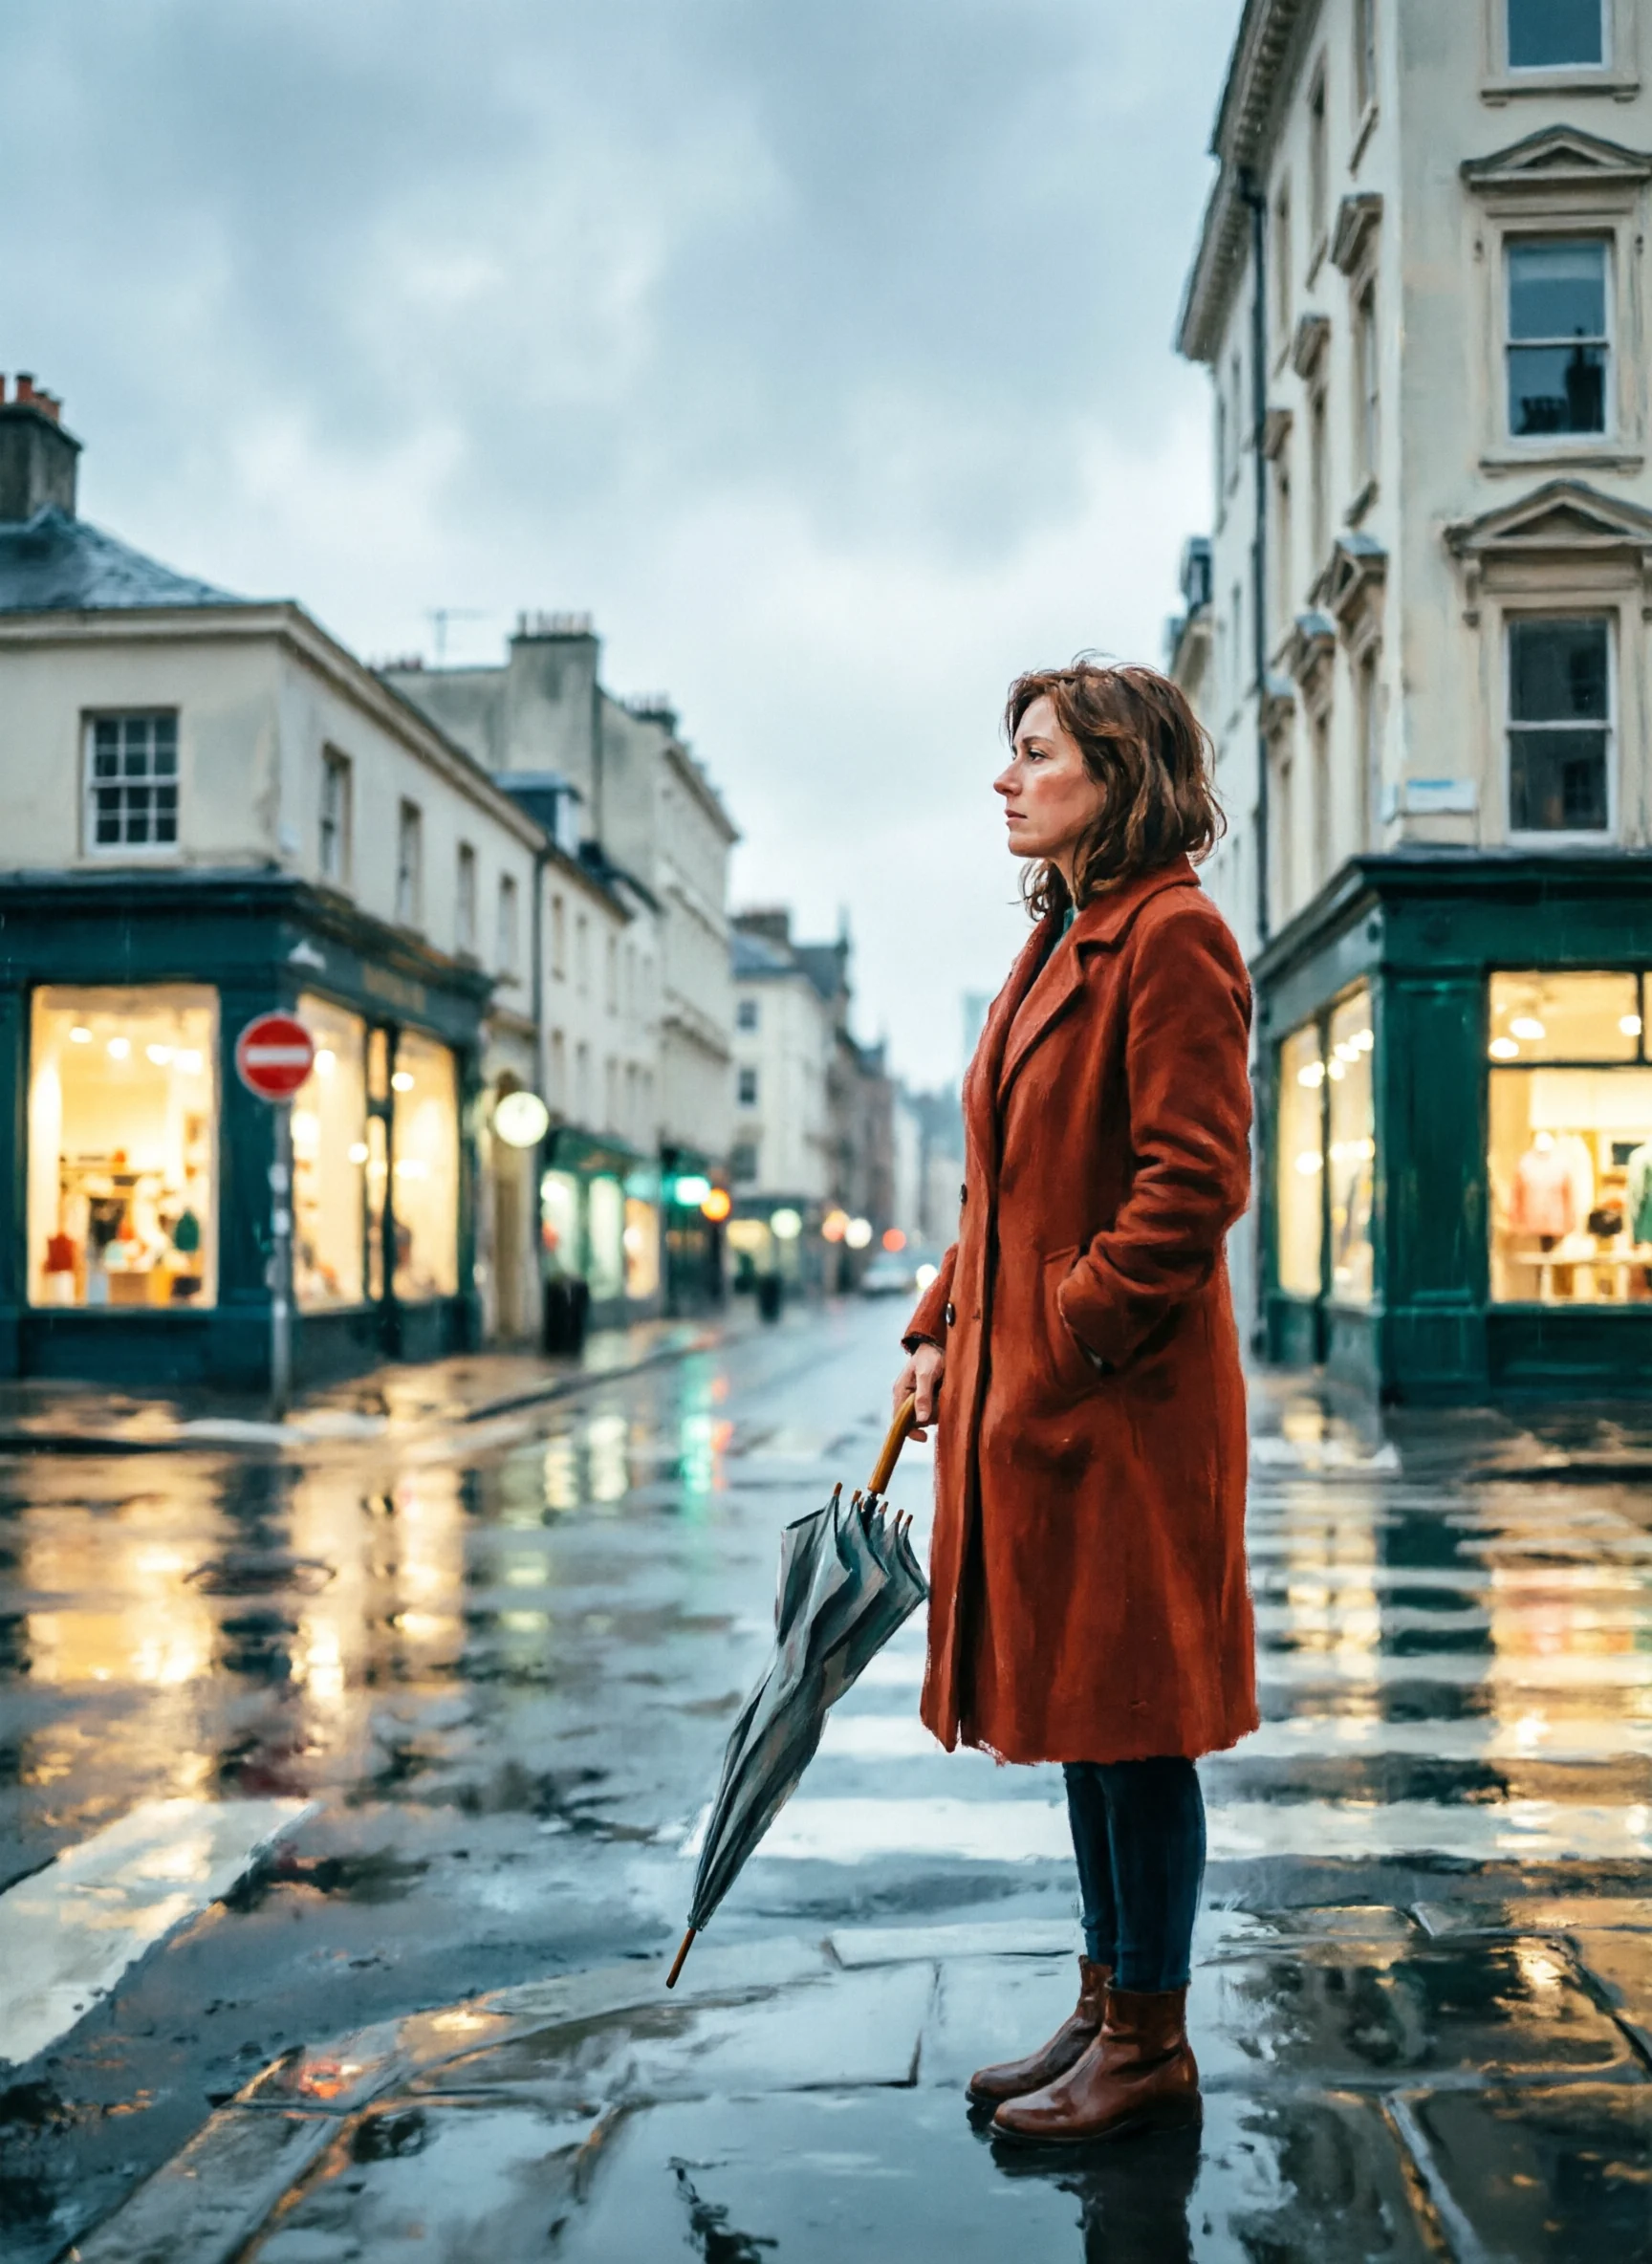
Spettro stilistico: dallo iperrealismo all'illustrazione piatta dello stesso soggetto
Stile spettro-di-stile · editorial-illustration · Design piatto
Prompt
Illustrazione quadrata in stile libro illustrato: una donna con un cappotto color rosso ruggine sta in un angolo di strada urbano sotto la pioggia, piano medio, vista a tre quarti, tiene tra le mani un ombrello chiuso, il manto stradale bagnato riflette le calde luci dei negozi, cielo grigio nuvoloso e soffice, dietro di lei facciate architettoniche simmetriche. Si presenta deliberatamente uno spettro stilistico che va dal realismo pittorico (pennellate visibili, morbide transizioni chiaroscurali, texture di pelle e tessuti, equilibrio tra luce calda e fredda) all'illustrazione vettoriale piatta (blocchi di colore puro, sagome pulite, gradienti ridotti, contorni marcati, palette limitata di rosso ruggine, verde acqua, crema e grigio antracite). Il soggetto è leggermente a destra del centro, con spazio negativo aperto in alto a sinistra, chiara stratificazione primo piano-piano medio-sfondo, composizione 1:1, senza tipografia, senza filigrana.
Copia il prompt completo e adattalo alla tua generazione.
Tag
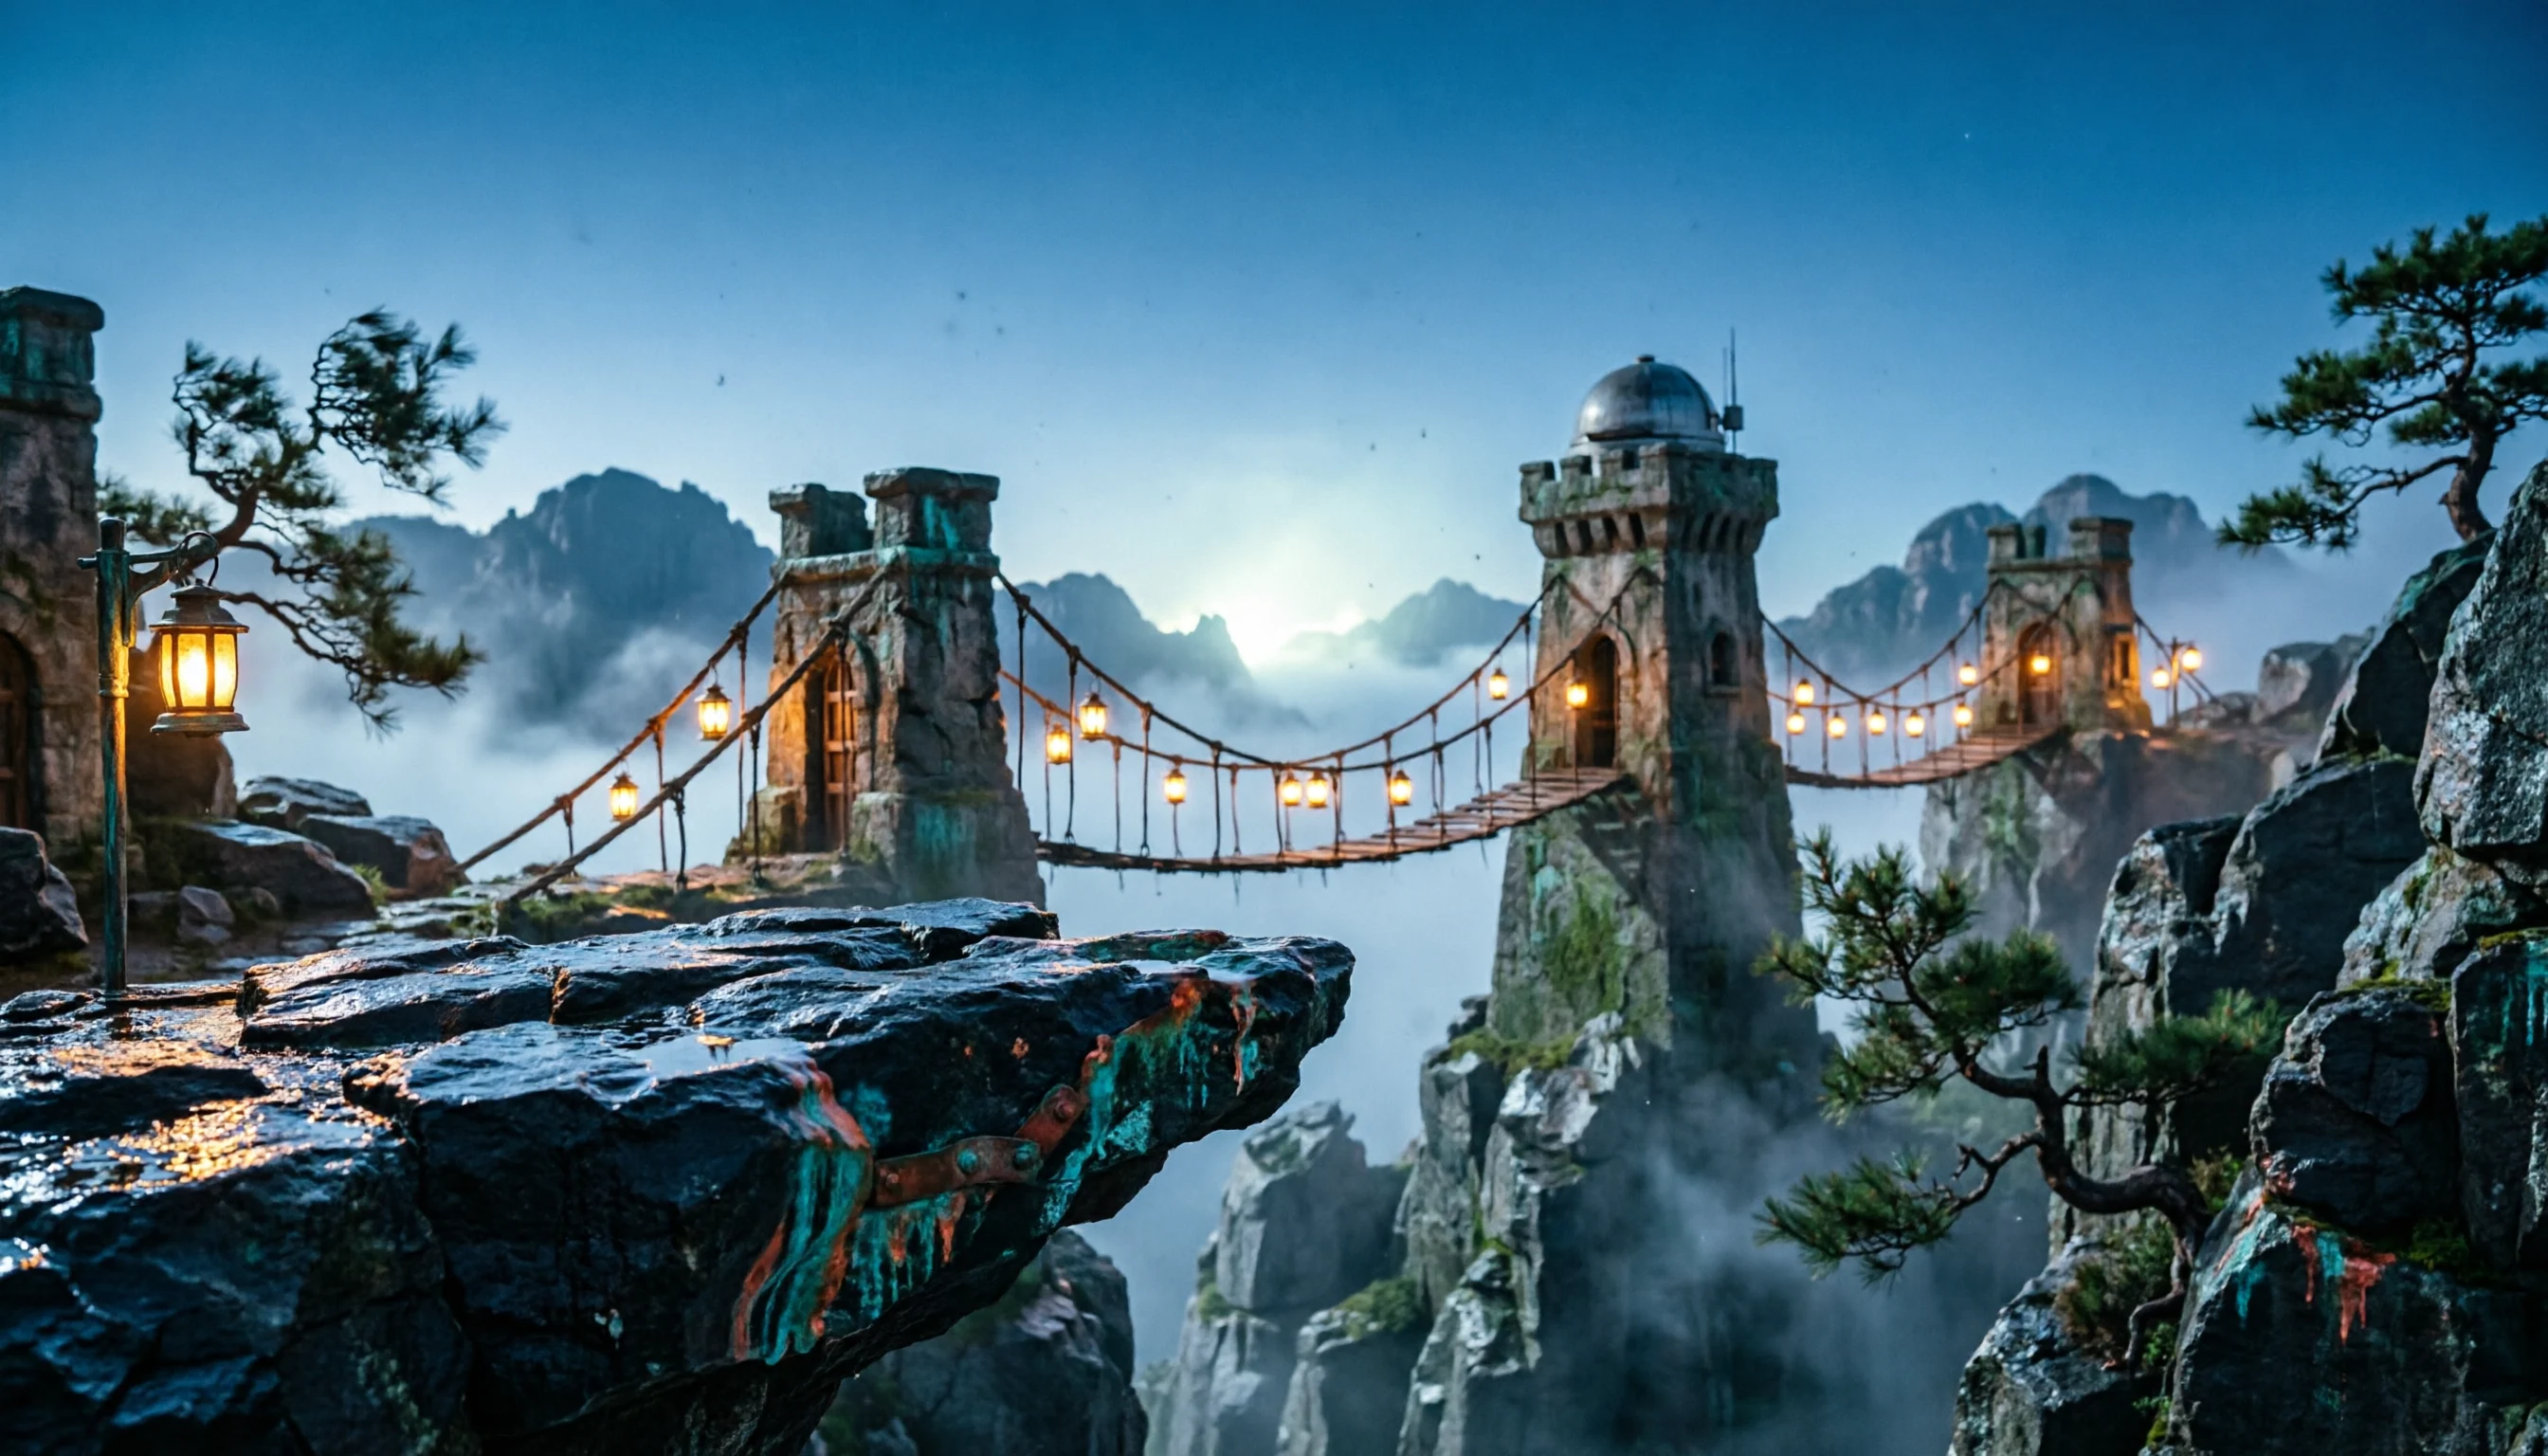
Concept art di scena: esplorazione visiva di worldbuilding e atmosfera
Stile Concept art · Costruzione del mondo · Illuminazione cinematografica
Prompt
Concept art ambientale dal taglio cinematografico, che ritrae una cittadina con osservatorio sul bordo di una scogliera nell'ora blu, composizione a tre strati di profondità: in primo piano uno sperone di scogliera in roccia scura, a metà campo torri in pietra erosa e ponti sospesi, in lontananza una cresta montuosa che si dissolve nella nebbia sottile presso il punto di fuga. La luce calda delle lanterne a bassa angolazione contrasta con la luce ambiente fredda del cielo, nebbia volumetrica, particelle di polvere sospese, pietra umida e materiali in rame ossidato, pini piegati dal vento. Punto di ripresa basso, leggermente sotto la linea del ponte, composizione anamorfica widescreen, 16:9. Stile realistico pittorico, dettagli architettonici nitidi, palette sobria di blu ardesia, verde muschio e ambra, alta gamma dinamica, senza testo, senza oggetti moderni.
Copia il prompt completo e adattalo alla tua generazione.
Tag
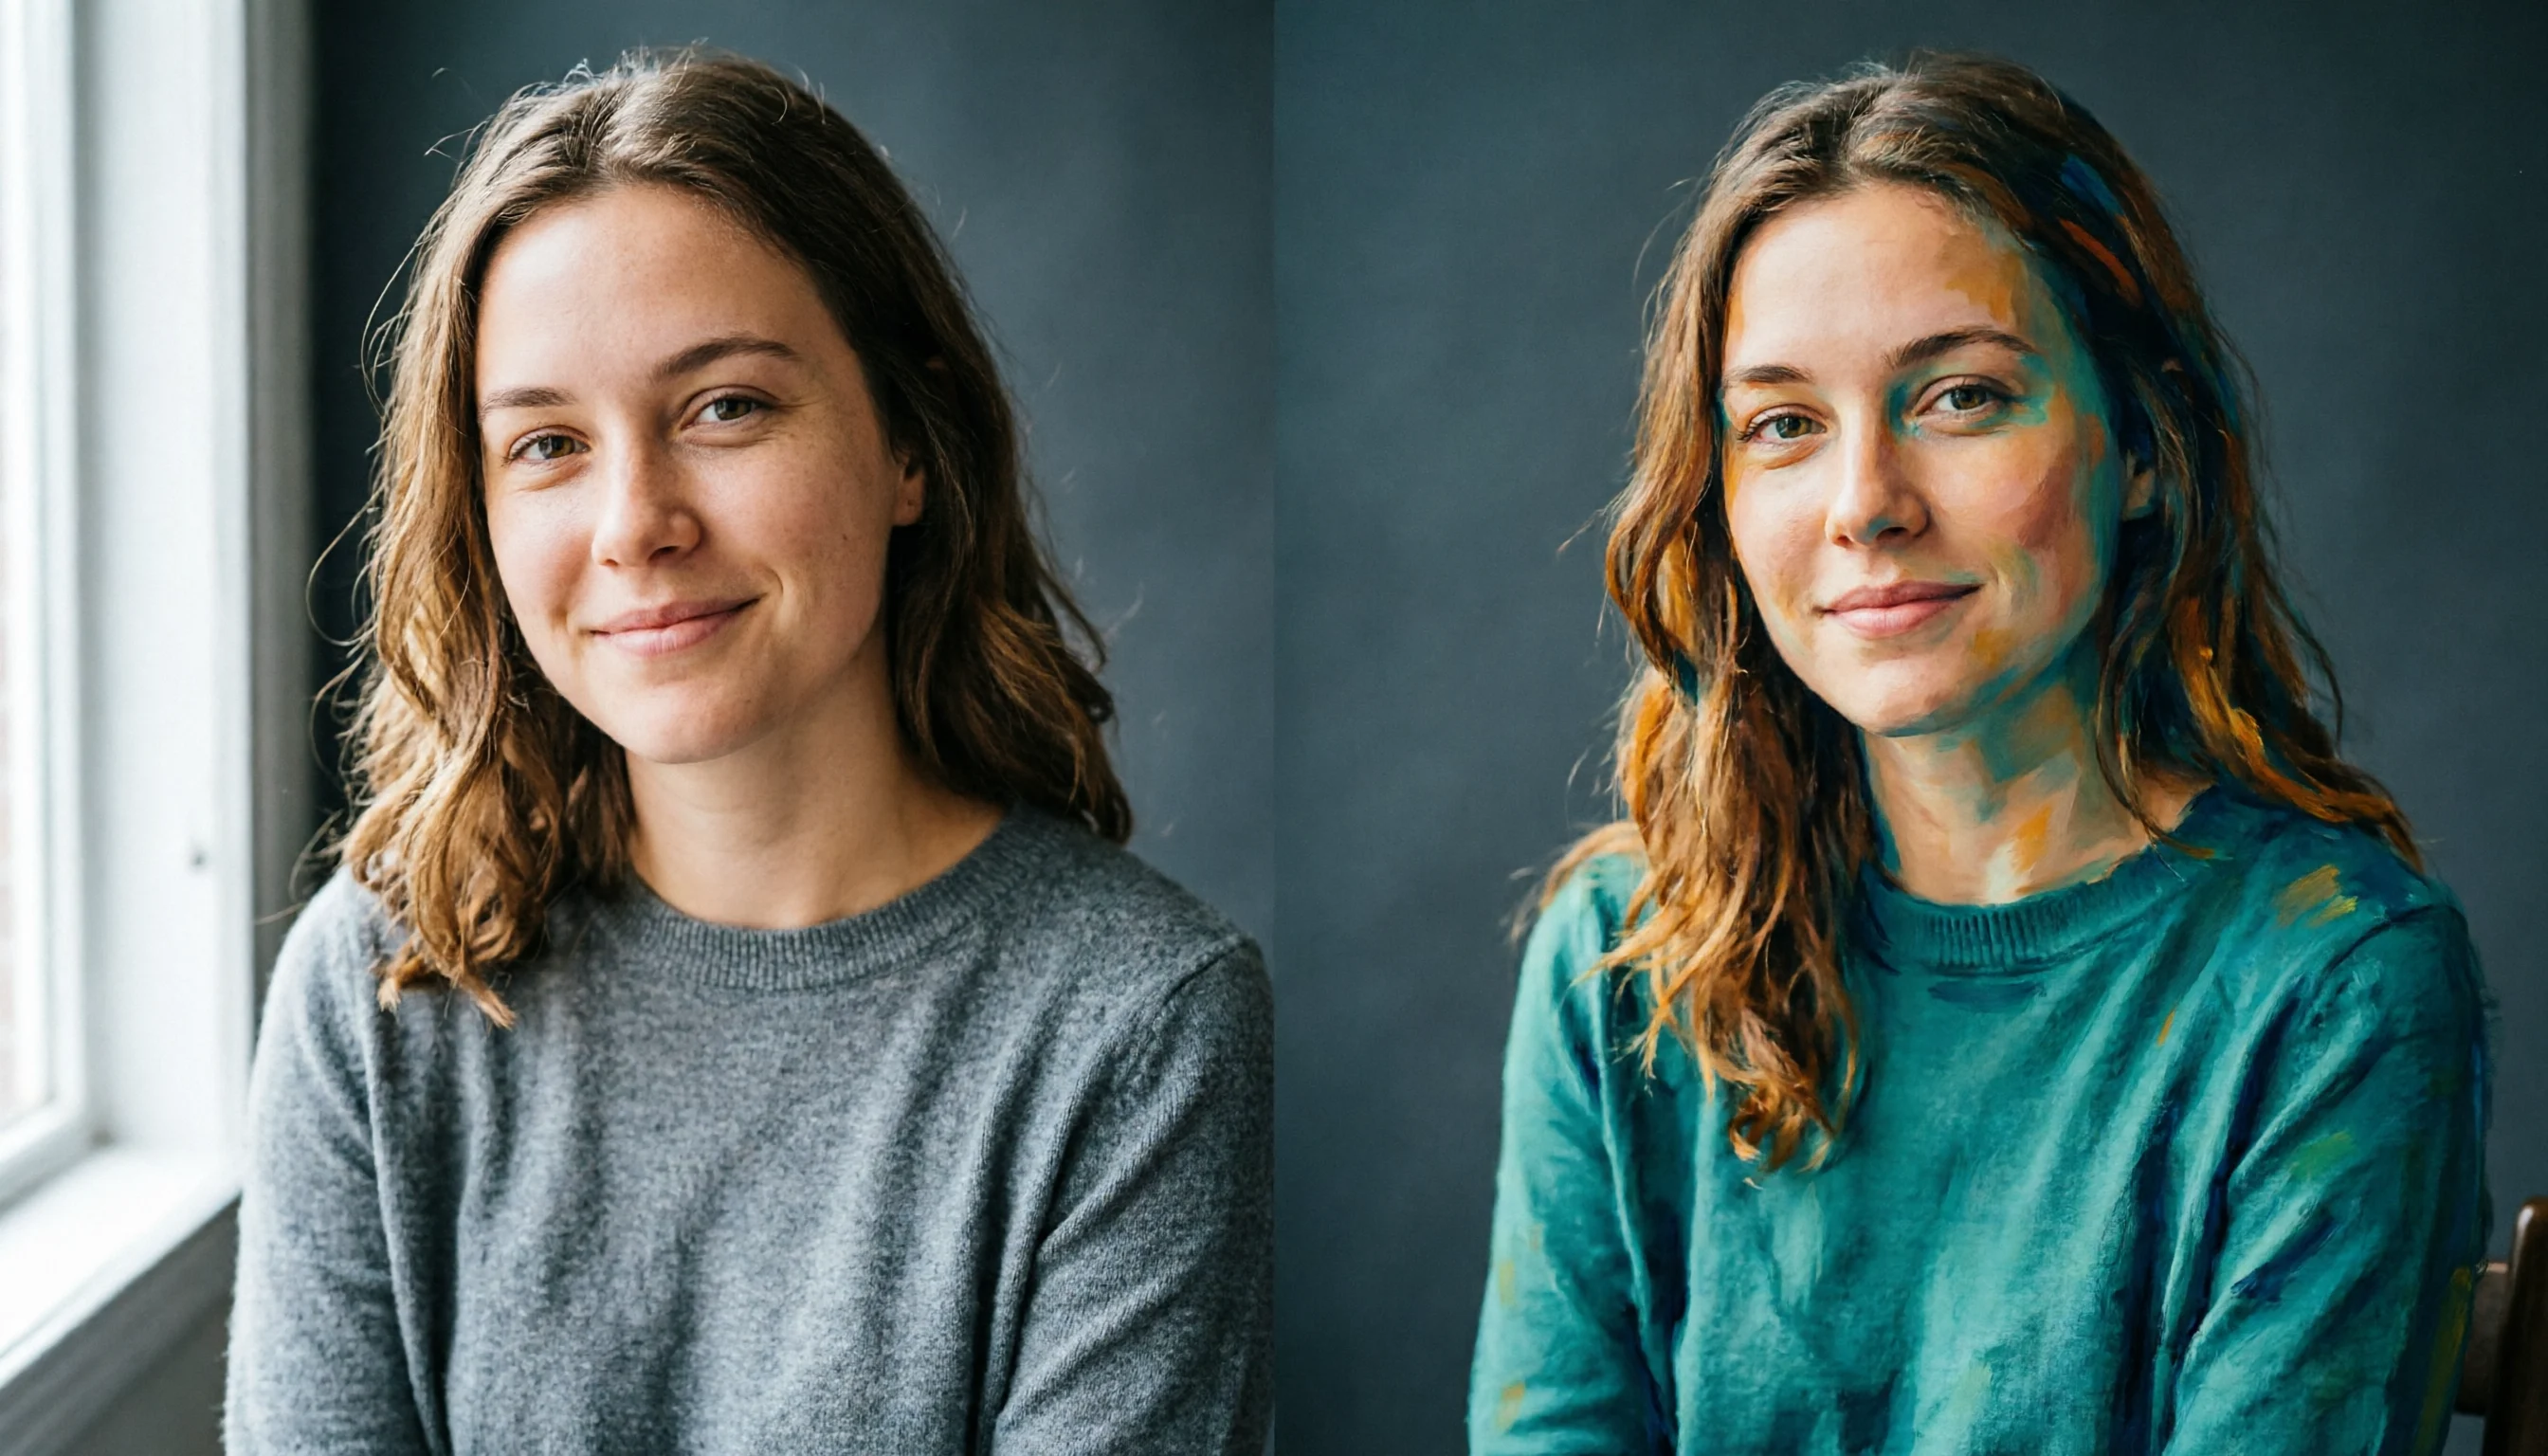
Riferimento di stile per prompt di ritratto con Qwen-Image-2.0: dittico tra realismo e artisticità
Stile Ritratto e fotografia · Fotorealistico · Rendering stilizzato
Prompt
Un'immagine di riferimento per ritratti in 16:9, divisa in due riquadri verticali di uguale larghezza, che mostrano la stessa giovane donna seduta, su uno sfondo da studio neutro e morbido. Riquadro sinistro: ritratto realistico in stile rivista, resa da obiettivo 85mm, profondità di campo ridotta, luce finestra morbida da sinistra, texture della pelle naturale, pori visibili e lentiggini leggere, sorriso lieve e rilassato, indosso un maglione in maglia grigio tinta unita, palette calda e neutra. Riquadro destro: la stessa donna presentata con un linguaggio stilizzato da rivista di moda pittorica, forme grafiche audaci, chiaroscuro a campiture piatte, palette satura di blu-verde e ambra, bordi di pennellata visibili, leggera grana di stampa. Entrambi i riquadri sono a mezzo busto, composizione centrata, parete grigio scuro pulita, senza testo né loghi, luce continua ed equilibrata su entrambi i lati della divisione, alto dettaglio, gestione professionale del colore.
Copia il prompt completo e adattalo alla tua generazione.
Tag
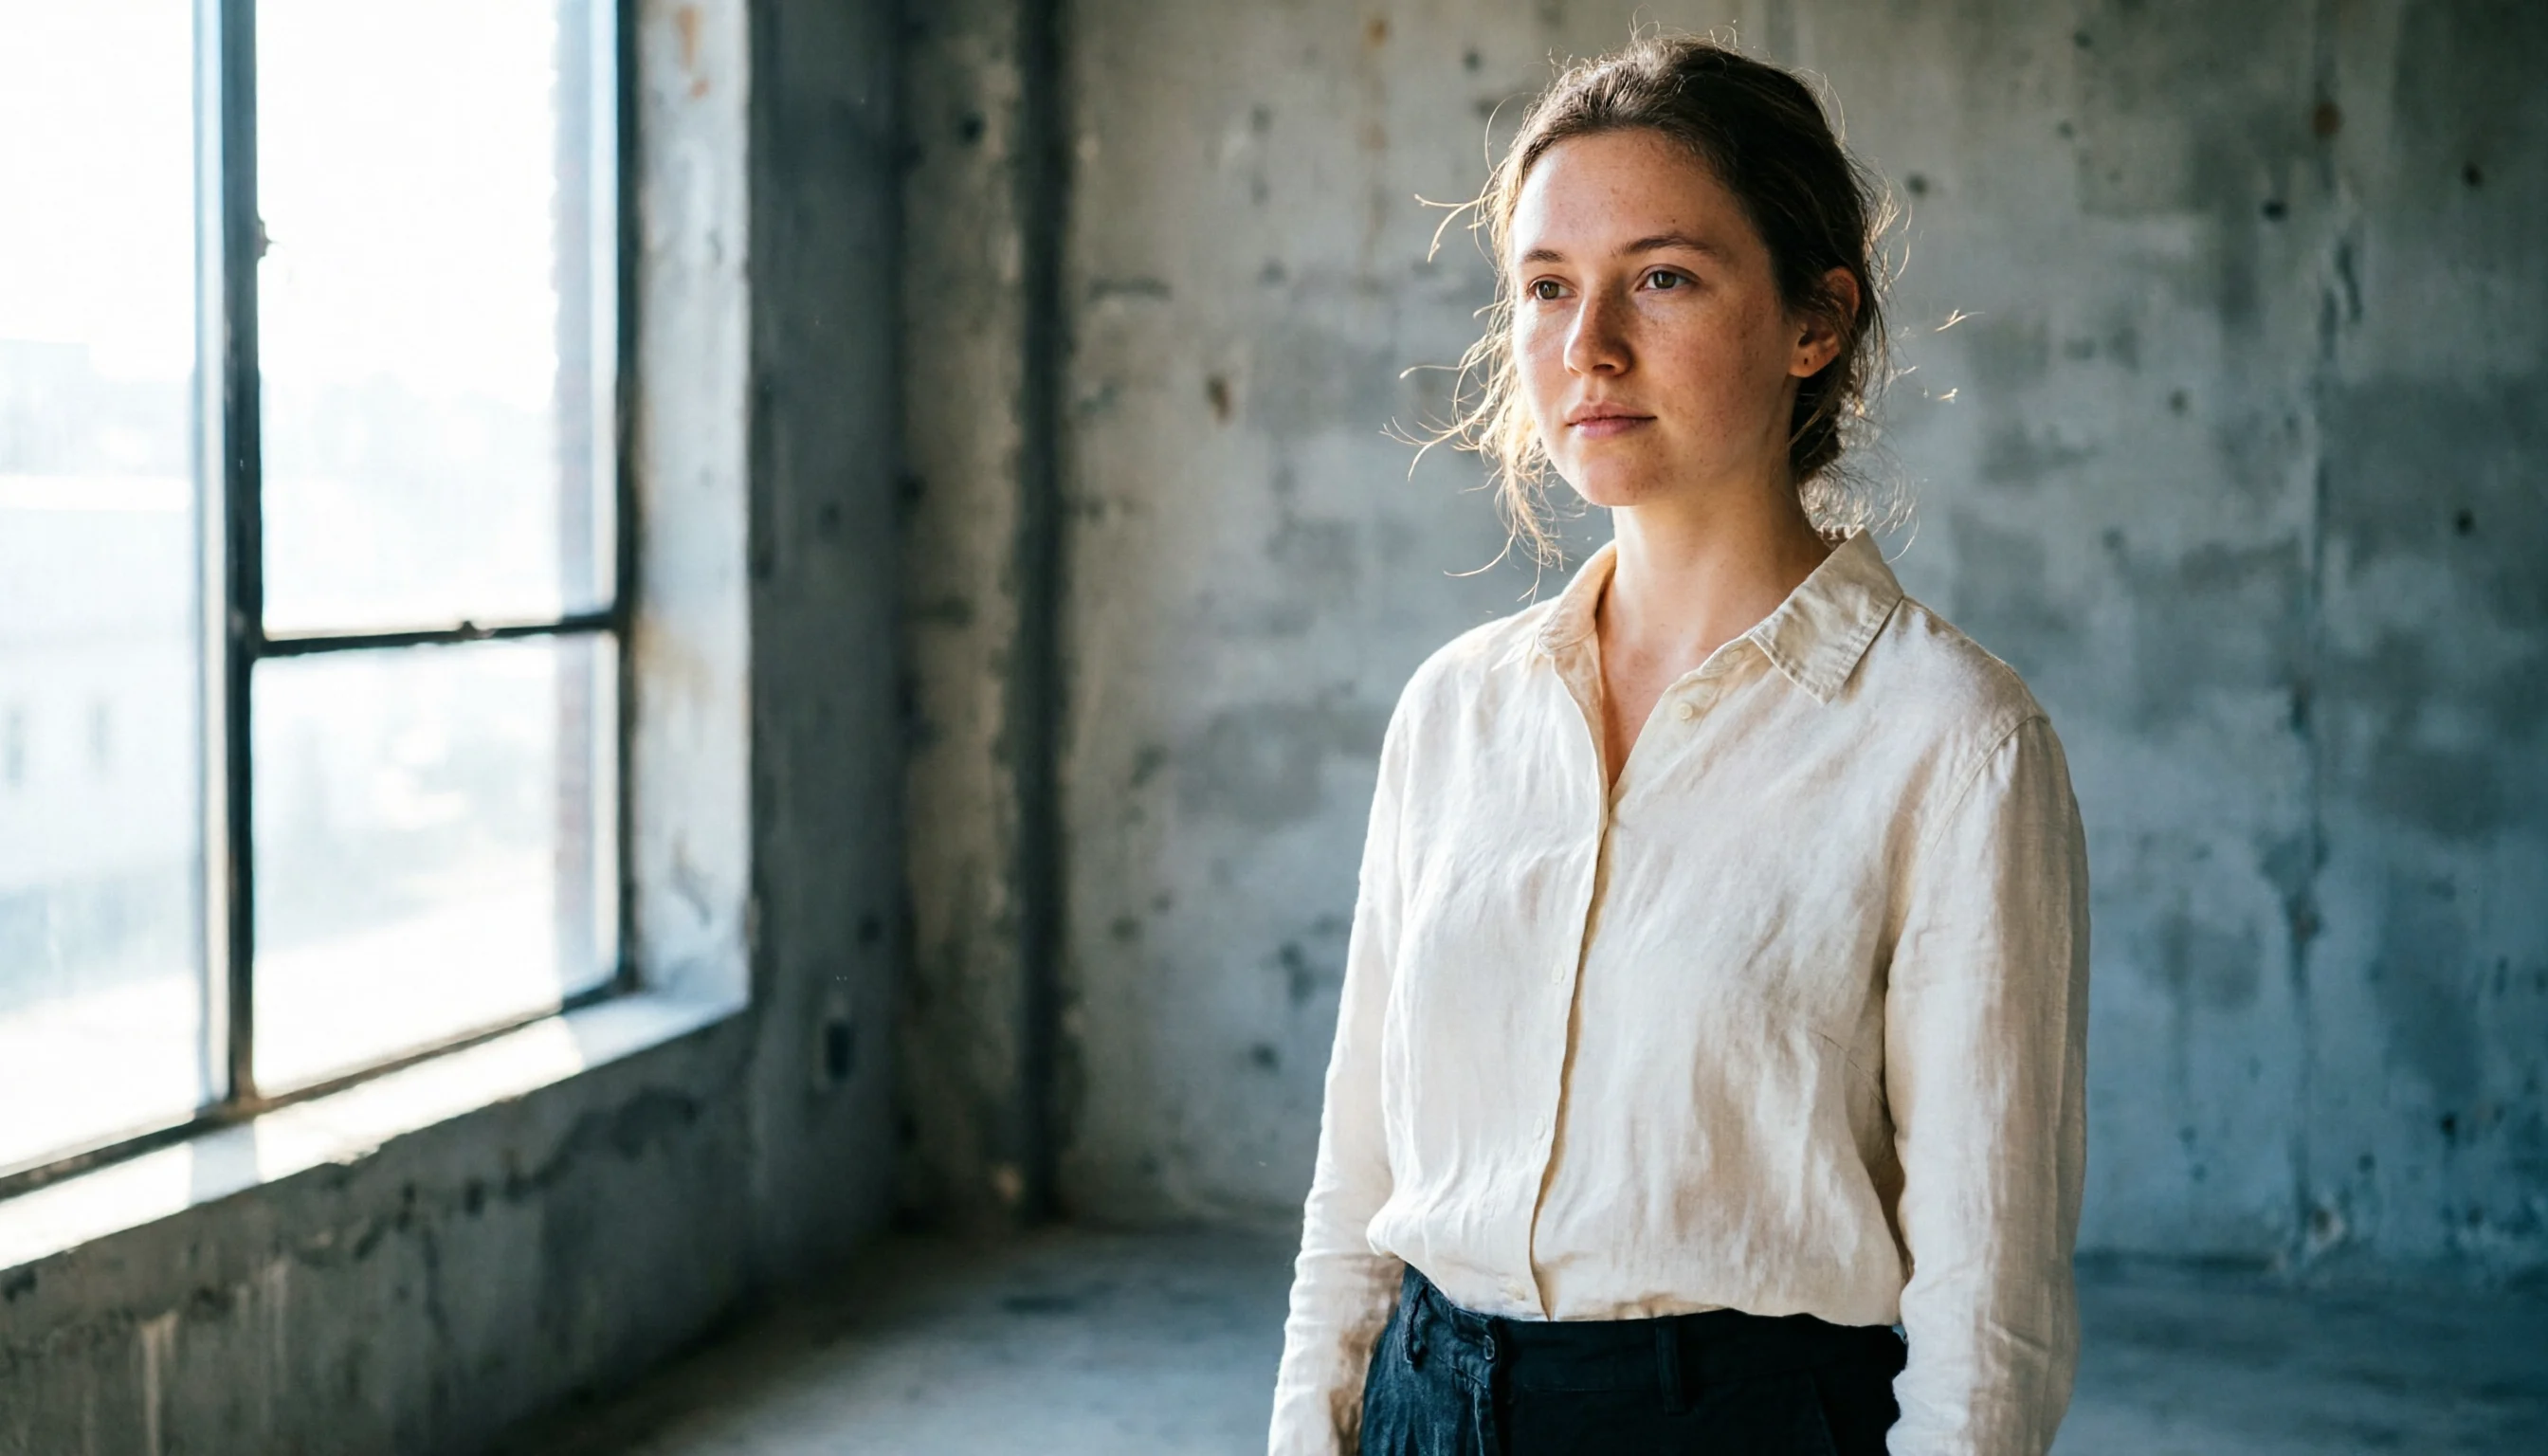
Confronto tra stili di ritratto con Qwen-Image-2.0: realismo e artisticità
Stile Ritratto e fotografia · Fotorealistico · Illuminazione da studio
Prompt
Ritratto a figura intera fotorealistico, una giovane donna in piedi in uno studio di cemento a vista, la luce diurna morbida e diffusa proveniente dalla grande finestra a sinistra cade sul suo viso e sulle spalle, texture della pelle naturale, pori visibili e leggere efelidi, ciocche sottili illuminate dalla luce, una sobria camicia di lino color avorio e pantaloni scuri, espressione calma e neutra, sguardo leggermente fuori dall'obiettivo, profondità di campo ridotta, sfondo con morbido sfocato, sottile separazione tra alte luci calde e ombre fredde, resa da obiettivo 85mm, composizione orizzontale 3:2, soggetto posizionato sul terzo destro, spazio negativo lasciato a sinistra, color grading cinematografico misurato, alto dettaglio, materiali realistici
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
qwen-image-2.0 per image
| Prezzo unitario | $0.0422 |
|---|
Panoramica della posizione
Qwen-Image-2.0 è un modello di generazione di immagini rilasciato da Alibaba, disponibile su HiAPI.ai tramite un'interfaccia di text-to-image. È pensato per gli sviluppatori che necessitano di output ad alta risoluzione e rendering di testo in cinese; supporta prompt positivi e negativi fino a 800 caratteri, può produrre immagini di livello 2K con scelta dell'orientamento orizzontale o verticale e offre la riscrittura intelligente dei prompt e la riproducibilità tramite seed. È adatto ai flussi di produzione di contenuti come poster, presentazioni e long-form con immagini, dove servono una resa stabile del testo in cinese e il controllo della composizione nella generazione batch.
Punti di forza principali
- Il rendering del testo in cinese è il principale elemento distintivo: presenta in modo stabile diversi font e testi cinesi piuttosto lunghi, ideale per materiali visivi con titoli e corpo del testo.
- Risoluzione di livello 2K e formati multipli: le dimensioni di output coprono cinque opzioni da 1536×2688 a 2688×1536, pensate sia per poster verticali sia per banner orizzontali.
- Riscrittura dei prompt e seed casuale: la riscrittura intelligente del prompt è attiva per impostazione predefinita per completare la descrizione e, insieme al parametro seed, consente di riprodurre il più possibile lo stesso risultato.
Descrizione delle capacità
Controllo tramite prompt positivi e negativi: il prompt positivo può arrivare a 800 caratteri, quello negativo a 500; è possibile descrivere il contenuto dell'immagine ed escludere gli elementi indesiderati, riducendo i tentativi ripetuti.
Cinque dimensioni di output: il formato di output si specifica come LARGHEZZA*ALTEZZA, con valore predefinito 2048*2048; sono disponibili altre quattro dimensioni verticali e orizzontali, così una singola chiamata corrisponde direttamente al posizionamento previsto.
Riscrittura intelligente del prompt: prompt_extend è attivo per impostazione predefinita e il modello completa le descrizioni più brevi; quando è necessario attenersi rigorosamente alla descrizione originale, è possibile disattivarlo esplicitamente.
Risultati riproducibili: fissando il seed casuale, a parità di parametri si riproduce il più possibile la stessa immagine, facilitando il confronto tra versioni e il debug in batch.
Interruttore opzionale per la filigrana: il parametro watermark controlla se aggiungere la filigrana Qwen-Image, così da decidere in base al canale di pubblicazione se l'immagine finale debba riportare il marchio.
Casi d'uso
- Produzione batch di poster in cinese da parte dei team marketing: inserendo prompt con titolo principale e punti di forza si ottengono immagini finite nel formato verticale specificato, pronte per pagine evento e pubblicazioni sui social.
- Realizzazione di long-form con immagini e vignette a fumetti da parte dei team contenuti: con prompt più lunghi si descrivono composizioni a più riquadri e testi di dialogo, ottenendo illustrazioni di accompagnamento per long-form su WeChat o contenuti a puntate.
- Esplorazione di bozze nel flusso di design: con prompt brevi si attiva la riscrittura intelligente per generare immagini in batch e, fissando il seed, si seleziona la direzione da usare come riferimento per il design definitivo.
Limiti e consigli di scelta
L'output massimo è di livello 2K; se servono risoluzioni più elevate o modifiche locali accurate, occorre valutare altri modelli che supportino risoluzioni superiori e capacità di editing. I confini delle sue capacità sono concentrati sul text-to-image e sul rendering del testo; non è adatto a compiti guidati dalla conoscenza come il retrieval-augmented o il ragionamento a più passaggi. L'interfaccia accetta solo prompt testuali, senza canale di input per immagini, quindi non può modificare immagini esistenti. Quando è necessario attenersi rigorosamente alla descrizione originale, si consiglia di disattivare la riscrittura del prompt e di fissare il seed per controllare le variabili.
Novità
Vedi il changelog →- Nuovo modello qwen-image-2.0-pro è disponibile: supporta la generazione di immagini da testo, prezzo standard $0.107/immagine
Domande frequenti
Vedi tutte le domande →-
A quali attività è principalmente adatto Qwen Image 2.0?
Un modello conveniente che supporta il cinese, i prompt negativi, l'espansione dei prompt, Seed opzionale e cinque dimensioni in pixel 2K.
-
Qwen Image 2.0 supporta le immagini di riferimento?
La linea attuale è di pura generazione di immagini da testo e non accetta immagini di riferimento.
-
Quali specifiche di output sono supportate?
La pagina attuale mostra 2688×1536, 2368×1728, 2048×2048, 1728×2368, 1536×2688 e ; le opzioni finali sono soggette ai parametri del Playground.
-
Come viene fatturato Qwen Image 2.0?
In base al numero di immagini generate con successo; eventuali differenze tra risoluzioni o livelli di qualità sono mostrate nel prezzo in tempo reale sulla pagina.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: qwen-image-2.0
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per qwen-image-2.0 e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionalemin 0max 2147483647Seme casuale, utilizzato per riprodurre il più possibile lo stesso risultato con gli stessi parametri. Passare un numero intero; se non fornito, viene generato casualmente dal server.
sizestringOpzionalePredefinito: "2048*2048"Dimensione dell'immagine di output, espressa come stringa nel formato larghezza*altezza. Predefinito 2048*2048.
2688*15362368*17282048*20481728*23681536*2688promptstringObbligatoriomaxLength 800Prompt positivo, utilizzato per descrivere il contenuto, lo stile e la composizione dell'immagine che si desidera generare.
watermarkbooleanOpzionalePredefinito: falseIndica se aggiungere la filigrana Qwen-Image all'immagine di output. Predefinito false.
prompt_extendbooleanOpzionalePredefinito: trueIndica se abilitare la riscrittura intelligente del prompt, espandendo e ottimizzando automaticamente il prompt inserito. Predefinito true.
negative_promptstringOpzionalePredefinito: ""maxLength 500Prompt negativo, utilizzato per descrivere il contenuto che non si desidera compaia nel risultato generato. Predefinito stringa vuota.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-2.0",
  "input": {
    "size": "2048*2048",
    "prompt": "…",
    "watermark": false,
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-2.0",
input: {
"size": "2048*2048",
"prompt": "…",
"watermark": false,
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-2.0",
"input": {
"size": "2048*2048",
"prompt": "…",
"watermark": False,
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Nano Banana 2 Lite Google $0.033 /immagine
-
 Grok Imagine xAI $0.011 /secondo
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /immagine
-
 BRIA Eraser Bria $0.058 /immagine
-
 Muse Image 1.0 Meta $0.015 per task
-
 GPT Image 2 OpenAI $0.007 /immagine
-
 FLUX 3 Image Black Forest Labs $0.041 /immagine
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /immagine
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /immagine
-
 Z-Image Alibaba $0.008 /immagine
-
 Ideogram V4.5 Ideogram $0.011 /immagine
-
 Grok Imagine Image 2.0 xAI $0.052 /immagine
Stesso fornitore
-
 HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caratteri
- Z-Image Alibaba $0.008 /immagine
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
-
 Qwen Image 3.0 Alibaba $0.036 /immagine