
ByteDance
Seedream 4.5
seedream-4.5/text-to-image
Modello di immagini di livello commerciale di ByteDance, incentrato su illuminazione cinematografica, coerenza dei personaggi tra diverse inquadrature e modifica con riferimento a più immagini, ideale per immagini ad alta risoluzione destinate a e-commerce e materiali di marketing
Prova seedream-4.5/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image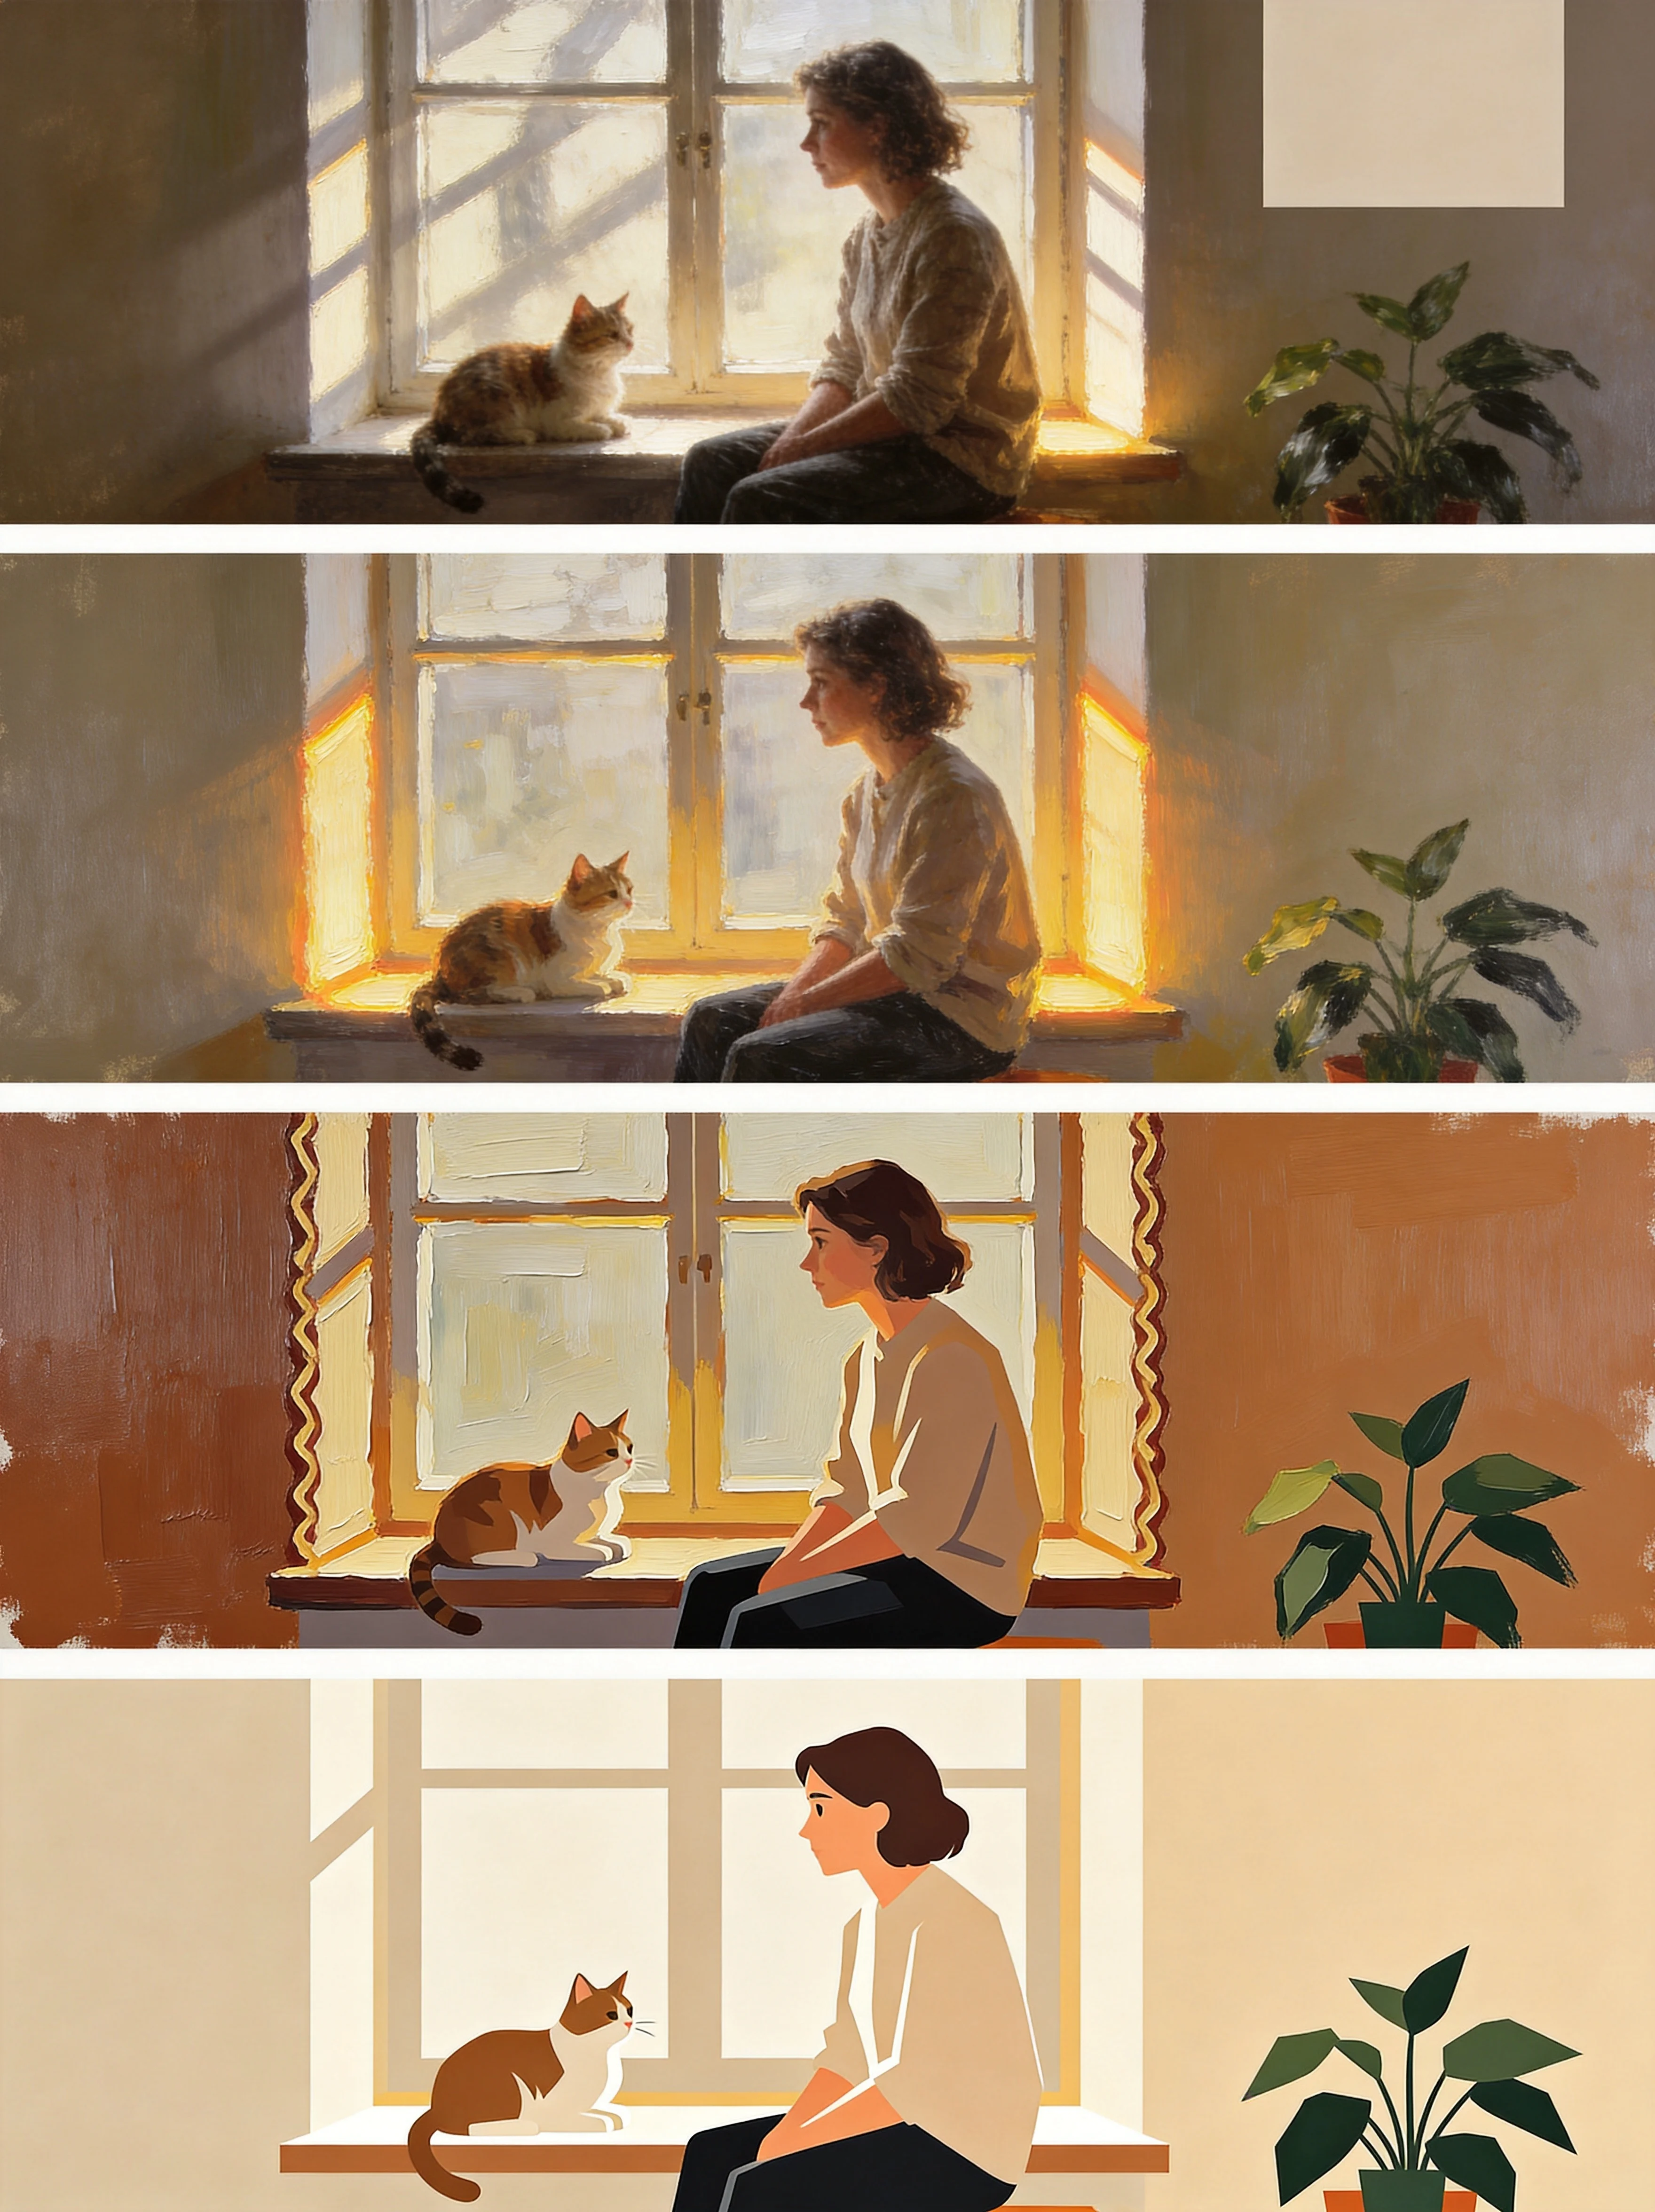
Dal realismo al flat: illustrazione in quattro riquadri lungo uno spettro stilistico
Stile spettro-di-stile · editorial-illustration · Illuminazione
Prompt
Un concept di illustrazione editoriale presentato come striscia comparativa orizzontale a quattro riquadri, in cui tutti i pannelli condividono la stessa composizione: una figura seduta con un gatto su un davanzale basso, una pianta sulla destra, una cornice di finestra essenziale sullo sfondo, il soggetto rivolto verso sinistra e ampio spazio negativo in alto a destra. Riquadro 1, realismo fotografico cinematografico: luce volumetrica dalla finestra, ombre morbide complesse, texture visibili di pelle e tessuto, profondità di campo ridotta. Riquadro 2, pittorico semi-realistico: pennellate morbide, calda luce di contorno, semplificato ma con volume conservato. Riquadro 3, impasto decorativo: pennellate spesse e visibili, palette ad alta saturazione, prospettiva appiattita con bordi texturizzati. Riquadro 4, vettoriale minimale e flat: forme bicromatiche, bordi netti e puliti, nessun gradiente, semplificazione geometrica. Transizione coerente della temperatura colore tra i pannelli, linee di separazione nette, composizione panoramica in 16:9, alto dettaglio, livello di direzione artistica professionale.
Copia il prompt completo e adattalo alla tua generazione.
Tag
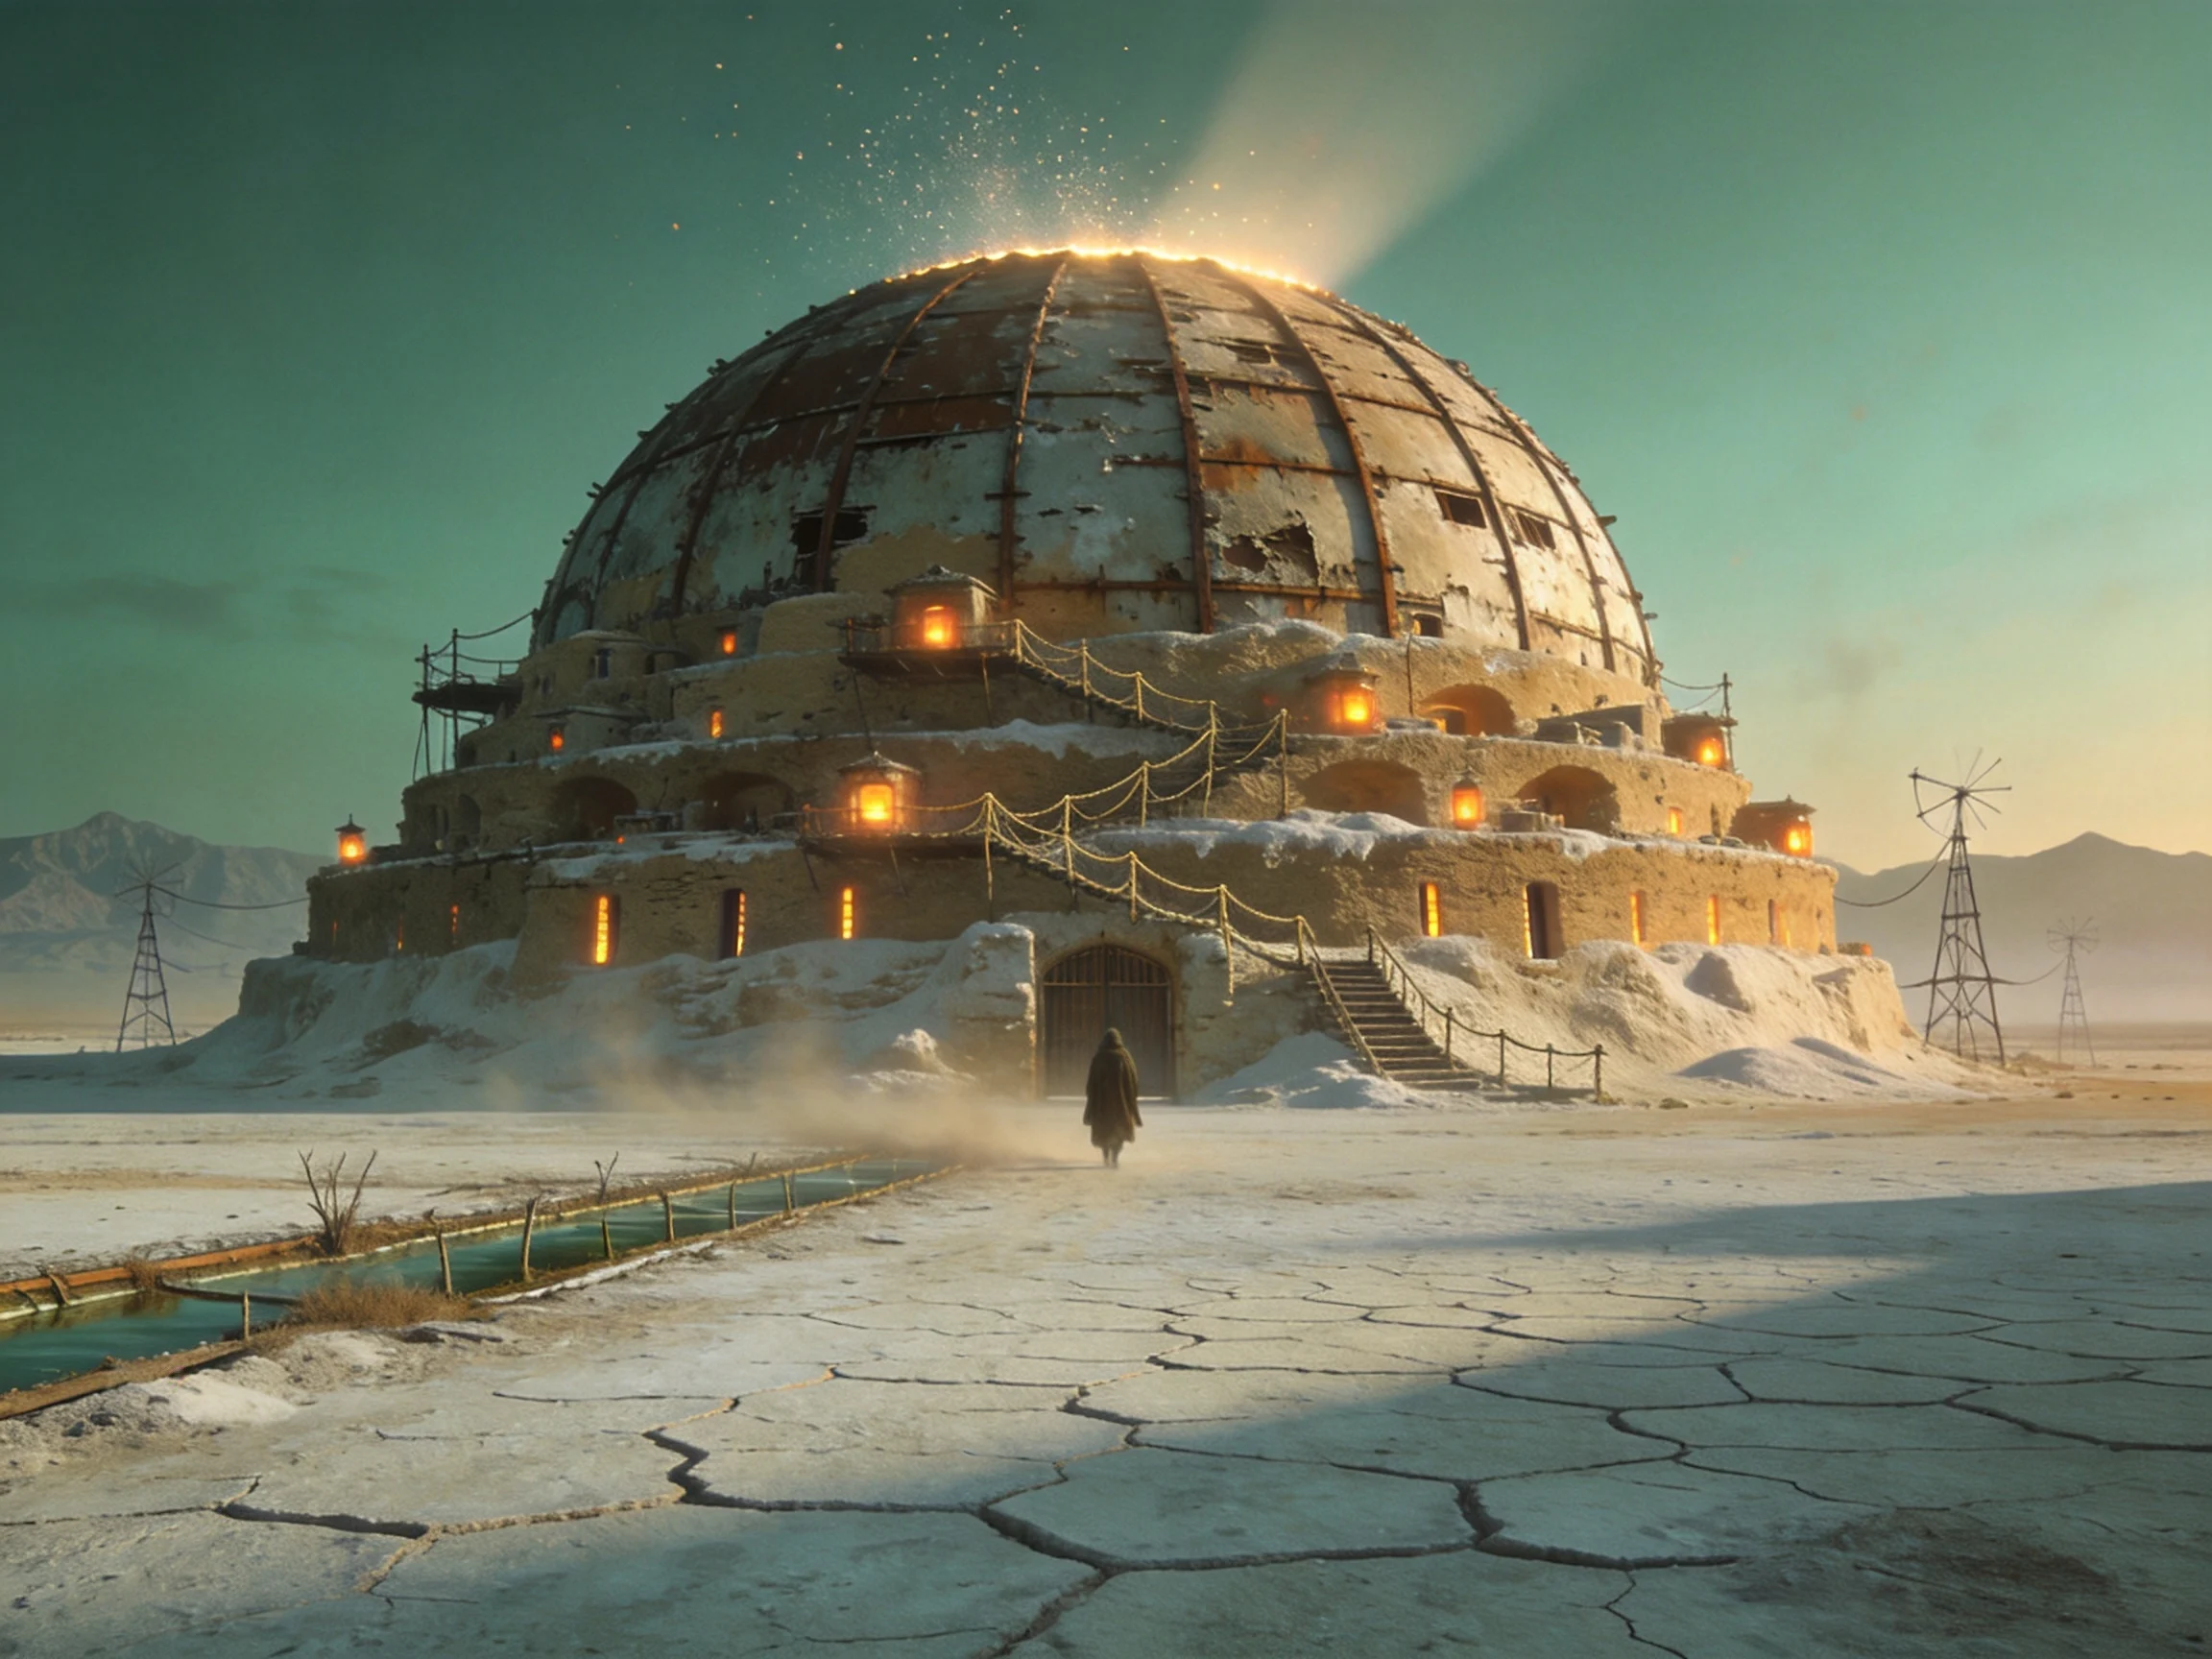
Concept art del worldbuilding: la città a cupola nel mare di sabbia al crepuscolo
Stile Concept art · Cinematografico · Costruzione del mondo
Prompt
Inquadratura panoramica cinematografica in formato ampio: un enorme insediamento a forma di cupola si erge al crepuscolo su una pallida distesa salina desertica alcalina, costruito con arenaria incrostata di sale e nervature metalliche di recupero. Struttura architettonica stratificata: una cupola esterna erosa dagli agenti atmosferici, anelli abitativi a terrazze scavati alla base, strette scalinate e ponti di corda, piccoli gruppi di calde lanterne ambrate che trapelano da fessure sottili come finestre. Primo piano: particelle di polvere fine sollevate dal vento su un terreno poligonale di saline crepate, una figura solitaria avvolta in un mantello antipolvere che si dirige verso il cancello, per suggerire la scala. Piano intermedio: canali di irrigazione prosciugati e torri del vento dall'aspetto ossuto. Sfondo: basse silhouette montuose sfumate che si dissolvono nella foschia atmosferica. Fasci di luce volumetrica divina che filtrano sotto il bordo della cupola, ombre lunghe e morbide, particelle di polvere sospese nell'aria, texture realistiche di pietra e metallo, sottile grana cinematografica, profondità di campo da lente anamorfica, color grading cinematografico 35mm, ombre ciano e alte luci calde, concept art fotorealistica, dettagli estremi, composizione 16:9, linea dell'orizzonte posizionata molto in basso.
Copia il prompt completo e adattalo alla tua generazione.
Tag
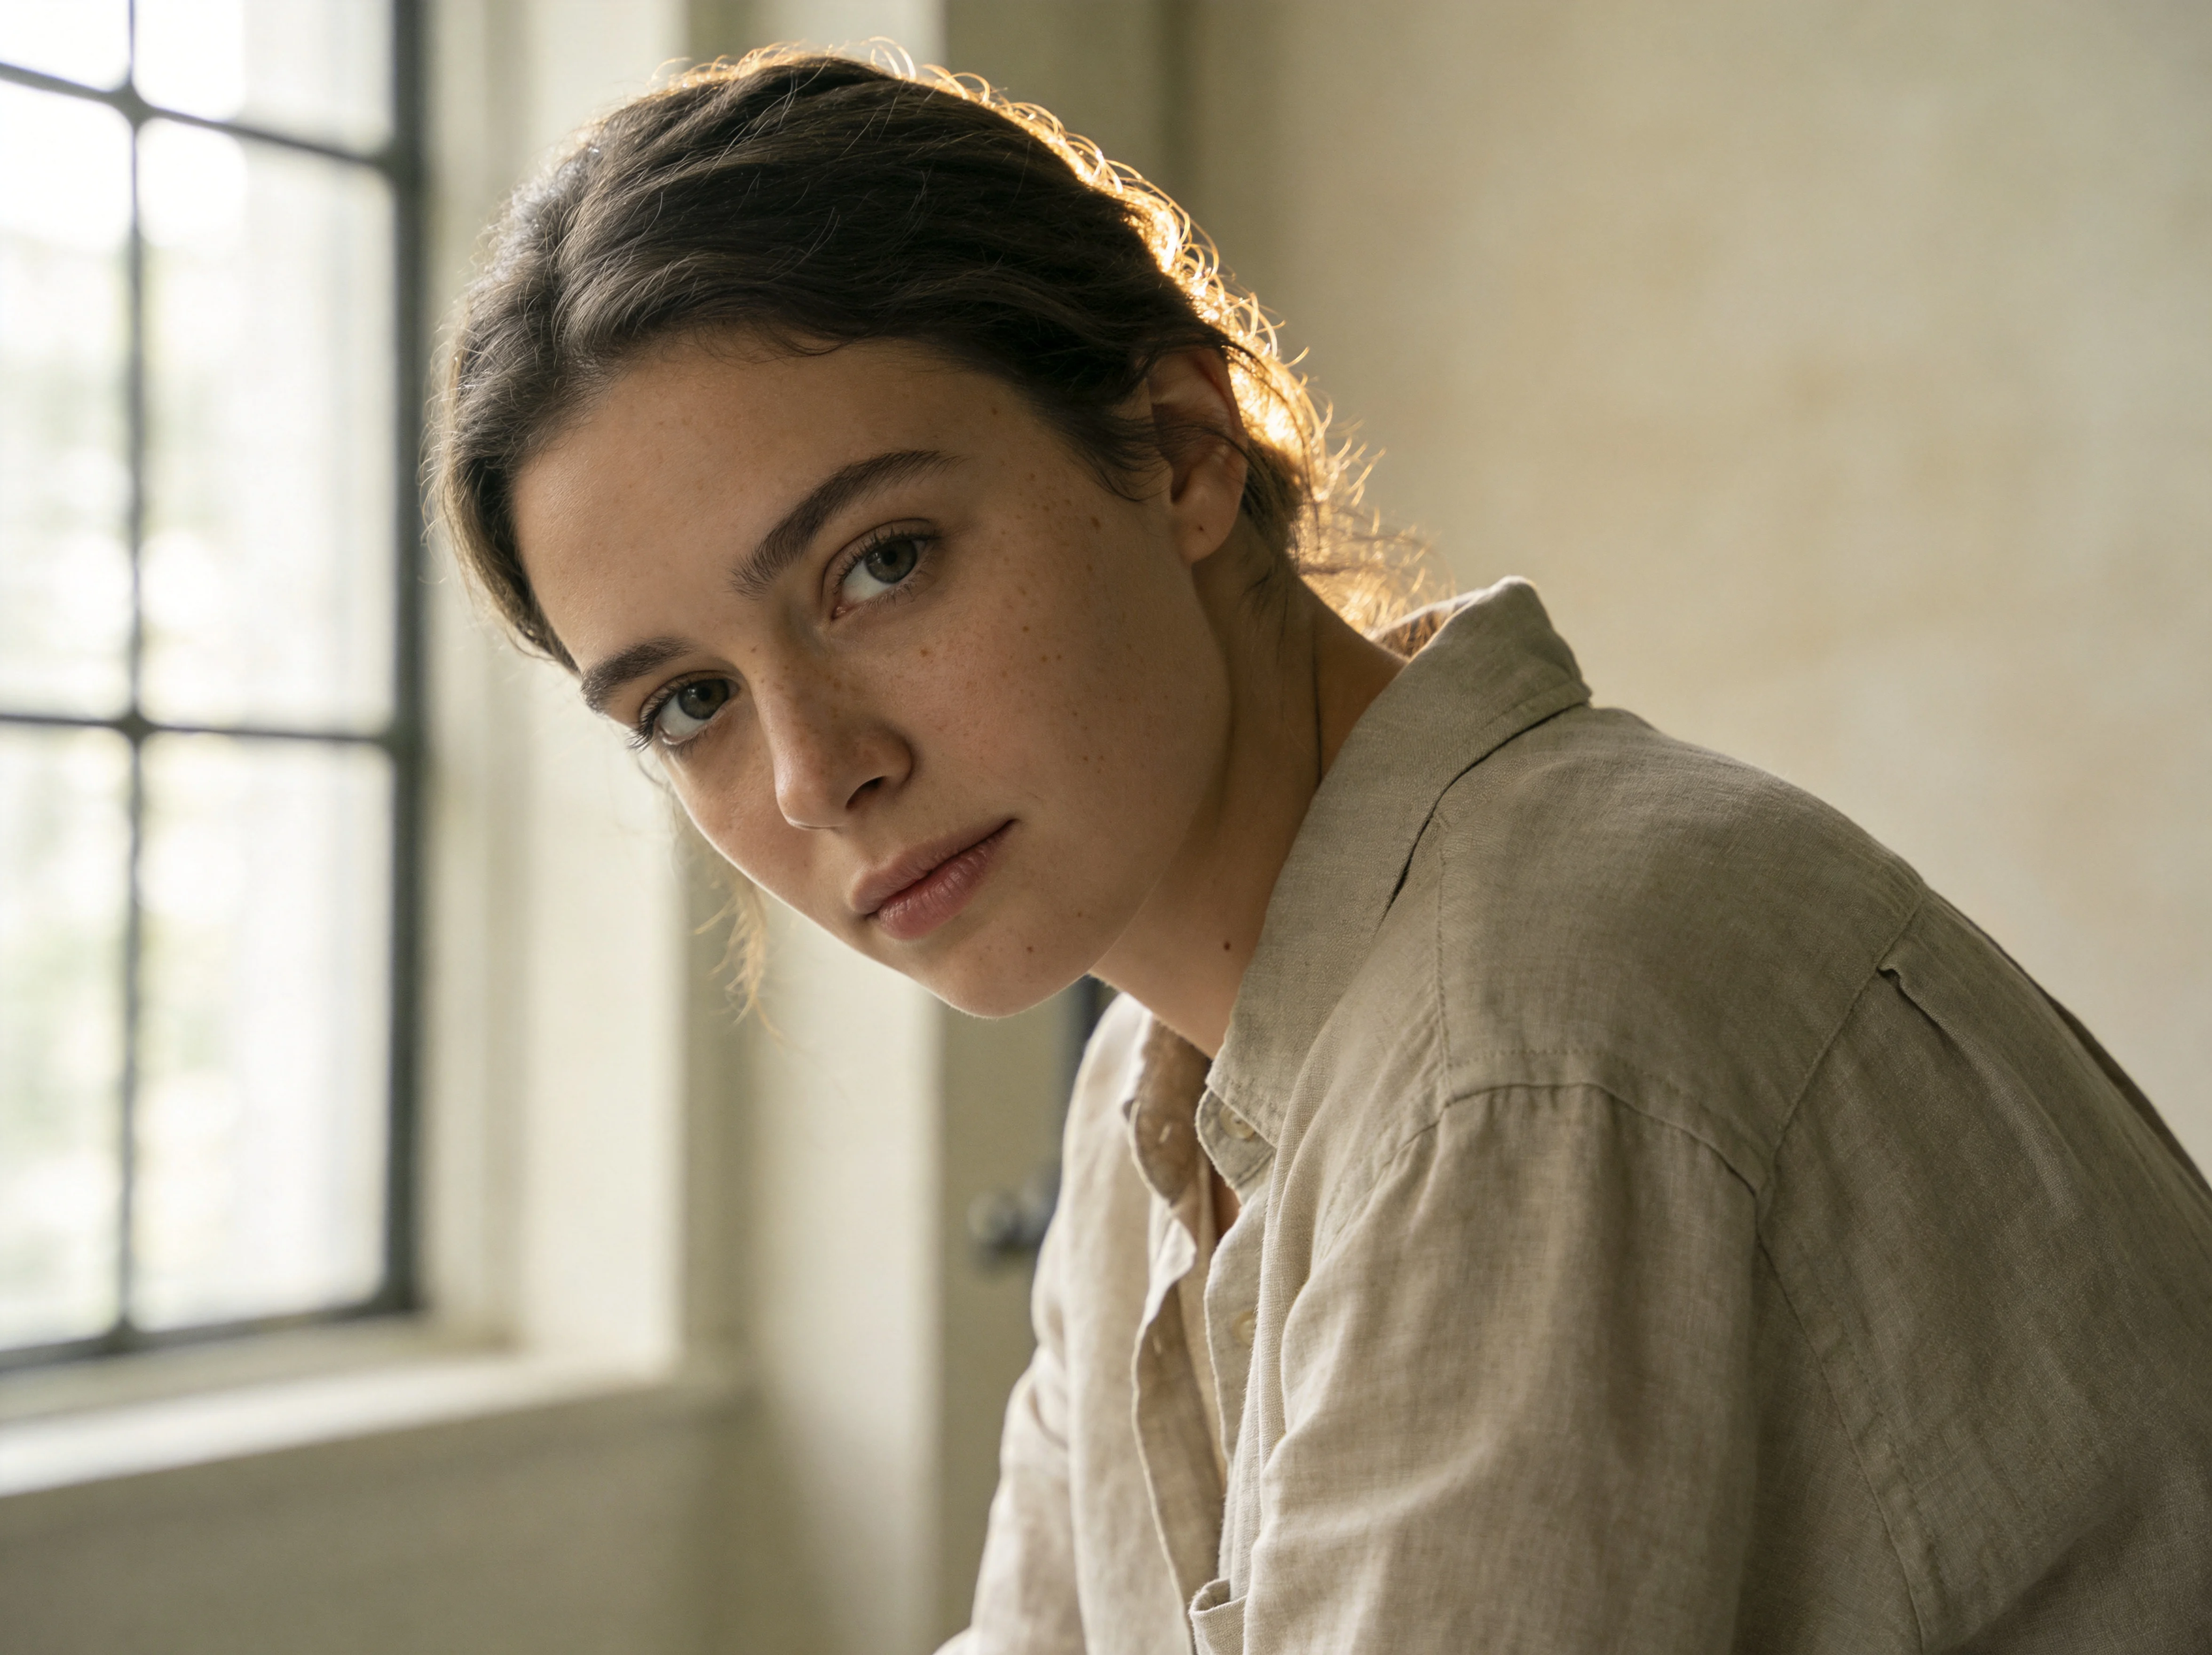
Seedream 4.5 riferimento doppio stile per ritratti: realistico e artistico
Stile Ritratto e fotografia · Fotorealistico · Editoriale
Prompt
Ritratto realistico in stile editoriale: una giovane donna con una camicia di lino, seduta accanto a una grande finestra in un tranquillo studio, luce diurna morbida e diffusa proveniente da sinistra rispetto alla fotocamera, che crea una progressiva e morbida attenuazione della luce volumetrica, sottile luce di contorno sui capelli, texture naturale della pelle visibile, inclusi pori fini e lentiggini chiare, profondità di campo ridotta con un bokeh morbido e cremoso, resa tipica di un obiettivo 85mm, tonalità calde e neutre a bassa saturazione, color grading cinematografico, alta gamma dinamica, dettagli degli occhi nitidi e definiti, senza testo, dettagli ultra-fini
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
seedream-4.5/text-to-image per image
| Prezzo unitario | $0.045 |
|---|
Panoramica e posizionamento
La linea text-to-image di Seedream 4.5 è pensata per sviluppatori che necessitano di output visivi controllabili e riutilizzabili, generando immagini in stile realistico direttamente da un prompt testuale. Supporta due risoluzioni native, 2K e 4K, e otto rapporti d'aspetto da 1:1 a 21:9, con un limite di 3000 caratteri per il prompt. È adatta a task di generazione batch come immagini di prodotto per l'e-commerce, materiali di marketing, concept per cinema e design, dove qualità e composizione hanno requisiti precisi; l'integrazione nei flussi di generazione esistenti avviene tramite l'interfaccia unificata di HiAPI.ai.
Punti di forza principali
- Output nativo diretto in 2K/4K ad alta risoluzione——è possibile scegliere l'uscita standard 2K o ultra HD 4K, eliminando il passaggio di upscaling dopo la generazione a bassa risoluzione.
- Otto rapporti d'aspetto per i formati più diffusi——dal quadrato 1:1 al formato largo 21:9, specificabili direttamente, per adattarsi a layout diversi come e-commerce, social media e banner.
- Illuminazione cinematografica e resa realistica——secondo le ricerche, simula la nebbia volumetrica e le ombre complesse della fotografia reale, con un risultato finale più vicino a uno scatto autentico.
- Prompt più lunghi per descrizioni complesse——il limite di 3000 caratteri consente di descrivere in una singola richiesta scena, materiali e relazioni spaziali.
Descrizione delle capacità
Generazione text-to-image realistica: basta inserire una descrizione testuale per ottenere un'immagine in stile realistico, trasformando direttamente l'idea creativa in un elaborato visivo consegnabile, riducendo i costi di disegno manuale o di ripresa fotografica.
Risoluzione e formato controllabili: tramite i parametri resolution e aspect_ratio si specificano output 2K o 4K e otto rapporti larghezza-altezza; una singola chiamata restituisce un'immagine adatta al formato di destinazione, senza necessità di ritagli successivi.
Interpretazione di prompt complessi: prompt fino a 3000 caratteri possono contenere descrizioni stratificate di scena, soggetto e composizione; secondo le ricerche, questa versione migliora rispetto alla precedente nell'aderenza al prompt e nell'accuratezza dei dettagli.
Qualità di livello commerciale: le ricerche indicano che illuminazione, resa della pelle e rendering del testo sono vicini alla resa fotografica, adatti a una consegna diretta al cliente e non solo a bozze.
Scenari d'uso
- Operazioni e-commerce: generazione batch di immagini di scena per prodotti——descrivendo con testo il prodotto e l'atmosfera della scena si producono immagini principali e di contesto ad alta risoluzione pubblicabili, per pagine di dettaglio prodotto e materiali pubblicitari.
- Team marketing: poster promozionali con testo——inserendo requisiti di layout e copy si generano poster e banner con testo nitido e leggibile, utilizzabili direttamente sui social e negli spazi pubblicitari.
- Cinema e gaming: concept e storyboard——generazione batch a partire da copioni o descrizioni di ambientazione per produrre concept design e tavole di storyboard, utili alle discussioni preliminari e alla definizione della direzione artistica.
- Team di design: elaborati visivi multi-formato——grazie ai vari rapporti d'aspetto e alle risoluzioni 2K/4K si producono rapidamente elaborati adatti a terminali diversi, per presentazioni al cliente e iterazioni.
Limiti e consigli di scelta
Questa linea accetta solo input testuali; per modificare immagini esistenti o comporre con riferimenti occorre usare la linea image-to-image della stessa serie. Le ricerche segnalano che la generazione a livello 4K richiede molta potenza di calcolo e tempi più lunghi: per scenari sensibili alla latenza è necessario valutare il costo di attesa. Le capacità descritte sono per lo più miglioramenti rispetto a Seedream 4.0 e mancano confronti indipendenti con altri modelli contemporanei; in fase di scelta si consiglia di testare l'effettiva resa con campioni del proprio business prima di decidere.
Domande frequenti
Vedi tutte le domande →-
Qual è la differenza tra image-to-image e text-to-image in Seedream 4.5?
L'endpoint image-to-image utilizza l'immagine caricata come base per la modifica, ed è adatto per cambiare colori, sostituire lo sfondo, ricalibrare l'illuminazione, convertire lo stile e comporre più immagini; il text-to-image, invece, genera l'immagine da zero basandosi solo sul testo. Quando è necessario preservare il soggetto, la composizione o il testo all'interno dell'immagine, è consigliabile utilizzare il modello image-to-image corrente.
-
Quante immagini di riferimento supporta al massimo Seedream 4.5?
Ogni richiesta può caricare da 1 a 14 immagini JPEG, PNG o WebP, con una dimensione massima di 10 MB per file; SVG non è supportato. Per le attività con più immagini, è possibile specificare esplicitamente lo scopo di ciascuna immagine nel Prompt usando “image 1” e “image 2”; l'ordine deve corrispondere a quello dell'array image_urls.
-
Come viene tariffata la modifica delle immagini con Seedream 4.5? Il numero di immagini di riferimento influisce sul prezzo?
La tariffazione si basa sulle immagini di output generate con successo, non sul numero di immagini di riferimento. Attualmente 2K e 4K utilizzano la stessa tariffa pubblica; l'importo esatto è determinato dal prezzo in tempo reale nella pagina del modello e dal registro delle attività.
-
Come si può far sì che Seedream 4.5 preservi il soggetto, la composizione o il testo presente in un'immagine?
Nel prompt occorre indicare chiaramente sia "cosa deve cambiare" sia "cosa deve rimanere invariato", ad esempio il contorno del soggetto, l'angolazione della fotocamera, l'ombra di contatto, la disposizione del negozio o il testo calligrafico. Verifica prima il risultato nel Playground; per materiali con testo di marca e requisiti di impaginazione rigorosi, si consiglia di mantenere una fase di revisione manuale.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: seedream-4.5/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per seedream-4.5/text-to-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 4maxLength 3000Prompt testuale che descrive il contenuto dell'immagine da generare, in formato stringa, lunghezza massima 3000 caratteri.
resolutionstringObbligatorioPredefinito: "2K"Livello di nitidezza dell'immagine di output, in formato stringa; 2K è la qualità standard, 4K è ultra HD; predefinito 2K.
2K4Kaspect_ratiostringObbligatorioPredefinito: "1:1"Rapporto di aspetto dell'immagine generata, in formato stringa; predefinito 1:1.
1:14:33:416:99:162:33:221:9callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "seedream-4.5/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "seedream-4.5/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "seedream-4.5/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Seedream 4.5 ByteDance $0.045 /immagine
-
 851 Labs Background Remover 851 Labs $0.002 /immagine
-
 Ideogram V3 Character Ideogram $0.090 /immagine
-
 Nano Banana 2 Google $0.036 /immagine
-
 Nano Banana Google $0.021 /immagine
-
 FLUX.2 Black Forest Labs $0.035 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Nano Banana Pro Google $0.057 /immagine
-
 Krea 2 Medium Turbo Krea $0.021 /immagine
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Ideogram V4.5 Ideogram $0.011 /immagine


