
ByteDance
Seedream 5.0
seedream-5.0-pro/text-to-image
Modello di generazione di immagini di livello produttivo di ByteDance, che supporta ricerca online e ragionamento logico in più passaggi, output in 4K e modifica basata su esempi, ideale per la creazione di immagini di prodotto e infografiche
Prova seedream-5.0-pro/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image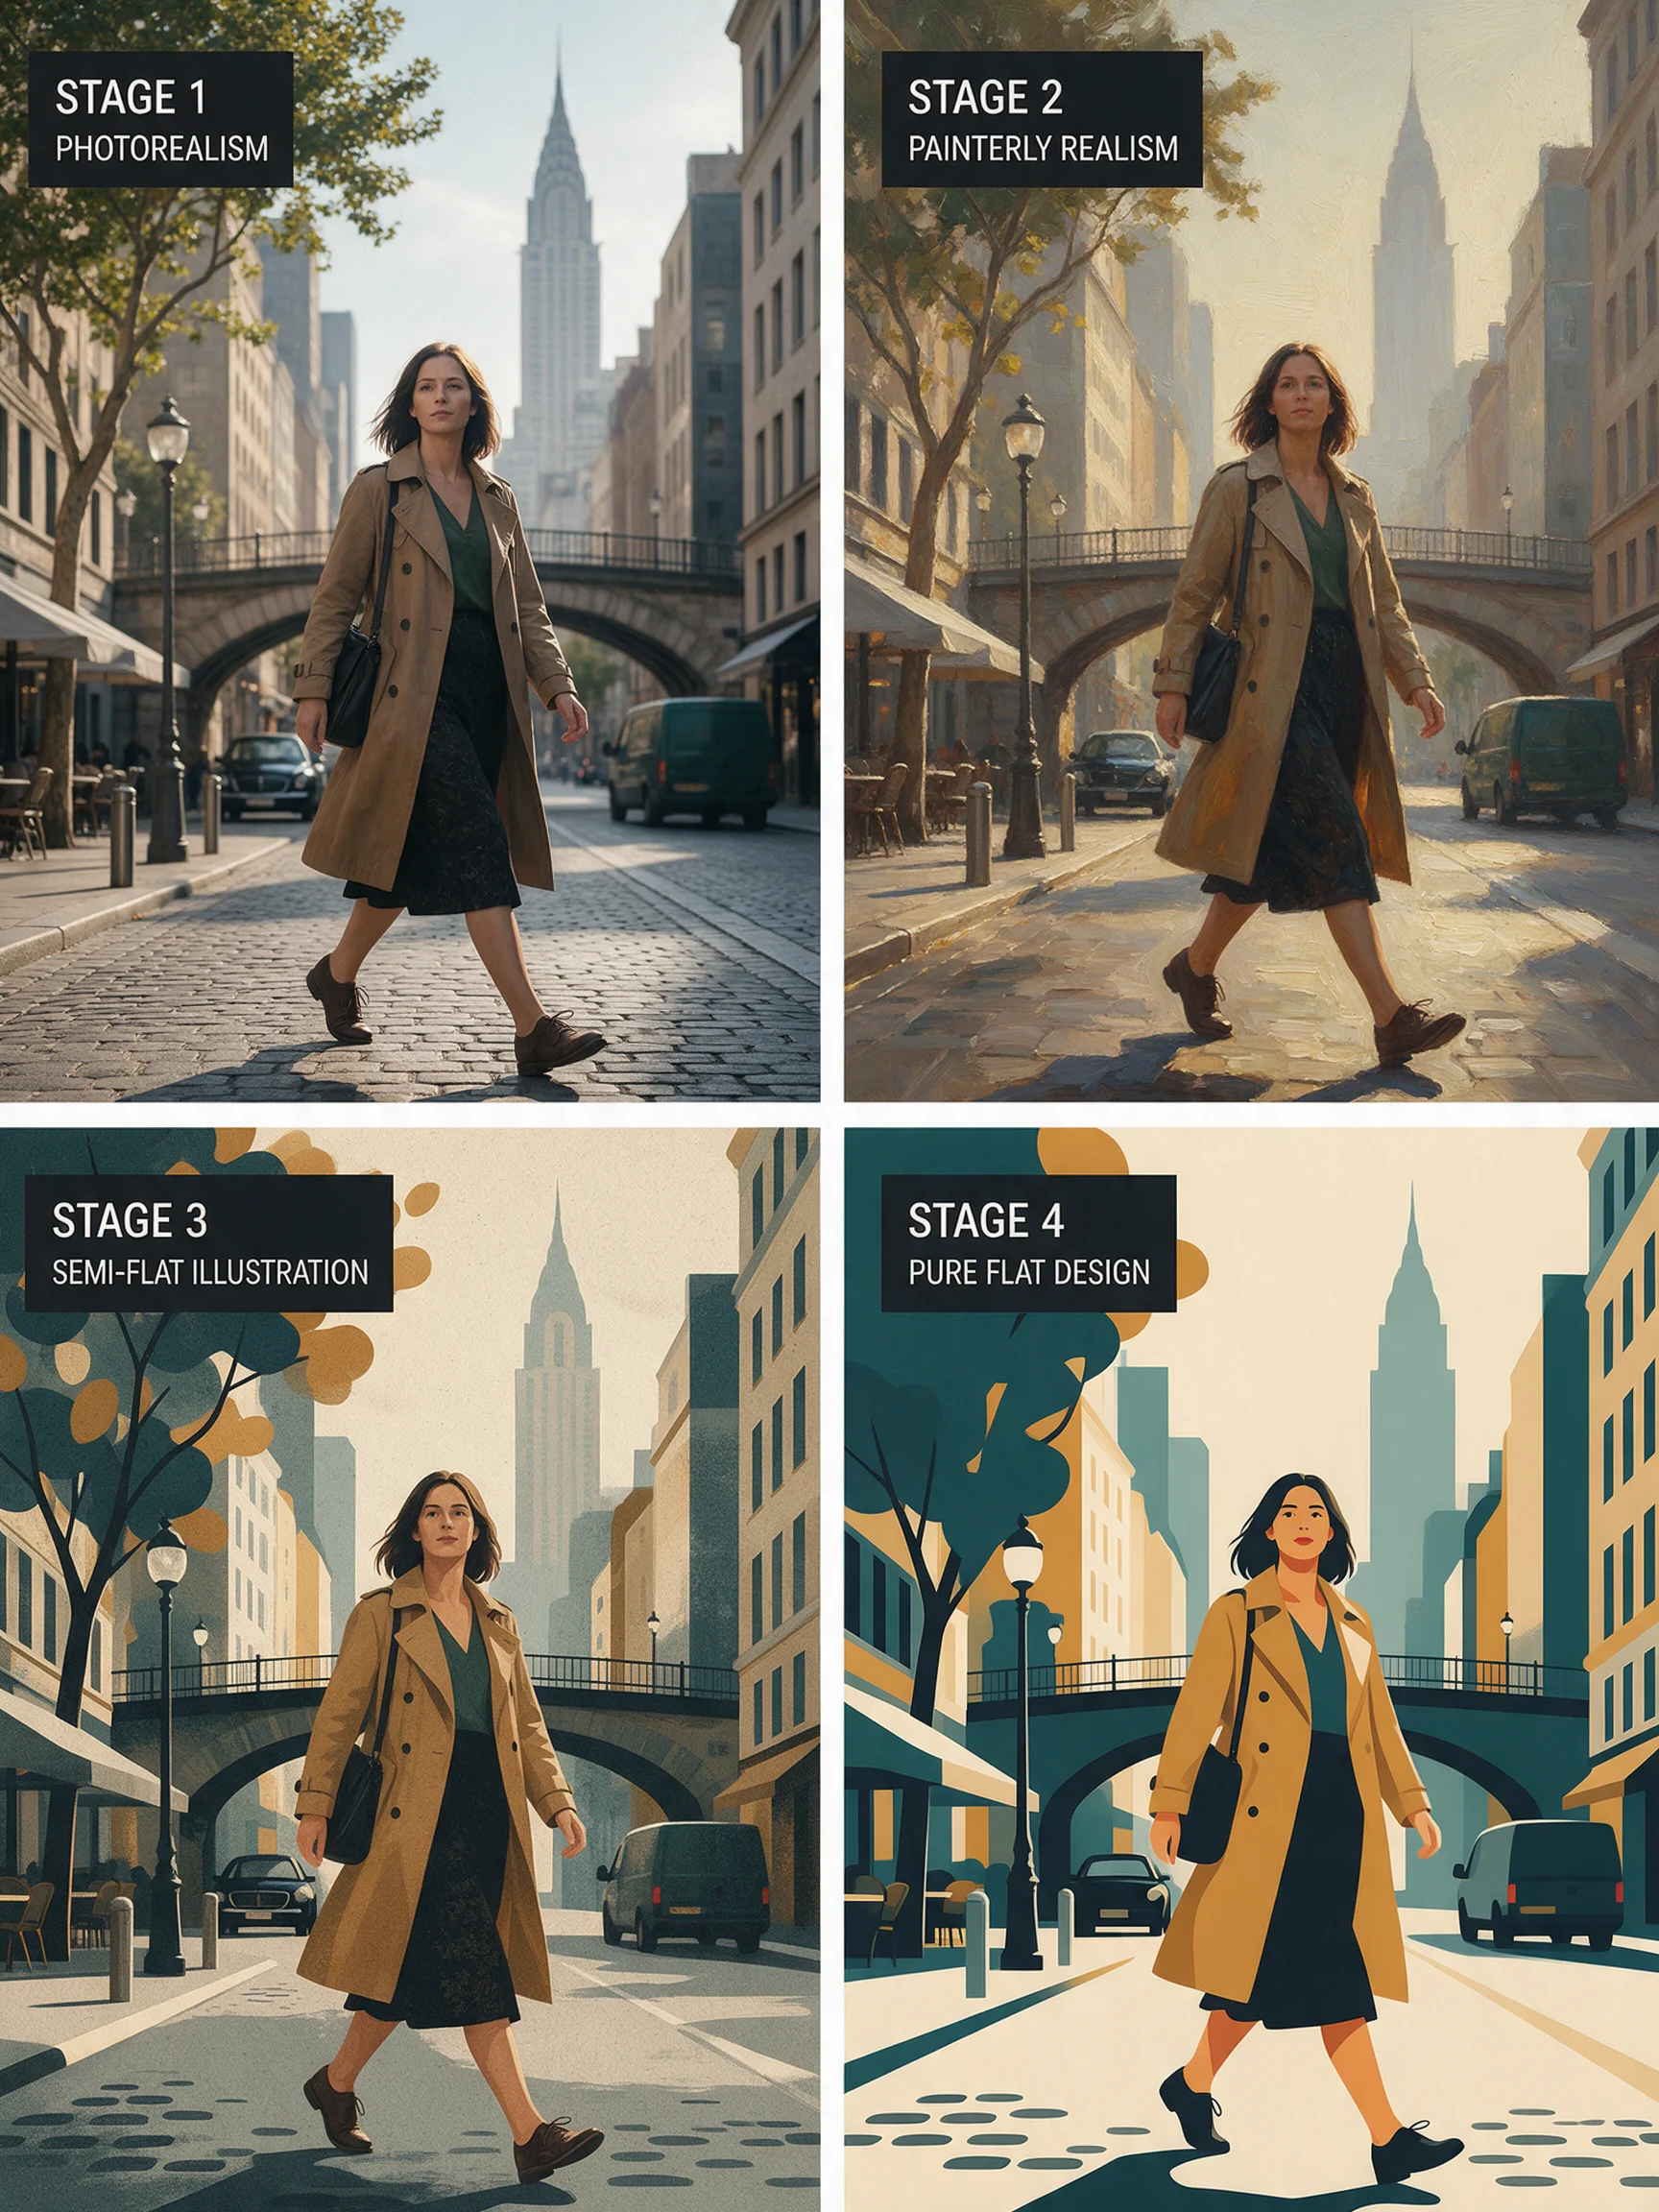
Dal realismo al flat: confronto a quattro livelli sullo spettro degli stili illustrativi
Stile Illustrazione · Studio di stile · Design piatto
Prompt
Studio dello spettro stilistico in quattro fasi presentato sulla stessa composizione: figura in primo piano che cammina, strada urbana in piano intermedio, skyline sullo sfondo. Fase uno, realismo fotografico: luce diurna naturale, texture cutanea e trama del tessuto visibili, profondità di campo reale, grana fotografica sottile. Fase due, realismo pittorico: stessa scena, ma con pennellate visibili, bordi ammorbiditi, luce riflessa calda, tonalità leggermente desaturate. Fase tre, illustrazione semi-flat: volume semplificato, chiaroscuro a due tonalità, silhouette nitide, palette limitata composta da verde acqua tenue, ocra e crema. Fase quattro, design puramente flat: campiture geometriche, nessun gradiente, forme dai bordi netti, palette flat audace. Tutte le fasi mantengono composizione e posa del soggetto coerenti, composizione orizzontale 3:2, qualità da immagine di riferimento per la direzione artistica editoriale.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
seedream-5.0-pro/text-to-image per image
| Specifiche | Prezzo unitario |
|---|---|
| 1K | $0.050 |
| 2K | $0.100 |
Panoramica e posizionamento
Seedream 5.0 Pro è il modello avanzato di text-to-image della serie Seedream 5.0 di ByteDance, richiamabile tramite l'interfaccia unificata di HiAPI.ai. È pensato per gli sviluppatori che devono integrare la generazione di immagini nei flussi di produzione e, oltre alla qualità visiva, pone l'accento sull'accuratezza fattuale e logica: supporta la ricerca in tempo reale sul web, il ragionamento in più passaggi e il rendering di testo ad alta densità, ed è in grado di produrre immagini PNG/JPEG a risoluzione 1K o 2K con un massimo di 8 rapporti d'aspetto comuni. È adatto a scenari che richiedono elevata accuratezza dei contenuti e del layout, come materiali per l'e-commerce, infografiche e poster multilingua con testo.
Punti di forza principali
- Ricerca e ragionamento integrati nel processo di generazione — quando il prompt riguarda argomenti di attualità, il modello può recuperare automaticamente informazioni dal web e includerle nella generazione, riducendo le imprecisioni fattuali.
- Rendering di testo ad alta densità e multilingua — con ottimizzazioni specifiche per la disposizione del testo e la comprensione multilingua, è in grado di gestire immagini complesse di tipo infografico.
- Risoluzione e formato selezionabili — supporta due livelli di risoluzione, 1K e 2K, e 8 rapporti d'aspetto, conciliando iterazione rapida e output finale.
- Gestione di prompt lunghi — il limite del prompt è di 4000 caratteri, utile per controllare strutture e layout complessi dell'immagine con descrizioni complete.
Descrizione delle capacità
Generazione text-to-image: basta inserire una descrizione testuale da 3 a 4000 caratteri per generare un'immagine; più il prompt è completo, maggiore è il controllo su strutture ed elementi dell'immagine.
Controllo di risoluzione e formato: è possibile scegliere 1K (circa 2MP) per iterazioni rapide o 2K (circa 4MP, fino a 2048x2048) per output rifiniti, con 8 rapporti da 1:1 a 21:9 per adattarsi a diversi formati di pubblicazione.
Scelta del formato di output: si può scegliere tra PNG e JPEG, facilitando l'integrazione diretta con i processi successivi di rimozione dello sfondo, compressione o archiviazione degli asset.
Allineamento testo-immagine e comprensione della struttura: secondo le indicazioni ufficiali, la versione Pro migliora allineamento immagine-testo e coerenza strutturale rispetto alle generazioni precedenti, ed è adatta a compiti di generazione che richiedono accuratezza del layout.
Scenari d'uso
- Operazioni e-commerce: immagini principali generate dai testi dei punti vendita — generare direttamente immagini promozionali del prodotto da titoli e descrizioni dei punti di forza, con output utilizzabili subito per pagine di dettaglio o materiali pubblicitari.
- Team di design: poster e infografiche multilingua — inserire nel prompt testi e layout da presentare per generare bozze di poster o infografiche con testo, da rifinire in seguito.
- Team di contenuti: immagini per temi di attualità — quando il prompt riguarda argomenti di attualità, il modello consulta informazioni dal web, utile per immagini di notizie o eventi che devono rispecchiare il contesto corrente.
- Sviluppo prodotto: segnaposto in batch e bozze visive — generare rapidamente schizzi in batch a risoluzione 1K per validare layout e direzione visiva, per poi passare all'output a 2K.
Limiti e consigli per la scelta
Il modello supporta solo il text-to-image, con un singolo prompt testuale come input massimo: non è possibile fornire immagini di riferimento per image-to-image o modifiche guidate da esempi; per l'editing di immagini e il trasferimento di stile occorre scegliere la linea image-to-image della stessa serie. La documentazione ufficiale ammette inoltre margini di miglioramento nel rendering di testi più fini e nella coerenza dell'editing a livello di pixel: per immagini con molto testo di piccola dimensione si consiglia una verifica manuale. I prompt sensibili al fattore tempo attivano la ricerca sul web e l'output risente dei contenuti recuperati; negli scenari che richiedono elevata stabilità dei risultati è preferibile sostituire i riferimenti all'attualità con descrizioni esplicite e coerenti.
Novità
Vedi il changelog →- Nuovo modello seedream-5.0-pro/image-to-image è ora disponibile
- Nuovo modello Nuovo modello disponibile: seedream-5.0-pro/text-to-image
- Nuovo modello Il modello text-to-image seedream-5.0-lite è ora disponibile
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: seedream-5.0-pro/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per seedream-5.0-pro/text-to-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 3maxLength 4000Testo di prompt che descrive l'immagine da generare; la lunghezza deve essere compresa tra 3 e 4000 caratteri.
resolutionstringObbligatorioPredefinito: "2K"Risoluzione dell'immagine di output. 1K (circa 2 MP) è adatta per iterazioni rapide, 2K (circa 4 MP, fino a 2048x2048) è adatta per generazioni con maggiori dettagli. Predefinito: 2K.
1K2Kaspect_ratiostringObbligatorioPredefinito: "1:1"Proporzioni (aspect ratio) dell'immagine generata. Predefinito: 1:1.
1:14:33:416:99:162:33:221:9output_formatstringOpzionalePredefinito: "png"Formato dell'immagine di output. Predefinito: png.
pngjpegcallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "seedream-5.0-pro/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "output_format": "png"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "seedream-5.0-pro/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "png"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "seedream-5.0-pro/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "png"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Recraft Crisp Upscale Recraft $0.004 /immagine
-
 GPT Image 2.5 OpenAI $0.017 /immagine
-
 Nano Banana Google $0.021 /immagine
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Seedream 4.5 ByteDance $0.045 /immagine
-
 Recraft V4.1 Recraft $0.010 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Ideogram V4.5 Ideogram $0.011 /immagine
-
 FASHN Tryon v1.6 FASHN $0.107 /immagine
-
 Krea 2 Medium Turbo Krea $0.021 /immagine
-
 Nano Banana 2 Lite Google $0.033 /immagine
-
 FLUX.1 Schnell Black Forest Labs $0.005 /immagine


