
Guia de uso
PixVerse V6 短视频:竖屏片段的文本转视频工作流
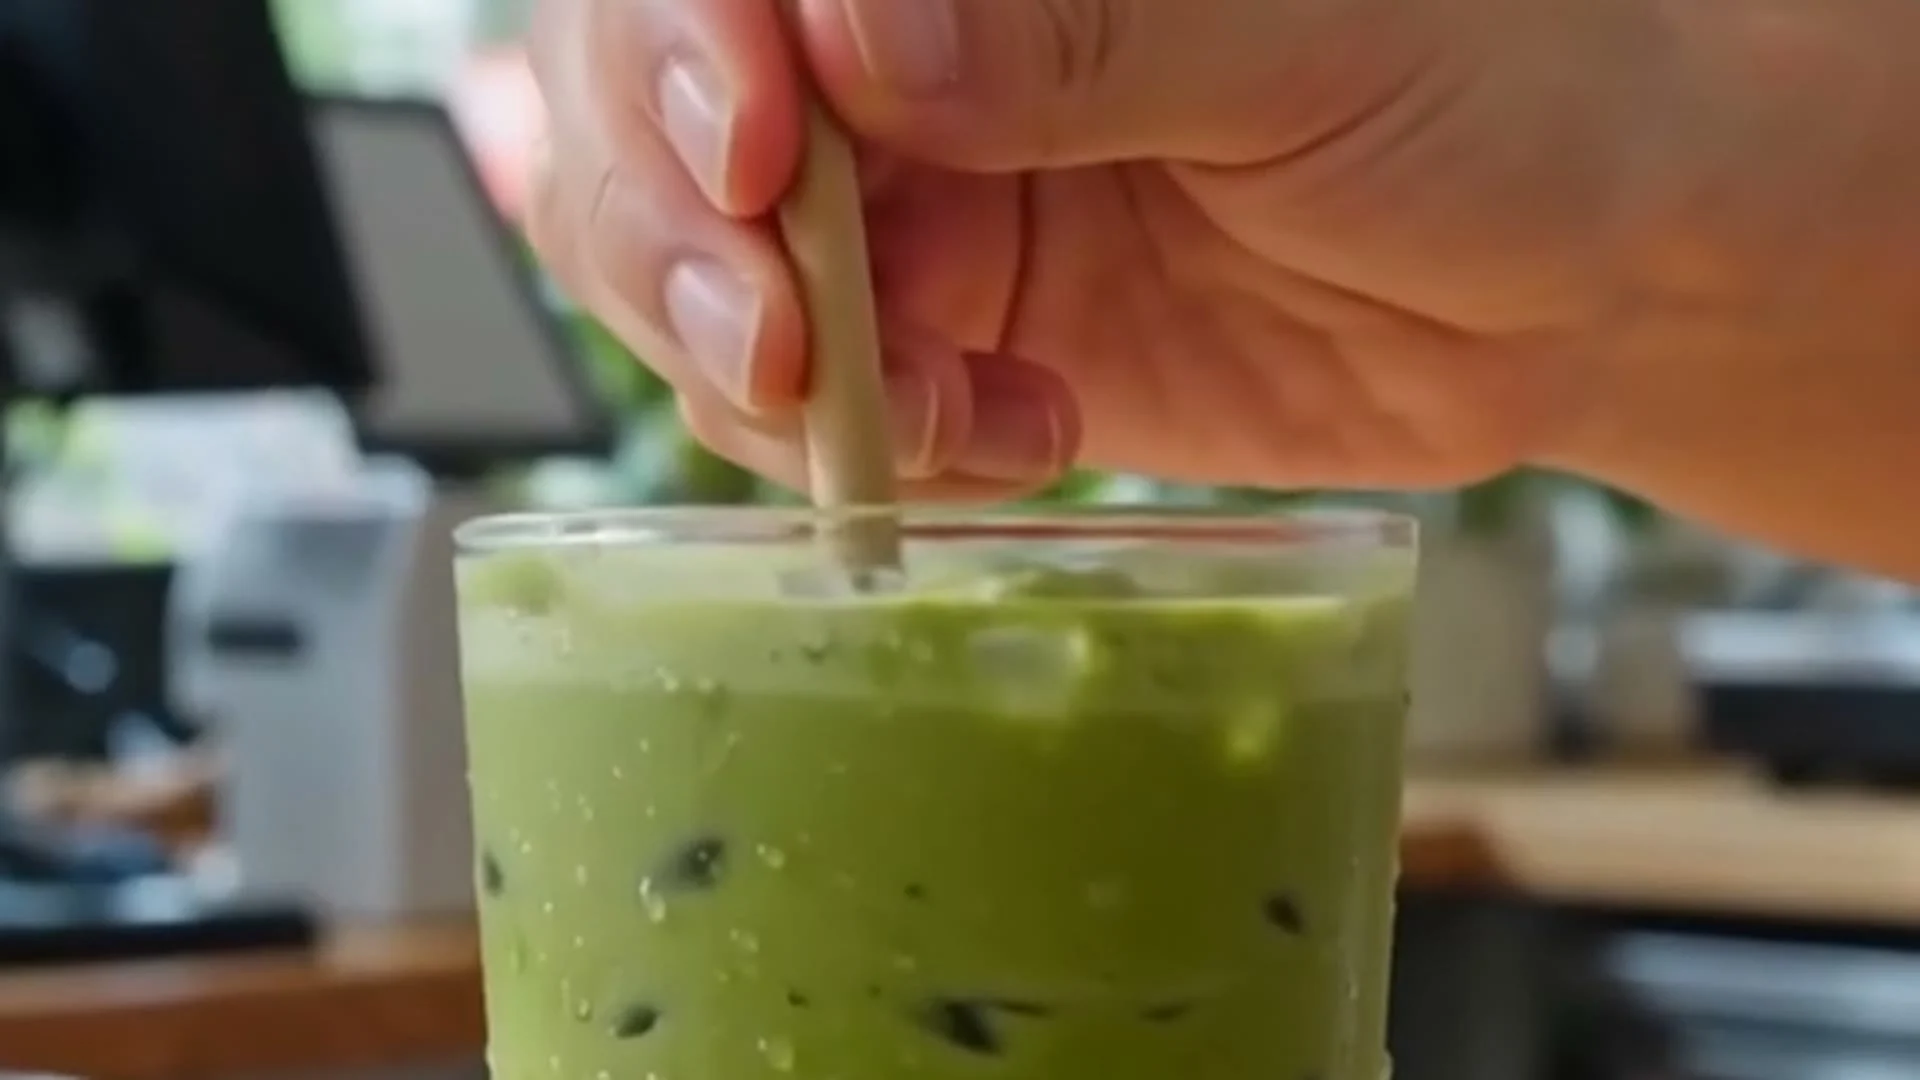
短格式视频是一场走量游戏:你需要不断产出竖屏片段,而瓶颈很少是某个精彩镜头——而是如何快速、低成本地批量产出。本文是一套端到端工作流,教你在 hiapi API 上用 pixverse-v6/text-to-video 实现这一目标:从一个内容创意,到可直接用于 Reels、Shorts 和 TikTok 的成品 9:16 片段。下文每个片段都是为本次演示真实生成的输出——片段可在页面内直接播放。
如果你想要逐条提示词的技巧(风格预设、镜头语言、音频),请参阅 PixVerse V6 提示词配方;如果你想要原始的请求/响应机制,请参阅 PixVerse V6 文本转视频操作指南。本文讲的是围绕它们的生产流水线。
工作流一览
- 把短视频写成一组镜头,而不是一个片段。短视频需要第一秒就抓住人的钩子,以及结尾的回报。pixverse-v6 单次生成上限为 15 秒,所以一条短视频几乎总是由多个协调的片段拼接而成。
- 保持镜头一致。文本转视频没有输入帧,因此镜头之间的连续性必须靠每条提示词中重复的锚点短语来承载。
- 批量提交异步任务。把所有镜头一次性作为
POST /v1/tasks调用发出,并一起轮询——你只需为整批等待一次,而不是逐个镜头等待。 - 低成本草稿,高质量成片。在低成本的
540p档位迭代,然后只把保留的片段重新渲染为720p/1080p。 - 以竖屏交付。一开始就要求
9:16,按平台决定音频,并剪辑到钩子处。
文章其余部分将以一条短视频为例,走完这些步骤。
第 1 步——把短视频分镜为协调的镜头
示例:一条约 10 秒的冰抹茶咖啡馆短视频——那种在美食和生活类信息流中表现良好的解压产品节拍。两个镜头:
- 钩子(0–5 秒):一个让人停下滑动的极特写——抹茶正在被搅拌,泡沫与蒸汽。
- 回报(5–10 秒):做好的饮品,端到镜头前。
文本转视频最重要的纪律是连续性。因为没有参考帧来锚定外观,模型会欣然把第二个镜头渲染成不同的厨房、不同的光线、不同的风格——除非你在两条提示词中重复同样的锚点。这里的共享锚点是:明亮的翠绿色抹茶、干净极简的日式咖啡馆、柔和的晨光、浅景深。下面两条提示词都包含全部四项。
并且记住:pixverse-v6 没有相机或运动参数。所有镜头运动都写在提示词文本里——“the camera slowly pushes in”“holds steady then tilts down”。这是该模型的标志性特点。
第 2 步——撰写协调的提示词
镜头 1——钩子(可直接复制粘贴):
垂直 9:16 微距镜头,明亮的绿色抹茶正在奶油色陶瓷碗中被搅打,细腻的翠绿色泡沫形成,柔和的晨光下细密的蒸汽缓缓升腾。镜头缓缓向泡沫表面推近,竹制茶筅快速来回搅动。干净极简的日式咖啡馆美学,温暖的阳光,浅景深,清晰诱人。
镜头 2——回报(可直接复制粘贴):
垂直 9:16 镜头,一杯高杯冰抹茶拿铁放在浅色木质咖啡馆吧台上,翠绿色与乳白色分层,玻璃杯上挂着新鲜的水珠。咖啡师的手将杯子向镜头推来,并插入一根纸吸管。明亮通透的晨光,背景是绿色植物的柔和散景,镜头保持稳定后略微下摇。干净极简的咖啡馆外观,清新而诱人。
注意贯穿其中的元素:翠绿色抹茶、干净极简的咖啡馆、晨光。正是这套共享词汇让两个片段读起来像一条短视频,而不是两段不相关的视频。镜头方向刻意不同——用推镜开场,用稳定保持后下摇来收尾呈现产品——因为短视频需要运动变化才看得下去。
第 3 步——批量处理异步任务
上面两个镜头并不是一个接一个生成的。它们作为异步任务一起提交、作为一个集合一起轮询——这正是当你规模化生产时 /v1/tasks 设计的全部意义。你只需为整批支付一次约 60–90 秒的生成等待,而不是每个片段都等。
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY", "Content-Type": "application/json"}

shots = {
    "hook":   "垂直 9:16 微距镜头,明亮的绿色抹茶正在搅打……",
    "payoff": "垂直 9:16 镜头,一杯高杯冰抹茶拿铁……",
}
common = {"aspect_ratio": "9:16", "duration": 5, "resolution": "540p"}

# 1) 把每个镜头作为独立任务发出,保存返回的 taskId
tasks = {}
for name, prompt in shots.items():
    r = requests.post(API, headers=HEADERS, json={
        "model": "pixverse-v6/text-to-video",
        "input": {"prompt": prompt, **common},
    })
    tasks[name] = r.json()["data"]["taskId"]

# 2) 轮询保存的 taskId,直到每个都报告成功
outputs = {}
while len(outputs) < len(tasks):
    for name, tid in tasks.items():
        if name in outputs:
            continue
        d = requests.get(f"{API}/{tid}", headers=HEADERS).json()["data"]
        if d["status"] == "success":
            outputs[name] = d["output"][0]["url"]   # 一个临时的 .mp4 URL
        elif d["status"] == "fail":
            raise RuntimeError(f"{name} failed: {d.get('error')}")
    time.sleep(6)
实际制作这条短视频时,有两点在实践中确实重要:
- 输出 URL 是临时的。每个完成的任务会返回一个会过期的
output[0].url——立即下载.mp4并移到自己的存储;不要热链它。 - 轮询可能打嗝,但任务不会失败。轮询某个任务时的单次网络抖动会表现为那一次请求的临时错误——任务仍在服务器上运行。解决办法是把失败的轮询当作“再试一次”,而不是“任务死了”:重新轮询保存的
taskId,而不是中止整批。只有任务体中的status: "fail"才是真正的失败。
第 4 步——低成本草稿,高质量成片
上面两个片段都是刻意用 540p 生成的。pixverse-v6 按秒计费,且分辨率档位差距很大:540p 静音是最低成本档,而 1080p 是最贵档(当前各档每秒费率见定价页面——数字会变,批量前请核实)。
对短视频来说,这种拆分是一份礼物。这项工作昂贵之处在于迭代——你会反复重掷提示词、改写镜头运动、更换主体。在 540p 做这些实验的每秒成本只是 1080p 的一小部分,而一个 5 秒的 540p 竖屏片段返回的是约 1–2 MB 的小 576×1024 .mp4,下载和审阅都很快。一旦某个镜头锁定,只把那条提示词重新渲染为 720p 或 1080p 用于最终剪辑。你只在要保留的镜头上花全分辨率成本。
经验法则:
540p用于草稿循环,把保留片段升到720p/1080p用于交付。绝不要在1080p迭代。
第 5 步——同样的流水线,不同的概念
因为工作流是提示词 → 批量 → 竖屏输出,它与概念无关。同样五步能产出一条完全不同的短视频——这里是一个动感赛博朋克动作节拍——除了提示词和 style 什么都没变:
那个片段使用了 aspect_ratio: "9:16"、style: "cyberpunk" 以及一个 negative_prompt 来推开静态输出——它完整的提示词和请求体在提示词配方中。这里重点不是提示词;而是说一旦批量草稿流水线存在,更换主题只是改一行的事,这才让它成为生产工作流,而不是一次性渲染。
第 6 步——完成与交付
- 形状先于规模。原生生成
9:16。把16:9渲染裁成竖屏会丢掉一半像素;直接要求你将要发布的画面比例。 - 把钩子前置。Reels/Shorts/TikTok 在第一秒就决定留存——用你最强的运动开场(这里的推镜),而不是缓慢淡入。
- 按平台决定音频。pixverse-v6 可以用
generate_audio: true(默认false)渲染同步声音,这有自己的有声定价档。对于大多数观众静音观看的信息流,静音草稿加上你自己的音乐/字幕轨更便宜;当环境音本身就是内容时,再打开音频。 - 在后期拼接和加字幕。把锁定的
720p/1080p镜头首尾拼接,添加字幕,并剪辑到平台的最佳时长。模型给你干净的 5 秒积木;把它们编排成短视频是剪辑步骤,不是生成步骤。
常见问题
如何用 pixverse-v6 制作超过 15 秒的短视频?
把它生成为多个最长 15 秒的片段,并在后期拼接。duration 是 1 到 15 的整数——把你的短视频规划为协调的镜头(如第 1–2 步),而不是一次长生成。
如何让多个镜头看起来像同一条视频? 在每条提示词中重复相同的锚点短语——主体、场景、光线、风格。文本转视频没有参考帧,因此没有共享锚点,每个镜头就会漂移到不同的外观。上面的抹茶短视频在两条提示词中都复用了“翠绿色抹茶、干净极简的咖啡馆、柔和晨光”。
如果我需要高分辨率最终成片,为什么还要用 540p 生成?
为了低成本迭代。计费按秒,540p 是最低成本档,所以所有提示词重掷都在那里做,只把保留片段重新渲染为 720p/1080p。当前费率见定价页面。
我可以并行生成多个片段吗?
可以——这正是异步 /v1/tasks 设计的用途。把每个镜头作为独立任务提交,保存返回的 taskId,并一起轮询(第 3 步)。及时下载每个完成的 .mp4,因为输出 URL 是临时的。
短视频需要打开音频吗?
通常不需要。许多信息流自动静音播放,所以静音片段加上你自己的字幕/音乐轨往往既便宜又更可控。当渲染出的环境音本身就是重点时,再打开 generate_audio: true。
自己动手运行
从 PixVerse V6 文本转视频模型页面开始获取实时 schema 和 API key,保持 Create Task 和 Get Task Detail 文档打开以了解批量请求/轮询格式,并在渲染一组之前查看定价。复制两条抹茶提示词,用 540p 起草,你就能在一批中完成你的第一条竖屏短视频。
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores