
Guia de uso
Prompts do Wan 3.0 Prime: 3 vídeos reais e um esqueleto reutilizável
Texto para vídeo, texto para vídeo com áudio sincronizado e bloqueio de sujeito com imagem de referência — cada um com o prompt completo, a requisição e o preço.
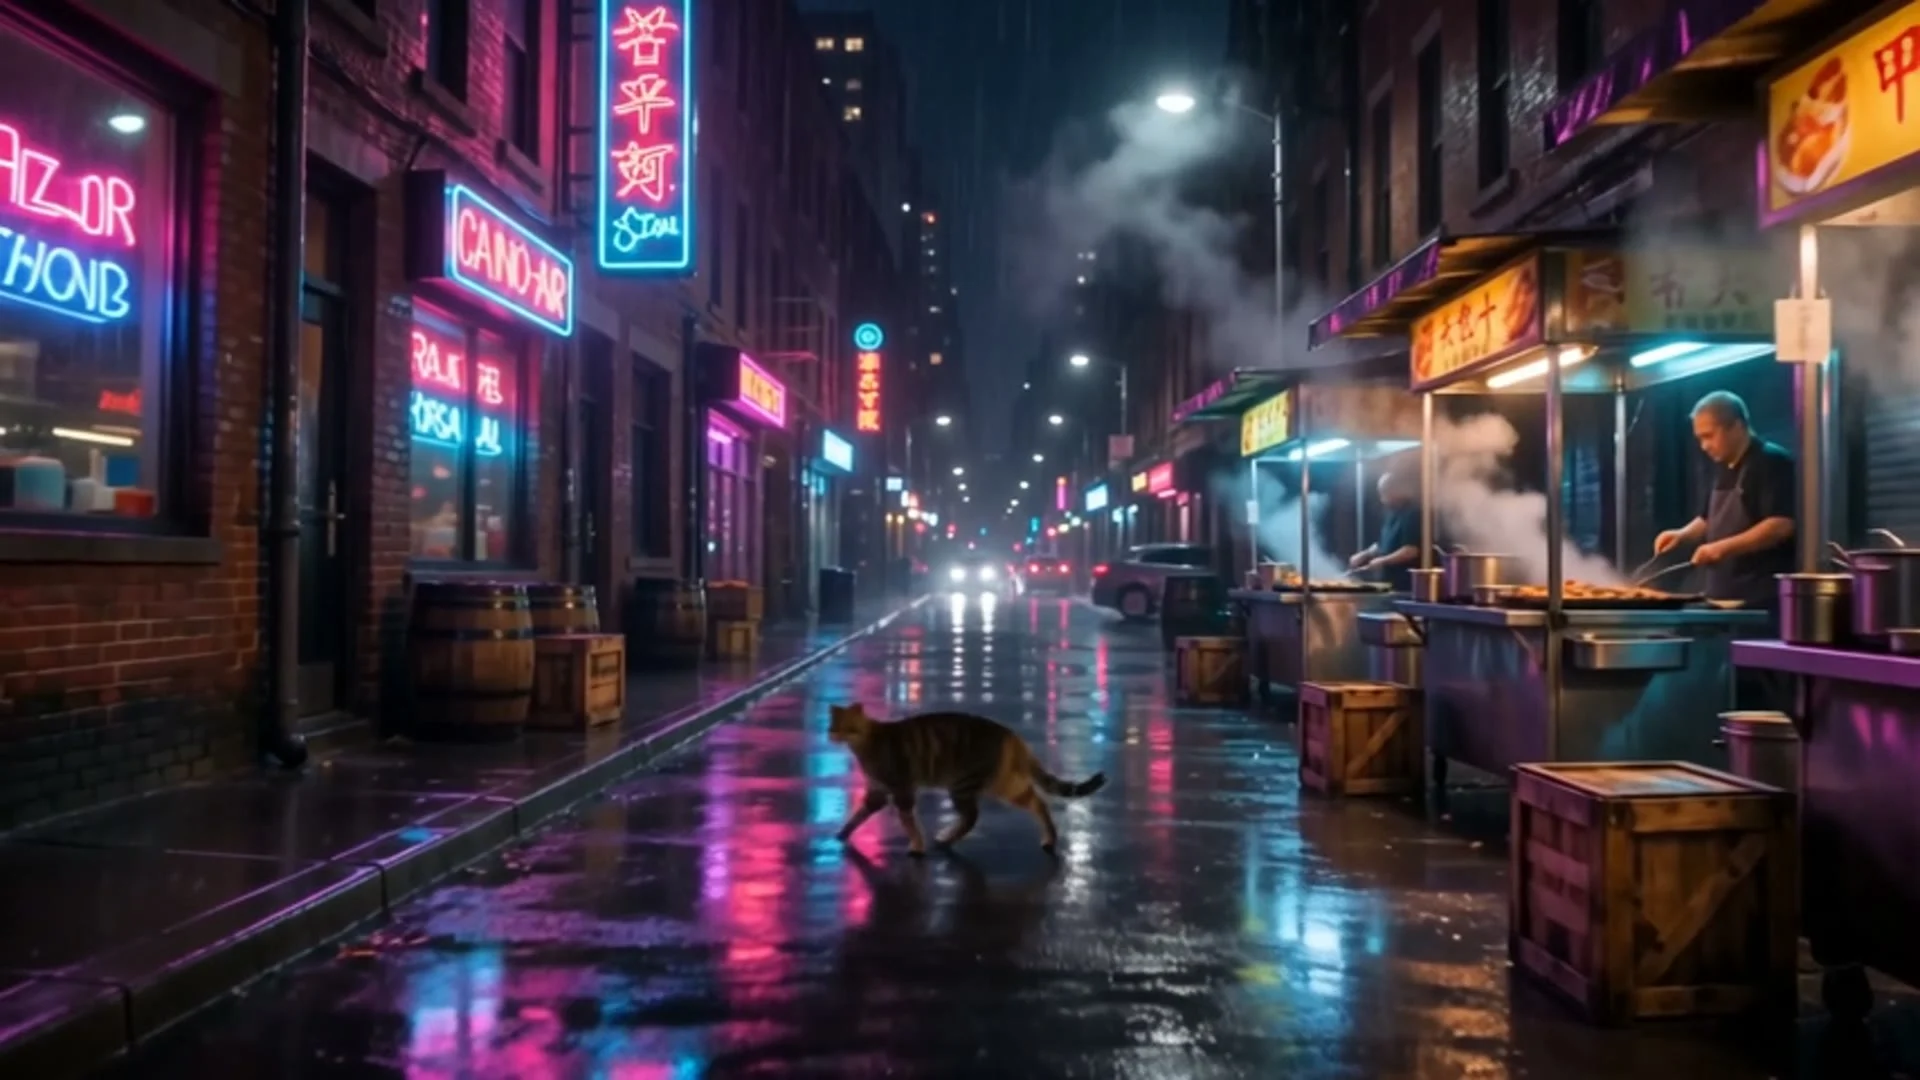
Os 3 vídeos abaixo foram gerados de uma só vez pelo Wan 3.0 Prime (wan3.0-video-prime): um texto para vídeo, um texto para vídeo com áudio sincronizado e um vídeo com referência que bloqueia o sujeito a partir de uma imagem. Cada um vem com o prompt completo, os parâmetros da requisição e o preço; clicar em "Gerar com este prompt" abre a página do modelo já com o prompt preenchido. Os 3 são 480P, 5 segundos, $0.4375 cada, total de $1.3125.
O que os prompts do Prime têm de diferente
- Entende câmera e ação. Termos como dolly-forward, órbita de 180 graus e slow push-in realmente controlam a câmera. Uma pilha de substantivos ("um gato, uma rua, neon") é desperdício; uma frase com intenção de direção é o que produz um plano com cara de direção.
- Produz áudio.
audiovem ativado por padrão e o modelo adiciona ambiente, efeitos sonoros e música leve conforme a imagem; definido comofalse, o vídeo sai sem som. - Aceita imagem de referência. O texto só descreve uma categoria de coisa ("uma raposa de cerâmica"), enquanto a imagem de referência fixa uma coisa específica. Com a imagem enviada, o Prime anima aquela mesma — não reinventa uma nova a cada vez.
1. Plano de produto e gastronomia (texto para vídeo)
A single scoop of pistachio gelato in a frosted coupe glass on a pale marble
counter; slow 180-degree orbit as a bead of condensation slides down the glass,
soft window light from the left, shallow depth of field, warm late-afternoon
tones, faint steam curling from an espresso cup just behind in soft focus.
Gerar com este prompt → (5 segundos, 480P, 16:9, sem som)
wan3.0-video-prime, 480P, 5 segundos, 16:9, sem som, $0.4375.
A ordem das frases é a ordem em que o modelo lê um plano: sujeito, movimento de câmera, um detalhe protagonista, direção da luz, profundidade de campo, tom de cor. "slow 180-degree orbit" dá apenas um movimento de câmera claro; "uma gota de água escorrendo pelo vidro" dá apenas uma pequena ação, e o realismo aparece. Indicar que a luz vem da esquerda e a profundidade de campo é rasa faz com que o fundo fique num desfoque limpo, e não numa bagunça. Planos de produto e de gastronomia cabem nessa estrutura: um sujeito, um movimento de câmera, uma pequena ação.
2. Plano de atmosfera com áudio sincronizado (texto para vídeo)
Neste, lembre-se de ativar o som: o som da chuva, o trânsito distante e o chiado da grelha são gerados conforme a imagem.
Rain streaking down a narrow neon-lit alley at night; a slow dolly-forward past
steaming street-food stalls, magenta and cyan reflections rippling in the wet
pavement, a tabby cat darting between crates mid-shot. Ambient sound: steady
rain, distant traffic hiss, the sizzle of a grill and a low synth drone.
Gerar com este prompt → (5 segundos, 480P, 16:9, com som)
wan3.0-video-prime, 480P, 5 segundos, 16:9, com som, $0.4375.
Escrever o som é uma habilidade à parte: primeiro escreva a imagem, depois acrescente uma frase separada "Ambient sound:" listando 3–4 camadas de som específicas: uma base contínua (chuva), uma camada distante (trânsito), um efeito próximo (grelha) e uma camada tonal (baixo de sintetizador). Escrever só "efeitos sonoros cinematográficos" resulta numa massa confusa; nomear as camadas dá ao modelo algo para mixar. Na parte visual, também dê apenas um movimento de câmera (slow dolly-forward) e acrescente um sujeito que se move (o gato): a imagem ganha vida sem virar bagunça.
3. Bloquear o sujeito (vídeo com referência)
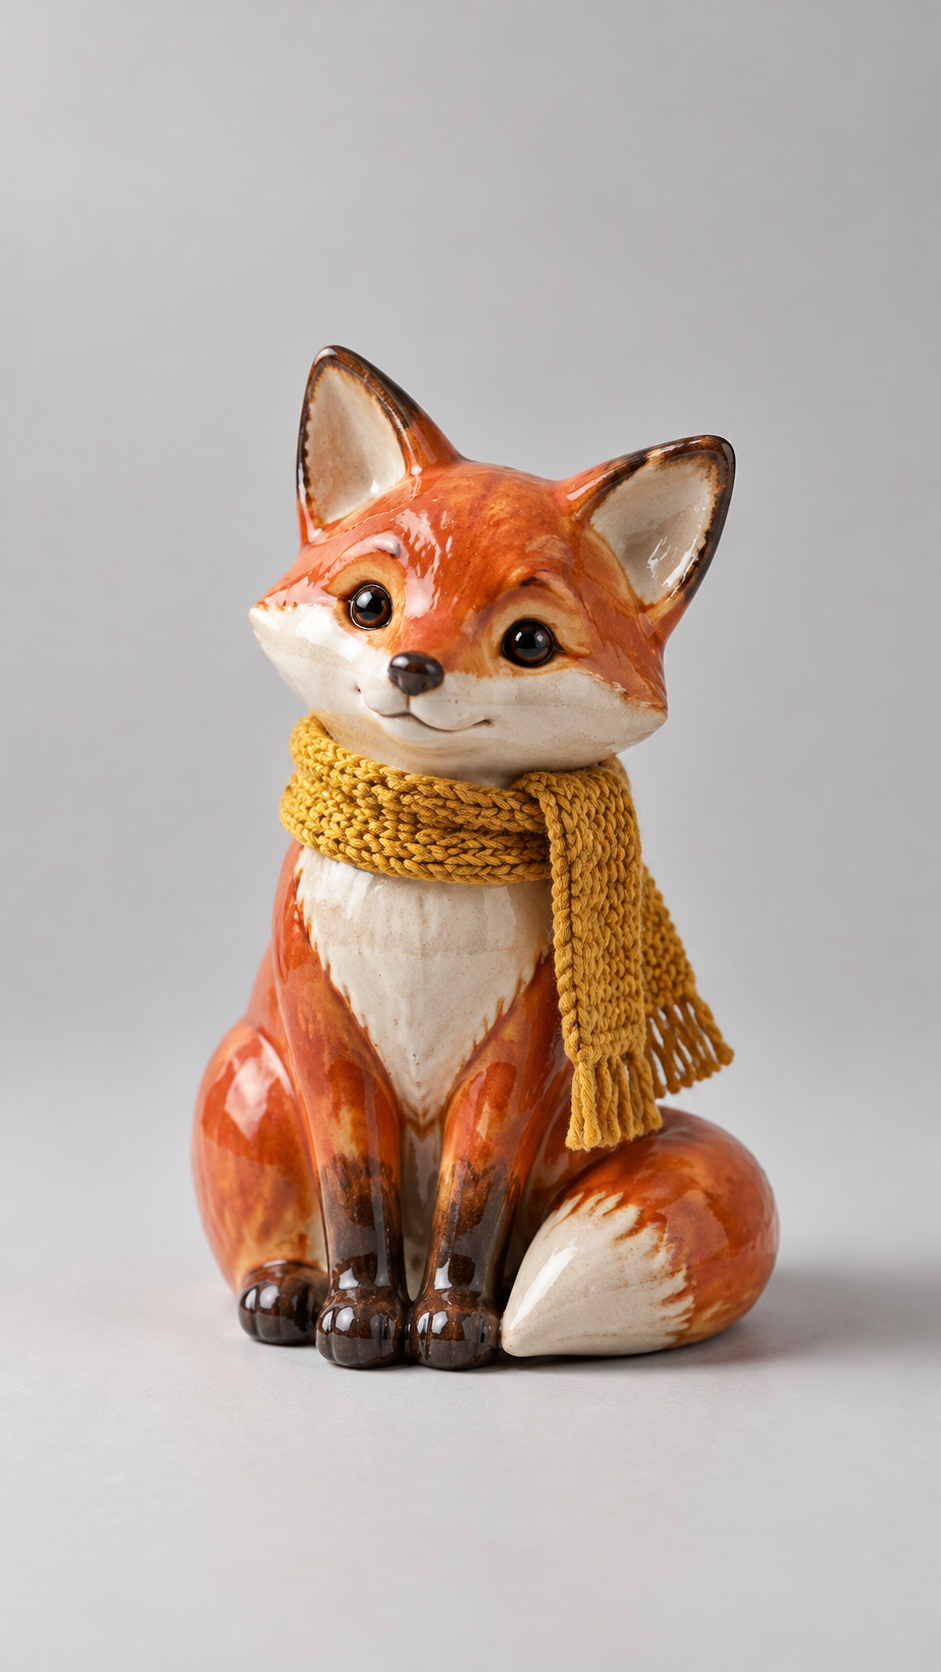
Este é o ponto forte do Prime. Só com texto, um novo sujeito é criado a cada vez; envie uma imagem de referência e ele fica bloqueado. Abaixo, primeiro preparamos uma imagem de uma raposa de cerâmica, colocamos em reference_image_urls, e o que se move no vídeo é essa raposa: o mesmo esmalte, o mesmo cachecol.
Imagem de referência:
Resultado da geração:
Bring the referenced ceramic fox figurine to life: it slowly turns its head
toward camera, blinks, and tilts with a curious expression; subtle idle
breathing, a light breeze stirring the tiny scarf, soft studio key light on a
clean seamless backdrop, smooth loopable motion.
Gerar com este prompt → (envie sua imagem de referência, 5 segundos, 480P, 9:16, sem som)
wan3.0-video-prime, imagem de referência, 480P, 5 segundos, 9:16, sem som, $0.4375.
Requisição completa:
{
  "model": "wan3.0-video-prime",
  "input": {
    "prompt": "Bring the referenced ceramic fox figurine to life ...",
    "resolution": "480P",
    "duration": 5,
    "aspect_ratio": "9:16",
    "audio": false,
    "reference_image_urls": [
      "https://static.hiapi.ai/blog/wan3-0-video-prime-prompt-recipes/recipe-3-reference-fox.jpg"
    ]
  }
}
Com a imagem de referência, não descreva mais a aparência do sujeito; use o espaço todo para "dirigir". Comece o prompt com "Bring the referenced … to life" para o modelo saber que a imagem é a base do sujeito, e depois escreva só ações que não estão na imagem: virar a cabeça, piscar, respirar, o vento mexendo no cachecol. "smooth loopable motion" facilita emendar o início e o fim num loop, e 9:16 entrega o formato vertical direto. Escolha imagens de referência com sujeito limpo, boa iluminação e fundo simples; referências com fundo carregado e muitos sujeitos são as que mais perdem consistência.
Um esqueleto para reutilizar
Os três prompts acima são, na verdade, o mesmo esqueleto:
- Sujeito: um protagonista claro (se houver imagem de referência, escreva "the referenced …").
- Câmera: dê apenas um movimento (órbita, avanço, acompanhamento), não três.
- Ação: uma ou duas pequenas coisas que realmente se mexem, com vida mas sem bagunça.
- Imagem: direção da luz, profundidade de campo, tom de cor.
- Som (opcional): uma frase separada "Ambient sound:" nomeando algumas camadas de som.
Troque os substantivos, mantenha a estrutura.
Reproduzir com a API
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan3.0-video-prime",
    "input": {
      "prompt": "A single scoop of pistachio gelato in a frosted coupe glass on a pale marble counter; slow 180-degree orbit",
      "resolution": "480P", "duration": 5, "aspect_ratio": "16:9", "audio": false
    }
  }'
Depois que a resposta retornar data.taskId, consulte com GET /v1/tasks/{taskId} até o status ser success e baixe em output[0].url; este é um link temporário, então salve a tempo. Para a integração completa, veja o tutorial em chinês da API do Wan 3.0 Prime.
Quanto custa
- 480P $0.0875 por segundo: 5 segundos $0.4375
- 720P $0.18 por segundo: 5 segundos $0.90
- 1080P $0.36 por segundo: 5 segundos $1.80
Ajuste o prompt em 480P e, depois de fechar, mude resolution para 720P ou 1080P e rode de novo; o prompt não muda. Atenção: o padrão de resolution é 1080P. Se não precisar da velocidade do Prime, a versão padrão do Wan 3.0, wan3.0-video, sai mais barata por segundo. Veja os detalhes em Preços da API do Wan 3.0 Prime.
Perguntas frequentes
O Prime realmente gera áudio?
Sim. Com audio em true (padrão), ele retorna um vídeo com faixa de áudio sincronizada; definido como false, sai sem som. O item 2 foi gerado com som.
Qual é a duração máxima de um vídeo?
duration é um número inteiro de 2 a 30, e o custo cresce linearmente com a duração.
Quais resoluções e proporções são suportadas?
resolution aceita 480P, 720P, 1080P (em maiúsculas); aspect_ratio aceita adaptive, 16:9, 4:3, 1:1, 3:4, 9:16.
Como manter o mesmo personagem ou produto consistente em vários vídeos?
Use reference_image_urls para enviar a imagem de referência e escreva no prompt apenas as ações, não a aparência.
Por que meu rascunho parece meio borrado?
Porque é 480P, a faixa barata feita de propósito para rascunhar. Depois de definir o prompt, suba a resolução para 720P ou 1080P.
Escolha o prompt mais próximo da sua necessidade, vá à página do modelo e gere o primeiro, e depois troque os substantivos.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores