
Guía de uso
Prompts de Wan 3.0 Prime: 3 vídeos reales y una plantilla reutilizable
Texto a vídeo, texto a vídeo con audio sincronizado y referencia de imagen para fijar el sujeto; cada uno con el prompt completo, la solicitud y el precio.
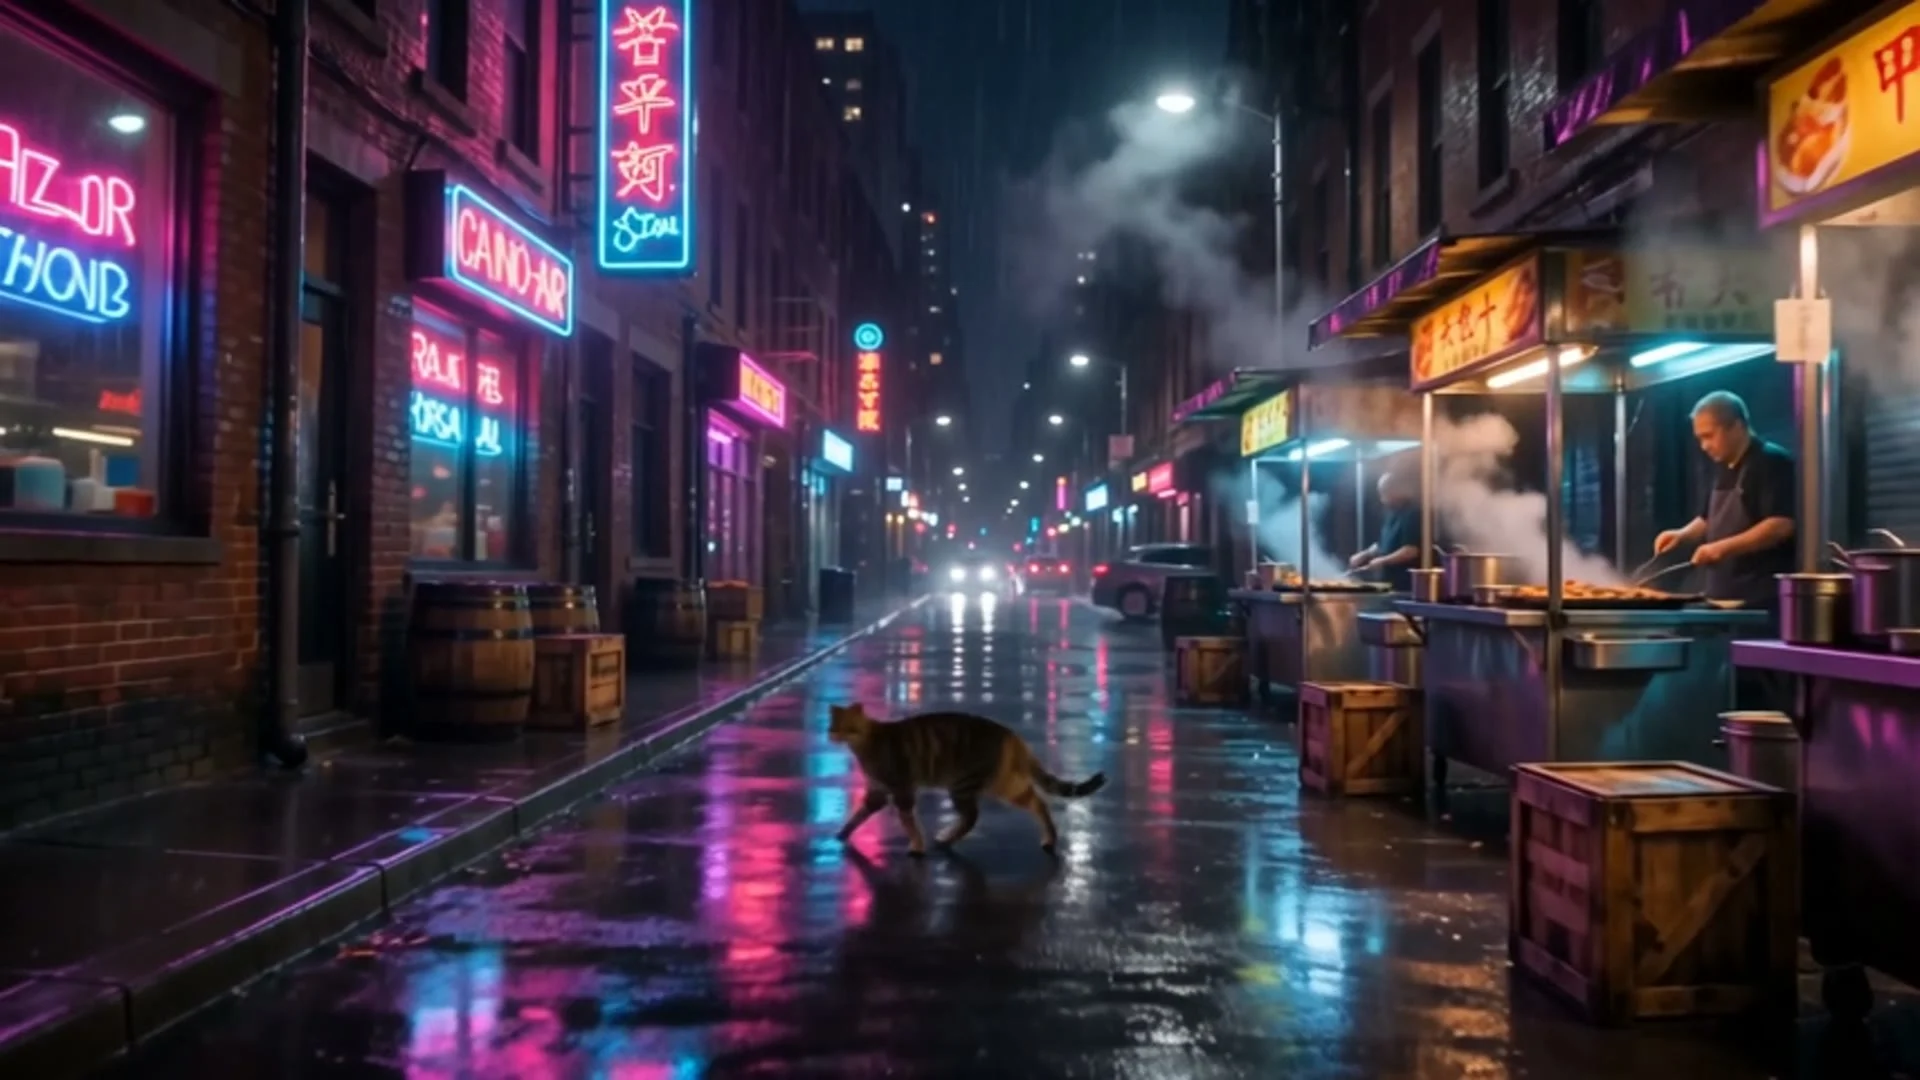
Los 3 vídeos siguientes se generaron con Wan 3.0 Prime (wan3.0-video-prime) en una sola pasada: uno de texto a vídeo, uno de texto a vídeo con audio sincronizado y uno de referencia de imagen que fija el sujeto. Cada uno incluye el prompt completo, los parámetros de la solicitud y el precio; al hacer clic en «Generar con este prompt» se abre la página del modelo con el prompt ya rellenado. Los 3 son 480P, 5 segundos, $0.4375 cada uno, $1.3125 en total.
Qué tienen de distinto los prompts de Prime
- Entiende los movimientos de cámara y las acciones. Términos como dolly-forward, órbita de 180 grados o slow push-in realmente controlan la cámara. Una lista de sustantivos («un gato, una calle, neón») es un desperdicio; una frase con intención de director es lo que da un plano con sensación de dirección.
- Puede generar sonido.
audioestá activado por defecto y el modelo añade ambiente, efectos de sonido y música ligera según la imagen; si se pone enfalse, el vídeo es mudo. - Acepta imágenes de referencia. El texto solo describe una categoría de cosa («un zorro de cerámica»); una imagen de referencia fija una cosa concreta. Si pasas una imagen, Prime anima exactamente esa, sin reinventarla cada vez.
1. Plano gastronómico de producto (texto a vídeo)
A single scoop of pistachio gelato in a frosted coupe glass on a pale marble
counter; slow 180-degree orbit as a bead of condensation slides down the glass,
soft window light from the left, shallow depth of field, warm late-afternoon
tones, faint steam curling from an espresso cup just behind in soft focus.
Generar con este prompt → (5 segundos, 480P, 16:9, sin sonido)
wan3.0-video-prime, 480P, 5 segundos, 16:9, sin sonido, $0.4375.
El orden de las frases es el orden en que el modelo lee un plano: sujeto, movimiento de cámara, un detalle protagonista, dirección de la luz, profundidad de campo, tono de color. «slow 180-degree orbit» da un único movimiento de cámara claro y «una gota de agua que resbala por el cristal» da una única acción pequeña, y así aparece el realismo. Al especificar que la luz viene de la izquierda y la poca profundidad de campo, el fondo queda limpiamente desenfocado en lugar de ser un amasijo. Este esquema sirve tanto para producto como para gastronomía: un sujeto, un movimiento de cámara, una acción pequeña.
2. Plano de ambiente con audio sincronizado (texto a vídeo)
En este no olvides activar el sonido: la lluvia, el tráfico lejano y el chisporroteo de la parrilla se generan según la imagen.
Rain streaking down a narrow neon-lit alley at night; a slow dolly-forward past
steaming street-food stalls, magenta and cyan reflections rippling in the wet
pavement, a tabby cat darting between crates mid-shot. Ambient sound: steady
rain, distant traffic hiss, the sizzle of a grill and a low synth drone.
Generar con este prompt → (5 segundos, 480P, 16:9, con sonido)
wan3.0-video-prime, 480P, 5 segundos, 16:9, con sonido, $0.4375.
Escribir el sonido es un oficio aparte: primero escribe la imagen y luego añade por separado una frase «Ambient sound:» que enumere 3–4 capas de sonido concretas: una base continua (la lluvia), una capa lejana (el tráfico), un efecto cercano (la parrilla) y una capa tonal (el bajo del sintetizador). Si solo escribes «efectos de sonido cinematográficos» obtienes una papilla; si nombras las capas, el modelo tiene algo que mezclar. En la parte visual, igualmente da un solo movimiento de cámara (slow dolly-forward) y añade un sujeto que se mueva (el gato); el plano gana vida sin desordenarse.
3. Fijar el sujeto (referencia a vídeo)
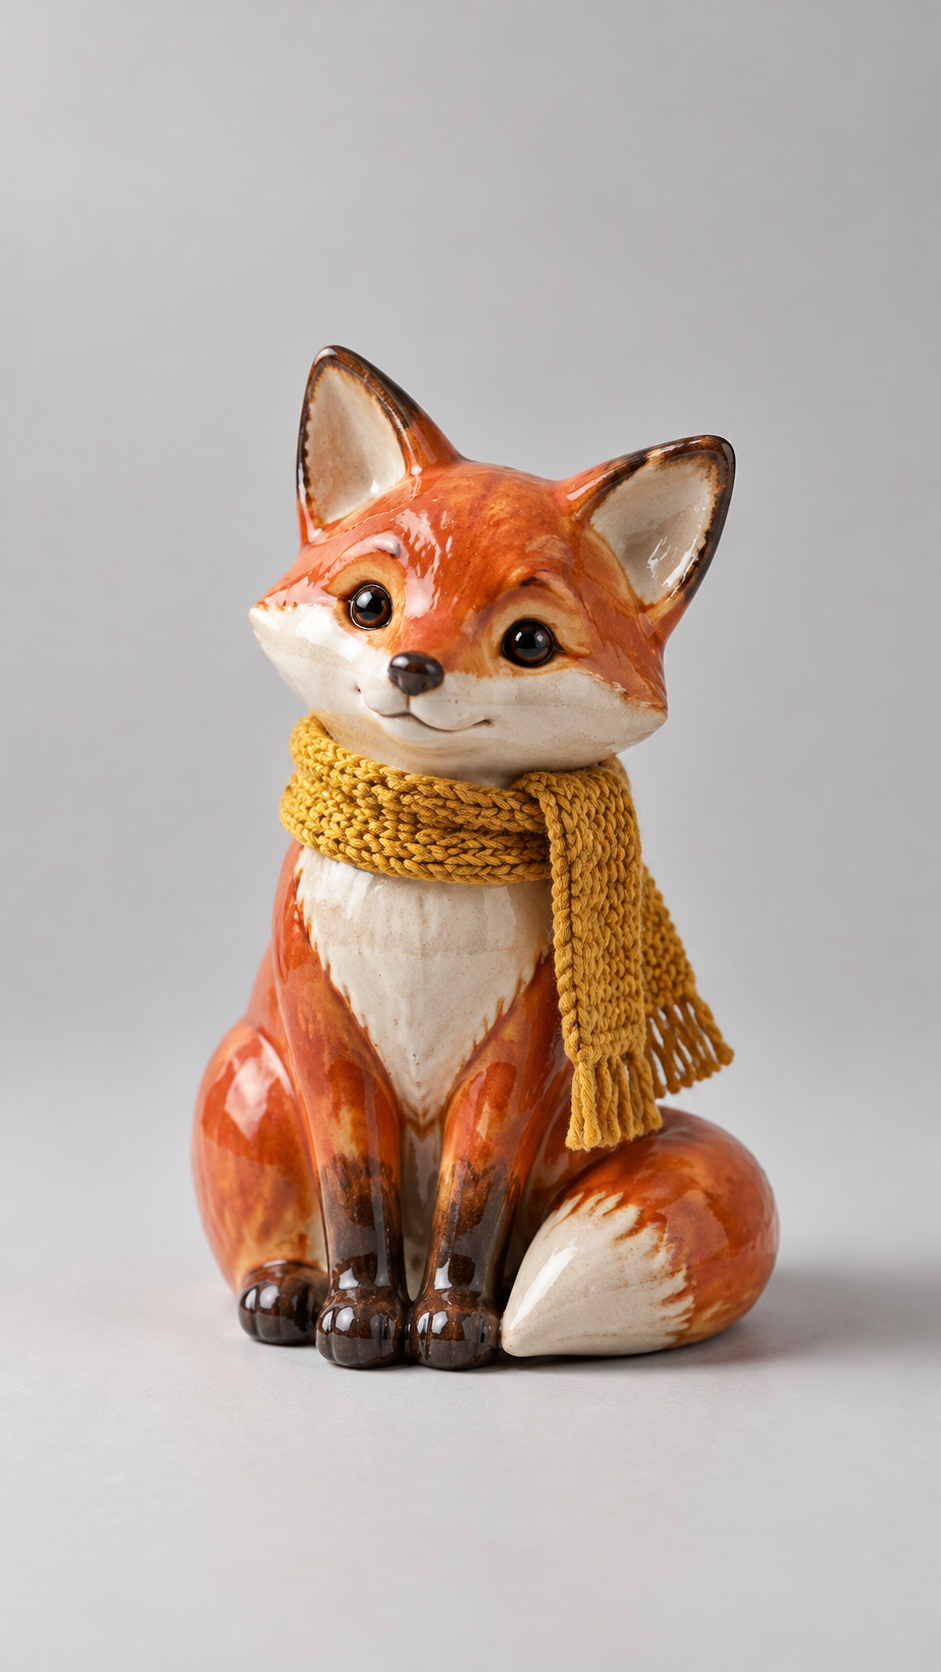
Esta es la especialidad de Prime. Si solo escribes texto, cada vez se crea un sujeto nuevo; si pasas una imagen de referencia, queda fijado. A continuación prepara una imagen de una figurita de zorro de cerámica y ponla en reference_image_urls; lo que se mueve en el vídeo es ese zorro: el mismo esmalte, la misma bufanda.
Imagen de referencia:
Resultado generado:
Bring the referenced ceramic fox figurine to life: it slowly turns its head
toward camera, blinks, and tilts with a curious expression; subtle idle
breathing, a light breeze stirring the tiny scarf, soft studio key light on a
clean seamless backdrop, smooth loopable motion.
Generar con este prompt → (sube tu imagen de referencia, 5 segundos, 480P, 9:16, sin sonido)
wan3.0-video-prime, imagen de referencia, 480P, 5 segundos, 9:16, sin sonido, $0.4375.
Solicitud completa:
{
  "model": "wan3.0-video-prime",
  "input": {
    "prompt": "Bring the referenced ceramic fox figurine to life ...",
    "resolution": "480P",
    "duration": 5,
    "aspect_ratio": "9:16",
    "audio": false,
    "reference_image_urls": [
      "https://static.hiapi.ai/blog/wan3-0-video-prime-prompt-recipes/recipe-3-reference-fox.jpg"
    ]
  }
}
Con una imagen de referencia, deja de describir cómo es el sujeto y dedica todo el espacio a «dirigir». Empieza el prompt con «Bring the referenced … to life» para que el modelo sepa que la imagen es la base del sujeto, y después escribe solo acciones que no estén en la imagen: girar la cabeza, parpadear, respirar, el viento que mueve la bufanda. «smooth loopable motion» facilita que el principio y el final se unan en un bucle, y 9:16 da directamente formato vertical. Elige una imagen de referencia con un sujeto limpio, buena luz y fondo sencillo; con fondos recargados y muchos sujetos, la consistencia se pierde con facilidad.
Una plantilla que puedes reutilizar
Los tres prompts anteriores son en realidad el mismo esqueleto:
- Sujeto: un protagonista claro (si has pasado una imagen de referencia, escribe «the referenced …»).
- Cámara: un solo movimiento de cámara (órbita, avance, seguimiento), no tres.
- Acción: una o dos cosas pequeñas que realmente se muevan; con vida, pero sin desorden.
- Imagen: dirección de la luz, profundidad de campo, tono de color.
- Sonido (opcional): una frase aparte «Ambient sound:» que nombre varias capas de sonido.
Cambia los sustantivos y conserva la estructura.
Reproducirlo con la API
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan3.0-video-prime",
    "input": {
      "prompt": "A single scoop of pistachio gelato in a frosted coupe glass on a pale marble counter; slow 180-degree orbit",
      "resolution": "480P", "duration": 5, "aspect_ratio": "16:9", "audio": false
    }
  }'
Cuando devuelva data.taskId, consulta con GET /v1/tasks/{taskId} hasta que status sea success y descarga desde output[0].url; es un enlace temporal, guárdalo a tiempo. Para la integración completa, consulta el tutorial en chino de la API de Wan 3.0 Prime.
Cuánto cuesta
- 480P $0.0875 por segundo: 5 segundos $0.4375
- 720P $0.18 por segundo: 5 segundos $0.90
- 1080P $0.36 por segundo: 5 segundos $1.80
Ajusta el prompt en 480P; cuando lo tengas definido, cambia resolution a 720P o 1080P y vuelve a ejecutarlo, sin tocar el prompt. Ten en cuenta que resolution es 1080P por defecto. Si no necesitas la velocidad de Prime, la versión estándar Wan 3.0 wan3.0-video es más barata por segundo. Consulta los detalles en Precios de la API de Wan 3.0 Prime.
Preguntas frecuentes
¿Prime realmente genera sonido?
Sí. Con audio en true (por defecto) devuelve un vídeo con pista de audio sincronizada; si se pone en false, es mudo. El segundo se generó con sonido.
¿Cuánto dura como máximo uno?
duration es un entero de 2 a 30, y el coste crece de forma lineal con la duración.
¿Qué resoluciones y relaciones de aspecto admite?
resolution es 480P, 720P o 1080P (en mayúsculas); aspect_ratio admite adaptive, 16:9, 4:3, 1:1, 3:4 y 9:16.
¿Cómo mantengo el mismo personaje o producto en varios vídeos?
Pasa la imagen de referencia en reference_image_urls y escribe en el prompt las acciones, no la apariencia.
¿Por qué mi borrador se ve algo borroso?
Porque es 480P, la opción barata pensada precisamente para borradores. Cuando fijes el prompt, sube la resolución a 720P o 1080P.
Elige el prompt que más se acerque a lo que necesitas, ve a la página del modelo y genera el primero, y luego cambia los sustantivos.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores