
Guida all'uso
Prompt per Wan 3.0 Prime: 3 video reali e uno scheletro riutilizzabile
Da testo a video, da testo a video con audio sincronizzato, e con un'immagine di riferimento per bloccare il soggetto: per ognuno, il prompt completo, la richiesta e il prezzo.
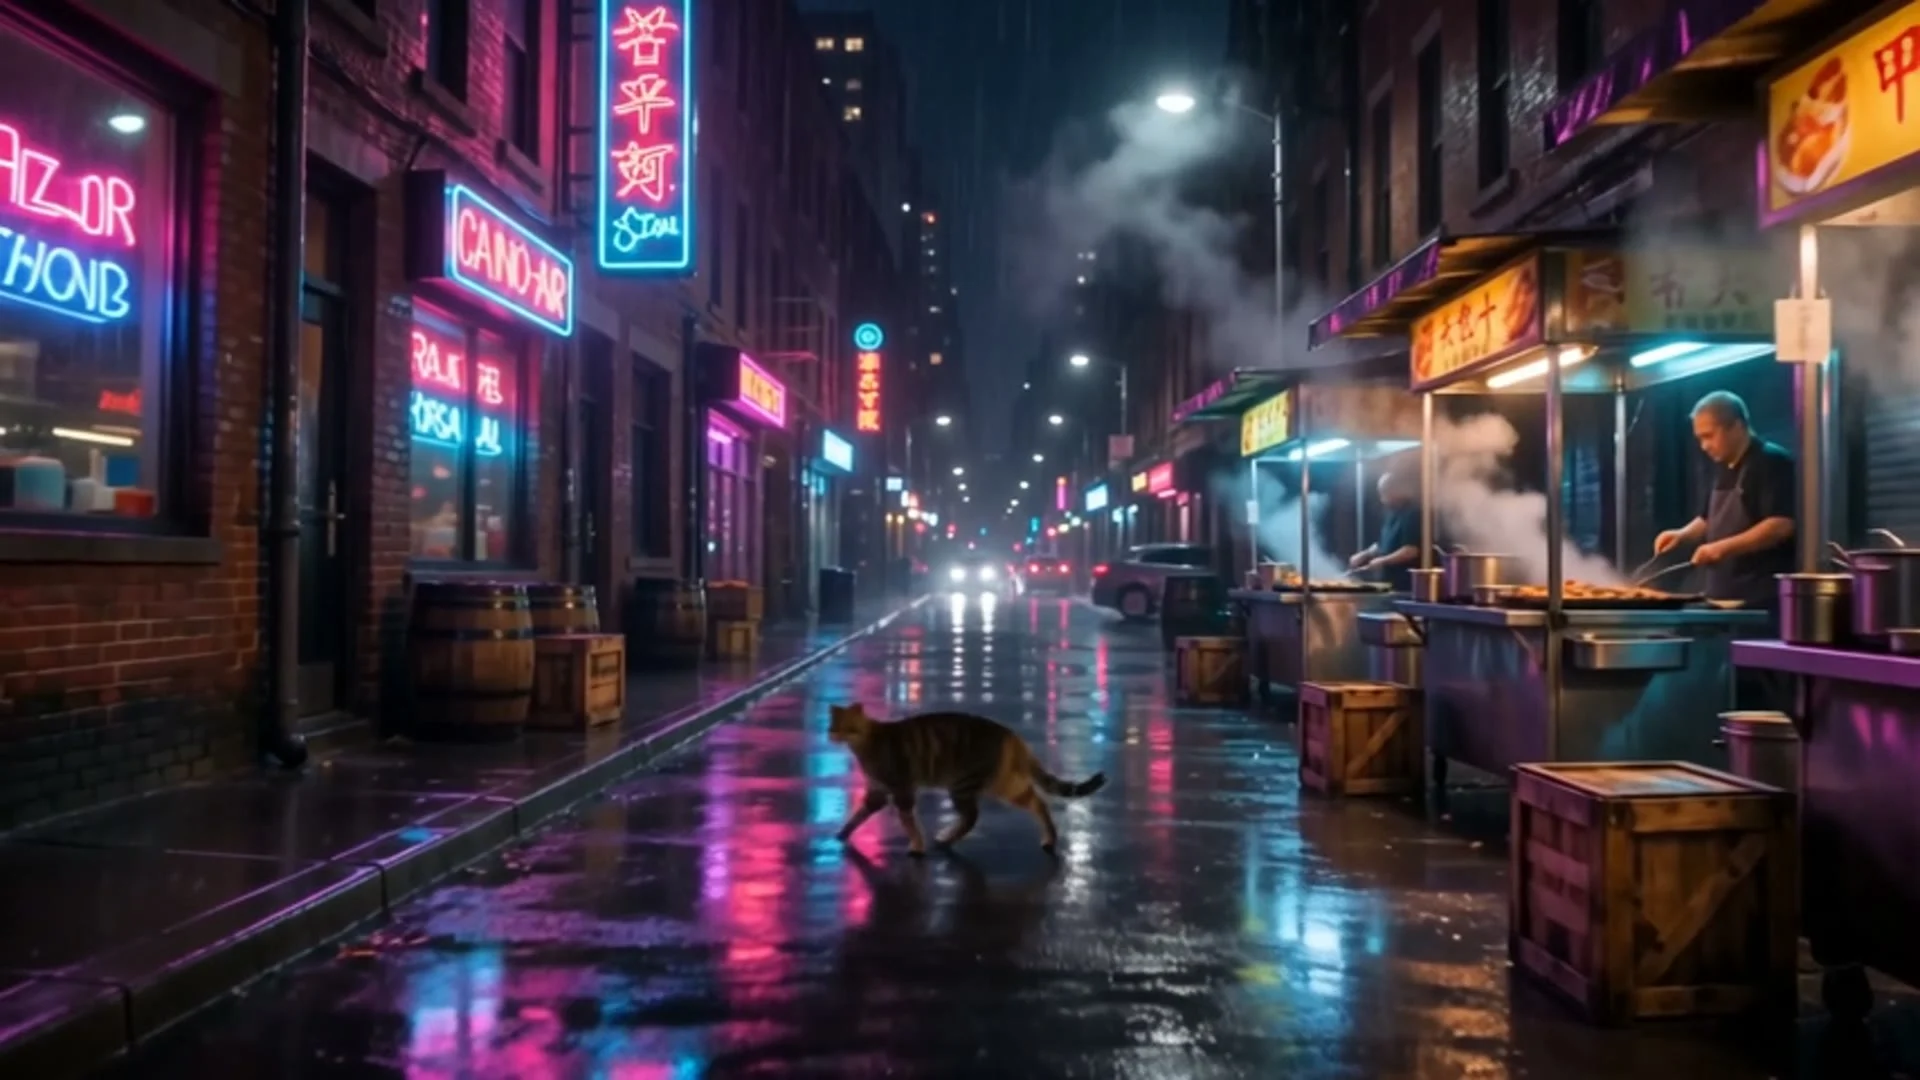
I 3 video qui sotto sono tutti generati in un solo passaggio con Wan 3.0 Prime (wan3.0-video-prime): un text-to-video, un text-to-video con audio sincronizzato e un reference-to-video che blocca il soggetto con un'immagine di riferimento. Per ognuno trovi il prompt completo, i parametri della richiesta e il prezzo; cliccando su «Genera con questo prompt» si apre la pagina del modello con il prompt già compilato. Tutti e 3 sono a 480P, 5 secondi, $0.4375 ciascuno, $1.3125 in totale.
Cosa hanno di diverso i prompt di Prime
- Capisce i movimenti di macchina e le azioni. Parole come dolly-forward, orbita a 180 gradi o lento push-in controllano davvero la camera. Un elenco di sostantivi («un gatto, una strada, neon») è uno spreco; solo una frase con un'intenzione registica produce un'inquadratura da regista.
- Sa produrre audio.
audioè attivo per impostazione predefinita e il modello aggiunge suoni ambientali, effetti sonori e musica leggera in base alle immagini; impostandolo sufalseottieni un video muto. - Sa usare le immagini di riferimento. Il testo può descrivere solo una categoria di cose («una volpe di ceramica»), un'immagine di riferimento blocca una cosa specifica. Se carichi un'immagine, Prime anima proprio quella, senza reinventarla ogni volta.
1. Inquadratura food di prodotto (text-to-video)
A single scoop of pistachio gelato in a frosted coupe glass on a pale marble
counter; slow 180-degree orbit as a bead of condensation slides down the glass,
soft window light from the left, shallow depth of field, warm late-afternoon
tones, faint steam curling from an espresso cup just behind in soft focus.
Genera con questo prompt → (5 secondi, 480P, 16:9, audio disattivato)
wan3.0-video-prime, 480P, 5 secondi, 16:9, audio disattivato, $0.4375.
L'ordine delle frasi è l'ordine in cui il modello legge un'inquadratura: soggetto, movimento di macchina, un dettaglio centrale, direzione della luce, profondità di campo, tonalità. «slow 180-degree orbit» dà un solo movimento di macchina chiaro, «una goccia di condensa che scende lungo il vetro» dà una sola piccola azione, e il realismo arriva. Specificando che la luce viene da sinistra e la profondità di campo è ridotta, lo sfondo resta una sfocatura pulita e non un ammasso confuso. Lo stesso schema funziona per prodotti e food: un soggetto, un movimento di macchina, una piccola azione.
2. Inquadratura d'atmosfera con audio sincronizzato (text-to-video)
Per questo ricorda di attivare l'audio: il rumore della pioggia, il traffico in lontananza e lo sfrigolio della griglia sono generati in base alle immagini.
Rain streaking down a narrow neon-lit alley at night; a slow dolly-forward past
steaming street-food stalls, magenta and cyan reflections rippling in the wet
pavement, a tabby cat darting between crates mid-shot. Ambient sound: steady
rain, distant traffic hiss, the sizzle of a grill and a low synth drone.
Genera con questo prompt → (5 secondi, 480P, 16:9, audio attivato)
wan3.0-video-prime, 480P, 5 secondi, 16:9, con audio, $0.4375.
Scrivere l'audio è un'arte a parte: prima descrivi le immagini, poi aggiungi una frase separata «Ambient sound:» elencando 3–4 livelli sonori concreti: una base continua (la pioggia), uno strato in lontananza (il traffico), un effetto in primo piano (la griglia), uno strato tonale (il drone del synth). Scrivendo solo «effetti sonori cinematografici» ottieni una poltiglia; se nomini i livelli, il modello ha qualcosa da mixare. Anche nella parte visiva dai un solo movimento di macchina (slow dolly-forward) e aggiungi un soggetto in movimento (il gatto): l'inquadratura prende vita senza diventare caotica.
3. Bloccare il soggetto (reference-to-video)
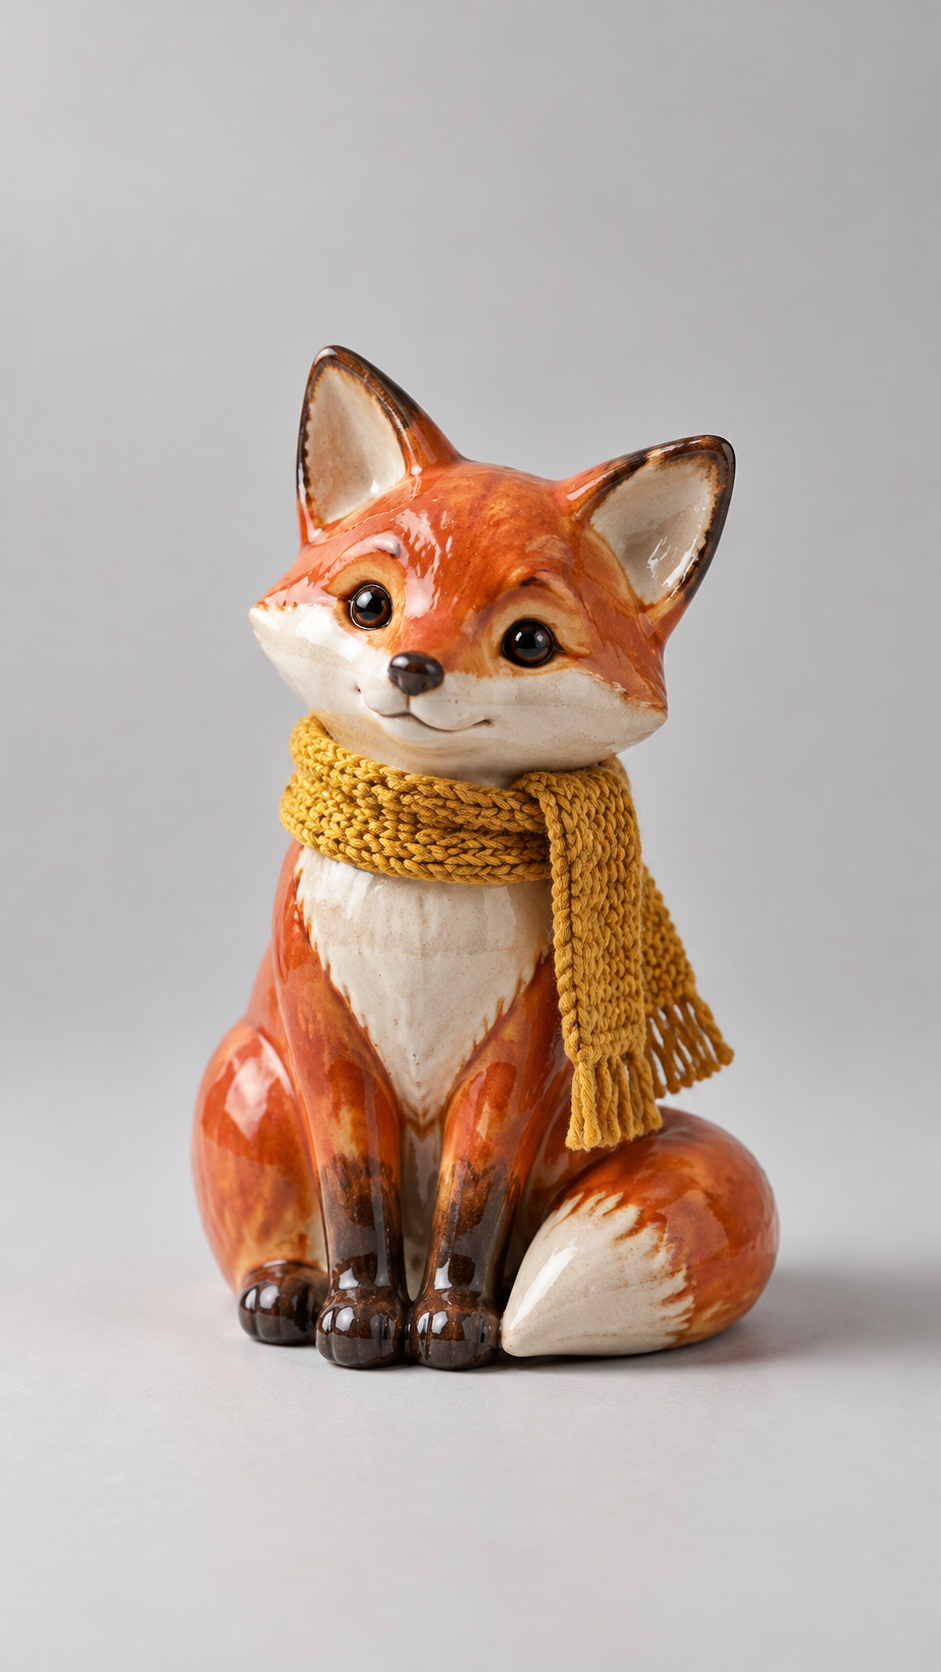
Questo è il pezzo forte di Prime. Scrivendo solo testo, il soggetto viene ricreato ogni volta; caricando un'immagine di riferimento, viene bloccato. Qui prepariamo un'immagine di una statuina di volpe in ceramica e la mettiamo in reference_image_urls: nel video si muove proprio quella volpe, con lo stesso smalto e la stessa sciarpa.
Immagine di riferimento:
Risultato:
Bring the referenced ceramic fox figurine to life: it slowly turns its head
toward camera, blinks, and tilts with a curious expression; subtle idle
breathing, a light breeze stirring the tiny scarf, soft studio key light on a
clean seamless backdrop, smooth loopable motion.
Genera con questo prompt → (carica la tua immagine di riferimento, 5 secondi, 480P, 9:16, audio disattivato)
wan3.0-video-prime, immagine di riferimento, 480P, 5 secondi, 9:16, audio disattivato, $0.4375.
Richiesta completa:
{
  "model": "wan3.0-video-prime",
  "input": {
    "prompt": "Bring the referenced ceramic fox figurine to life ...",
    "resolution": "480P",
    "duration": 5,
    "aspect_ratio": "9:16",
    "audio": false,
    "reference_image_urls": [
      "https://static.hiapi.ai/blog/wan3-0-video-prime-prompt-recipes/recipe-3-reference-fox.jpg"
    ]
  }
}
Con un'immagine di riferimento, smetti di descrivere l'aspetto del soggetto e usa lo spazio per «dirigere la scena». Inizia il prompt con «Bring the referenced … to life» per far capire al modello che l'immagine è la base del soggetto, poi scrivi solo le azioni che nell'immagine non ci sono: girare la testa, sbattere le palpebre, respirare, il vento che muove la sciarpa. «smooth loopable motion» rende più facile chiudere un loop tra inizio e fine, e 9:16 dà subito il formato verticale. Scegli immagini di riferimento con un soggetto pulito, buona luce e sfondo semplice; con sfondi disordinati e molti soggetti la coerenza si perde più facilmente.
Uno scheletro riutilizzabile
I tre prompt qui sopra sono in realtà lo stesso scheletro:
- Soggetto: un protagonista chiaro (se hai caricato un'immagine di riferimento scrivi «the referenced …»).
- Camera: un solo movimento di macchina (orbita, avanzamento, inseguimento), non tre.
- Azione: una o due piccole cose che si muovono davvero, vive ma non caotiche.
- Immagine: direzione della luce, profondità di campo, tonalità.
- Audio (facoltativo): una frase separata «Ambient sound:» che nomina alcuni livelli sonori.
Cambia i sostantivi, mantieni la struttura.
Riprodurre con l'API
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan3.0-video-prime",
    "input": {
      "prompt": "A single scoop of pistachio gelato in a frosted coupe glass on a pale marble counter; slow 180-degree orbit",
      "resolution": "480P", "duration": 5, "aspect_ratio": "16:9", "audio": false
    }
  }'
Dopo che la risposta restituisce data.taskId, usa GET /v1/tasks/{taskId} per verificare che status sia success, poi scarica da output[0].url: è un link temporaneo, salvalo subito. Per l'integrazione completa vedi la guida API in cinese di Wan 3.0 Prime.
Quanto costa
- 480P $0.0875 al secondo: 5 secondi $0.4375
- 720P $0.18 al secondo: 5 secondi $0.90
- 1080P $0.36 al secondo: 5 secondi $1.80
Metti a punto il prompt a 480P, poi, quando è definitivo, cambia resolution in 720P o 1080P e rigenera una volta: il prompt non va modificato. Attenzione: resolution è 1080P per impostazione predefinita. Se non ti serve la velocità di Prime, la versione standard Wan 3.0 wan3.0-video costa meno al secondo. Dettagli su prezzi API di Wan 3.0 Prime.
Domande frequenti
Prime produce davvero l'audio?
Sì. Con audio su true (impostazione predefinita) restituisce un video con traccia audio sincronizzata; impostandolo su false è muto. Il video 2 è generato con l'audio attivo.
Quanto può durare al massimo un video?
duration è un intero tra 2 e 30; il costo cresce linearmente con la durata.
Quali risoluzioni e formati sono supportati?
resolution può essere 480P, 720P, 1080P (in maiuscolo); aspect_ratio può essere adaptive, 16:9, 4:3, 1:1, 3:4, 9:16.
Come mantengo lo stesso personaggio o prodotto coerente in più video?
Usa reference_image_urls per caricare un'immagine di riferimento e scrivi le azioni nel prompt, non l'aspetto.
Perché la mia bozza sembra un po' sfocata?
Perché è a 480P, la fascia economica pensata apposta per le bozze. Una volta fissato il prompt, porta la risoluzione a 720P o 1080P.
Scegli il prompt più vicino alle tue esigenze, vai alla pagina del modello e genera il primo, poi cambia i sostantivi.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori