
Meta
Muse Image 1.0
muse-image-1.0/text-to-image
Modelo de geração e edição de imagens baseado em raciocínio da Meta, que primeiro decompõe prompts complexos e depois renderiza, podendo combinar várias imagens de referência e usar a busca na web para garantir precisão factual
Experimentar muse-image-1.0/text-to-image
Entrada
Criações
Ver todas as criaçõesSaída
image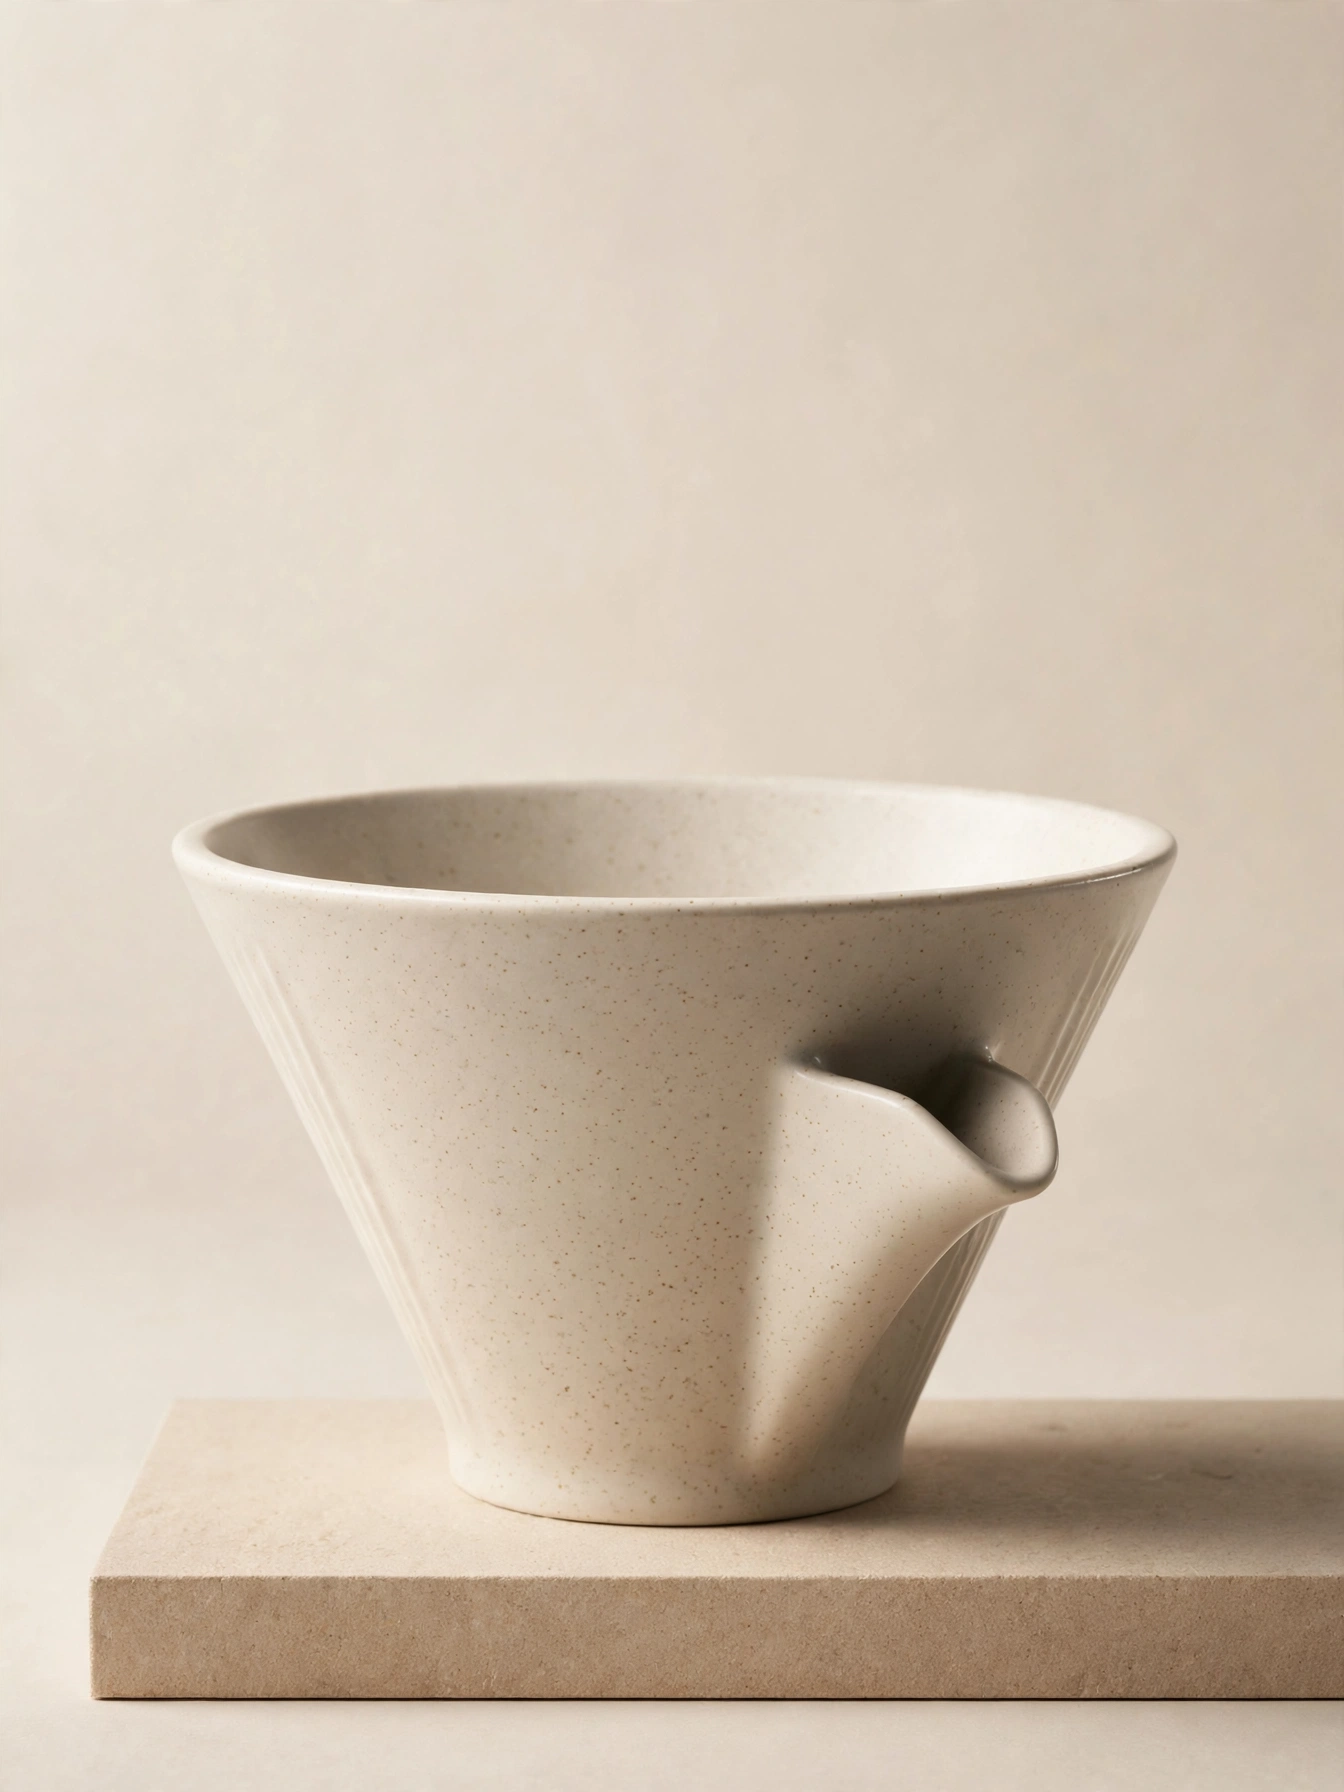
Qualidade de fotografia de produto nível e-commerce: geração de imagens com muse-image
Estilo Imagem do produto · Iluminação de estúdio · Negócios
Prompt
Foto de produto em estúdio de um porta-filtro de café pour-over de cerâmica fosca, branco quente puxado para bege, em perspectiva de três quartos centrada sobre uma base baixa cor de areia. Fundo contínuo bege-claro sem emendas, com transição em degradê suave. Luz principal de softbox grande a 45 graus no canto superior esquerdo, painel refletor leve à direita para clarear as sombras, e uma faixa estreita de luz de contorno na borda direita para separar o sujeito do fundo. Textura de finas manchas visível no esmalte, borda da xícara arredondada e nítida, bico geometricamente preciso. Capturado com lente equivalente a 85mm, abertura f/8, queda suave nas bordas distantes, sem distorção. Estética de retoque comercial limpo, balanço de branco neutro, altas luzes controladas sem superexposição, sombra de contato suave que assenta o objeto. Composição vertical 4:3 com amplo espaço negativo no topo para diagramação. Sem texto, sem logotipo, sem adereços desorganizados.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
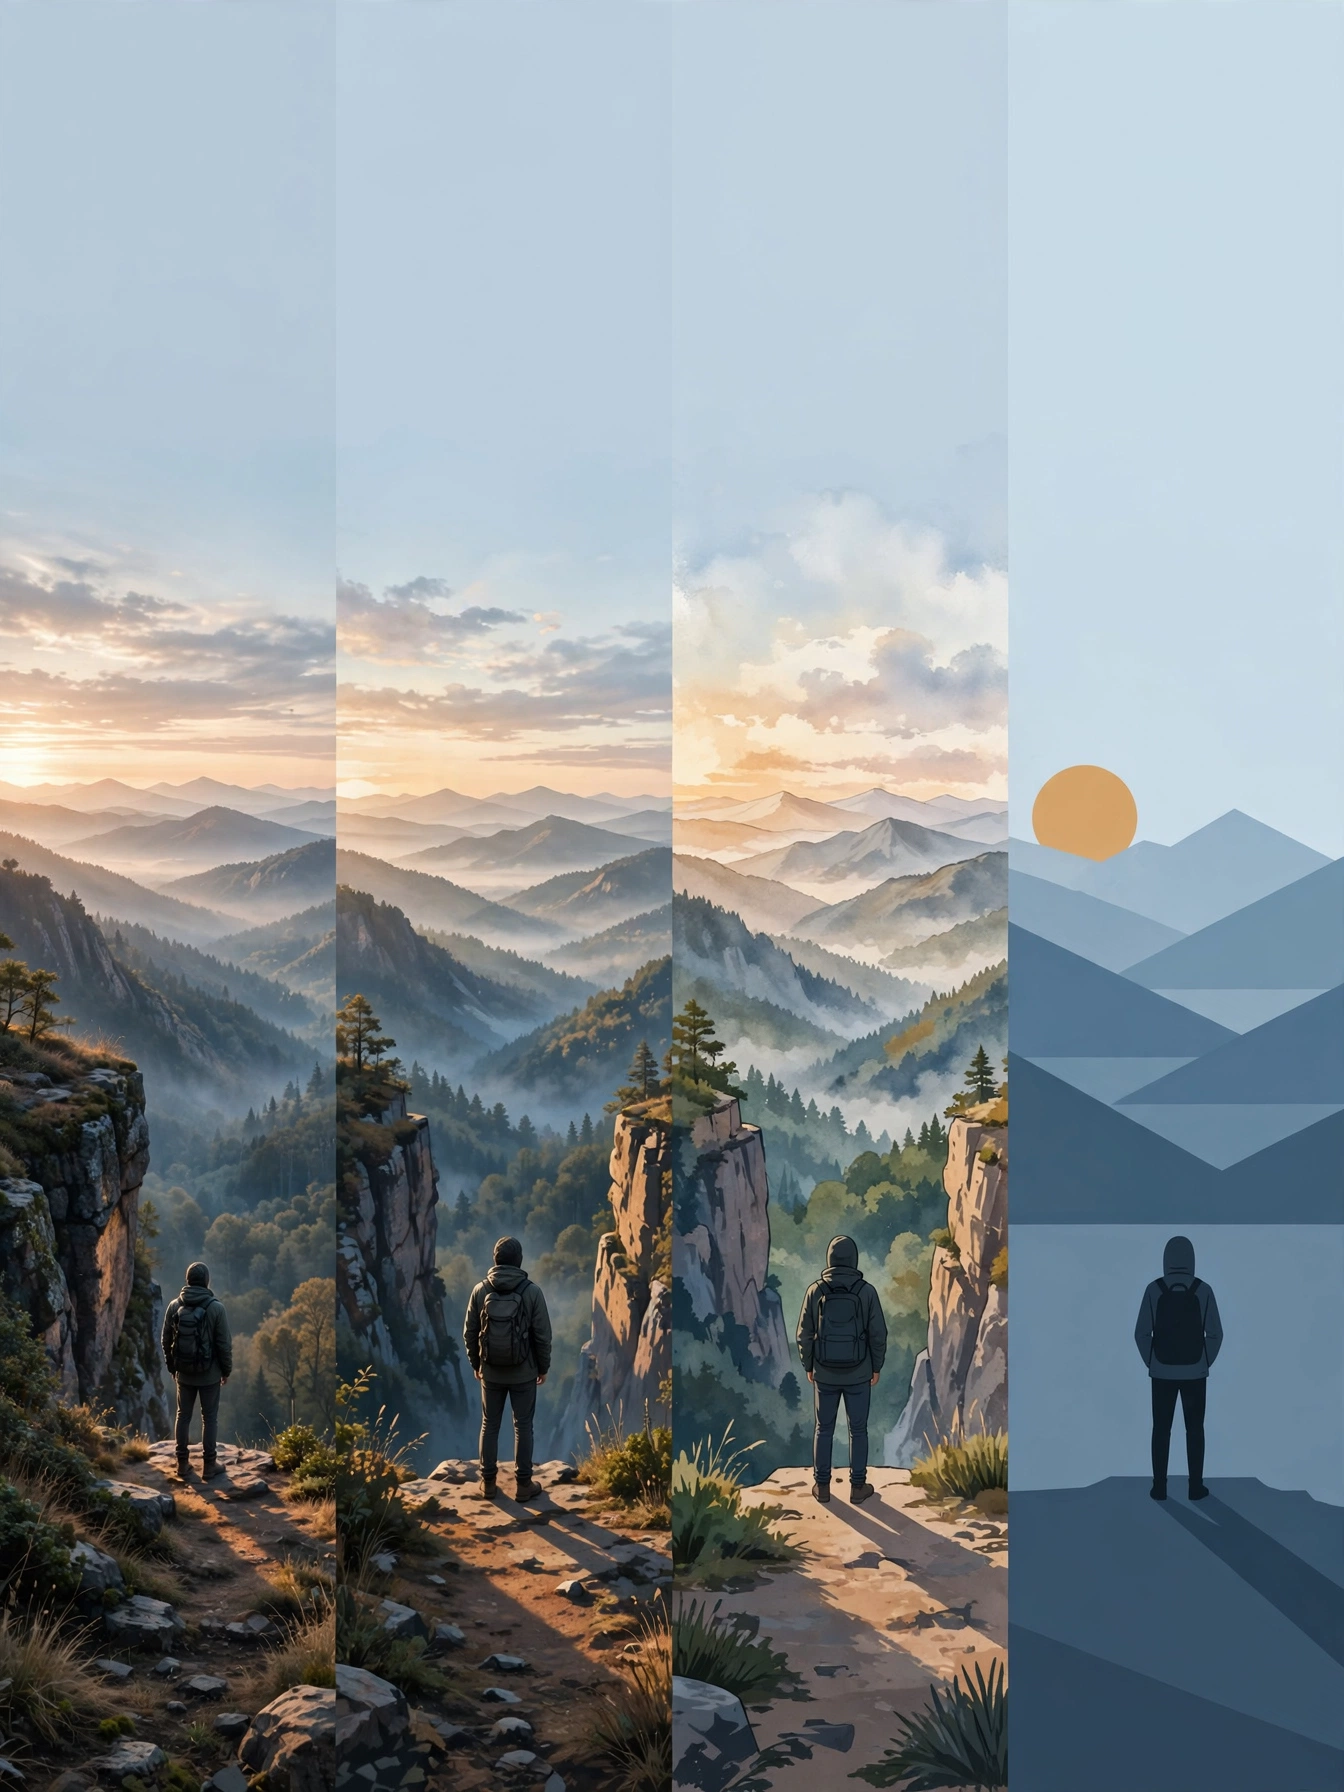
Do realismo ao flat: o espectro de estilos de ilustração
Estilo Ilustração · Estudo de estilo · Direção de arte
Prompt
Uma ilustração editorial com um único sujeito, apresentando um espectro do realismo ao estilo flat: uma figura solitária em pé à beira de um penhasco, contemplando um vale em camadas sobrepostas ao amanhecer. Composição: sujeito centralizado, ancorado no terço inferior do quadro, o vale recua em faixas horizontais em direção a um horizonte alto e distante, com amplo espaço negativo no céu acima para composição tipográfica. Estilo: linguagem de ilustração coerente, com estágios deliberadamente simplificados — de um lado, volume fotorrealista e névoa atmosférica; do outro, blocos de cor vetoriais de bordas duras sem gradientes. Iluminação: luz solar quente de baixo ângulo vinda da esquerda, sombras longas e suaves, luz de preenchimento ambiente fria no vale. Paleta: azul-ardósia dessaturado com toques de ocre quente, cores limitadas e contidas. Acabamento: obra nítida e pronta para impressão, silhuetas limpas, sem texto ou marca d'água.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
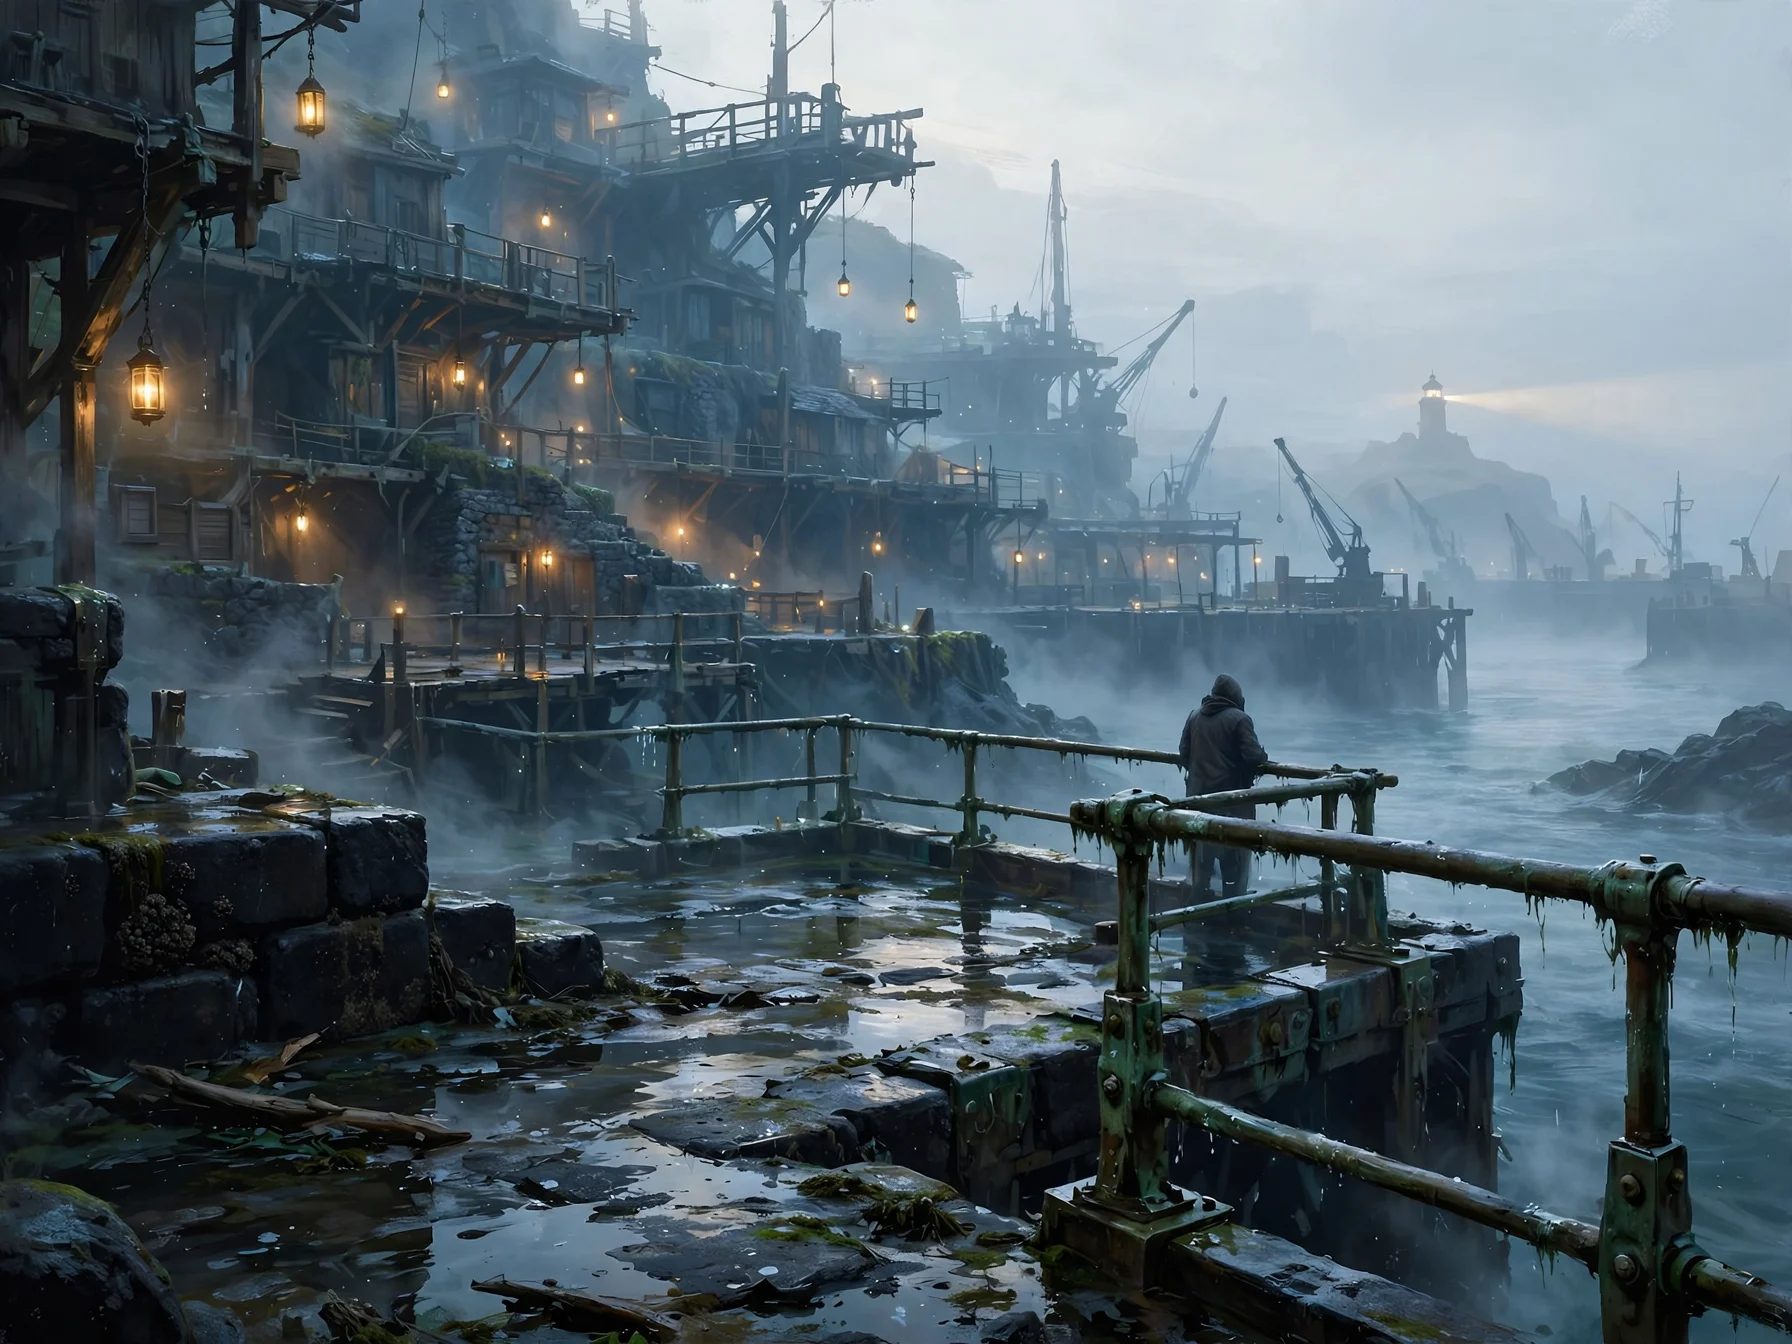
Concept art de cenário de worldbuilding: Plataforma de Marés do Porto Nebuloso
Estilo Construção de mundo · Arte conceitual · Atmosfera
Prompt
Uma obra de concept art cinematográfica em formato panorâmico, retratando um porto costeiro envolto em névoa num mundo fictício, composição panorâmica 21:9. Primeiro plano: uma plataforma de observação de marés erodida pelo vento marinho, construída em basalto escuro e latão oxidado, meio exposta após a maré baixa, com a superfície pétrea úmida refletindo o céu pálido. Plano médio: edifícios portuários em camadas encostados ao penhasco, passarelas de madeira, lanternas suspensas emitindo um brilho âmbar quente na névoa azul-fria, e uma figura solitária com um sobretudo pesado junto à balaustrada da plataforma, para dar escala. Fundo: a foz do porto dissolve-se em camadas de névoa, com silhuetas de guindastes e o feixe de luz de um farol distante varrendo lentamente. Atmosfera: névoa marítima densa, respingos de água suspensos, atenuação de profundidade de campo de baixo contraste. Iluminação: amanhecer frio e nublado, com uma única fonte de luz prática quente vinda das lanternas e luz volumétrica suave. Estilo: concept art digital pictórico, paleta contida — azul-ardósia, verde-azulado oxidado e âmbar apagado, detalhes materiais refinados na pedra e no metal, sem texto, sem logotipos.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
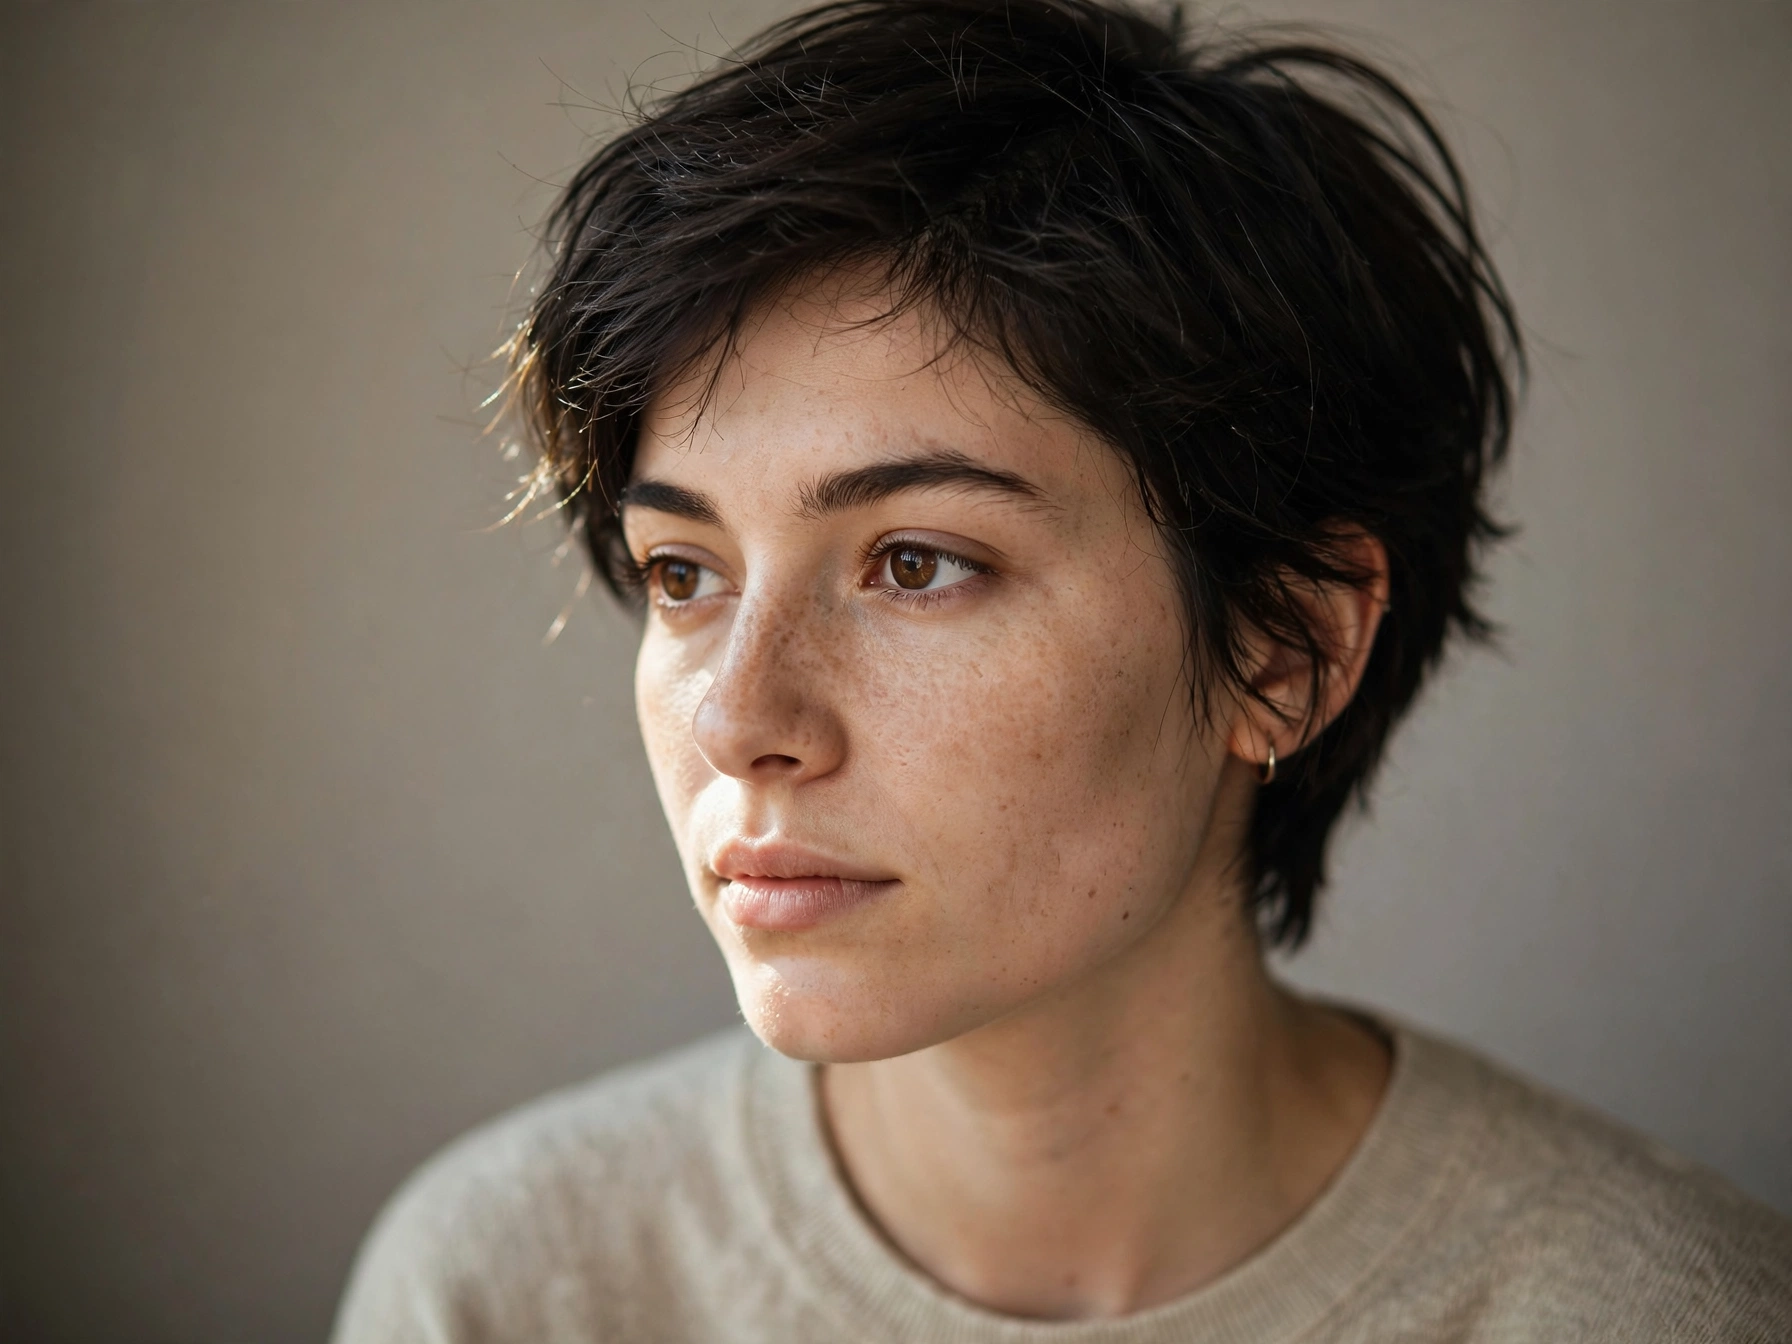
Muse Image referência de estilo de retrato: dois caminhos de prompt, o realista e o artístico
Estilo Retrato e fotografia · Fotorrealismo · Editorial
Prompt
Um retrato de estúdio vertical em 3:4, mostrando uma jovem com sardas no rosto, cabelo curto escuro, ombros relaxados, olhar direto e ligeiramente desviado da câmera. Uma luz principal suave e ampla vinda da esquerda da câmera forma um contorno sutil no cabelo, e a luz se dissolve suavemente em um fundo infinito cinza quente. Capturado com lente de 85mm em abertura f/2.0, profundidade de campo rasa, textura de pele realista, poros visíveis e fios de cabelo finos, gradação de cor contida, sem vestígios de retoque. Estética geral de fotografia editorial, atmosfera calma e sóbria, detalhes faciais ricos, fundo deliberadamente simples para manter a atenção sempre no sujeito.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
muse-image-1.0/text-to-image per task
| Preço unitário | $0.015 |
|---|
Visão geral da posição
muse-image-1.0/text-to-image é a rota puramente textual no HiAPI.ai do modelo de texto para imagem lançado pela Meta, adotando um fluxo de geração de raciocínio primeiro, renderização depois: antes de gerar a imagem, decompõe prompts de múltiplos parágrafos, planeja o layout da cena e se autocorrige durante o processo de raciocínio. É adequado para desenvolvedores que precisam de geração em lote de alta concorrência e com prompts mais complexos, como variantes de materiais publicitários, imagens de catálogo de produtos, etc. Por meio da interface unificada do HiAPI.ai, basta um prompt de texto para gerar imagens, com proporção e formato de saída selecionáveis.
Destaques principais
- Raciocínio antes da renderização, prompts complexos mais controláveis — antes da renderização, decompõe prompts de múltiplos parágrafos na cadeia de raciocínio, planeja o layout e corrige iterativamente a saída, sendo mais adequado para descrições estruturadas do que a geração em uma única passagem.
- Prompts intensivos em conhecimento podem usar busca na web — ao encontrar prompts que exigem informações do mundo real, aciona a busca na web para calibrar o conteúdo, reduzindo desvios em ilustrações de natureza factual.
- Saída de imagem final em uma única chamada, integração simples — basta enviar o prompt de texto para especificar a proporção e o formato de saída jpeg, png ou webp, obtendo diretamente um ativo de imagem pronto para uso.
Descrição das capacidades
Texto para imagem com raciocínio: decompõe prompts complexos de múltiplos parágrafos em elementos visuais executáveis, planeja o layout antes da renderização e se autocorrige, reduzindo o custo de ajustes repetidos no prompt.
Proporções predefinidas: oferece nove proporções — 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3, 21:9 e 9:21 — que podem ser selecionadas diretamente conforme o posicionamento de mídia ou o layout, sem necessidade de recorte posterior.
Saída em múltiplos formatos: suporta três formatos de download — jpeg, png e webp —, com webp como padrão, facilitando a escolha conforme exibição no front-end, arquivamento ou fluxos de processamento posteriores.
Suporte a prompts longos: limite de 5000 caracteres no prompt, comportando necessidades complexas de geração com múltiplos parágrafos e descrições com restrições.
Cenários de aplicação
- Equipes de mídia gerando variantes de anúncios em lote — usar vários conjuntos de prompts de texto com o mesmo argumento de venda para gerar imagens em lote, produzindo materiais em diferentes proporções, diretamente para testes de veiculação em múltiplos canais.
- Operações de e-commerce criando imagens de cena de produtos — gerar imagens de cena em diferentes estilos e composições a partir de descrições textuais de produtos, complementando o catálogo e as páginas de detalhes.
- Operações de conteúdo ilustrando pautas de conhecimento — inserir descrições de pauta com elementos factuais para produzir ilustrações alinhadas ao conteúdo, usadas em artigos, postagens e publicações em redes sociais.
Limitações e recomendações de seleção
Materiais públicos não divulgam a resolução de saída desta rota; a proporção define apenas o formato, não o tamanho exato em pixels, portanto cenários com requisitos rígidos de resolução precisam de verificação prévia. O fluxo com raciocínio e a busca na web sob demanda trazem latência adicional, não sendo adequados para geração em tempo real com latência extremamente baixa. A saída é limitada a imagens, sem vídeo ou áudio. Se a tarefa exigir fusão ou reescrita com base em uma imagem de referência, deve-se escolher a rota image-to-image da mesma família.
Perguntas frequentes
Ver todas as perguntas →-
Como escolher entre geração de imagem a partir de texto e edição de imagem?
Quando você tem apenas texto e vai começar do zero, escolha a geração de imagem a partir de texto; quando precisar manter um sujeito ou layout existente, escolha a edição de imagem e forneça uma imagem de referência.
-
Quantas imagens posso obter por vez?
Cada tarefa retorna uma imagem, sem opção de quantidade. Se precisar comparar outra composição, ajuste o prompt e envie uma nova tarefa.
-
Posso escolher 1K, 2K ou 4K?
Esta entrada não oferece níveis de resolução. O enquadramento é escolhido por você e as dimensões em pixels são determinadas pelo modelo, geralmente cerca de 2,5MP; consulte as dimensões reais do arquivo baixado.
-
Quais formatos de arquivo posso escolher?
Você pode escolher JPEG, PNG ou WebP; se nenhum for selecionado, WebP é usado. Escolha de acordo com as necessidades posteriores de materiais para páginas web ou ferramentas de design.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: muse-image-1.0/text-to-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para muse-image-1.0/text-to-image e a rota default — veja a tabela de parâmetros abaixo.
promptstringObrigatóriominLength 1maxLength 5000Usado para descrever a imagem que você deseja gerar, ou para explicar o que precisa ser modificado e preservado na imagem de referência; assume a forma de string.
aspect_ratiostringOpcionalSelecione a proporção de aspecto da imagem de saída; assume a forma de string; este item não especifica dimensões exatas em pixels.
1:14:33:416:99:163:22:321:9Mostrar tudo (1)
9:21output_formatstringOpcionalPadrão: "webp"Selecione o formato de arquivo para baixar a imagem; assume a forma de string; o padrão é webp.
jpegpngwebpcallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/text-to-image",
  "input": {
    "prompt": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/text-to-image",
input: {
"prompt": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/text-to-image",
"input": {
"prompt": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
recraft-v4.1-flash geração de imagens por texto na prática: 5 cenários de negócio de alto valor e pontos de integração
Partindo de um custo de US$ 0,01 por imagem, planeje como aplicar a geração de imagens em negócios reais
-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagem
-
 Recraft Creative Upscale Recraft $0.357 /imagem
-
 Seedream 5.0 ByteDance $0.025 /imagem
-
 Qwen Image 3.0 Alibaba $0.036 /imagem
-
 Seedream 4.5 ByteDance $0.045 /imagem
-
 FASHN Tryon v1.6 FASHN $0.107 /imagem
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagem
-
 Nano Banana 2 Google $0.036 /imagem
-
 GPT Image 2.5 OpenAI $0.017 /imagem
-
 Grok Imagine xAI $0.011 /segundo
-
 FLUX 3 Image Black Forest Labs $0.041 /imagem
-
 Imagen 4 Google $0.030 /imagem
