
Meta
Muse Image 1.0
muse-image-1.0/text-to-image
Metas räsonierendes Modell zur Bildgenerierung und -bearbeitung: Es zerlegt komplexe Prompts vor dem Rendern, kann mehrere Referenzbilder zusammenführen und mithilfe von Websuche die sachliche Richtigkeit sicherstellen
muse-image-1.0/text-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image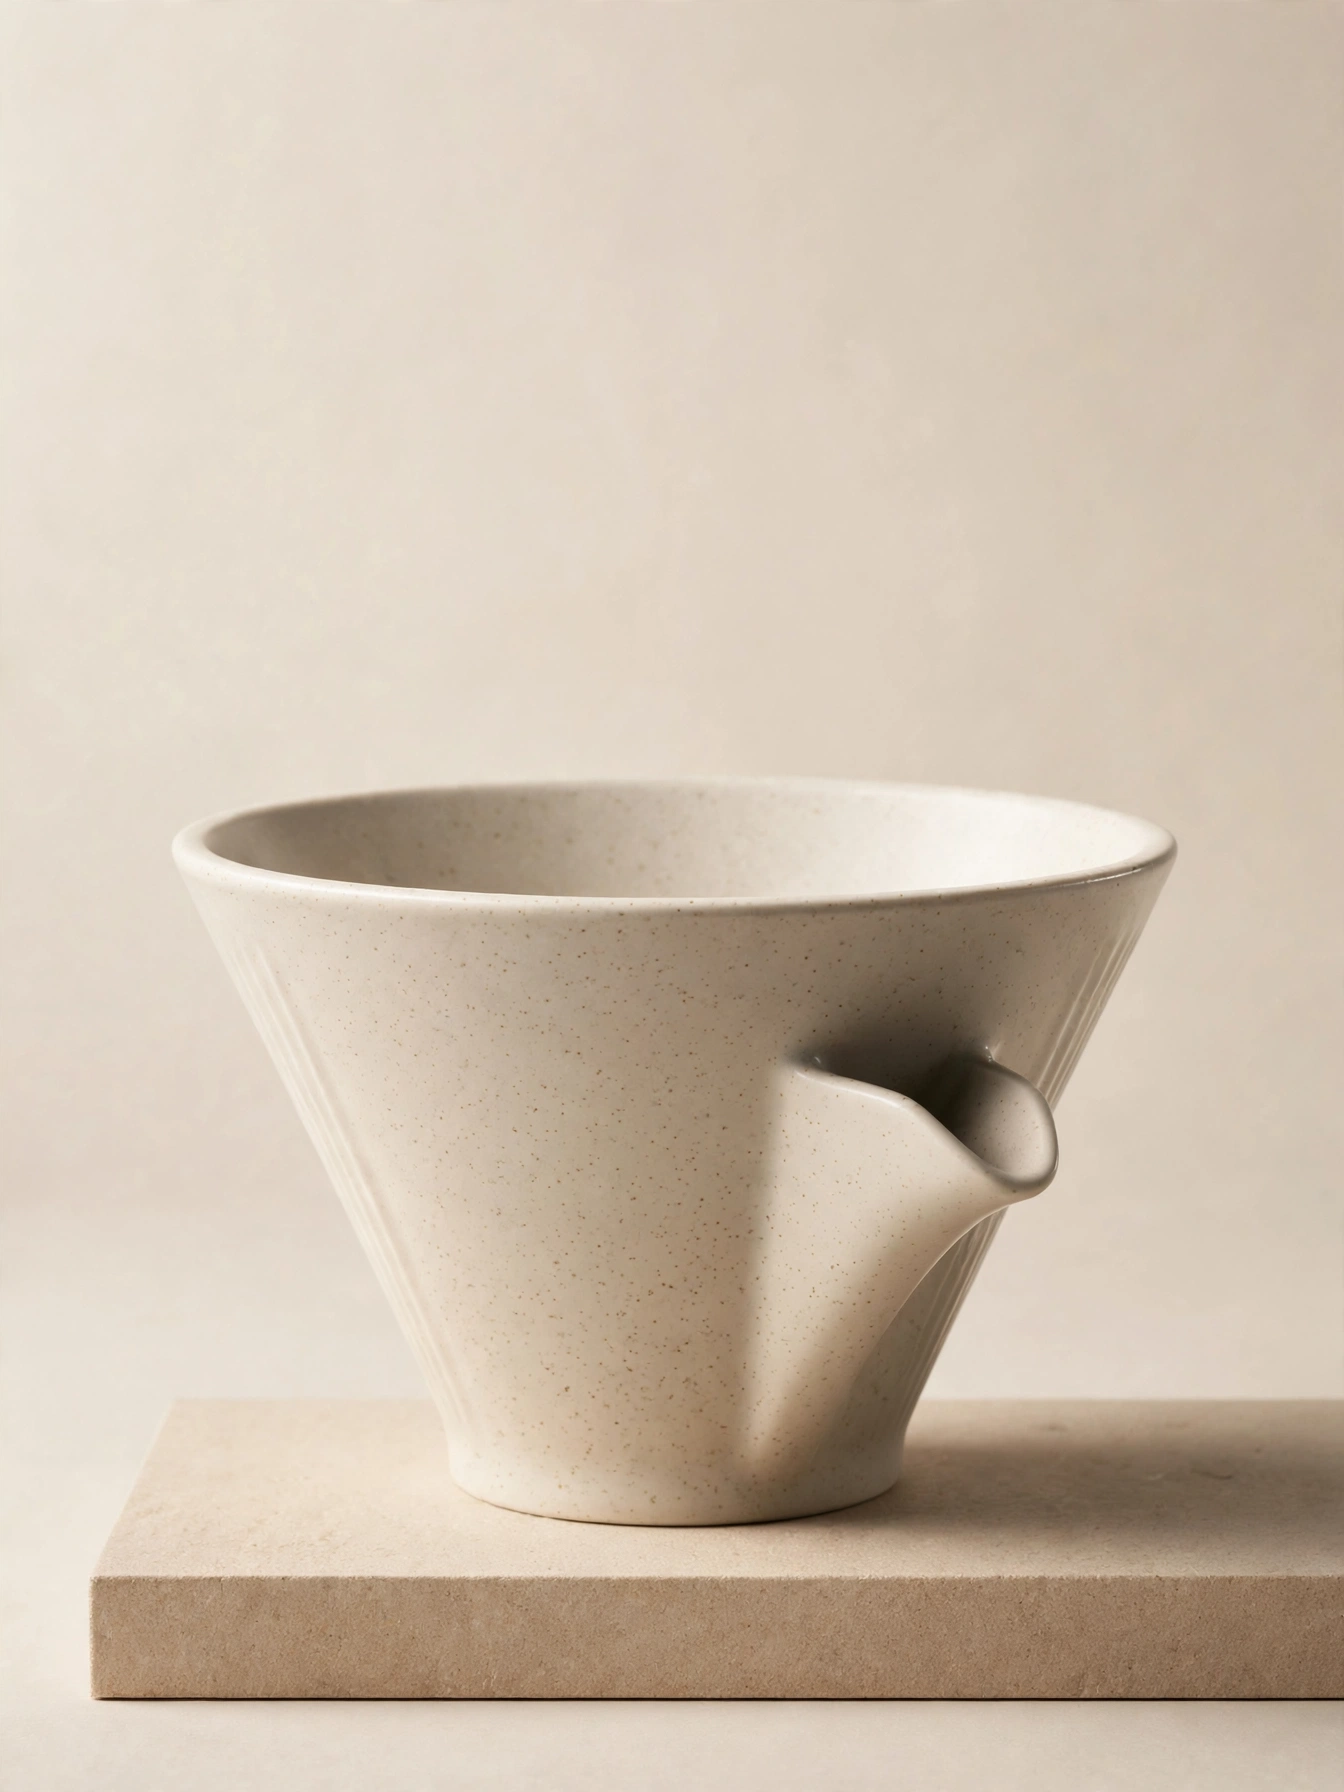
E-Commerce-Produktfotografie-Qualität: Texterzeugung mit muse-image
Stil Produktbild · Studiobeleuchtung · Business
Prompt
Studio-Produktaufnahme eines matten Keramik-Handfilterkaffee-Drippers in warmem, leicht beigefarbenem Ton, zentriert auf einem niedrigen sandfarbenen Sockel in Dreiviertelansicht. Nahtloser hellbeiger Hintergrund mit weichem Verlauf. Großes Softbox-Hauptlicht von links oben im 45-Grad-Winkel, rechts ein dezentes Aufhellpanel zur Aufhellung der Schatten, am rechten Rand ein schmaler Kantenlichtstreifen, der das Motiv vom Hintergrund trennt. Auf der Glasur feine sichtbare Sprenkeltextur, die Tassenöffnung rund und klar, der Ausguss geometrisch präzise. Aufgenommen mit einem 85-mm-Äquivalentobjektiv bei Blende f/8, weiche Abblendung an den fernen Rändern, keine Verzerrung. Saubere kommerzielle Retusche-Ästhetik, neutraler Weißabgleich, kontrollierte Glanzlichter ohne Überbelichtung, weicher Kontaktschatten, der das Objekt verankert. 4:3-Hochformat, oben großzügiger Negativraum für die Typografie. Kein Text, keine Logos, keine unruhigen Requisiten.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
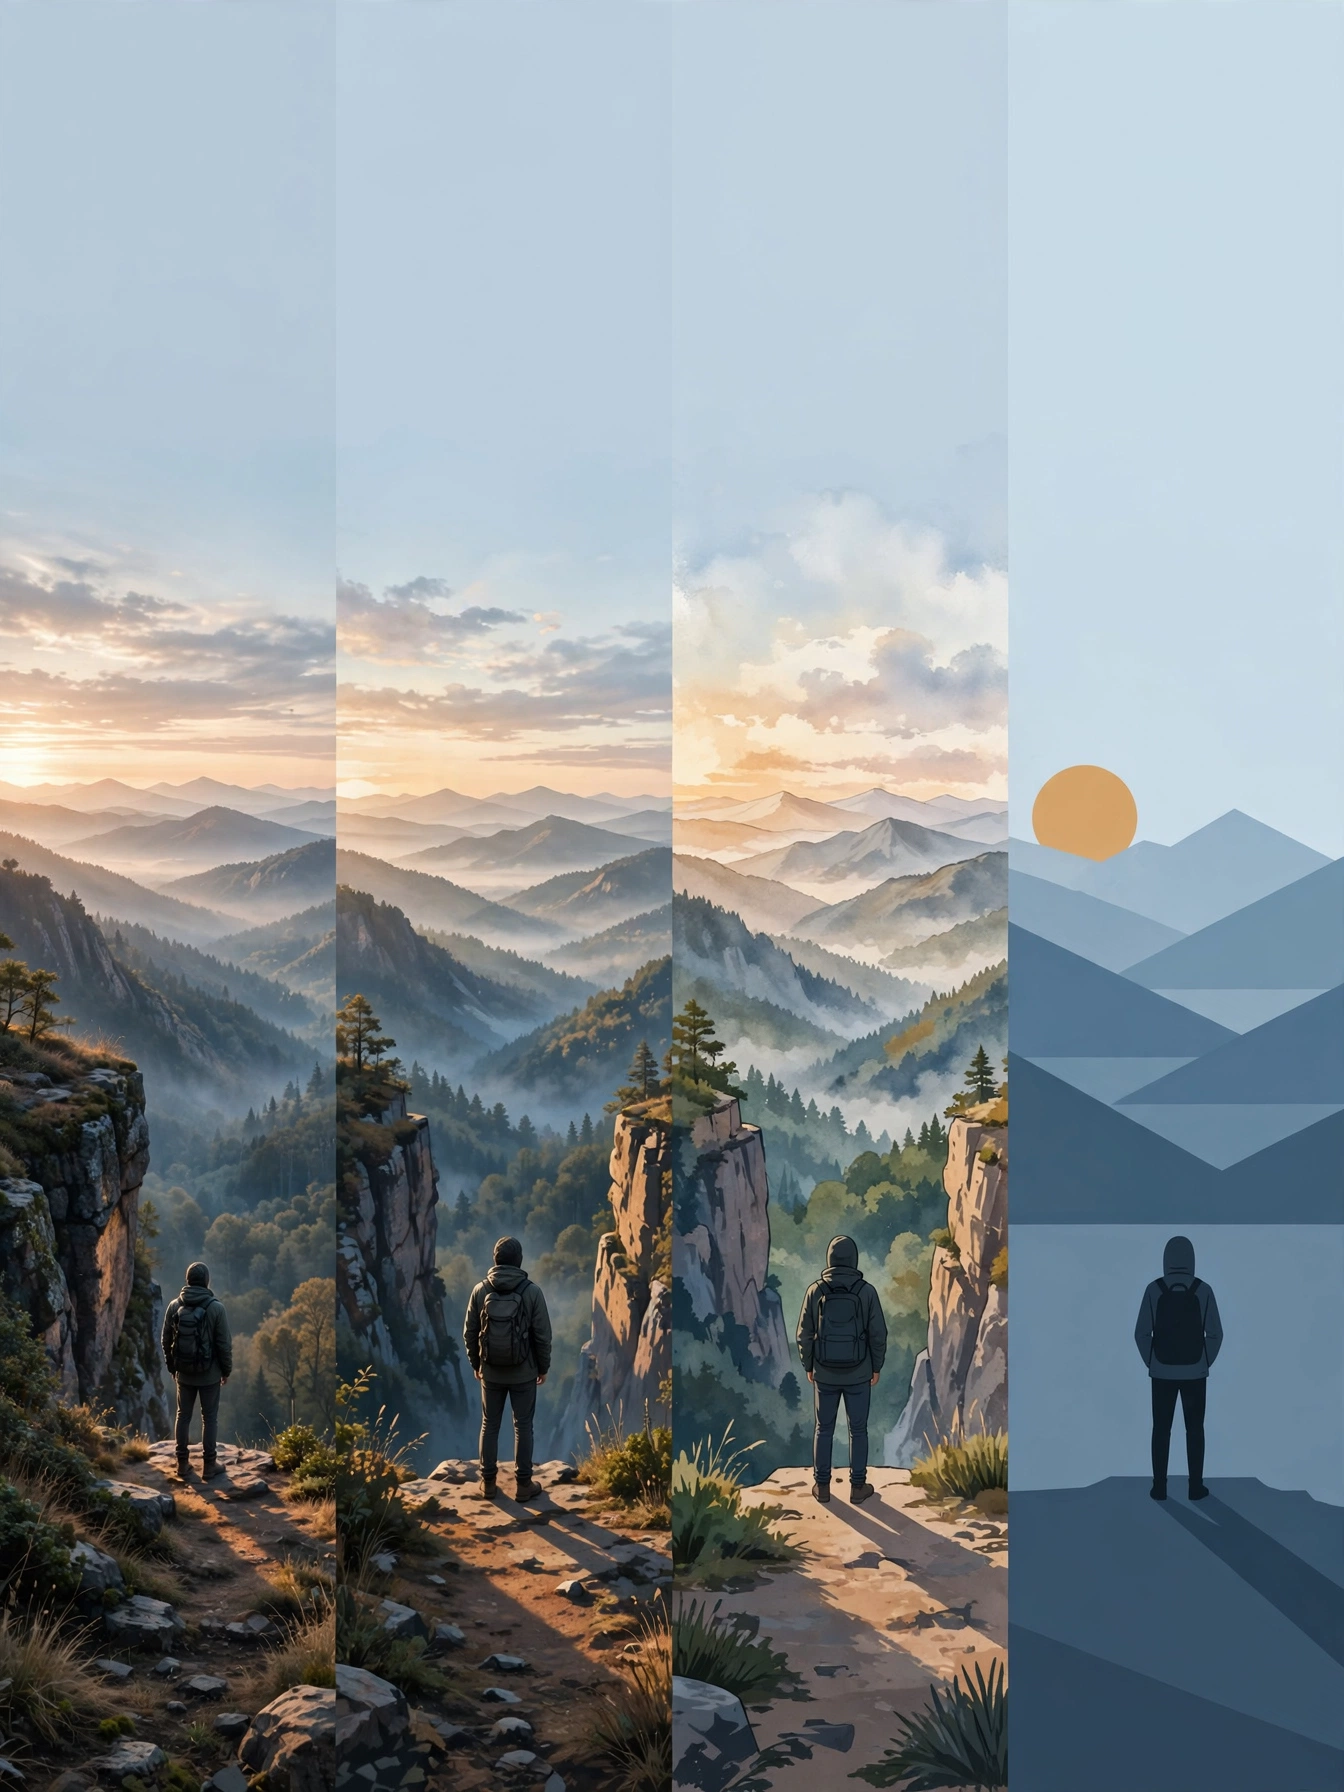
Das Spektrum der Illustrationsstile: von realistisch bis flach
Stil Illustration · Stilstudie · Art Direction
Prompt
Ein einzelnes Illustrationsmotiv im redaktionellen Stil, das das Spektrum von realistisch bis flach durchläuft: eine einsame Figur am Rand einer Klippe, die auf ein bei Tagesanbruch in Schichten gestaffeltes Tal hinabblickt. Komposition: Das Motiv ist zentriert und im unteren Drittel des Bildes verankert, das Tal zieht sich in horizontalen Bändern nach oben und hinten bis zum fernen Horizont zurück, darüber bleibt reichlich Negativraum im Himmel für die Typografie. Stil: eine kohärente Illustrationssprache mit bewusst vereinfachten Abstufungen – an einem Ende fotorealistische Volumenwirkung und atmosphärischer Dunst, am anderen Ende hartkantige Vektorflächen ohne Verläufe. Licht: warmes, tief stehendes Sonnenlicht von links, weiche lange Schatten, kühles Umgebungslicht als Aufhellung im Tal. Farbpalette: entsättigtes Schieferblau mit warmen Ockerakzenten, begrenzt und zurückhaltend. Ausführung: klares, scharfes, direkt druckbares Bildwerk, saubere Silhouetten, kein Text und kein Wasserzeichen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
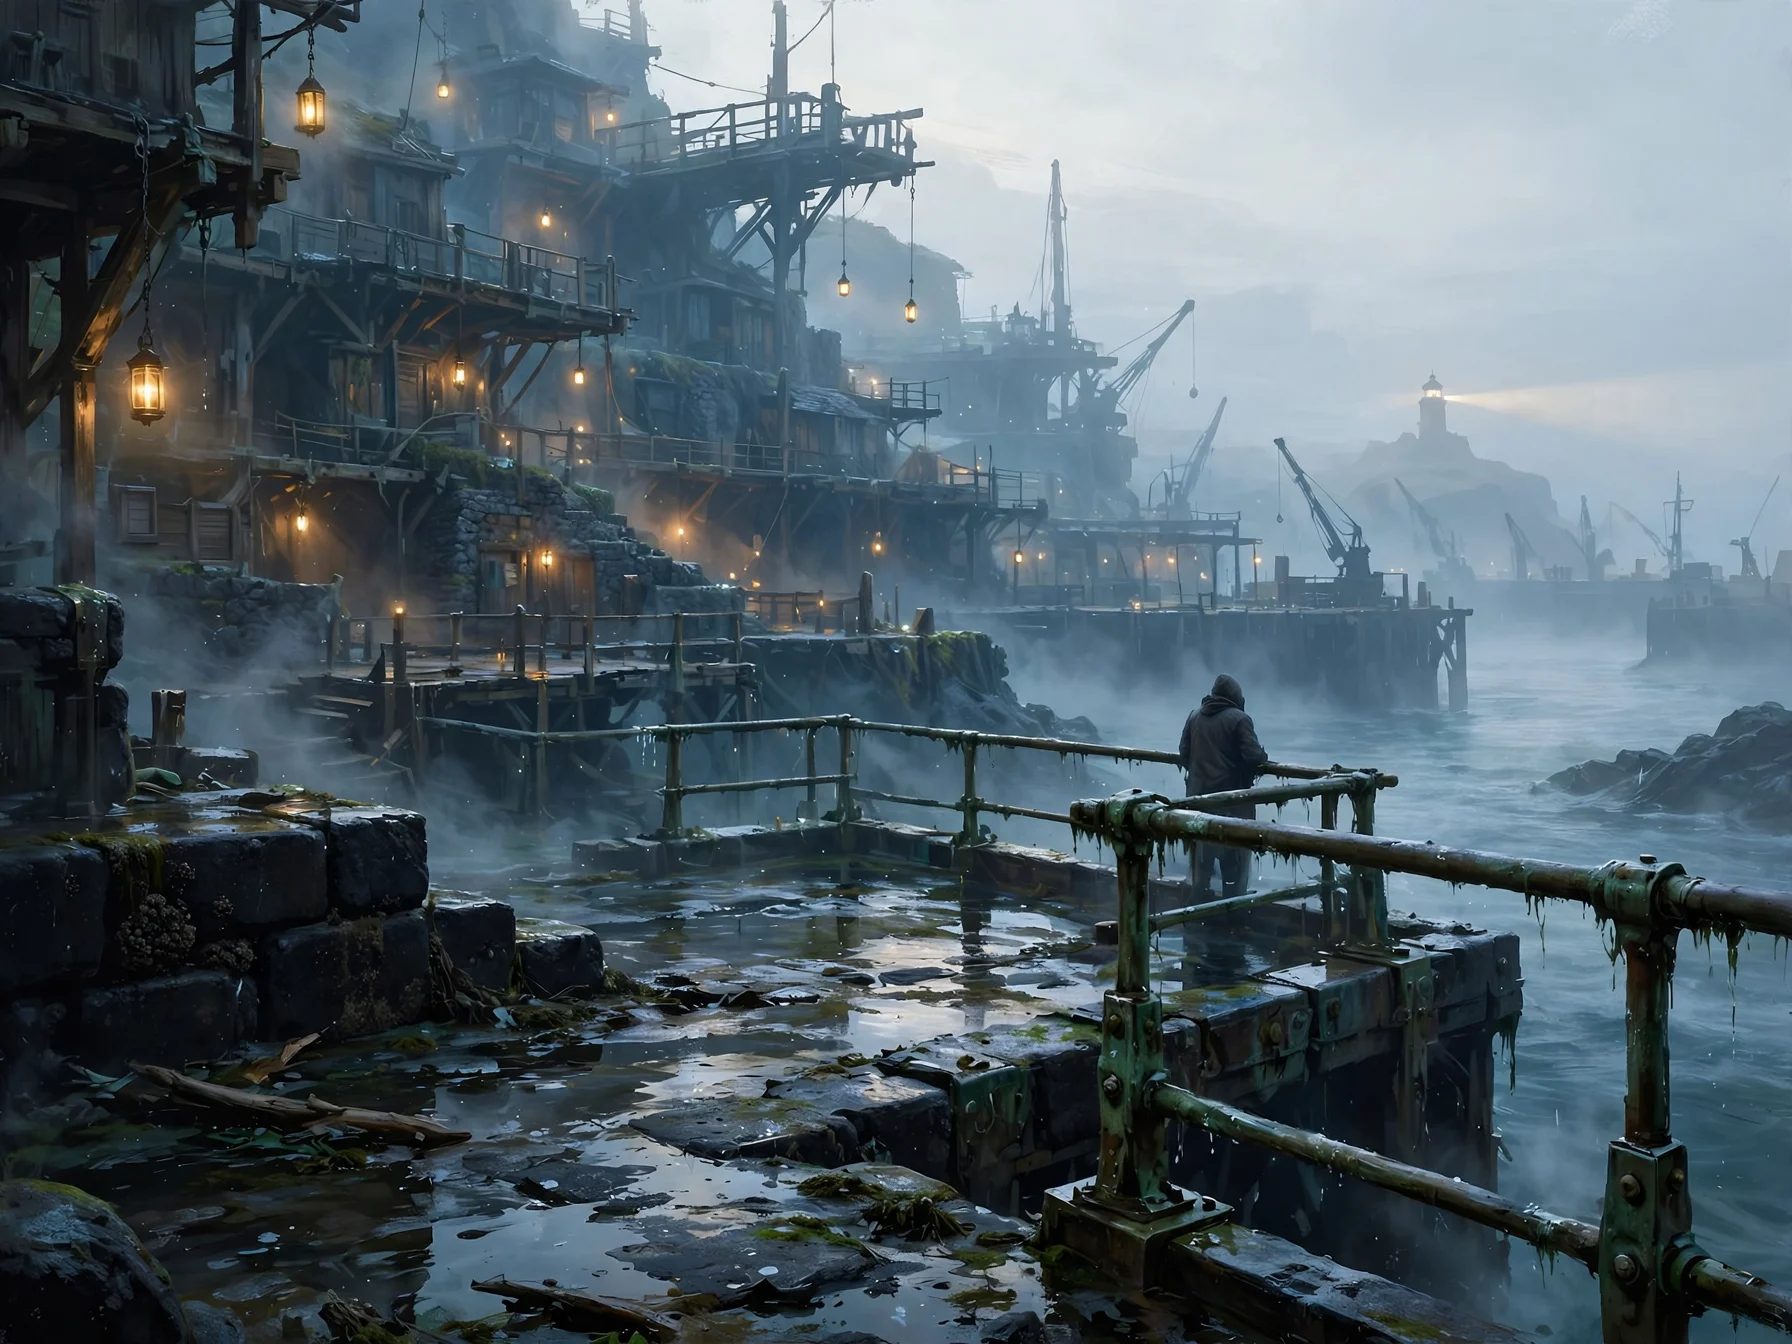
Konzeptbild der Weltanschauung: Nebelhaven-Gezeitenplattform
Stil Weltbau · Konzeptkunst · Atmosphäre
Prompt
Ein breitformatiges, filmisches Konzeptkunstbild, das einen nebelverhangenen Küstenhafen in einer fiktiven Welt darstellt, 21:9-Panoramakomposition. Vordergrund: eine vom Meerwind zerfressene Gezeitenbeobachtungsplattform aus dunklem Basalt und oxidiertem Messing, nach der Ebbe halb freiliegend, die feuchten Steinflächen spiegeln den fahlen Himmel. Mittelgrund: terrassenförmig an die Klippe gebaute Hafenarchitektur, hölzerne Stege, aufgehängte Laternen verbreiten warmes bernsteinfarbenes Licht im kaltblauen Nebel, eine einsame Gestalt in schwerem Mantel steht am Geländer der Plattform, um den Maßstab zu verdeutlichen. Hintergrund: die Hafeneinfahrt löst sich in den Nebelschichten auf, silhouetteartige Kräne und der Lichtstrahl eines fernen Leuchtturms streichen langsam vorbei. Atmosphäre: dichter Meernebel, verwehte Gischt, kontrastarme Tiefenschärfeabnahme. Beleuchtung: kühles, trübes Morgengrauen, nur eine einzige warme praktische Lichtquelle von den Laternen, weiches volumetrisches Licht. Stil: malerische digitale Konzeptkunst, zurückhaltende Farbpalette – Schieferblau, oxidiertes Blaugrün und gedämpftes Bernstein, feine Materialdetails an Stein und Metall, kein Text, keine Logos.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
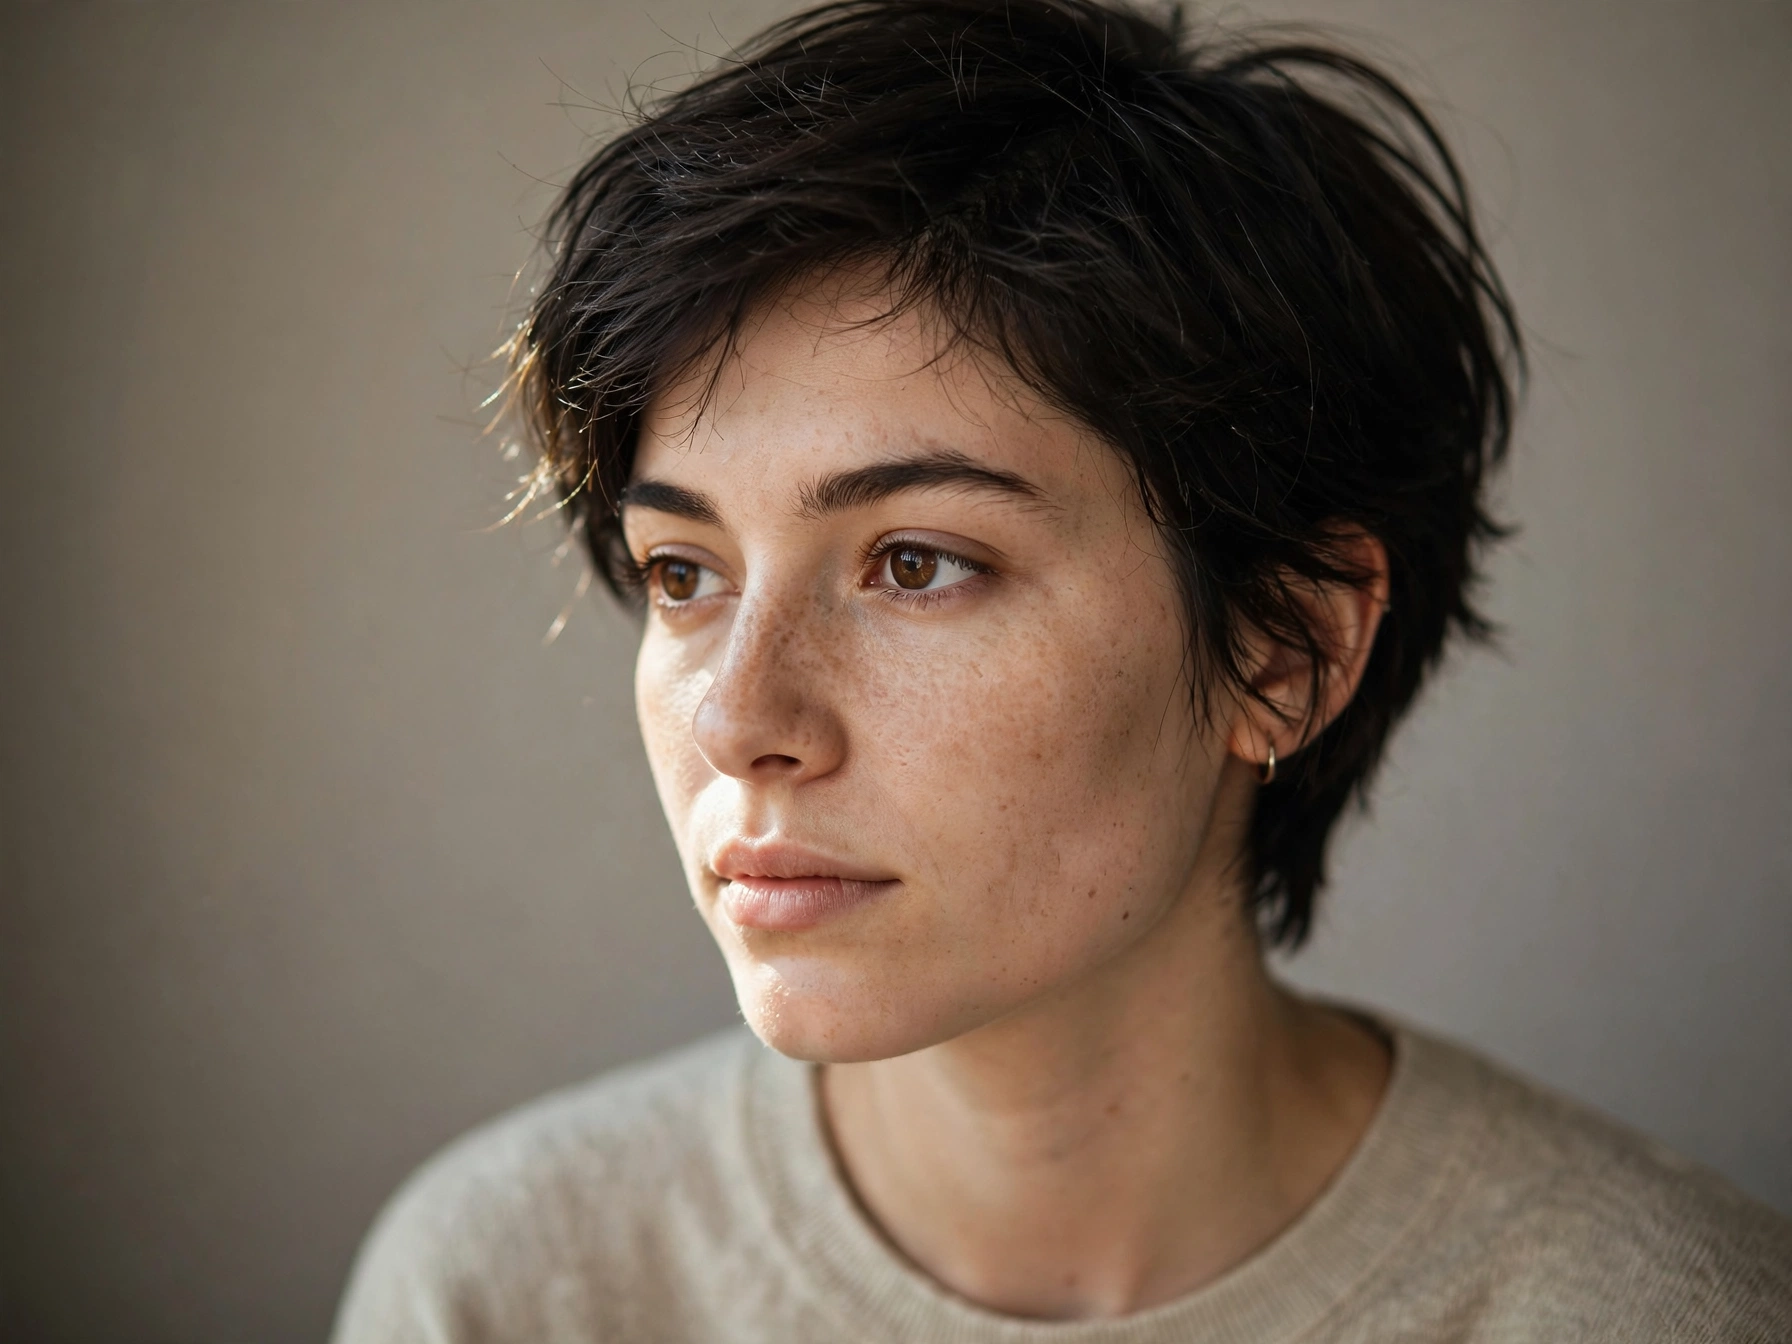
Muse Image Porträtstil-Referenz: Zwei Prompt-Pfade – realistisch und künstlerisch
Stil Porträt und Fotografie · Fotorealistisch · Bearbeitung
Prompt
Ein vertikales Studio-Porträt im Format 3:4 mit einer jungen Frau, Sommersprossen im Gesicht, kurzem dunklem Haar, entspannten Schultern und einem direkten, leicht am Objektiv vorbeigehenden Blick. Ein weiches, großflächiges Hauptlicht von der linken Kameraseite erzeugt ein subtiles Kantenlicht im Haar und läuft sanft in einen warmen grauen, nahtlosen Hintergrund aus. Aufgenommen mit einem 85-mm-Objektiv bei Blende f/2.0, geringe Schärfentiefe, realistische Hauttextur mit sichtbaren Poren und feinen Härchen, zurückhaltende Farbabstimmung, keine Spuren von Retusche. Insgesamt eine redaktionelle Fotografie-Ästhetik, ruhige und gefasste Stimmung, detailreiches Gesicht, bewusst schlicht gehaltener Hintergrund, damit die Aufmerksamkeit stets auf dem Motiv bleibt.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
muse-image-1.0/text-to-image per task
| Einzelpreis | $0.015 |
|---|
Positionierung und Kurzprofil
muse-image-1.0/text-to-image ist der reine Text-zu-Bild-Pfad des von Meta entwickelten Text-zu-Bild-Modells auf HiAPI.ai und folgt einem Generierungsablauf, der erst schlussfolgert und dann rendert: Vor der Bildausgabe werden mehrteilige Prompts zerlegt, das Bildlayout geplant und während des Inferenzprozesses Selbstkorrekturen vorgenommen. Es eignet sich für Entwickler, die hochparallele Batch-Bildgenerierung mit komplexen Prompts benötigen, etwa für Werbemittelvarianten oder Produktkatalogbilder. Über die einheitliche Schnittstelle von HiAPI.ai reicht ein reiner Text-Prompt zur Bilderzeugung, Seitenverhältnis und Ausgabeformat sind wählbar.
Kernhighlights
- Erst schlussfolgern, dann rendern – komplexe Prompts besser kontrollierbar – vor dem Rendern werden mehrteilige Prompts in der Inferenzkette zerlegt, das Layout geplant und die Ausgabe iterativ korrigiert; für strukturierte Beschreibungen besser geeignet als eine einmalige Vorwärtsgenerierung.
- Wissensintensive Prompts mit Web-Recherche – bei Prompts, die reale Weltinformationen erfordern, wird eine Websuche zur Kalibrierung der Inhalte aufgerufen, wodurch faktische Bildfehler reduziert werden.
- Fertiges Bild in einem einzigen Aufruf, einfache Integration – es genügt ein Text-Prompt, zusätzlich lassen sich Seitenverhältnis sowie die Ausgabeformate jpeg, png und webp festlegen, und man erhält direkt einsatzbereite Bildassets.
Funktionsbeschreibung
Schlussfolgernde Text-zu-Bild-Generierung: Mehrteilige, komplexe Prompts werden in ausführbare Bildelemente zerlegt, vor dem Rendern wird das Layout geplant und selbst korrigiert, was den Aufwand für wiederholtes Prompt-Tuning senkt.
Voreingestellte Seitenverhältnisse: Neun Formate stehen bereit – 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3, 21:9 und 9:21 –, die je nach Platzierung oder Layout direkt gewählt werden können, ohne spätere Beschnittbearbeitung.
Ausgabe in mehreren Formaten: Drei Downloadformate – jpeg, png und webp – werden unterstützt, Standard ist webp, passend für Frontend-Anzeige, Archivierung oder nachgelagerte Verarbeitungsprozesse.
Unterstützung langer Prompts: Das Prompt-Limit liegt bei 5000 Zeichen und bietet Raum für mehrteilige, komplexe Generierungsanforderungen mit einschränkenden Beschreibungen.
Anwendungsszenarien
- Kampagnenteams erzeugen Werbemittelvarianten im Batch – mit mehreren Prompt-Sets zum selben Verkaufsargument werden Bilder im Batch erzeugt und Materialien in verschiedenen Seitenverhältnissen produziert, die direkt für Multichannel-Werbetests genutzt werden.
- E-Commerce-Betrieb erstellt Produktszenenbilder – aus Produktbeschreibungstexten werden Szenenbilder in unterschiedlichen Stilen und Kompositionen erzeugt, um Produktkataloge und Detailseiten zu bebildern.
- Content-Teams bebildern wissensbezogene Themen – thematische Beschreibungen mit Faktenbestandteilen werden eingegeben und inhaltlich passende Bilder erzeugt, die in Artikeln, Posts und sozialen Medien eingesetzt werden.
Einschränkungen und Auswahlhinweise
Öffentlich verfügbare Informationen geben die Ausgaberesolution dieses Pfads nicht an; das Seitenverhältnis bestimmt nur die Proportion, nicht die genaue Pixelgröße. Bei Szenarien mit festen Anforderungen an die Auflösung ist dies vorab zu verifizieren. Der schlussfolgernde Ablauf und die bedarfsweise Websuche verursachen zusätzliche Latenz und eignen sich nicht für Echtzeitgenerierung mit extrem niedriger Latenz. Die Ausgabe beschränkt sich auf Bilder, es gibt keine Video- oder Audiofunktion. Wenn Aufgaben auf Basis von Referenzbildern fusioniert oder umgeschrieben werden sollen, ist der bildbasierte Pfad (image-to-image) derselben Familie zu wählen.
Häufige Fragen
Alle Fragen ansehen →-
Wie wählt man zwischen Text-zu-Bild und Bildbearbeitung?
Wenn nur Text vorliegt und man von Null anfängt, wählt man Text-zu-Bild; wenn ein vorhandenes Motiv oder Layout beibehalten werden soll, wählt man die Bildbearbeitung und stellt ein Referenzbild bereit.
-
Wie viele Bilder erhalte ich pro Vorgang?
Jeder Auftrag liefert ein Bild; es gibt keine Auswahl der Bildanzahl. Wenn Sie eine andere Bildkomposition vergleichen möchten, passen Sie den Prompt an und reichen Sie einen neuen Auftrag ein.
-
Kann man 1K, 2K oder 4K wählen?
Dieser Einstiegspunkt bietet keine Auflösungsstufen. Das Bildformat wählst du, die Pixelabmessungen bestimmen das Modell, üblicherweise etwa 2,5 MP; maßgeblich sind die tatsächlichen Abmessungen der heruntergeladenen Datei.
-
Welche Dateiformate kann ich auswählen?
Sie können JPEG, PNG oder WebP auswählen; wenn keine Auswahl getroffen wird, wird WebP verwendet. Wählen Sie das Format je nach Bedarf für spätere Webbenutzeroberflächen-Assets oder Design-Tools.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: muse-image-1.0/text-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für muse-image-1.0/text-to-image und Route default — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 5000Beschreibt das gewünschte Bild oder legt fest, welche Inhalte im Referenzbild geändert bzw. beibehalten werden sollen; als Zeichenkette.
aspect_ratiostringOptionalWählt das Seitenverhältnis des Ausgabebildes; als Zeichenkette. Dies legt keine exakten Pixelmaße fest.
1:14:33:416:99:163:22:321:9Alle anzeigen (1)
9:21output_formatstringOptionalStandard: "webp"Wählt das Dateiformat zum Herunterladen des Bildes; als Zeichenkette, Standard ist webp.
jpegpngwebpcallbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/text-to-image",
  "input": {
    "prompt": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/text-to-image",
input: {
"prompt": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/text-to-image",
"input": {
"prompt": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Krea 2 Medium Turbo Krea $0.021 /Bild
-
 BRIA Eraser Bria $0.058 /Bild
-
 Ideogram V4.5 Ideogram $0.011 /Bild
-
 BRIA Product Shot Bria $0.058 /Bild
-
 FASHN Tryon v1.6 FASHN $0.107 /Bild
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /Bild
-
 FLUX.1 Schnell Black Forest Labs $0.005 /Bild
-
 Google Virtual Try-On Google $0.107 /Bild
-
 Grok Imagine Quality xAI $0.070 /Bild
-
 Imagen 4 Google $0.030 /Bild
-
 FLUX 3 Image Black Forest Labs $0.041 /Bild
-
 Krea 3 Krea $0.036 /Bild
