
Руководство
Практическое применение gemini-4-argon: 5 сценариев использования текстовой модели с высокой ценностью и ключевые моменты реализации
От выбора модели до интеграции: 5 сценариев применения текстовой модели в реальном бизнесе
На этой странице
Почему для внедрения в бизнес выбирают текстовую модель
Прежде чем перейти к конкретным сценариям, ответим на более фундаментальный вопрос: какие задачи следует поручать такой модели? gemini-4-argon вызывается через интерфейс, совместимый с Chat Completions, поддерживает ввод текста и изображений, выдаёт текст и тарифицируется по токенам — сама эта позиция очерчивает границы её возможностей.
Задачи, которые подходят текстовой модели
Критерий только один: является ли конечный результат задачи фрагментом текста или структурированными данными, переданными в виде текста. Типичные примеры: извлечение полей из свободного текста, массовая генерация или переписывание текстов, суммирование и объединение длинных документов, разметка запросов для маршрутизации, а также организация естественно-языкового ответа в диалоге. Общее у этих задач то, что вход — текст (при необходимости с изображением), выход — текст; не нужно генерировать аудио или видео, не нужно выполнять детерминированные вычисления; модель лишь отображает семантику входа в ожидаемый текстовый выход.
Задачи, которые не подходят текстовой модели
Наоборот, в следующих случаях следует решительно перейти на модели другого типа или вообще обойтись без модели: нужен ввод аудио или видео, нужен вывод речи или видео, нужны точные численные вычисления или логические рассуждения, а также любые сценарии, требующие 100% детерминированности (например, расчёты сумм, определение прав доступа). Если насильно втискивать такие задачи в текстовую модель, вы лишь привнесёте неопределённость в изначально контролируемую цепочку.
Как способ тарификации влияет на инженерные решения
gemini-4-argon тарифицируется по токенам, и это ограничение передаётся вверх по цепочке вплоть до архитектурных решений. Это значит, что основная переменная затрат — длина ввода, а не количество вызовов. Поэтому на этапе выбора модели нужно выработать две привычки: во-первых, считать «насколько можно сократить ввод» таким же важным проектным целевым показателем, как и «точность вывода»; во-вторых, для каждого сценария отдельно оценивать масштаб ввода-вывода одного запроса, а не составлять бюджет по количеству вызовов на глазок.
В одной серии есть три модели, различающиеся по сложности задач и затратам: gemini-4-carbon — самая мощная модель серии Gemini 4, ориентированная на самые сложные многошаговые и долгосрочные задачи; gemini-4-argon подходит для большинства задач программной инженерии и интеллектуальной работы, обеспечивая баланс возможностей и стоимости; gemini-3.8-flash — быстрая и дешёвая, подходит для задач с высокой конкурентностью и низкой задержкой.
Цены рассчитываются по трём составляющим — ввод / кэшированный ввод / вывод — в долларах за миллион токенов. У каждой модели есть два канала: стандартный (имя модели без суффикса) и канал Vertex (имя модели с @vertex), с разными ценами:
gemini-4-carbon: стандартный канал 1.00 / 0.05 / 5.00; канал@vertex1.64 / 0.09 / 8.20.gemini-4-argon: стандартный канал 1.00 / 0.05 / 5.00; канал@vertex1.64 / 0.09 / 8.20.gemini-3.8-flash: стандартный канал 0.19 / 0.02 / 0.92; канал@vertex0.62 / 0.07 / 3.08.
Только с учётом этой границы обретают смысл следующие 5 сценариев — все они в рамках «ввод текста (возможно, с изображением), вывод текста» представляют собой конкретные способы применить одну и ту же модель в разных бизнес-областях за счёт различного проектирования структуры ввода-вывода.
Сценарий первый: из неструктурированного текста в структурированные данные
Это сценарий, в котором текстовая модель приносит наибольшую отдачу и чаще всего даёт сбои. Заявки, письма, отзывы пользователей, фрагменты договоров — всё это свободный текст, а нижестоящим системам нужны фиксированные поля. Модель отвечает за отображение семантики в поля, инженерия — за то, чтобы этот процесс был стабильным и проверяемым.
Дизайн ввода-вывода
На стороне ввода помимо исходного текста нужно передавать в prompt само определение полей. Определение полей должно содержать три элемента: имя поля, тип, диапазон значений или перечисление. Не стоит рассчитывать, что модель «угадает» желаемую структуру, — контракт полей должен быть явно прописан.
На стороне вывода в prompt требуется, чтобы модель возвращала только один JSON-объект, и приводится полный пример. Пример эффективнее любых прилагательных — он одновременно фиксирует написание имён ключей, уровни вложенности и способ представления пустых значений. Следует пояснить: данный интерфейс не предоставляет параметр структурированного вывода (JSON-режим), легальность JSON полностью зависит от ограничений prompt и нижестоящей валидации — поэтому ниже и предусмотрена валидация с откатом.
Ограничения формата и откат при валидации
Как бы хорошо ни был написан prompt, всегда нужно исходить из того, что модель иногда вернёт невалидный JSON или пропущенные поля. В инженерии нужно подготовить три уровня защиты:
- Уровень разбора: строгий JSON-парсинг; при ошибке — переход в ветку повторной попытки, а не попытка исправить регулярными выражениями.
- Проверка схемы: с помощью JSON Schema или эквивалентной структурной проверки проверяются типы и обязательные поля; значение перечисления вне диапазона считается ошибкой.
- Бизнес-подстраховка: при неудачной валидации запись помечается как «требует ручной обработки» и сохраняется в базу, а не пропускает пустые поля в нижестоящую систему.
Стратегия повторных попыток
При повторной попытке не отправляйте запрос как есть. Вставьте в prompt информацию об ошибке валидации, например «значение high поля priority не входит в допустимое перечисление, выберите из low/medium/high», — это заметно повышает вероятность успеха со второй попытки. Одновременно задайте верхний предел числа повторных попыток; при превышении — передача человеку, чтобы не тратить токены впустую на одну запись.
Сценарий второй: массовая генерация и переписывание контента
Маркетинговые тексты, описания товаров, шаблоны писем — такие задачи характеризуются высокой конкурентностью, низкой ценностью одной единицы и высокими требованиями к единообразию стиля. Основное противоречие здесь: нужно и массово, и так, чтобы не выглядело массово сгенерированным.
Шаблонный prompt — источник единообразия стиля
Разбейте prompt на две части: «фиксированный шаблон + слоты переменных». В фиксированном шаблоне пропишите роль, тон, диапазон длины, запрещённые слова и формат вывода; в слоты переменных кладите только конкретный материал для генерации — например, название товара, преимущества, целевую аудиторию. Ценность такого подхода в том, что стилевые ограничения пишутся один раз и переиспользуются бесконечно, а при необходимости скорректировать стиль меняется одно место, и не нужно бояться, что отдельные prompt'ы «уплывут».
Контроль длины одного ввода
Тарификация по токенам означает, что в массовых сценариях стоимость почти полностью определяется вводом. Три непосредственно эффективных приёма:
- В слоты переменных кладите только необходимую информацию. В описание товара не нужно втискивать всю карточку товара — достаточно выбрать три-пять ключевых атрибутов.
- Оставляйте только один пример. Примеры few-shot помогают стилю, но каждый дополнительный пример — это дополнительный фиксированный расход на ввод; по умолчанию одного достаточно.
- Не повторяйте в prompt информацию, уже известную системе. Ограничения, жёстко прописанные в шаблоне, не нужно повторять в каждой переменной.
Этап проверки единообразия
После массовой генерации добавьте лёгкую проверку: проверка вывода по правилам (входит ли длина в диапазон, нет ли запрещённых слов, содержится ли обязательная информация); не прошедшие записи попадают в очередь повторной генерации. Эта проверка не расходует квоту модели, но отсекает большинство явно неудачных результатов — самый экономически выгодный метод контроля качества в массовых сценариях.
Сценарий третий: суммирование длинных текстов и объединение нескольких документов
Длинный ввод — «чёрная дыра» затрат в этом сценарии. Для одного и того же материала при разной стратегии разбиения расход токенов может отличаться в несколько раз, и точность передачи информации тоже заметно различается.
Сначала определите, можно ли обойтись без разбиения
Если длина оригинала укладывается в приемлемый для одного запроса диапазон, прямая суммаризация всего текста часто даёт лучший результат, чем разбиение с последующим объединением, потому что модель видит полный контекст. Разбиение вводите только тогда, когда текст действительно превышает возможности однократной обработки. Это решение должно явно приниматься в коде, а не всегда идти по пути разбиения. Верхний предел контекста данного интерфейса — 1 048 576 токенов; в большинстве случаев один материал можно отправить целиком.
Стратегия разбиения определяет стоимость и точность
Когда разбиение необходимо, соблюдайте два принципа:
- Режьте по смысловым границам, а не по числу символов. Предпочтительно разрывать на абзацах, заголовках, главах; не разрывайте предложение посередине — потеря информации на месте разрыва часто не восстанавливается на этапе объединения.
- Сохраняйте небольшое перекрытие между блоками. Небольшой перекрывающийся фрагмент между соседними блоками смягчает проблемы межблочных отсылок и обрезанных выводов; цена — небольшое дублирование токенов, и обычно оно того стоит.
Иерархический дизайн объединённой суммаризации
Не склеивайте суммаризации блоков в один плоский список, а делайте иерархическое объединение: сначала создайте суммаризацию каждого блока, затем объедините суммаризации блоков в порядке исходного документа в промежуточный уровень, и наконец создайте общую суммаризацию. Иерархия не должна быть слишком глубокой — двух-трёх уровней достаточно; каждый дополнительный уровень — это ещё один раунд расхода токенов и ещё одна потеря деталей при сжатии информации.
Особенности объединения нескольких документов
В сценарии с несколькими документами помимо суммаризации обычно нужна и такая сравнительная информация, как «сходства/различия». Подход: в prompt объединения явно требуйте организовывать вывод по темам, а не по документам — если пересказывать документ за документом, результат превратится в набор несвязанных абзацев и потеряет смысл объединения.
Сценарий четвёртый: классификация текста и маршрутизация запросов
Во многих системах наиболее подходящая роль текстовой модели — не генерация контента, а «семантический маршрутизатор»: определить, к какому классу относится запрос, и передать его в специализированный нижестоящий процесс.
Фиксированный набор меток — предпосылка стабильности
Пространство вывода задачи классификации должно быть замкнутым, заранее определённым набором меток. Не используйте открытые вопросы («к какому типу это относится?»), а включайте в prompt кандидатные метки вместе с определением каждой метки в одно предложение и требуйте от модели выводить только саму метку. Открытые вопросы порождают бесконечные самодельные метки, которые нижестоящая система просто не сможет маршрутизировать.
Одновременно зарезервируйте метку unknown. В реальном трафике всегда есть запросы за пределами набора меток; дать модели выход «не могу классифицировать» управляемее, чем заставлять её насильно выбирать ближайшую метку.
Выбор уровня интенсивности рассуждений
Классификация — одна из текстовых задач с наивысшими требованиями к детерминированности. Управляйте интенсивностью рассуждений через reasoning_effort (доступны low / medium / high); конкретный уровень следует выбирать по результатам оценки на реальной задаче, не стоит по умолчанию применять какой-то один; одновременно в prompt требуйте «выводить только имя метки, без объяснений». После вывода выполните проверку по белому списку: результаты вне набора меток сразу относите к unknown или передавайте человеку.
Нижестоящий контракт после маршрутизации
Классификация решает только вопрос «куда», а сама маршрутизация должна быть чётко определена: запросы с низкой уверенностью или unknown идут в канал по умолчанию или в очередь для людей; как нижестоящий сервис, получив метку, собирает параметры. Пропишите это в контракте интерфейса, а не разбрасывайте по бизнес-коду — тогда при добавлении меток или изменении правил маршрутизации зона изменений будет гораздо меньше.
Сценарий пятый: диалоговые ответы на вопросы для пользователей
Это единственный сценарий, напрямую обращённый к конечным пользователям, и поэтому наименее терпимый к сбоям. Пользователям не важно, что модель не уверена, — они запомнят один ответ невпопад.
Организация контекста
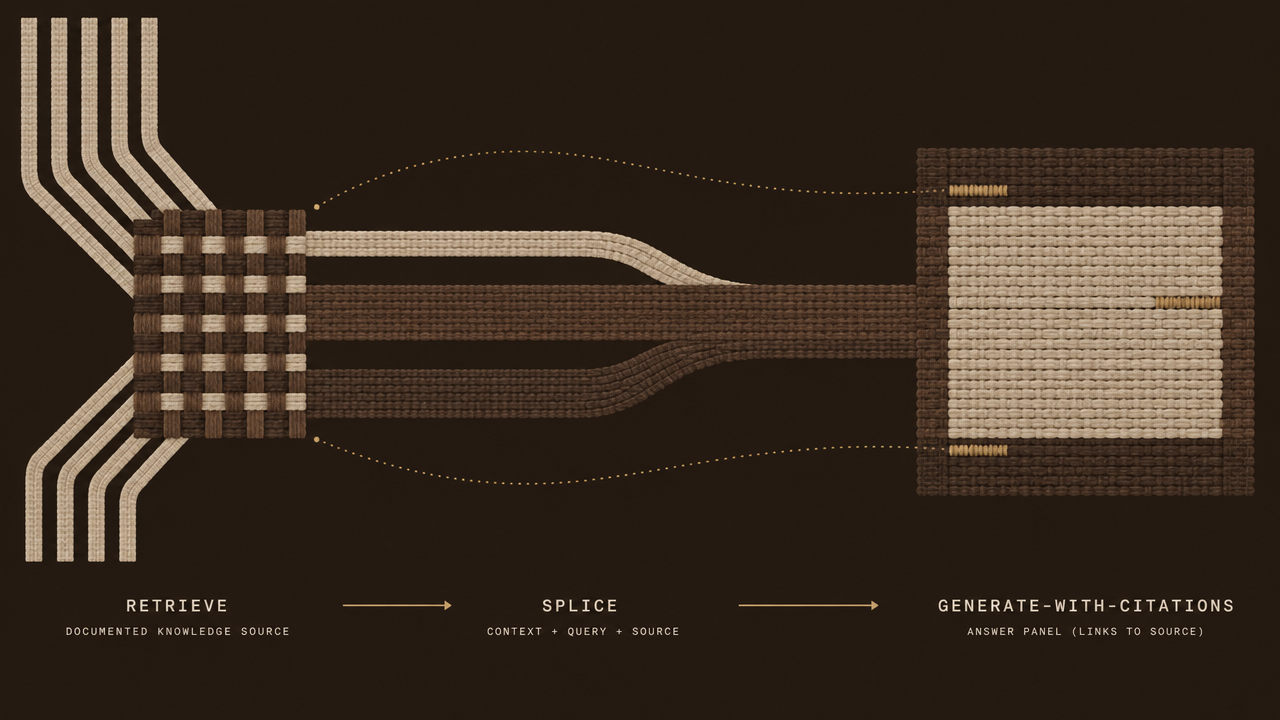
Ввод в диалоговом сценарии обычно состоит из трёх частей: системные инструкции, найденные или предустановленные фрагменты знаний и вопрос пользователя в текущем раунде. В инженерии нужно соблюдать две линии: во-первых, кладите только фрагменты знаний, относящиеся к текущему вопросу; нерелевантное содержимое не только тратит токены, но и мешает ответу; во-вторых, сохраняйте ограниченное число раундов истории диалога — чем больше раундов, тем длиннее ввод, и после превышения необходимой длины отдача быстро падает. Кроме того, данный интерфейс не предоставляет поиск в интернете; все материалы нужно находить на стороне бизнеса и добавлять в запрос.
Ограничение области ответа
В системных инструкциях явно пропишите: отвечать только на основе предоставленных материалов, не выдумывать информацию, которой нет в материалах; при невозможности ответить использовать фиксированную фразу-подстраховку. Фраза-подстраховка должна быть заранее написана и протестирована, а не импровизирована моделью — импровизированный отказ часто бывает и многословным, и неуправляемым.
Подстраховка и передача человеку
Даже если модель считает, что уверена, нужно предусмотреть выход для «не могу ответить». Распространённый подход: когда модель в ответе явно отмечает недостаточность оснований, фронтенд показывает переход к человеку; при нескольких раундах подряд без решения проблемы — проактивно вызывать передачу человеку. Завершайте неопределённость на стороне системы, а не показывайте её пользователю.
Взгляд с точки зрения затрат
Диалог — сценарий с самым быстрым накоплением расхода токенов, потому что каждый раунд тащит за собой историю. Средства контроля: суммаризация-сжатие истории или сохранение только последних нескольких раундов, а также своевременная очистка контекста при простое сессии. Это совместное решение продукта и инженерии, правила нужно определить ещё на этапе проектирования.
Ключевые моменты интеграции: стоимость токенов, задержка и повторные попытки
Соберём общие инженерные вопросы пяти сценариев в чек-лист, который можно сразу применять. Сначала уточним форму интерфейса:
- Способ вызова: интерфейс, совместимый с Chat Completions,
POST https://api.hiapi.ai/v1/chat/completions, base_url —https://api.hiapi.ai/v1, поддерживается потоковый вывод. - Каналы: у каждой модели есть стандартный канал (имя модели без суффикса) и канал Vertex (имя модели с
@vertex, напримерgemini-4-carbon@vertex); цены каналов различаются, выбирайте по потребности. - Ввод-вывод: на входе — текст и изображения, на выходе — текст; контекст 1 048 576 токенов, максимальный вывод за один раз 65 536 токенов.
- Интенсивность рассуждений: управляется через
reasoning_effort, доступныlow/medium/high. - Границы возможностей: не поддерживаются вызов инструментов / function calling, поиск в интернете, computer use, структурированный вывод / JSON-режим; это нужно реализовывать на стороне бизнеса через ограничения prompt и собственные цепочки.
Метод оценки затрат
Для модели с тарификацией по токенам оценка затрат должна опираться на число токенов ввода-вывода одного запроса, умноженное на объём бизнеса и цену соответствующего канала. Конкретный подход: для каждого сценария подготовьте три репрезентативных образца (короткий, средний, длинный), измерьте масштаб ввода-вывода и возьмите взвешенное среднее как базовую стоимость одного запроса. Цены — по приведённому выше прайсу; у разных моделей и каналов различия заметны, при оценке считайте по фактически выбранной комбинации.
Приёмы сокращения ввода
- Удалите из prompt предложения, повторяющие одно и то же ограничение, — достаточно сказать один раз.
- Пример few-shot по умолчанию один; добавляйте при реальной необходимости, и каждое добавление подкрепляйте оценкой.
- Длинный текст сначала структурированно сокращайте (берите только релевантные разделы), затем суммируйте.
- В диалоговом сценарии сжимайте или обрезайте историю, не накапливайте без предела.
Тайм-ауты и повторные попытки
- Устанавливайте явный верхний предел тайм-аута для каждого вызова; по тайм-ауту — сбой, не ждите бесконечно.
- Повторные попытки — с экспоненциальной задержкой и верхним пределом общего числа попыток.
- При повторной попытке передавайте информацию о предыдущей ошибке (причина сбоя разбора, поля, не прошедшие валидацию), чтобы повысить вероятность успеха.
- Идемпотентность: повторный вызов по одной и той же бизнес-записи не должен давать повторных побочных эффектов.
Стратегия деградации
Для каждого сценария нужно ответить на вопрос «что делать, если модель недоступна». Структурированное извлечение может деградировать до очереди для людей, генерация контента — до предустановленных шаблонов, классификация — до канала по умолчанию, вопросы-ответы — до передачи человеку. Пути деградации должны быть реализованы и отработаны ещё на этапе разработки, а не собираться наспех во время сбоя.
Приёмка и итерации: как понять, что сценарий действительно заработал
Главная ловушка при интеграции модели — выход в продакшен, как только «демо выглядит неплохо». Приёмка должна отвечать на вопрос: приемлемо ли поведение сценария на реальном трафике и сможем ли мы вовремя заметить ухудшение.
Небольшой оценочный набор
Для каждого сценария создайте отдельный оценочный набор; масштаб не обязателен большой, но он должен покрывать два типа входов — типичные и граничные. В наборе для структурированного извлечения должны быть образцы с пропущенными полями, лишними полями, хаотичным форматом; в сценарии классификации — двусмысленные и совершенно нерелевантные образцы; в сценарии вопросов-ответов — вопросы, на которые в материалах нет ответа. Оценочный набор — это актив сценария; при каждом изменении prompt прогоняйте его.
Доля ручной выборочной проверки
Автоматические метрики покрывают только проверяемую часть (легальность JSON, легальность меток, ограничения длины), семантическое качество по-прежнему требует человека. Долю выборочной проверки определяйте по риску сценария: для пользовательских вопросов-ответов и внешней генерации контента она должна быть выше, для внутренней маршрутизации и внутренних суммаризаций — ниже. Результаты выборочной проверки должны возвращаться в оценочный набор — добавляйте найденные плохие примеры.
Метрики онлайн-мониторинга
Следите как минимум за четырьмя типами метрик: доля успешных вызовов и доля повторных попыток, доля сбоев разбора и валидации, среднее число токенов ввода-вывода на один запрос, а также частота срабатывания деградации и передачи человеку. Первые две отражают стабильность, третья — не вышли ли затраты из-под контроля, четвёртая — реальную доступность. Любая тенденциозная динамика должна запускать пересмотр prompt или процесса.
Ритм итераций
Одна и та же модель может переиспользоваться в нескольких сценариях, но prompt и оценочные наборы должны вестись отдельно по сценариям. Не пытайтесь одним набором prompt охватить весь бизнес — различия в структуре ввода между сценариями как раз и составляют ценность всей предыдущей проектной работы. Итерируйте каждый сценарий как самостоятельный маленький продукт: критерии приёмки прописаны, пути подстраховки отработаны — только тогда вы действительно прошли путь от «выбора модели» до «использования модели».
Похожие статьи
Все статьи →-

Руководство
Как вызывать kimi-k3.1-pro через API HiAPI: curl, Python и готовые к запуску запросы
Практическое руководство по интеграции: эндпоинт, параметры запроса, потоковая передача, вызовы инструментов и устранение ошибок
-

Руководство
ElevenLabs Music API на HiAPI: генерация музыки с помощью curl, Python и рецептов промптов
Практическое руководство по вызову elevenlabs/music-v2.5 через HiAPI с готовыми к копированию рецептами промптов для стиля, настроения и длительности
-

Руководство
Как использовать gpt-image-2.5-sunburst/image-to-image через HiAPI API: curl и Python
Готовые к запуску запросы для разработчиков, процесс загрузки референсных изображений и устранение ошибок