
Tutoriale
gemini-4-argon scenari applicativi reali: 5 utilizzi ad alto valore dei modelli testuali e punti di implementazione
Dalla selezione all'integrazione: 5 scenari per calare i modelli testuali in attività aziendali reali
In questa pagina
Perché scegliere un modello testuale per implementare casi d'uso aziendali
Prima di addentrarci negli scenari specifici, rispondiamo a una domanda più fondamentale: quali tipi di attività dovrebbero essere affidati a questo tipo di modello? gemini-4-argon viene invocato tramite un'interfaccia compatibile con Chat Completions, accetta input testuali e immagini, restituisce testo e viene fatturato a token; questa stessa collocazione definisce già chiaramente i confini delle sue capacità.
Attività adatte a un modello testuale
Il criterio di valutazione è uno solo: il prodotto finale dell'attività è un testo o un insieme di dati strutturati veicolati da testo. Rientrano tipicamente in questa categoria: l'estrazione di campi da testo libero, la generazione o riscrittura di contenuti in batch, il riassunto e la fusione di documenti lunghi, l'etichettatura delle richieste per il routing e l'organizzazione di risposte in linguaggio naturale all'interno di una conversazione. Il tratto comune di queste attività è che l'input è testo (eventualmente accompagnato da immagini), l'output è testo, non è necessario generare audio o video né eseguire calcoli deterministici; il modello deve solo mappare la semantica dell'input in un output testuale conforme alle aspettative.
Attività non adatte a un modello testuale
Al contrario, nei seguenti casi è opportuno passare risolutamente ad altri tipi di modello o non utilizzare affatto un modello: necessità di input audio o video, necessità di produrre voce o video, necessità di calcoli numerici precisi o ragionamenti logici, e qualsiasi scenario che richieda una certezza al 100% (come il regolamento di importi o la determinazione dei permessi). Forzare queste attività su un modello testuale non fa altro che introdurre incertezza in una catena altrimenti controllabile.
Come il modello di fatturazione influenza le decisioni ingegneristiche
gemini-4-argon viene fatturato a token, un vincolo che si ripercuote a monte sulla progettazione architetturale. Ciò significa che la variabile principale dei costi è la lunghezza dell'input, non il numero di chiamate. Pertanto, già in fase di selezione è necessario acquisire due abitudini: la prima è considerare "quanto posso accorciare l'input" un obiettivo di progettazione importante quanto "quanto è accurato l'output"; la seconda è stimare separatamente per ogni scenario la dimensione di input e output di una singola richiesta, invece di fare budget a naso in base al volume di chiamate.
La stessa serie comprende tre modelli, con un compromesso tra complessità del compito e costo: gemini-4-carbon è il modello più potente della serie Gemini 4, orientato ai compiti multi-step e a lungo ciclo più complessi; gemini-4-argon è adatto alla maggior parte dell'ingegneria del software e del knowledge work, con un equilibrio tra capacità e costo; gemini-3.8-flash è veloce ed economico, adatto a compiti ad alta concorrenza e bassa latenza.
Il prezzo è articolato in tre segmenti — input / input in cache / output — in dollari per milione di token. Ogni modello dispone di due canali, standard (nome del modello senza suffisso) e Vertex (nome del modello con @vertex), con prezzi unitari diversi:
gemini-4-carbon: canale standard 1,00 / 0,05 / 5,00; canale@vertex1,64 / 0,09 / 8,20.gemini-4-argon: canale standard 1,00 / 0,05 / 5,00; canale@vertex1,64 / 0,09 / 8,20.gemini-3.8-flash: canale standard 0,19 / 0,02 / 0,92; canale@vertex0,62 / 0,07 / 3,08.
Solo una volta chiarito questo confine i 5 scenari successivi acquistano senso: sono tutti, nell'ambito dello schema "input testuale (eventualmente con immagini), output testuale", modi concreti di calare lo stesso modello in diverse attività aziendali attraverso diverse progettazioni della struttura di input e output.
Scenario uno: da testo non strutturato a dati strutturati
È lo scenario in cui il modello testuale dà i risultati più rapidi, ma anche quello in cui è più facile fallire. Ticket, email, recensioni degli utenti, frammenti di contratti sono tutti testo libero, mentre i sistemi a valle richiedono campi fissi. Il modello si occupa di mappare la semantica sui campi, l'ingegneria di rendere questo processo stabile e verificabile.
Progettazione di input e output
Lato input, oltre al testo originale, è necessario passare come parte del prompt anche la definizione stessa dei campi. La definizione dei campi deve contenere tre elementi: nome del campo, tipo, intervallo di valori o enumerazione. Non aspettarti che il modello "indovini" la struttura desiderata: il contratto dei campi deve essere esplicitamente scritto.
Lato output, nel prompt si chiede al modello di restituire solo un oggetto JSON, fornendo un esempio completo. Un esempio è più efficace di qualsiasi aggettivo: vincola contemporaneamente l'ortografia dei nomi delle chiavi, i livelli di annidamento e la modalità di rappresentazione dei valori nulli. Va precisato che questa interfaccia non offre il parametro di output strutturato (modalità JSON): la validità del JSON dipende interamente dai vincoli del prompt e dalla validazione a valle, ed è questo il motivo per cui è necessario predisporre la validazione con fallback descritta di seguito.
Vincoli di formato e fallback di validazione
Per quanto ben scritto sia il prompt, bisogna sempre presupporre che il modello restituisca occasionalmente JSON non valido o campi mancanti. A livello ingegneristico occorre predisporre tre livelli di difesa:
- Livello di parsing: parsing JSON rigoroso; in caso di fallimento si passa al ramo di retry, senza tentare di riparare con espressioni regolari.
- Validazione dello schema: verificare tipi e campi obbligatori con JSON Schema o una validazione strutturale equivalente; i valori di enumerazione fuori intervallo sono considerati fallimenti.
- Fallback di business: in caso di validazione fallita, contrassegnare il record come "da gestire manualmente" e salvarlo, evitando che campi vuoti fluiscano a valle.
Strategia di retry
In caso di retry non inviare di nuovo lo stesso contenuto identico. Reinserire nel prompt le informazioni sull'errore di validazione, ad esempio "il valore high del campo priority non rientra nell'enumerazione consentita, scegliere tra low/medium/high", aumenta significativamente il tasso di successo al secondo tentativo. Allo stesso tempo, impostare un limite massimo al numero di retry: superato il limite, passare alla gestione manuale, evitando di consumare inutilmente token su un singolo dato.
Scenario due: generazione e riscrittura di contenuti in batch
Compiti come testi marketing, descrizioni di prodotti e modelli di email sono caratterizzati da alta concorrenza, basso valore per singolo elemento e forte esigenza di coerenza stilistica. Il conflitto centrale qui è: bisogna procedere in batch, ma il risultato non deve sembrare generato in batch.
Il prompt templatizzato è la fonte della coerenza stilistica
Suddividere il prompt in due parti: "template fisso + slot variabili". Nel template fisso scrivere ruolo, tono, intervallo di lunghezza, parole vietate e formato di output; negli slot variabili inserire solo i materiali concreti da generare questa volta, come nome del prodotto, punti di forza, pubblico di riferimento. Il valore di questo approccio è che i vincoli di stile vengono scritti una sola volta e riutilizzati infinite volte, e quando è necessario modificare lo stile si interviene in un solo punto, senza timore che i vari prompt divergano.
Controllare la lunghezza dell'input per singola chiamata
La fatturazione a token significa che in scenari batch il costo è quasi interamente determinato dall'input. Tre pratiche direttamente efficaci:
- Negli slot variabili inserire solo le informazioni necessarie. Nella descrizione del prodotto non serve inserire l'intera scheda del prodotto: bastano tre-cinque attributi chiave.
- Mantenere un solo esempio. Gli esempi few-shot aiutano lo stile, ma ogni esempio in più aggiunge un costo fisso di input; in genere uno è sufficiente.
- Non ripetere nel prompt informazioni già note al sistema. Non ripetere nei vari slot variabili i vincoli già fissati nel template.
Fase di verifica della coerenza
Dopo la generazione in batch, aggiungere un controllo leggero: applicare regole di validazione all'output (la lunghezza rientra nell'intervallo? compaiono parole vietate? sono presenti le informazioni obbligatorie?), e inserire le voci non conformi in una coda di rigenerazione. Questo controllo non consuma quota del modello, ma blocca la maggior parte dei risultati palesemente fuori strada: è il mezzo di controllo qualità più conveniente negli scenari batch.
Scenario tre: riassunto di testi lunghi e fusione di più documenti
L'input lungo è il buco nero dei costi in questo scenario. Con lo stesso materiale, strategie di suddivisione diverse possono far variare il consumo di token di più volte, con una differenza evidente anche nella fedeltà dell'informazione.
Prima valutare se si può evitare la suddivisione in blocchi
Se la lunghezza del testo originale rientra nell'intervallo accettabile per una singola richiesta, il riassunto dell'intero testo tende a dare risultati migliori rispetto alla suddivisione con successiva fusione, perché il modello vede il contesto completo. Solo quando si supera effettivamente la capacità di elaborazione di una singola chiamata si introduce la suddivisione in blocchi. Questa valutazione va fatta esplicitamente nel codice, non applicando sempre il flusso di suddivisione. Il limite di contesto di questa interfaccia è di 1.048.576 token; nella maggior parte dei casi un singolo materiale può essere inviato integralmente.
La strategia di suddivisione determina costo e fedeltà
Quando è necessario suddividere, rispettare due principi:
- Suddividere secondo i confini semantici, non tagliando a numero fisso di caratteri. Privilegiare le interruzioni a paragrafi, titoli, capitoli, evitando di spezzare una frase a metà: la perdita di informazione nel punto di taglio spesso non è recuperabile in fase di fusione.
- Mantenere una piccola sovrapposizione tra i blocchi. Lasciare un breve testo sovrapposto tra blocchi adiacenti attenua i problemi di riferimento anaforico tra blocchi e di conclusioni troncate, al costo di pochi token duplicati, generalmente ne vale la pena.
Progettazione gerarchica del riassunto di fusione
Per i riassunti dei blocchi, non concatenarli in modo piatto in un'unica soluzione, ma effettuare una fusione gerarchica: prima generare un riassunto per ogni blocco, poi combinare i riassunti dei blocchi nell'ordine del documento originale in un livello intermedio, infine generare il riassunto complessivo. La gerarchia non deve essere troppo profonda: due o tre livelli sono sufficienti; ogni livello in più comporta un ulteriore consumo di token e una perdita di dettaglio nella compressione dell'informazione.
Trattamento speciale per la fusione di più documenti
Negli scenari multi-documento, oltre al riassunto, spesso servono anche informazioni comparative come "punti in comune / differenze". L'approccio è richiedere esplicitamente nel prompt di fusione di organizzare l'output per tema anziché per documento: se si riporta documento per documento il risultato diventa una serie di paragrafi tra loro scollegati, perdendo il senso della fusione.
Scenario quattro: classificazione testuale e routing delle richieste
In molti sistemi il ruolo più adatto per un modello testuale non è generare contenuti, ma fungere da "router semantico": determinare a quale categoria appartiene questa richiesta e affidarla al processo dedicato a valle.
Un set di etichette fisso è il presupposto della stabilità
Lo spazio di output di un'attività di classificazione deve essere un set di etichette chiuso e predefinito. Non usare domande aperte ("Di che tipo si tratta?"), ma scrivere nel prompt le etichette candidate insieme a una definizione di una frase per ciascuna, chiedendo al modello di restituire solo l'etichetta. Le domande aperte generano infinite etichette create autonomamente, che il sistema a valle non può instradare.
Allo stesso tempo occorre prevedere un'etichetta unknown. Nel traffico reale ci saranno sempre richieste al di fuori del set di etichette; dare al modello una via d'uscita "non classificabile" è più controllabile che forzarlo a scegliere l'etichetta più vicina.
Scelta del livello di intensità di ragionamento
La classificazione è una delle attività testuali con la massima esigenza di determinismo. Usare reasoning_effort per controllare l'intensità di ragionamento (opzioni low / medium / high); il livello specifico va scelto in base alla valutazione dell'attività reale, non conviene applicare un livello predefinito; contemporaneamente nel prompt richiedere "restituire solo il nome dell'etichetta, senza spiegazioni". Dopo l'output effettuare una validazione whitelist: i risultati non presenti nel set di etichette vengono ricondotti a unknown o passati alla gestione manuale.
Contratto a valle dopo il routing
La classificazione risolve solo il problema del "dove andare"; il routing stesso deve anche essere definito chiaramente: le richieste a bassa confidenza o unknown vanno al canale predefinito o alla coda manuale; come i servizi a valle assemblano i parametri dopo aver ricevuto l'etichetta. Scrivere tutto questo nel contratto dell'interfaccia, anziché sparpagliarlo nel codice di business, riduce di molto l'area di intervento quando in seguito si aggiungono etichette o si modificano le regole di routing.
Scenario cinque: domande e risposte conversazionali rivolte all'utente
È l'unico scenario che si rivolge direttamente all'utente finale e, proprio per questo, è il meno tollerante agli errori. All'utente non importa dell'incertezza del modello: ricorderà solo quella volta in cui la risposta era fuori luogo.
Come organizzare il contesto
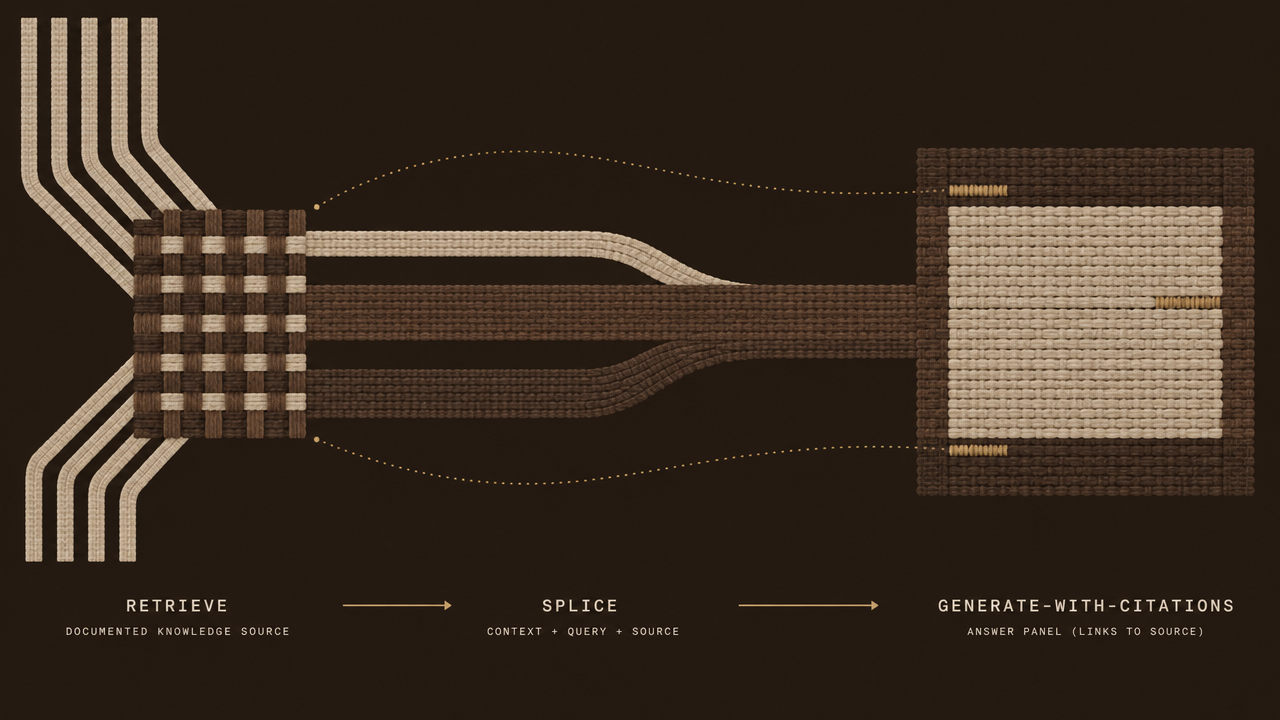
L'input di uno scenario conversazionale è solitamente composto da tre parti: istruzioni di sistema, frammenti di conoscenza recuperati o preimpostati e la domanda dell'utente del turno corrente. A livello ingegneristico occorre rispettare due linee: la prima è inserire solo i frammenti di conoscenza pertinenti alla domanda del turno corrente; contenuti irrilevanti non solo sprecano token ma disturbano la risposta. La seconda è mantenere un numero limitato di turni di cronologia della conversazione: più turni significano input più lungo, e oltre la lunghezza necessaria i benefici diminuiscono rapidamente. Inoltre, questa interfaccia non offre la ricerca web: tutti i materiali devono essere recuperati dal lato business e iniettati con la richiesta.
Limitare l'ambito della risposta
Nelle istruzioni di sistema scrivere esplicitamente: rispondere solo in base ai materiali forniti, non inventare informazioni assenti dai materiali; quando non è possibile rispondere usare una formula di fallback fissa. La formula di fallback deve essere scritta in anticipo e testata, non lasciata all'improvvisazione del modello: un rifiuto improvvisato è spesso sia prolisso che incontrollabile.
Fallback e passaggio alla gestione manuale
Anche se il modello ritiene di essere sicuro, occorre progettare una via d'uscita per il "non so rispondere". La pratica comune è: quando il modello segnala esplicitamente nella risposta un'insufficienza di basi, il frontend mostra l'accesso al passaggio alla gestione manuale; quando per più turni consecutivi il problema non viene risolto, attivare proattivamente il passaggio alla gestione manuale. Terminare l'incertezza lato sistema, anziché esporla all'utente.
Prospettiva di costo
La conversazione è lo scenario in cui i token si consumano più rapidamente in modo cumulativo, perché ogni turno deve portare con sé la cronologia. I mezzi di controllo consistono nel comprimere la cronologia tramite riassunto o nel mantenerne solo gli ultimi turni, e nel ripulire tempestivamente il contesto quando la sessione è inattiva. Si tratta di una decisione condivisa tra prodotto e ingegneria, le cui regole vanno stabilite già in fase di progettazione.
Punti di integrazione: costo dei token, latenza e retry in caso di errore
Raccogliamo i problemi ingegneristici comuni ai 5 scenari precedenti in una checklist direttamente applicabile. Chiariamo prima la forma dell'interfaccia:
- Modalità di chiamata: interfaccia compatibile con Chat Completions,
POST https://api.hiapi.ai/v1/chat/completions, base_urlhttps://api.hiapi.ai/v1, supporta l'output in streaming. - Canali: ogni modello dispone di canale standard (nome del modello senza suffisso) e canale Vertex (nome del modello con
@vertex, ad esempiogemini-4-carbon@vertex), con prezzi unitari diversi; scegliere in base alle necessità. - Input e output: l'input supporta testo e immagini, l'output è testo; contesto 1.048.576 token, output massimo per singola chiamata 65.536 token.
- Intensità di ragionamento: controllata da
reasoning_effort, opzionilow/medium/high. - Limiti di capacità: non supporta il tool calling / function calling, la ricerca web, il computer use, l'output strutturato / modalità JSON; questi aspetti vanno implementati lato business con vincoli nel prompt e catene proprie.
Metodo di stima dei costi
Per un modello fatturato a token, la stima dei costi deve basarsi sul numero di token di input e output per singola richiesta, moltiplicato per il volume di business e il prezzo unitario del canale corrispondente. In concreto: preparare per ogni scenario tre campioni rappresentativi (breve, medio, lungo), misurare separatamente le dimensioni di input e output, e prendere la media ponderata come base di costo per singola richiesta. I prezzi unitari sono quelli del listino sopra riportato; le differenze tra modelli e canali sono evidenti, quindi la stima va calcolata sulla combinazione effettivamente scelta.
Tecniche di riduzione dell'input
- Eliminare dal prompt le frasi che esprimono ripetutamente lo stesso vincolo: basta enunciarlo una volta.
- Un solo esempio few-shot come impostazione predefinita; aggiungerne altri solo se realmente necessario, e ogni aggiunta deve essere supportata da valutazioni.
- Per i testi lunghi, prima effettuare un ritaglio strutturato (prendere solo i capitoli pertinenti), poi riassumere.
- Negli scenari conversazionali comprimere o troncare la cronologia, senza accumulo illimitato.
Timeout e retry
- Impostare un limite di timeout esplicito per ogni chiamata; allo scadere è un fallimento, senza attese infinite.
- Per i retry utilizzare il backoff esponenziale, con un limite massimo al numero totale di tentativi.
- Nei retry includere le informazioni sull'errore precedente (motivo del fallimento del parsing, campi non validati) per aumentare il tasso di successo.
- Progettazione idempotente: chiamate ripetute sullo stesso dato di business non devono produrre effetti collaterali duplicati.
Strategia di degradazione
Ogni scenario deve rispondere alla domanda "cosa fare quando il modello non è disponibile". L'estrazione strutturata può degradare in coda manuale, la generazione di contenuti in template preimpostati, la classificazione nel canale predefinito, le domande e risposte nel passaggio alla gestione manuale. I percorsi di degradazione vanno implementati e collaudati già in fase di sviluppo, non improvvisati al momento del guasto.
Validazione e iterazione: come stabilire se lo scenario funziona davvero
La più grande trappola dell'integrazione di un modello è andare in produzione perché "la demo sembrava buona". La validazione deve rispondere a una domanda: il comportamento di questo scenario sul traffico reale è accettabile, e saremo in grado di accorgerci tempestivamente se peggiora?
Set di valutazione su piccolo campione
Costruire un set di valutazione separato per ogni scenario; la dimensione non deve essere grande, ma deve coprire sia input tipici che input limite. Il set di valutazione dell'estrazione strutturata deve includere campioni con campi mancanti, campi in eccesso e formato confuso; lo scenario di classificazione deve includere campioni ambigui e completamente irrilevanti; lo scenario di domande e risposte deve includere domande senza risposta nei materiali. Il set di valutazione è un asset dello scenario: va eseguito a ogni modifica del prompt.
Percentuale di campionamento manuale
Le metriche automatiche possono coprire solo la parte verificabile (validità del JSON, validità delle etichette, vincoli di lunghezza), mentre la qualità semantica richiede ancora intervento umano. La percentuale di campionamento va decisa in base al rischio dello scenario: per le domande e risposte rivolte all'utente e la generazione di contenuti esterni la percentuale deve essere più alta, per il routing interno e i riassunti interni può essere più bassa. I risultati del campionamento devono poter rifluire nel set di valutazione, aggiungendo i cattivi esempi individuati.
Metriche di monitoraggio online
Tenere sotto controllo almeno quattro categorie di metriche: tasso di successo delle chiamate e tasso di retry, tasso di fallimento di parsing e validazione, numero medio di token di input e output per singola richiesta, e tasso di attivazione di degradazione e passaggio alla gestione manuale. Le prime due riflettono la stabilità, la terza riflette se i costi sono fuori controllo, la quarta riflette l'effettiva usabilità. Qualsiasi variazione di tendenza in una di esse dovrebbe attivare una revisione del prompt o del flusso.
Ritmo di iterazione
Lo stesso modello può essere riutilizzato in più scenari, ma prompt e set di valutazione devono essere mantenuti separatamente per scenario. Non cercare di coprire tutte le attività aziendali con un unico prompt: le differenze nella struttura di input tra scenari sono proprio il valore di tutto il lavoro di progettazione precedente. Iterare ogni scenario come un piccolo prodotto indipendente: solo quando i criteri di validazione sono scritti chiaramente e i percorsi di fallback funzionano si è davvero passati dalla "scelta del modello" al "suo utilizzo".
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kimi-k3.1-pro tramite l'API HiAPI: curl, Python e richieste eseguibili direttamente
Una guida pratica all'integrazione, che copre endpoint, parametri della richiesta, streaming, tool calling e risoluzione dei problemi
-

Tutoriale
API ElevenLabs Music su HiAPI: generare musica con curl, Python e ricette di prompt
Un tutorial pratico per chiamare elevenlabs/music-v2.5 tramite HiAPI, con ricette di prompt pronte da copiare per stile, mood e durata
-

Tutoriale
Come usare gpt-image-2.5-sunburst/image-to-image tramite l'API HiAPI: curl e Python
Richieste eseguibili per sviluppatori, flusso di caricamento dell'immagine di riferimento e risoluzione degli errori