
Tutorial
gemini-4-argon Anwendungsszenarien in der Praxis: 5 hochwertige Einsatzmöglichkeiten von Textmodellen und ihre Umsetzung
Von der Auswahl zur Integration: 5 Szenarien für den Einsatz von Textmodellen im realen Geschäft
Auf dieser Seite
Warum Textmodelle für den Geschäftseinsatz wählen
Bevor wir konkrete Szenarien betrachten, beantworten wir eine grundlegendere Frage: Welche Aufgaben sollten einem solchen Modell übertragen werden? gemini-4-argon wird über eine Chat-Completions-kompatible Schnittstelle aufgerufen, unterstützt Texteingaben und Bilder, gibt Text aus und wird nach Tokens abgerechnet – diese Positionierung grenzt bereits seinen Fähigkeitsbereich ab.
Aufgaben, die sich für Textmodelle eignen
Es gibt nur ein Beurteilungskriterium: Ist das endgültige Ergebnis der Aufgabe ein Textabschnitt oder strukturierte Daten, die durch Text getragen werden. Typische Beispiele: Felder aus Freitext extrahieren, Werbetexte in großem Umfang generieren oder umschreiben, lange Dokumente zusammenfassen und zusammenführen, Anfragen mit Tags versehen und weiterleiten sowie in Dialogen natürlichsprachige Antworten formulieren. Gemeinsam ist diesen Aufgaben, dass die Eingabe Text ist (bei Bedarf mit Bild), die Ausgabe Text ist, weder Audio noch Video generiert werden muss und keine deterministischen Berechnungen erforderlich sind – das Modell muss lediglich die Eingabesemantik in eine erwartungskonforme Textausgabe überführen.
Aufgaben, die sich nicht für Textmodelle eignen
Umgekehrt sollte man bei folgenden Fällen konsequent auf andere Modelltypen ausweichen oder ganz auf ein Modell verzichten: Audio- oder Videoeingaben, Sprach- oder Videoausgaben, präzise numerische Berechnungen oder logische Schlussfolgerungen sowie alle Szenarien, die 100 % Determinismus erfordern (z. B. Geldabrechnung, Berechtigungsprüfung). Solche Aufgaben einem Textmodell aufzuzwingen bringt lediglich Unsicherheit in eine ursprünglich kontrollierbare Kette.
Wie die Abrechnungsart technische Entscheidungen beeinflusst
gemini-4-argon wird nach Tokens abgerechnet – eine Einschränkung, die sich bis in die Architektur durchzieht. Das bedeutet: Die wichtigste Kostenvariable ist die Eingabelänge, nicht die Anzahl der Aufrufe. Daher sollte man sich schon bei der Auswahl zwei Gewohnheiten aneignen: erstens „Wie kurz kann die Eingabe gemacht werden“ als ebenso wichtiges Designziel behandeln wie „Wie genau ist die Ausgabe“; zweitens für jedes Szenario den Eingabe-/Ausgabeumfang einer einzelnen Anfrage separat schätzen, statt das Budget pauschal nach Aufrufvolumen zu planen.
Die Serie umfasst drei Modelle, die nach Aufgabenkomplexität und Kosten abgewogen werden: gemini-4-carbon ist das stärkste Modell der Gemini-4-Serie für die komplexesten mehrstufigen, langfristigen Aufgaben; gemini-4-argon eignet sich für die meisten Software-Engineering- und Wissensarbeitsaufgaben mit ausgewogenem Verhältnis von Leistung und Kosten; gemini-3.8-flash ist schnell und günstig, geeignet für hohe Parallelität und niedrige Latenz.
Die Preise werden in drei Segmenten abgerechnet – Eingabe / gecachte Eingabe / Ausgabe – in US-Dollar pro Million Tokens. Jedes Modell gibt es in zwei Varianten: Standard-Route (Modellname ohne Suffix) und Vertex-Route (Modellname mit @vertex), mit unterschiedlichen Stückpreisen:
gemini-4-carbon: Standard-Route 1,00 / 0,05 / 5,00;@vertex-Route 1,64 / 0,09 / 8,20.gemini-4-argon: Standard-Route 1,00 / 0,05 / 5,00;@vertex-Route 1,64 / 0,09 / 8,20.gemini-3.8-flash: Standard-Route 0,19 / 0,02 / 0,92;@vertex-Route 0,62 / 0,07 / 3,08.
Mit dieser klaren Grenze ergeben die folgenden 5 Szenarien Sinn – sie alle bewegen sich im Rahmen „Texteingabe (ggf. mit Bild), Textausgabe“ und zeigen anhand unterschiedlicher Ein-/Ausgabestrukturen, wie dasselbe Modell in verschiedenen Geschäftsbereichen konkret eingesetzt wird.
Szenario 1: Unstrukturierter Text zu strukturierten Daten
Dies ist das Szenario, in dem Textmodelle am schnellsten Wirkung zeigen – und am leichtesten scheitern. Tickets, E-Mails, Nutzerkommentare und Vertragsausschnitte sind Freitext, während nachgelagerte Systeme feste Felder benötigen. Das Modell übernimmt die semantische Zuordnung zu Feldern, die Technik sorgt dafür, dass dieser Prozess stabil und prüfbar bleibt.
Ein-/Ausgabedesign
Auf der Eingabeseite müssen neben dem Originaltext auch die Felddefinitionen selbst als Teil des Prompts übergeben werden. Die Felddefinitionen sollten drei Elemente enthalten: Feldname, Typ, Wertebereich oder Enumeration. Erwarten Sie nicht, dass das Modell die gewünschte Struktur „errät“ – der Feldvertrag muss explizit ausgeschrieben werden.
Auf der Ausgabeseite wird das Modell im Prompt angewiesen, ausschließlich ein JSON-Objekt zurückzugeben, und es wird ein vollständiges Beispiel mitgegeben. Ein Beispiel ist wirksamer als jedes Adjektiv – es legt gleichzeitig Schlüsselnamensschreibweise, Verschachtelungsebene und Darstellung von Nullwerten fest. Es sei darauf hingewiesen, dass diese Schnittstelle keinen Parameter für strukturierte Ausgaben (JSON-Modus) bietet; ob das JSON gültig ist, hängt vollständig von der Prompt-Einschränkung und der nachgelagerten Validierung ab – daher die im Folgenden vorzubereitende Validierungs-Fallback-Logik.
Formatbeschränkungen und Validierungs-Fallback
Unabhängig davon, wie gut der Prompt formuliert ist, muss man davon ausgehen, dass das Modell gelegentlich ungültiges JSON oder fehlende Felder zurückgibt. Technisch sind drei Verteidigungslinien vorzubereiten:
- Parsing-Ebene: Strenges JSON-Parsing; bei Fehlschlag in den Retry-Zweig wechseln, statt zu versuchen, mit regulären Ausdrücken zu reparieren.
- Schema-Validierung: Mit JSON Schema oder einer äquivalenten Strukturvalidierung Typen und Pflichtfelder prüfen; Enumerationswerte außerhalb des zulässigen Bereichs gelten als Fehler.
- Geschäftliche Absicherung: Bei Validierungsfehler den Datensatz als „manuelle Bearbeitung erforderlich“ markieren und speichern, statt leere Felder in die nachgelagerten Systeme fließen zu lassen.
Retry-Strategie
Beim Wiederholen nicht unverändert erneut senden. Die Validierungsfehlermeldung zurück in den Prompt einbinden, z. B. „Der Wert high des Feldes priority liegt nicht in der zulässigen Enumeration; bitte aus low/medium/high wählen“ – das erhöht die Erfolgsrate beim zweiten Versuch deutlich. Gleichzeitig eine Obergrenze für Wiederholungen festlegen; bei Überschreitung an die manuelle Bearbeitung übergeben, um bei einzelnen Datensätzen keine Tokens unnötig zu verbrauchen.
Szenario 2: Massenhafte Inhaltsgenerierung und -umschreibung
Marketingtexte, Produktbeschreibungen und E-Mail-Vorlagen zeichnen sich durch hohe Parallelität, geringen Wert pro Einheit und hohe Anforderungen an Stilkonsistenz aus. Der Kernkonflikt hierbei: Es soll massenhaft erfolgen, aber nicht wie massenhaft generiert aussehen.
Template-basierte Prompts als Quelle der Stilkonsistenz
Den Prompt in zwei Teile aufteilen: „festes Template + Variablenplätze“. Im festen Template werden Rolle, Tonalität, Längenbereich, verbotene Wörter und Ausgabeformat festgelegt; die Variablenplätze enthalten nur das konkrete Material für diese Generierung, etwa Produktname, Verkaufsargumente, Zielgruppe. Der Vorteil: Stilbeschränkungen werden nur einmal geschrieben und unzählig oft wiederverwendet, und bei Stilanpassungen muss nur eine Stelle geändert werden, ohne dass einzelne Prompts auseinanderdriften.
Eingabelänge pro Aufruf kontrollieren
Die Abrechnung nach Tokens bedeutet, dass die Kosten in Massenszenarien nahezu vollständig von der Eingabe bestimmt werden. Drei direkt wirksame Maßnahmen:
- Variablenplätze nur mit notwendigen Informationen füllen. In eine Produktbeschreibung muss nicht das gesamte Produktdossier – drei bis fünf Schlüsselattribute genügen.
- Nur ein Beispiel behalten. Few-Shot-Beispiele helfen beim Stil, aber jedes zusätzliche Beispiel verursacht zusätzliche feste Eingabekosten; standardmäßig reicht eines.
- Keine Wiederholung von dem System bereits bekannten Informationen im Prompt. Bereits im Template festgeschriebene Beschränkungen nicht in jeder Variable erneut wiederholen.
Konsistenzprüfung
Nach der Massengenerierung eine leichte Prüfung einbauen: Regelvalidierung der Ausgaben (Länge im Bereich? verbotene Wörter enthalten? Pflichtinformationen vorhanden?). Nicht konforme Einträge kommen in die Neugenerierungs-Warteschlange. Diese Prüfung verbraucht kein Modellkontingent, fängt aber die meisten offensichtlich abweichenden Ergebnisse ab – die kosteneffizienteste Qualitätskontrolle in Massenszenarien.
Szenario 3: Zusammenfassung langer Texte und Zusammenführung mehrerer Dokumente
Lange Eingaben sind das Kostenloch dieses Szenarios. Bei demselben Material können unterschiedliche Aufteilungsstrategien den Token-Verbrauch um ein Mehrfaches unterscheiden und auch die Informationsgenauigkeit deutlich beeinflussen.
Zunächst prüfen, ob eine Aufteilung vermeidbar ist
Wenn die Originallänge im akzeptablen Bereich einer einzelnen Anfrage liegt, ist eine ganzheitliche Zusammenfassung oft besser als Aufteilen und anschließendes Zusammenführen, weil das Modell den vollständigen Kontext sieht. Erst wenn die Kapazität einer einzelnen Verarbeitung tatsächlich überschritten wird, sollte auf Aufteilung zurückgegriffen werden. Diese Entscheidung sollte im Code explizit getroffen werden, statt stets den Aufteilungsprozess zu durchlaufen. Das Kontextlimit dieser Schnittstelle beträgt 1.048.576 Tokens; einzelne Materialien können in den meisten Fällen direkt vollständig übergeben werden.
Die Aufteilungsstrategie bestimmt Kosten und Genauigkeit
Bei notwendiger Aufteilung zwei Prinzipien beachten:
- An semantischen Grenzen schneiden, nicht starr nach Zeichenzahl. Bevorzugt an Absätzen, Überschriften und Kapiteln trennen, um zu vermeiden, dass ein Satz mittendurch getrennt wird – Informationsverluste an Bruchstellen lassen sich in der Zusammenführungsphase oft nicht wiederherstellen.
- Geringe Überlappung zwischen Blöcken beibehalten. Ein kleiner überlappender Text zwischen benachbarten Blöcken mildert Probleme mit blockübergreifenden Referenzen und abgeschnittenen Schlussfolgerungen; der Preis sind wenige doppelte Tokens, was sich in der Regel lohnt.
Hierarchisches Design der Zusammenführungs-Zusammenfassung
Blockzusammenfassungen nicht flach aneinanderreihen und in einem Schritt zusammenfügen, sondern hierarchisch zusammenführen: Zuerst für jeden Block eine Blockzusammenfassung erzeugen, dann die Blockzusammenfassungen in der Reihenfolge des Originaldokuments zu einer Zwischenebene zusammenführen und schließlich die Gesamtzusammenfassung erzeugen. Die Hierarchie sollte nicht zu tief sein – zwei bis drei Ebenen genügen; jede weitere Ebene bedeutet eine weitere Runde Token-Verbrauch und einen weiteren Detailverlust durch Informationskompression.
Besonderheiten bei der Zusammenführung mehrerer Dokumente
In Mehrdokument-Szenarien werden neben der Zusammenfassung meist auch Vergleichsinformationen wie „Gemeinsamkeiten/Unterschiede“ benötigt. Die Vorgehensweise: Im Zusammenführungs-Prompt explizit fordern, die Ausgabe nach Themen statt nach Dokumenten zu organisieren – wenn Dokument für Dokument nacherzählt wird, entsteht eine Sammlung unzusammenhängender Absätze, und der Sinn der Zusammenführung geht verloren.
Szenario 4: Textklassifikation und Anfragen-Routing
In vielen Systemen ist die geeignetste Rolle eines Textmodells nicht die Inhaltsgenerierung, sondern die eines „semantischen Routers“: Feststellen, zu welcher Kategorie eine Anfrage gehört, und sie dann an den zuständigen nachgelagerten Prozess weiterleiten.
Ein festes Label-Set ist Voraussetzung für Stabilität
Der Ausgaberaum einer Klassifikationsaufgabe muss ein geschlossenes, vordefiniertes Label-Set sein. Keine offenen Fragen stellen („Welcher Typ ist das?“), sondern die Kandidaten-Labels zusammen mit einer einzeiligen Definition jedes Labels in den Prompt schreiben und das Modell anweisen, nur das Label selbst auszugeben. Offene Fragen führen zu unzähligen selbst erfundenen Labels, die nachgelagerte Systeme nicht routen können.
Gleichzeitig ein unknown-Label vorsehen. Im echten Verkehr gibt es immer Anfragen außerhalb des Label-Sets; dem Modell einen Ausgang „nicht kategorisierbar“ zu geben ist kontrollierbarer, als es zu zwingen, das nächstliegende Label zu wählen.
Wahl der Stufe der Inferenzintensität
Klassifikation ist eine der Textaufgaben mit den höchsten Determinismusanforderungen. Mit reasoning_effort die Inferenzintensität steuern (wählbar: low / medium / high); die konkrete Stufe sollte anhand praktischer Aufgabenevaluierung gewählt und nicht standardmäßig auf eine Stufe festgelegt werden. Gleichzeitig im Prompt fordern: „Nur den Label-Namen ausgeben, keine Erklärung“. Nach der Ausgabe eine Whitelist-Validierung durchführen; Ergebnisse außerhalb des Label-Sets direkt unknown zuordnen oder an die manuelle Bearbeitung übergeben.
Nachgelagerter Vertrag nach dem Routing
Die Klassifikation löst nur das „Wohin“; das Routing selbst muss ebenfalls klar definiert werden: Gehen Anfragen mit niedriger Konfidenz oder unknown über den Standardkanal oder die manuelle Warteschlange; wie der nachgelagerte Dienst nach Erhalt des Labels die Parameter zusammenstellt. Dies in den Schnittstellenvertrag schreiben statt in den Geschäftscode zu verstreuen – so sind bei späteren Label-Erweiterungen oder Routing-Regeländerungen deutlich weniger Stellen betroffen.
Szenario 5: Benutzergerichtete dialogische Fragebeantwortung
Dies ist das einzige Szenario, das direkt mit Endnutzern interagiert, und daher am wenigsten fehlertolerant. Nutzer kümmern sich nicht um die Unsicherheit des Modells – sie erinnern sich nur an eine Antwort, die am Thema vorbeiging.
Organisation des Kontexts
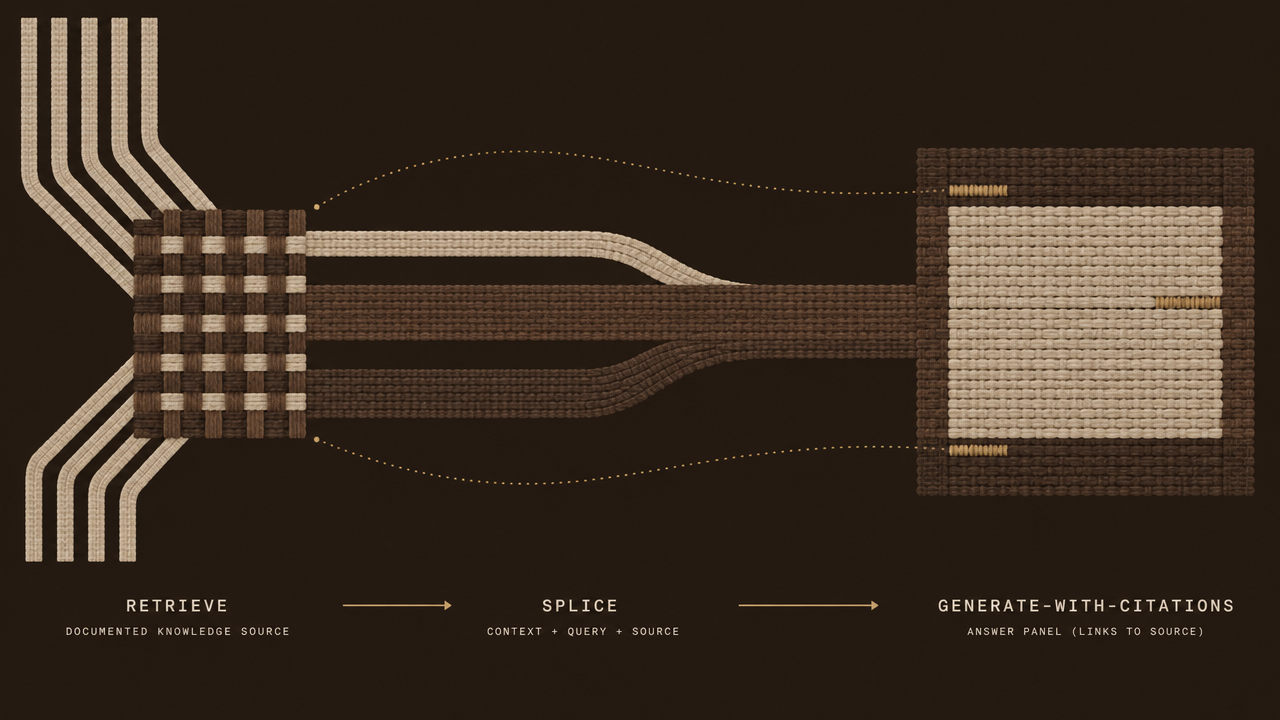
Die Eingabe im Dialog besteht in der Regel aus drei Teilen: Systemanweisung, abgerufene oder vorgegebene Wissensausschnitte sowie die aktuelle Nutzerfrage. Technisch sind zwei Linien einzuhalten: erstens nur für die aktuelle Frage relevante Wissensausschnitte einfügen – irrelevante Inhalte verschwenden nicht nur Tokens, sondern stören auch die Antwort; zweitens eine begrenzte Anzahl von Dialogrunden als Verlauf behalten – je mehr Runden, desto länger die Eingabe, und nach Überschreiten der notwendigen Länge sinkt der Nutzen schnell. Außerdem bietet diese Schnittstelle keine Websuche; alle Materialien müssen von der Geschäftsseite abgerufen und mit der Anfrage übergeben werden.
Antwortumfang begrenzen
In der Systemanweisung klar festhalten: Nur auf Basis der bereitgestellten Materialien antworten, keine Informationen erfinden, die nicht in den Materialien stehen; wenn keine Antwort möglich ist, feste Fallback-Formulierungen verwenden. Fallback-Formulierungen müssen vorab geschrieben und getestet sein, nicht dem Modell spontan überlassen – spontane Ablehnungen sind oft sowohl weitschweifig als auch unkontrollierbar.
Fallback und Übergabe an manuelle Bearbeitung
Auch wenn das Modell sicher zu sein glaubt, muss ein Ausgang für „kann nicht beantworten“ vorgesehen sein. Übliche Praxis: Wenn das Modell in der Antwort explizit unzureichende Grundlage kennzeichnet, zeigt das Frontend den Einstieg zur manuellen Bearbeitung an; wenn mehrere Runden hintereinander nicht gelöst wurden, aktiv die manuelle Bearbeitung auslösen. Unsicherheit im System beenden, statt sie dem Nutzer auszusetzen.
Kostenperspektive
Dialoge verbrauchen Tokens am schnellsten, weil jede Runde den Verlauf mitführt. Gegenmaßnahmen: Verlauf zusammenfassen und komprimieren oder nur die letzten wenigen Runden behalten und den Kontext bei Inaktivität der Sitzung zeitnah bereinigen. Dies ist eine gemeinsame Entscheidung von Produkt und Technik; die Regeln sollten bereits in der Designphase festgelegt werden.
Integrationspunkte: Token-Kosten, Latenz und Fehlerwiederholung
Die gemeinsamen technischen Fragen der fünf Szenarien zu einer direkt anwendbaren Checkliste bündeln. Zunächst die Schnittstellenform klären:
- Aufrufart: Chat-Completions-kompatible Schnittstelle,
POST https://api.hiapi.ai/v1/chat/completions, base_urlhttps://api.hiapi.ai/v1, Streaming-Ausgabe unterstützt. - Routen: Jedes Modell hat eine Standard-Route (Modellname ohne Suffix) und eine Vertex-Route (Modellname mit
@vertex, z. B.gemini-4-carbon@vertex); die beiden Routen haben unterschiedliche Stückpreise, je nach Bedarf wählen. - Ein-/Ausgabe: Eingabe unterstützt Text und Bilder, Ausgabe ist Text; Kontext 1.048.576 Tokens, maximale Ausgabe pro Aufruf 65.536 Tokens.
- Inferenzintensität: Gesteuert über
reasoning_effort, wählbarlow/medium/high. - Fähigkeitsgrenzen: Keine Tool-Aufrufe / Function Calling, keine Websuche, kein Computer Use, keine strukturierten Ausgaben / kein JSON-Modus – diese müssen auf der Geschäftsseite durch Prompt-Einschränkungen und eigene Ketten umgesetzt werden.
Kostenschätzmethode
Bei nach Tokens abgerechneten Modellen muss die Kostenschätzung auf die Token-Anzahl von Eingabe und Ausgabe pro Anfrage heruntergebrochen und dann mit dem Geschäftsvolumen und dem Stückpreis der jeweiligen Route multipliziert werden. Konkret: Für jedes Szenario drei repräsentative Stichproben (kurz, mittel, lang) vorbereiten, jeweils Eingabe- und Ausgabeumfang messen und den gewichteten Durchschnitt als Kostenbasis pro Anfrage verwenden. Die Stückpreise richten sich nach der obigen Preisliste; verschiedene Modelle und Routen unterscheiden sich deutlich, daher bei der Schätzung die tatsächlich gewählte Kombination zugrunde legen.
Tipps zur Eingabekürzung
- Sätze im Prompt löschen, die dieselbe Beschränkung wiederholt ausdrücken – eine einmalige Nennung genügt.
- Few-Shot-Beispiele standardmäßig eines; bei echtem Bedarf weitere hinzufügen, aber jede Ergänzung muss durch Evaluierung belegt sein.
- Lange Texte zuerst strukturell kürzen (nur relevante Kapitel entnehmen), dann zusammenfassen.
- Im Dialog den Verlauf komprimieren oder abschneiden, nicht unbegrenzt anwachsen lassen.
Timeout und Wiederholung
- Für jeden Aufruf ein klares Timeout-Limit setzen; bei Überschreitung gilt der Aufruf als fehlgeschlagen, nicht unbegrenzt warten.
- Wiederholungen mit exponentiellem Backoff und einer Obergrenze für die Gesamtzahl der Wiederholungen.
- Bei Wiederholung die Fehlerinformation des letzten Versuchs mitgeben (Grund für Parsing-Fehler, nicht bestandene Felder der Validierung), um die Erfolgsrate zu erhöhen.
- Idempotentes Design: Wiederholte Aufrufe für denselben Geschäftsdatensatz sollten keine doppelten Nebenwirkungen erzeugen.
Degradationsstrategie
Jedes Szenario muss die Frage beantworten: „Was tun, wenn das Modell nicht verfügbar ist?“ Strukturierte Extraktion kann auf eine manuelle Warteschlange degradiert werden, Inhaltsgenerierung auf vorgegebene Templates, Klassifikation auf den Standardkanal, Fragebeantwortung auf Übergabe an die manuelle Bearbeitung. Degradationspfade müssen in der Entwicklungsphase implementiert und geübt werden, nicht erst bei Störungen ad hoc zusammengestellt werden.
Abnahme und Iteration: Wie man erkennt, ob ein Szenario wirklich funktioniert
Die größte Falle bei der Modellintegration ist das Live-Gehen, sobald „die Demo gut aussieht“. Die Abnahme muss eine Frage beantworten können: Ist die Leistung dieses Szenarios unter echtem Verkehr akzeptabel, und können wir Verschlechterungen rechtzeitig erkennen?
Kleines Evaluierungs-Set
Für jedes Szenario ein eigenes Evaluierungs-Set anlegen; der Umfang muss nicht groß sein, aber typische und Grenzfälle abdecken. Das Evaluierungs-Set für strukturierte Extraktion sollte Beispiele mit fehlenden Feldern, zusätzlichen Feldern und chaotischem Format enthalten; Klassifikationsszenarien sollten mehrdeutige und völlig irrelevante Beispiele enthalten; Fragebeantwortungs-Szenarien sollten Fragen ohne Antwort in den Materialien enthalten. Das Evaluierungs-Set ist ein Asset des Szenarios; jede Prompt-Änderung muss damit geprüft werden.
Anteil manueller Stichproben
Automatisierte Metriken decken nur den prüfbaren Teil ab (JSON-Gültigkeit, Label-Gültigkeit, Längenbeschränkungen); die semantische Qualität erfordert weiterhin manuelle Prüfung. Der Stichprobenanteil richtet sich nach dem Risiko des Szenarios: Bei benutzergerichteter Fragebeantwortung und externer Inhaltsgenerierung sollte er höher sein, bei internem Routing und internen Zusammenfassungen niedriger. Die Ergebnisse der Stichproben müssen in das Evaluierungs-Set zurückfließen; entdeckte schlechte Beispiele dort ergänzen.
Online-Überwachungsmetriken
Mindestens vier Metriktypen im Auge behalten: Erfolgsrate der Aufrufe und Wiederholungsrate, Fehlerrate bei Parsing und Validierung, durchschnittliche Token-Anzahl von Eingabe und Ausgabe pro Anfrage sowie Auslöserate von Degradation und Übergabe an manuelle Bearbeitung. Die ersten beiden spiegeln die Stabilität wider, die dritte, ob die Kosten außer Kontrolle geraten, die vierte die tatsächliche Verfügbarkeit. Jede trendartige Veränderung einer dieser Metriken sollte eine Überprüfung von Prompt oder Prozess auslösen.
Iterationsrhythmus
Dasselbe Modell kann in mehreren Szenarien wiederverwendet werden, aber Prompts und Evaluierungs-Sets müssen je Szenario getrennt gepflegt werden. Nicht versuchen, mit einem einzigen Prompt alle Geschäftsbereiche abzudecken – die Unterschiede in den Eingabestrukturen zwischen den Szenarien sind genau der Wert all der vorangegangenen Designarbeit. Jedes Szenario als eigenständiges kleines Produkt iterieren, Abnahmekriterien klar formulieren und Fallback-Pfade zum Laufen bringen – erst dann ist man wirklich von der „Modellauswahl“ zum „Modelleinsatz“ gelangt.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie kimi-k3.1-pro über die HiAPI-API auf: curl, Python und direkt ausführbare Anfragen
Ein praxisnaher Integrationsleitfaden zu Endpunkten, Anfrageparametern, Streaming, Tool-Aufrufen und Fehlerbehebung
-

Tutorial
ElevenLabs Music API auf HiAPI: Musikgenerierung mit curl, Python und Prompt-Rezepten
Ein praktisches Tutorial zum Aufruf von elevenlabs/music-v2.5 über HiAPI sowie kopierbare Prompt-Rezepte für Stil, Stimmung und Länge
-

Tutorial
So verwenden Sie gpt-image-2.5-sunburst/image-to-image über die HiAPI API: curl und Python
Ausführbare Requests für Entwickler, Workflow zum Hochladen von Referenzbildern und Fehlerbehebung