
튜토리얼
gemini-4-argon 애플리케이션 시나리오 실전: 5가지 고부가 텍스트 모델 활용법과 구현 포인트
모델 선택에서 연동까지: 텍스트 모델을 실제 비즈니스에 적용하는 5가지 시나리오
이 페이지에서
비즈니스 구현에 텍스트 모델을 선택하는 이유
구체적인 시나리오를 시작하기 전에 더 근본적인 질문에 먼저 답해야 합니다. 어떤 작업을 이 유형의 모델에 맡겨야 할까요? gemini-4-argon은 Chat Completions 호환 인터페이스로 호출되며, 입력은 텍스트와 이미지를 지원하고 출력은 텍스트이며, 토큰 기준으로 과금됩니다. 이定位 자체가 모델의 능력 경계를 명확히划定합니다.
텍스트 모델에 적합한 작업
판단 기준은 단 하나입니다. 작업의 최종 산출물이一段의 텍스트이거나 텍스트로承载된 구조화 데이터인지 여부입니다. 대표적으로: 자유 텍스트에서 필드 추출, 대량 카피 생성 또는改写, 긴 문서 요약 및 병합, 요청에 태그를 달아 라우팅, 대화에서 자연어 응답 구성 등이 있습니다.这些 작업의 공통점은 입력이 텍스트(필요 시 이미지 첨부 가능)이고 출력이 텍스트이며, 오디오나 비디오 생성이 필요 없고 결정론적 계산도 필요 없다는 점입니다. 모델은 입력 의미를 기대에 부합하는 텍스트 출력으로 매핑하기만 하면 됩니다.
텍스트 모델에 부적합한 작업
반대로 다음 상황에서는 과감히 다른 유형의 모델로 전환하거나 아예 모델을 사용하지 않아야 합니다. 오디오 또는 비디오 입력이 필요한 경우, 음성이나 비디오 출력이 필요한 경우, 정확한 수치 계산이나 논리 연역이 필요한 경우, 그리고 100% 결정론이 요구되는 모든 시나리오(예: 금액 정산, 권한 판정)입니다. 이런 작업을 텍스트 모델에 억지로 맡기면 원래 통제 가능했던 링크에 불확실성만引入하게 됩니다.
과금 방식이 엔지니어링 의사결정에 미치는 영향
gemini-4-argon은 토큰 기준으로 과금되며, 이는 아키텍처 설계까지 전파되는 제약입니다. 이는 비용의 주요 변수가 호출 횟수가 아니라 입력 길이임을 의미합니다. 따라서 모델 선택 단계에서부터 두 가지 습관을 형성해야 합니다. 첫째, '입력을 얼마나 짧게 줄일 수 있는가'를 '출력이 정확한가'와 동등하게 중요한 설계 목표로 삼는 것. 둘째, 호출량 기준으로 대충 예산을 잡지 말고 각 시나리오별로 단일 요청의 입출력 규모를 개별 산정하는 것입니다.
동일 시리즈에는 작업 복잡도와 비용权衡에 따라 세 가지 모델이 있습니다. gemini-4-carbon은 Gemini 4 시리즈 최강 모델로 가장 복잡한 다단계·장기 작업을 대상으로 합니다. gemini-4-argon은 대부분의 소프트웨어 엔지니어링과 지식 작업에 적합하며 능력과 비용이 균형을 이룹니다. gemini-3.8-flash는 속도가 빠르고 가격이 낮아 고동시성·저지연 작업에 적합합니다.
가격은 입력 / 캐시 입력 / 출력 세 구간으로 과금되며, 단위는 백만 토큰당 미국 달러입니다. 각 모델에는 표준 라인(모델명에 접미사 없음)과 Vertex 라인(모델명에 @vertex 추가) 두 가지가 있으며 단가가 다릅니다.
gemini-4-carbon: 표준 라인 1.00 / 0.05 / 5.00;@vertex라인 1.64 / 0.09 / 8.20.gemini-4-argon: 표준 라인 1.00 / 0.05 / 5.00;@vertex라인 1.64 / 0.09 / 8.20.gemini-3.8-flash: 표준 라인 0.19 / 0.02 / 0.92;@vertex라인 0.62 / 0.07 / 3.08.
이 경계를 명확히 한 뒤에야 다음 5가지 시나리오가 의미를 갖습니다. 이들은 모두 '입력 텍스트(이미지 첨부 가능), 출력 텍스트'라는 프레임 안에서 서로 다른 입출력 구조 설계를 통해 동일 모델을 각기 다른 비즈니스에 적용하는 구체적 방법입니다.
시나리오 1: 비정형 텍스트에서 구조화 데이터로
이것은 텍스트 모델이 가장 효과를 보기 쉽고, 가장 실패하기 쉬운 시나리오입니다. 티켓, 이메일, 사용자 리뷰, 계약서 조각은 모두 자유 텍스트이지만 다운스트림 시스템은 고정 필드를 필요로 합니다. 모델은 의미를 필드로 매핑하고, 엔지니어링은 이 과정을 안정적이고 검증 가능하게 만듭니다.
입출력 설계
입력 측에서는 원문 텍스트 외에 필드 정의 자체를 프롬프트의 일부로 전달해야 합니다. 필드 정의에는 세 가지 요소가 포함되어야 합니다: 필드명, 타입, 값 범위 또는 열거형. 모델이 원하는 구조를 '알아서 추측'하리라 기대하지 마십시오. 필드 계약은 명시적으로 작성해야 합니다.
출력 측에서는 프롬프트에서 모델이 JSON 객체 하나만 반환하도록 요구하고 완전한 예시를 제공합니다. 예시는 어떤 형용사보다 효과적입니다. 키 이름 표기, 중첩 계층, null 값 표현 방식을 동시에 제약하기 때문입니다. 참고로 이 인터페이스는 구조화 출력(JSON 모드) 파라미터를 제공하지 않으므로, JSON 유효성은 전적으로 프롬프트 제약과 다운스트림 검증에 달려 있습니다. 이것이 아래에서 검증 및 폴백을 준비해야 하는 이유이기도 합니다.
형식 제약과 검증 폴백
프롬프트를 아무리 잘 작성해도 모델이 간혹 유효하지 않은 JSON을 반환하거나 필드를 누락할 수 있다고 가정해야 합니다. 엔지니어링에서는 세 겹의 방어선을 준비해야 합니다.
- 파싱 계층: 엄격한 JSON 파싱을 수행하고, 실패하면 정규식으로修补하려 하지 말고 재시도 분기로 진입합니다.
- 스키마 검증: JSON Schema 또는 동등한 구조 검증으로 타입과 필수 필드를检查하고, 열거형 값이 범위를 벗어나면一律 실패로 간주합니다.
- 비즈니스 폴백: 검증 실패 시 해당 레코드를 '수동 처리 필요'로 표시하여 저장하고, 빈 필드가 다운스트림으로 흘러가게 두지 않습니다.
재시도 전략
재시도할 때 원본을 그대로 재전송하지 마십시오. 검증 오류 정보를 프롬프트에 다시 붙여넣으면, 예를 들어 '필드 priority의 값 high가 허용 열거형에 없습니다. low/medium/high 중에서 선택하십시오'라고 하면 두 번째 성공률이 현저히 높아집니다. 동시에 재시도 횟수에 상한을 두고, 상한을 넘으면 수동 처리로 전환하여 단일 데이터에 토큰을 무의미하게 소모하지 않도록 합니다.
시나리오 2: 대량 콘텐츠 생성 및改写
마케팅 카피, 상품 설명, 이메일 템플릿 같은 작업은 고동시성, 낮은 단일 건 가치, 높은 스타일 일관성 요구라는 특징이 있습니다. 여기서 핵심 모순은 대량으로 생성하면서도 대량 생성처럼 보이지 않아야 한다는 것입니다.
템플릿화된 프롬프트가 스타일 일관성의 원천
프롬프트를 '고정 템플릿 + 변수 슬롯' 두 부분으로 분리합니다. 고정 템플릿에는 역할, 어조, 길이 범위, 금지어, 출력 형식을 명확히 적습니다. 변수 슬롯에는 이번에 생성할 구체적 소재, 예를 들어 상품명, 판매 포인트, 목표 고객만 넣습니다. 이렇게 하면 스타일 제약을 한 번만 작성하고 무수히 재사용할 수 있으며, 스타일을 조정할 때 한 곳만 수정하면 되어 각 프롬프트가 표류할 걱정이 없습니다.
단일 입력 길이 통제
토큰 기준 과금은 대량 시나리오의 비용이 거의 전적으로 입력에 의해 결정됨을 의미합니다. 세 가지 직접 효과적인 방법:
- 변수 슬롯에는 필요한 정보만 넣기. 상품 설명에 전체 상품档案을 넣을 필요 없이 세에서 다섯 개의 핵심 속성만 고르면 됩니다.
- 예시는 하나만 유지. few-shot 예시는 스타일에 도움이 되지만 예시가 하나 늘 때마다 고정 입력 비용이 늘어나므로 기본적으로 하나면 충분합니다.
- 프롬프트에 시스템이 이미 아는 정보를 반복하지 않기. 템플릿에 이미 고정된 제약을 각 변수에 다시 서술하지 마십시오.
일관성 검사 단계
대량 생성 후 가벼운 검사를 추가합니다: 출력에 규칙 검증(길이가 범위 내인지, 금지어가 나타났는지, 필수 정보가 포함되었는지)을 수행하고, 불합격 항목은 재생성 큐로 보냅니다. 이 검사는 모델 할당량을 소모하지 않으면서 대부분의 명백한 이탈 결과를 걸러내므로, 대량 시나리오에서 가성비가 가장 높은 품질 통제 수단입니다.
시나리오 3: 긴 텍스트 요약과 다문서 병합
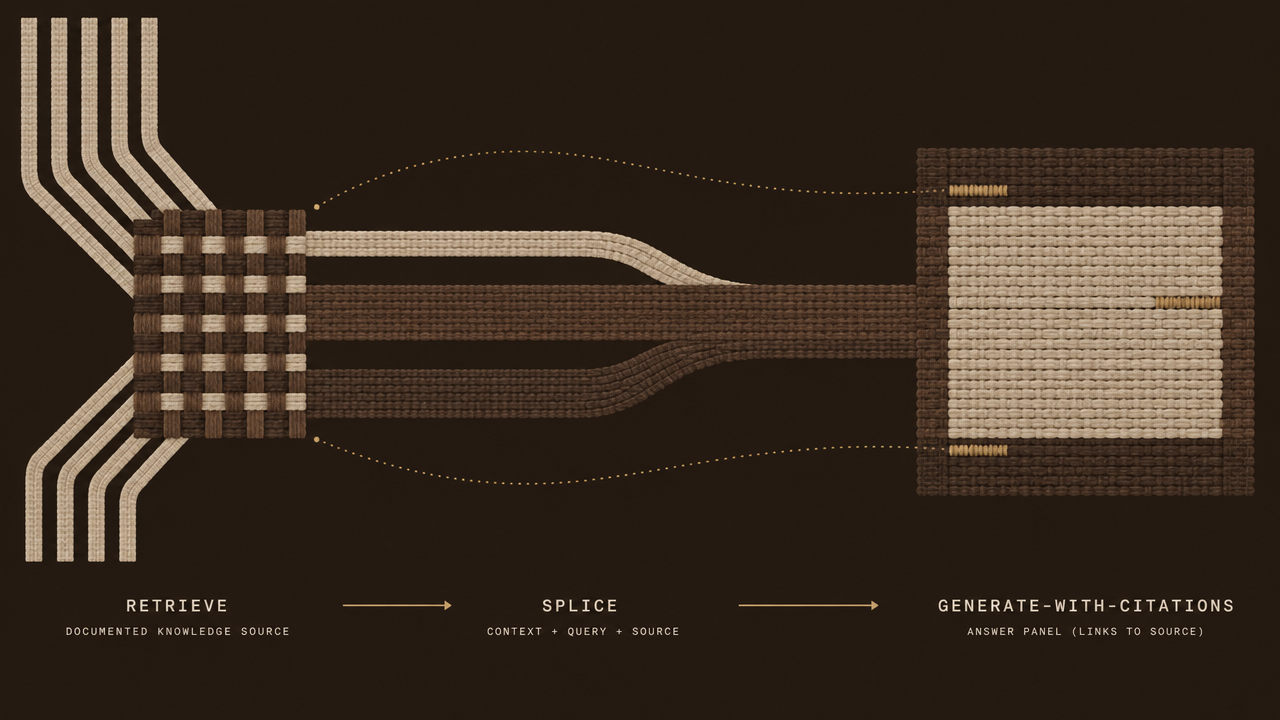
긴 입력은 이 시나리오의 비용 블랙홀입니다. 동일한 자료라도 분할 전략이 다르면 토큰 소모가 몇 배 차이 날 수 있고, 정보 보존도도 현저히 달라집니다.
먼저 분할하지 않아도 되는지 판단하기
원문 길이가 단일 요청에서 수용 가능한 범위 내라면, 분할 후 병합하는 것보다 전체 요약이 더 나은 경우가 많습니다. 모델이 완전한 컨텍스트를 볼 수 있기 때문입니다. 실제로 단일 처리 능력을 초과할 때만 분할을 도입합니다. 이 판단은 코드에서 명시적으로 수행해야 하며, 무조건 분할流程을 타지 않도록 합니다. 이 인터페이스의 컨텍스트 상한은 1,048,576 token이므로, 단일 문서 자료는 대부분의 경우 전체를 그대로 보낼 수 있습니다.
분할 전략이 비용과 보존도를 결정
분할이 필요할 때는 두 가지 원칙을 따릅니다:
- 의미 경계로 자르고, 글자 수로硬切하지 않기. 문단, 제목, 장절에서 우선 끊고, 한 문장을 중간에서 쪼개지 않도록 합니다. 끊긴 지점의 정보 손실은 병합 단계에서 되찾을 수 없는 경우가 많습니다.
- 블록 간에少量 중첩 유지. 인접 블록에 작은 중첩 텍스트를 두면 블록 간 지시어와 결론이 잘리는 문제를 완화할 수 있으며, 비용은 소량의 중복 토큰인데 보통 그만한 가치가 있습니다.
병합 요약의 계층 설계
블록 요약을 평면적으로 나열해 한 번에 이어붙이지 말고 계층적 병합을 합니다. 먼저 각 블록에 대해 블록 수준 요약을 생성하고, 블록 요약을 원문서 순서대로 병합해 중간 계층을 만들고, 마지막으로 총 요약을 생성합니다. 계층은 너무 깊지 않게, 두세 계층이면 충분합니다. 한 계층 늘어날 때마다 한轮의 토큰이 소모되고, 정보 압축에서 디테일이 한 번 더 손실됩니다.
다문서 병합의 특수 처리
다문서 시나리오에서는 요약 외에 보통 '공통점/차이점' 같은 비교 정보도 필요합니다. 방법은 병합 프롬프트에서 문서별이 아니라 주제별로 출력을 구성하도록 명시적으로 요구하는 것입니다. 문서별로 하나씩 반복 서술하면 결과가 서로 무관한 문단 더미가 되어 병합의 의미를 잃습니다.
시나리오 4: 텍스트 분류와 요청 라우팅
많은 시스템에서 텍스트 모델의 가장 적합한 역할은 콘텐츠 생성이 아니라 '의미 라우터' 역할입니다. 이 요청이 어느 범주에 속하는지 판단한 뒤 다운스트림의 전용流程으로 넘기는 것입니다.
고정 레이블 세트는 안정성의 전제
분류 작업의 출력 공간은 반드시 폐쇄적이고 사전 정의된 레이블 세트여야 합니다. 개방형 질문('이것은 어떤 유형입니까?')을 쓰지 말고, 후보 레이블과 각 레이블의 한 문장 정의를 함께 프롬프트에 작성하고 모델이 레이블 자체만 출력하도록 요구합니다. 개방형 질문은 끝없는 자체 생성 레이블을 낳아 다운스트림이 라우팅할 수 없게 만듭니다.
동시에 unknown 레이블을预留해야 합니다. 실제 트래픽에는 항상 레이블 세트 밖의 요청이 있으므로, 모델에게 '분류 불가' 출구를 주는 것이 가장 가까운 레이블을 억지로 고르게 하는 것보다 통제 가능합니다.
추론 강도 단계 선택
분류는 결정론 요구가 가장 높은 텍스트 작업 중 하나입니다. reasoning_effort로 추론 강도를 제어하며(선택 가능: low / medium / high), 구체적 단계는 실제 작업 평가에 따라 선택해야 하고 기본적으로 특정 단계를 일괄 적용하지 않는 것이 좋습니다. 동시에 프롬프트에서 '레이블명만 출력하고 설명하지 말 것'을 요구합니다. 출력 후 화이트리스트 검증을 수행하여 레이블 세트 내에 없는 결과는 unknown으로 분류하거나 수동 처리로 전환합니다.
라우팅 후 다운스트림 계약
분류는 '어디로 갈지'만 해결하므로, 라우팅 자체도 명확히 정의해야 합니다: 낮은 신뢰도 또는 unknown 요청은 기본 채널로 보낼지 수동 큐로 보낼지, 다운스트림 서비스가 레이블을 받은 후 파라미터를 어떻게 조립할지. 이것을 비즈니스 코드에 흩어놓지 말고 인터페이스 계약에 작성하면, 이후 레이블 추가나 라우팅 규칙 조정 시 변경 범위가 훨씬 작아집니다.
시나리오 5: 사용자 대상 대화형 질의응답
이것은 유일하게 최종 사용자를 직접 대면하는 시나리오이므로 실패에 가장 관대하지 않습니다. 사용자는 모델의 불확실성에 관심이 없고, 한 번의 동문서답만 기억합니다.
컨텍스트 구성 방식
대화 시나리오의 입력은 보통 세 부분으로 구성됩니다: 시스템 지시, 검색 또는 사전 설정된 지식 조각, 그리고 이번輪 사용자 질문. 엔지니어링에서는 두 가지 선을 지켜야 합니다. 첫째, 이번 질문과 관련된 지식 조각만 넣기. 무관한 내용은 토큰을 낭비할 뿐 아니라 답변을 방해합니다. 둘째, 제한된轮次의 대화 이력 유지. 轮次가 많을수록 입력이 길어지고, 필요 길이를 넘으면 수익이 급격히 감소합니다. 또한 이 인터페이스는 웹 검색을 제공하지 않으므로 모든 자료는 비즈니스 측에서 검색한 후 요청에 주입해야 합니다.
답변 범위 제한
시스템 지시에 명확히 작성합니다: 제공된 자료에만 근거하여 답하고, 자료에 없는 정보는 지어내지 말 것; 답할 수 없을 때는 고정된 폴백 문구를 사용할 것. 폴백 문구는 사전에 작성하고 테스트해야 하며, 모델이 즉석에서 만들어내게 하지 마십시오. 즉석 거절은 대개 장황하고 통제 불가능합니다.
폴백과 수동 전환
모델이 확신한다고 판단하더라도 '답하지 못하는' 경우를 위한 출구를 설계해야 합니다. 일반적인 방법은: 모델이 답변에서 근거 부족을 명시적으로 표시하면 프론트엔드에서 수동 상담 입구를 표시하고; 연속 여러 轮에서 문제가 해결되지 않으면 적극적으로 수동 전환을 트리거합니다. 불확실성을 사용자에게 노출하지 않고 시스템 측에서 종결시키는 것입니다.
비용 관점
대화는 매 轮마다 이력을携带해야 하므로 누적 토큰 소모가 가장 빠른 시나리오입니다. 통제 수단은 이력을 요약 압축하거나 최근 몇 轮만 유지하고, 세션이 유휴할 때 컨텍스트를及时 정리하는 것입니다. 이는 제품과 엔지니어링의 공동 의사결정에 속하므로 설계 단계에서 규칙을 정해야 합니다.
연동 포인트: 토큰 비용, 지연, 실패 재시도
앞의 5가지 시나리오의 공통 엔지니어링 문제를 바로 적용 가능한 체크리스트로 정리합니다. 먼저 인터페이스 형태를 명확히 합니다:
- 호출 방식: Chat Completions 호환 인터페이스,
POST https://api.hiapi.ai/v1/chat/completions, base_url은https://api.hiapi.ai/v1, 스트리밍 출력 지원. - 라인: 각 모델에는 표준 라인(모델명에 접미사 없음)과 Vertex 라인(모델명에
@vertex추가, 예:gemini-4-carbon@vertex)이 있으며, 두 라인의 단가가 다르므로 필요에 따라 선택. - 입출력: 입력은 텍스트와 이미지를 지원하고 출력은 텍스트; 컨텍스트 1,048,576 token, 단일 최대 출력 65,536 token.
- 추론 강도:
reasoning_effort로 제어, 선택 가능:low/medium/high. - 능력 경계: 도구 호출 / function calling, 웹 검색, computer use, 구조화 출력 / JSON 모드를 지원하지 않으며, 이는 비즈니스 측에서 프롬프트 제약과 자체 링크로 구현해야 합니다.
비용 추정 방법
토큰 기준 과금 모델의 비용 추정은 단일 요청의 입출력 토큰 수에 착안하여 비즈니스량과 해당 라인의 단가를 곱해야 합니다. 구체적 방법은: 각 시나리오에 대해 짧음, 중간, 긺 세 가지 대표 샘플을 준비하고 각각 입출력 규모를 측정하여 가중 평균을 단일 비용 기준선으로 삼습니다. 단가는 위의 가격표를 기준으로 하며, 모델과 라인에 따라 차이가 크므로 추정 시 실제 선택한 조합으로 계산해야 합니다.
입력 축소 기법
- 프롬프트에서 동일한 제약을 반복 표현하는 문장을 삭제합니다. 제약은 한 번만 말하면 충분합니다.
- few-shot 예시는 기본적으로 하나, 정말 필요할 때 추가하며, 추가할 때마다 평가 근거가 있어야 합니다.
- 긴 텍스트는 먼저 구조화 축소(관련 장절만 추출)한 후 요약합니다.
- 대화 시나리오에서는 이력을 압축하거나截断하고, 무한정 누적하지 않습니다.
타임아웃과 재시도
- 매 호출에 명확한 타임아웃 상한을 설정하고, 타임아웃이면 실패로 처리하며 무한 대기하지 않습니다.
- 재시도는 지수 백오프를 사용하고 총 재시도 횟수에 상한을 둡니다.
- 재시도 시 이전 오류 정보(파싱 실패 원인, 검증 불통과 필드)를携带하여 성공률을 높입니다.
- 멱등 설계: 동일한 비즈니스 데이터를 반복 호출해도 중복 부작용이 발생하지 않아야 합니다.
폴백 전략
각 시나리오마다 '모델을 사용할 수 없을 때怎么办'에 답해야 합니다. 구조화 추출은 수동 큐로 폴백, 콘텐츠 생성은 사전 설정 템플릿으로 폴백, 분류는 기본 채널로 폴백, 질의응답은 수동 전환으로 폴백할 수 있습니다. 폴백 경로는 개발 단계에서 구현하고 리허설해야 하며, 장애 시 임시로 짜맞추지 않도록 합니다.
검수와迭代: 시나리오가 실제로 작동하는지 판단하는 방법
모델 연동의 가장 큰 함정은 '데모가 좋아 보인다'는 이유로 출시하는 것입니다. 검수는 한 가지 질문에 답할 수 있어야 합니다: 이 시나리오가 실제 트래픽에서 수용 가능한 성능을 보이는지, 그리고 나빠질 때 우리가及时 발견할 수 있는지.
소표본 평가 세트
각 시나리오별로 평가 세트를 따로 구축합니다. 규모는 클 필요 없지만 전형적 입력과 경계 입력 두 가지를 반드시 포함해야 합니다. 구조화 추출 평가 세트에는 필드 누락, 필드 과다, 형식 혼란 샘플을 포함하고; 분류 시나리오에는 모호한 샘플과 완전히 무관한 샘플을 포함하며; 질의응답 시나리오에는 자료에 답이 없는 질문을 포함합니다. 평가 세트는 시나리오의 자산이며, 프롬프트를 수정할 때마다 실행해야 합니다.
수동 표본 검사 비율
자동화 지표는 검증 가능한 부분(JSON 유효성, 레이블 유효성, 길이 제약)만 커버할 수 있으며, 의미 품질은 여전히 수동이 필요합니다. 표본 검사 비율은 시나리오 위험도에 따라 정합니다: 사용자 대상 질의응답과 외부 콘텐츠 생성은 비율을 높이고, 내부 라우팅과 내부 요약은 더 낮출 수 있습니다. 표본 검사 결과는 평가 세트로 환류되어 발견된 나쁜 예시를补充해야 합니다.
온라인 모니터링 지표
최소 네 가지 지표를 주시합니다: 호출 성공률과 재시도율, 파싱 및 검증 실패율, 단일 요청의 평균 입출력 토큰 수, 그리고 폴백과 수동 전환 트리거율. 앞의 두 가지는 안정성을 반영하고, 세 번째는 비용이 통제를 벗어났는지 반영하며, 네 번째는 실제 가용성을 반영합니다. 어느 하나라도 추세적 변화가 나타나면 프롬프트나流程의 재검토를 트리거해야 합니다.
迭代 리듬
동일 모델을 여러 시나리오에서 재사용할 수 있지만, 프롬프트와 평가 세트는 시나리오별로 분리 관리해야 합니다. 하나의 프롬프트 세트로 모든 비즈니스를打通하려 하지 마십시오. 시나리오 간 입력 구조 차이가 바로 앞의 모든 설계 작업의 가치입니다. 각 시나리오를 독립적인 작은 제품으로迭代하고, 검수 기준을 명확히 작성하고 폴백 경로를 작동시켜야 비로소 '모델 선택'에서 '모델 활용'으로 진정 나아갔다고 할 수 있습니다.
관련 글
모든 아티클 보기 →-

튜토리얼
HiAPI API로 kimi-k3.1-pro 호출하는 방법: curl, Python과 바로 실행 가능한 요청
엔드포인트, 요청 파라미터, 스트리밍, 도구 호출, 오류 문제 해결을 다루는 실전 통합 가이드
-

튜토리얼
HiAPI의 ElevenLabs Music API: curl, Python 및 프롬프트 레시피로 음악 생성하기
HiAPI를 통해 elevenlabs/music-v2.5를 호출하는 실전 튜토리얼과 스타일·분위기·길이를 위한 복사 가능한 프롬프트 레시피
-

튜토리얼
HiAPI API를 통한 gpt-image-2.5-sunburst/image-to-image 사용 방법: curl과 Python
개발자를 위한 실행 가능한 요청, 참조 이미지 업로드 흐름 및 오류 문제 해결