
Tutorial
gemini-4-argon 实战场景:5 种高价值文本模型用法与实现要点
Da seleção à integração: 5 cenários para aplicar modelos de texto em negócios reais
Nesta página
Por que escolher um modelo de texto para aplicar em negócios
Antes de entrar nos cenários concretos, responda a uma pergunta mais fundamental: que tipo de tarefa deve ser entregue a este tipo de modelo? O gemini-4-argon é chamado por meio da interface compatível com Chat Completions, aceita texto e imagem na entrada, devolve texto na saída e é cobrado por token. Esse posicionamento já delimita claramente suas fronteiras de capacidade.
Tarefas adequadas a um modelo de texto
O critério é único: o produto final da tarefa é um trecho de texto ou um conjunto de dados estruturados carregado por texto. Casos típicos incluem: extrair campos de texto livre, gerar ou reescrever textos em lote, resumir e consolidar documentos longos, atribuir rótulos a requisições para roteamento e organizar respostas em linguagem natural dentro de uma conversa. O ponto comum é que a entrada é texto (podendo incluir imagens quando necessário) e a saída é texto, sem necessidade de gerar áudio ou vídeo nem de executar cálculos determinísticos; o modelo só precisa mapear a semântica da entrada para uma saída de texto conforme o esperado.
Tarefas inadequadas a um modelo de texto
Por outro lado, quando houver situações como as abaixo, deve-se trocar sem hesitar por outro tipo de modelo ou simplesmente não usar modelo: necessidade de entrada de áudio ou vídeo, necessidade de saída de voz ou vídeo, necessidade de cálculos numéricos precisos ou raciocínio lógico, e qualquer cenário que exija 100% de determinismo (como liquidação de valores, decisão de permissões). Forçar esse tipo de tarefa em um modelo de texto apenas introduz incerteza em cadeias que antes eram controláveis.
Como o modelo de cobrança afeta decisões de engenharia
O gemini-4-argon cobra por token, o que é uma restrição que se propaga até o design da arquitetura. Isso significa que a principal variável de custo é o comprimento da entrada, e não o número de chamadas. Por isso, já na fase de seleção é preciso criar dois hábitos: primeiro, tratar “o quanto a entrada pode ser encurtada” como um objetivo de design tão importante quanto “a saída é precisa ou não”; segundo, estimar separadamente, para cada cenário, o volume de entrada e saída por requisição, em vez de fazer orçamento com base no número de chamadas no chute.
A mesma família tem três modelos, com escolha conforme complexidade da tarefa e custo: gemini-4-carbon é o modelo mais forte da família Gemini 4, voltado às tarefas mais complexas, com múltiplas etapas e longa duração; gemini-4-argon é adequado à maioria dos trabalhos de engenharia de software e de conhecimento, com equilíbrio entre capacidade e custo; gemini-3.8-flash é rápido e barato, adequado a tarefas de alta concorrência e baixa latência.
O preço é cobrado em três faixas — entrada / entrada em cache / saída — em dólares por milhão de tokens. Cada modelo tem duas rotas, a padrão (nome do modelo sem sufixo) e a Vertex (nome do modelo com @vertex), com preços unitários diferentes:
gemini-4-carbon: rota padrão 1,00 / 0,05 / 5,00; rota@vertex1,64 / 0,09 / 8,20.gemini-4-argon: rota padrão 1,00 / 0,05 / 5,00; rota@vertex1,64 / 0,09 / 8,20.gemini-3.8-flash: rota padrão 0,19 / 0,02 / 0,92; rota@vertex0,62 / 0,07 / 3,08.
Delimitada essa fronteira, os 5 cenários a seguir fazem sentido — todos são formas concretas de aplicar o mesmo modelo em diferentes negócios, dentro do quadro “entrada de texto (com imagem opcional), saída de texto”, por meio de diferentes designs de estrutura de entrada e saída.
Cenário 1: de texto não estruturado a dados estruturados
Este é o cenário em que o modelo de texto traz resultados mais rápidos, mas também onde mais se erra. Tickets, e-mails, comentários de usuários e trechos de contrato são texto livre, enquanto os sistemas a jusante precisam de campos fixos. O modelo é responsável por mapear a semântica para os campos; a engenharia, por tornar esse processo estável e verificável.
Design de entrada e saída
Do lado da entrada, além do texto original, é preciso passar também a definição dos campos como parte do prompt. A definição de campo deve conter três elementos: nome do campo, tipo e faixa de valores ou enumeração. Não conte com o modelo para “adivinhar” a estrutura desejada; o contrato de campos deve ser escrito explicitamente.
Do lado da saída, exija no prompt que o modelo retorne apenas um objeto JSON e forneça um exemplo completo. Um exemplo é mais eficaz do que qualquer adjetivo — ele restringe simultaneamente a grafia das chaves, os níveis de aninhamento e a forma de representar valores nulos. Vale esclarecer que esta interface não oferece o parâmetro de saída estruturada (modo JSON); a validade do JSON depende inteiramente das restrições do prompt e da validação a jusante, motivo pelo qual é preciso preparar a validação com fallback descrita abaixo.
Restrições de formato e validação com fallback
Por melhor que o prompt seja escrito, é obrigatório assumir que o modelo pode ocasionalmente retornar JSON inválido ou campos ausentes. Na engenharia, é preciso preparar três camadas de defesa:
- Camada de análise: parsing JSON estrito; em caso de falha, entrar no ramo de nova tentativa, em vez de tentar corrigir com expressões regulares.
- Validação de schema: usar JSON Schema ou validação estrutural equivalente para conferir tipos e campos obrigatórios; valores fora do intervalo da enumeração são sempre tratados como falha.
- Contenção de negócio: quando a validação falhar, marcar o registro como “requer tratamento manual” e gravá-lo no banco, em vez de deixar campos vazios fluírem para a jusante.
Estratégia de nova tentativa
Não reenvie a mesma requisição sem alterações. Acrescentar a mensagem de erro da validação ao prompt, por exemplo “o valor high do campo priority não está na enumeração permitida; escolha entre low/medium/high”, aumenta bastante a taxa de sucesso na segunda tentativa. Ao mesmo tempo, defina um limite máximo de tentativas e, ao ultrapassá-lo, encaminhe para atendimento humano, evitando gasto desnecessário de tokens em um único registro.
Cenário 2: geração e reescrita de conteúdo em lote
Textos de marketing, descrições de produtos e modelos de e-mail têm como características alta concorrência, baixo valor por item e forte exigência de consistência de estilo. O conflito central aqui é: produzir em lote, mas sem parecer gerado em lote.
Prompt com template é a fonte da consistência de estilo
Divida o prompt em duas partes: “template fixo + slots de variáveis”. No template fixo, escreva papel, tom, intervalo de comprimento, palavras proibidas e formato de saída; nos slots de variáveis, coloque apenas o material concreto a gerar nesta chamada, como nome do produto, argumentos de venda e público-alvo. O valor disso é que as restrições de estilo são escritas uma vez e reutilizadas inúmeras vezes, e, quando for necessário ajustar o estilo, altera-se um único ponto, sem risco de deriva entre prompts.
Controlar o comprimento de uma única entrada
Cobrar por token significa que, em cenários de lote, o custo é quase totalmente determinado pela entrada. Três práticas diretas e eficazes:
- Colocar apenas informações necessárias nos slots de variáveis. Na descrição de produto não é preciso inserir o dossiê inteiro; selecione de três a cinco atributos-chave.
- Manter apenas um exemplo. Exemplos few-shot ajudam no estilo, mas cada exemplo adicional acrescenta um custo fixo de entrada; por padrão, um já basta.
- Não repetir no prompt informações que o sistema já conhece. Restrições já fixadas no template não devem ser repetidas em cada variável.
Etapa de verificação de consistência
Após a geração em lote, acrescente uma verificação leve: validar as regras da saída (se o comprimento está no intervalo, se há palavras proibidas, se contém informações obrigatórias) e enviar os itens reprovados para a fila de regeneração. Essa verificação não consome cota do modelo, mas barra a maioria dos resultados claramente desviantes; é o controle de qualidade com melhor custo-benefício em cenários de lote.
Cenário 3: resumo de textos longos e consolidação de múltiplos documentos
Entradas longas são o buraco negro de custo deste cenário. Para um mesmo material, estratégias de divisão diferentes podem gerar consumo de tokens várias vezes maior e fidelidade de informação claramente distinta.
Primeiro avalie se é possível não dividir em blocos
Se o comprimento do texto original estiver dentro do aceitável para uma única requisição, resumir o texto inteiro costuma dar resultado melhor do que dividir e depois consolidar, porque o modelo consegue ver o contexto completo. Só introduza a divisão em blocos quando de fato ultrapassar a capacidade de uma única chamada. Essa decisão deve ser tomada explicitamente no código, e não seguir sempre o fluxo de divisão. O limite de contexto desta interface é de 1.048.576 tokens; na maioria dos casos, um único material pode ser enviado inteiro.
A estratégia de divisão determina custo e fidelidade
Quando for necessário dividir, siga dois princípios:
- Dividir por fronteiras semânticas, não por contagem fixa de caracteres. Priorize quebras em parágrafos, títulos e capítulos, evitando cortar uma frase ao meio — a perda de informação no ponto de corte geralmente não é recuperável na etapa de consolidação.
- Manter pequena sobreposição entre blocos. Uma pequena sobreposição de texto entre blocos adjacentes alivia problemas de referência entre blocos e de conclusões truncadas, ao custo de alguns tokens repetidos, o que geralmente vale a pena.
Design hierárquico do resumo consolidado
Não empilhe os resumos dos blocos e concatene tudo de uma vez; faça consolidação hierárquica: primeiro gere um resumo por bloco, depois una os resumos de bloco na ordem do documento original em uma camada intermediária e, por fim, gere o resumo geral. A hierarquia não deve ser profunda demais; duas a três camadas são suficientes; cada camada adicional consome mais uma rodada de tokens e perde mais uma vez detalhes na compressão de informação.
Tratamento especial para consolidação de múltiplos documentos
No cenário com múltiplos documentos, além do resumo, normalmente também são necessárias informações comparativas como “semelhanças/diferenças”. A abordagem é exigir explicitamente no prompt de consolidação que a saída seja organizada por tema, e não por documento — se cada documento for recontado individualmente, o resultado vira um monte de parágrafos desconexos e perde o sentido da consolidação.
Cenário 4: classificação de texto e roteamento de requisições
Em muitos sistemas, o papel mais adequado do modelo de texto não é gerar conteúdo, mas atuar como um “roteador semântico”: identificar a qual categoria pertence a requisição e encaminhá-la ao fluxo especializado a jusante.
Conjunto fixo de rótulos é premissa de estabilidade
O espaço de saída de uma tarefa de classificação deve ser um conjunto de rótulos fechado e previamente definido. Não use perguntas abertas (“a que tipo isto pertence?”); inclua os rótulos candidatos no prompt junto com uma definição de uma frase para cada um e exija que o modelo retorne apenas o rótulo em si. Perguntas abertas geram infinitos rótulos inventados, impossíveis de rotear a jusante.
Ao mesmo tempo, reserve um rótulo unknown. No tráfego real sempre haverá requisições fora do conjunto de rótulos; dar ao modelo uma saída para “não classificável” é mais controlável do que forçá-lo a escolher o rótulo mais próximo.
Escolha do nível de intensidade de raciocínio
Classificação é uma das tarefas de texto com maior exigência de determinismo. Use reasoning_effort para controlar a intensidade de raciocínio (opções low / medium / high); o nível concreto deve ser escolhido com base na avaliação da tarefa real, sem aplicar um nível padrão por hábito. No prompt, exija “retorne apenas o nome do rótulo, sem explicação”. Após a saída, faça uma validação contra a lista permitida; resultados fora do conjunto de rótulos vão diretamente para unknown ou para atendimento humano.
Contrato a jusante após o roteamento
A classificação só resolve a questão “para onde ir”; o roteamento em si também precisa definir claramente: se requisições de baixa confiança ou unknown vão para o canal padrão ou para a fila humana; como o serviço a jusante monta os parâmetros após receber o rótulo. Escreva isso no contrato da interface, em vez de espalhar pela lógica de negócio; assim, ao adicionar rótulos ou ajustar regras de roteamento no futuro, a área de mudança será muito menor.
Cenário 5: perguntas e respostas conversacionais voltadas ao usuário
Este é o único cenário que atende diretamente o usuário final e, por isso, o menos tolerante a falhas. O usuário não se importa com a incerteza do modelo; ele só lembra de uma resposta que não correspondeu à pergunta.
Como organizar o contexto
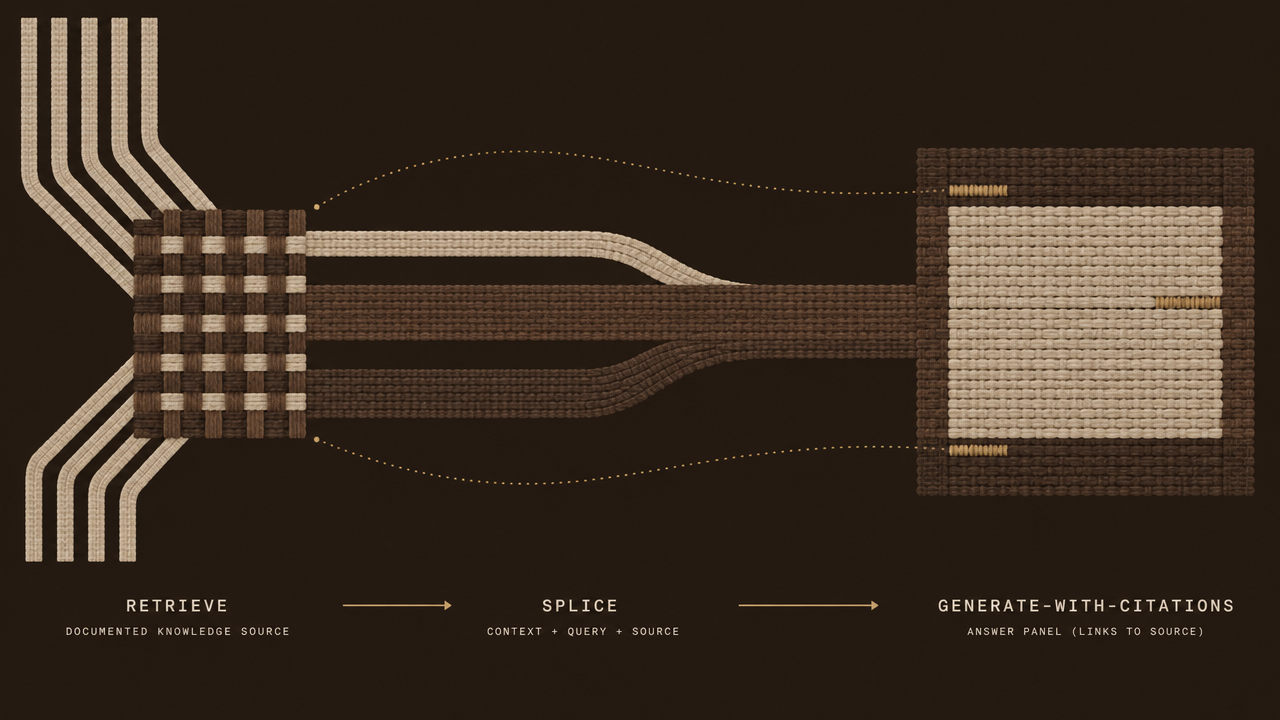
A entrada de um cenário conversacional normalmente tem três partes: instrução de sistema, trechos de conhecimento recuperados ou predefinidos e a pergunta do usuário na rodada atual. Na engenharia, é preciso respeitar duas linhas: primeiro, incluir apenas trechos de conhecimento relevantes à pergunta atual; conteúdo irrelevante não só desperdiça tokens como interfere na resposta; segundo, manter um número limitado de rodadas do histórico da conversa; quanto mais rodadas, maior a entrada, e, acima do comprimento necessário, o ganho cai rapidamente. Além disso, esta interface não oferece busca na internet; todo material precisa ser recuperado pelo lado do negócio e injetado junto com a requisição.
Limitar o escopo da resposta
Na instrução de sistema, escreva claramente: responda apenas com base no material fornecido; não invente informações que não estejam no material; quando não puder responder, use uma frase padrão de fallback. A frase de fallback deve ser previamente escrita e testada, e não improvisada pelo modelo — recusas improvisadas costumam ser prolixas e incontroláveis.
Fallback e transferência para atendimento humano
Mesmo que o modelo julgue ter confiança, é preciso projetar uma saída para “não consigo responder”. Práticas comuns: quando o modelo indicar explicitamente que a base é insuficiente na resposta, o front-end exibe a entrada para atendimento humano; quando várias rodadas consecutivas não resolverem o problema, disparar proativamente a transferência para humano. Encerre a incerteza no lado do sistema, em vez de expô-la ao usuário.
Perspectiva de custo
Conversa é o cenário que consome tokens acumulados mais rápido, porque cada rodada carrega o histórico. As formas de controle são resumir/compactar o histórico ou manter apenas as últimas rodadas, além de limpar o contexto quando a sessão estiver ociosa. Essa é uma decisão conjunta de produto e engenharia e deve ser definida já na fase de design.
Pontos de integração: custo de token, latência e novas tentativas em falhas
Reúna os problemas de engenharia comuns aos 5 cenários anteriores em uma lista pronta para uso. Primeiro, deixe clara a forma da interface:
- Chamada: interface compatível com Chat Completions,
POST https://api.hiapi.ai/v1/chat/completions, base_urlhttps://api.hiapi.ai/v1, com suporte a saída em streaming. - Rotas: cada modelo tem rota padrão (nome do modelo sem sufixo) e rota Vertex (nome do modelo com
@vertex, comogemini-4-carbon@vertex); as duas rotas têm preços unitários diferentes, escolha conforme a necessidade. - Entrada e saída: entrada aceita texto e imagem, saída é texto; contexto de 1.048.576 tokens, saída máxima de 65.536 tokens por chamada.
- Intensidade de raciocínio: controlada por
reasoning_effort, com opçõeslow/medium/high. - Limites de capacidade: sem suporte a chamada de ferramentas / function calling, busca na internet, computer use, saída estruturada / modo JSON; esses recursos precisam ser implementados no lado do negócio com restrições de prompt e cadeia própria.
Método de estimativa de custo
Para modelos cobrados por token, a estimativa de custo deve se basear no número de tokens de entrada e saída por requisição, multiplicado pelo volume de negócio e pelo preço unitário da rota correspondente. O procedimento é: preparar três amostras representativas para cada cenário (curta, média e longa), medir separadamente os volumes de entrada e saída e usar a média ponderada como linha de base de custo por chamada. Os preços unitários seguem a tabela acima; há diferenças claras entre modelos e rotas, e a estimativa deve usar a combinação efetivamente escolhida.
Técnicas de enxugamento da entrada
- Remova do prompt frases que repetem a mesma restrição; basta dizer uma vez.
- Por padrão, use um exemplo few-shot; acrescente mais apenas se realmente necessário, e cada acréscimo deve ter suporte de avaliação.
- Para textos longos, faça primeiro corte estrutural (pegar só seções relevantes) e depois resumir.
- No cenário conversacional, compacte ou trunque o histórico; não acumule sem limite.
Timeout e novas tentativas
- Defina um limite explícito de timeout para cada chamada; ao estourar, é falha, sem espera infinita.
- Use backoff exponencial nas novas tentativas e defina um limite total de tentativas.
- Inclua na nova tentativa a mensagem de erro anterior (motivo da falha de parsing, campos que não passaram na validação) para aumentar a taxa de sucesso.
- Design idempotente: chamadas repetidas para o mesmo dado de negócio não devem gerar efeitos colaterais duplicados.
Estratégia de degradação
Cada cenário deve responder à pergunta “o que fazer quando o modelo estiver indisponível”. Extração estruturada pode degradar para fila manual; geração de conteúdo, para template predefinido; classificação, para canal padrão; perguntas e respostas, para atendimento humano. O caminho de degradação deve ser implementado e testado já na fase de desenvolvimento, e não montado às pressas durante uma falha.
Aceitação e iteração: como saber se o cenário realmente funciona
A maior armadilha da integração de modelos é colocar em produção só porque “a demonstração parece boa”. A aceitação deve responder a uma pergunta: o desempenho deste cenário no tráfego real é aceitável, e conseguimos detectar a tempo quando piorar?
Conjunto de avaliação com pequena amostra
Crie um conjunto de avaliação separado para cada cenário; não precisa ser grande, mas deve cobrir entradas típicas e entradas de fronteira. O conjunto de avaliação de extração estruturada deve incluir amostras com campos faltantes, campos extras e formato confuso; o de classificação deve incluir amostras ambíguas e completamente irrelevantes; o de perguntas e respostas deve incluir perguntas sem resposta no material. O conjunto de avaliação é um ativo do cenário; ele deve ser executado a cada alteração do prompt.
Proporção de inspeção manual por amostragem
Métricas automatizadas só cobrem a parte verificável (validade do JSON, validade de rótulos, restrição de comprimento); a qualidade semântica ainda depende de pessoas. A proporção de inspeção deve ser definida pelo risco do cenário: perguntas e respostas voltadas ao usuário e geração de conteúdo externo devem ter proporção maior; roteamento interno e resumos internos podem ter proporção menor. Os resultados da inspeção devem voltar para o conjunto de avaliação, incluindo os exemplos ruins encontrados.
Métricas de monitoramento em produção
Acompanhe ao menos quatro tipos de métricas: taxa de sucesso de chamadas e taxa de novas tentativas; taxa de falha de parsing e validação; média de tokens de entrada e saída por requisição; e taxa de acionamento de degradação e transferência para humano. As duas primeiras refletem estabilidade, a terceira reflete se o custo saiu de controle, e a quarta reflete a usabilidade real. Qualquer mudança de tendência em uma delas deve acionar revisão do prompt ou do fluxo.
Ritmo de iteração
O mesmo modelo pode ser reutilizado em vários cenários, mas prompt e conjunto de avaliação devem ser mantidos separadamente por cenário. Não tente resolver todos os negócios com um único prompt — as diferenças de estrutura de entrada entre cenários são justamente o valor de todo o trabalho de design anterior. Itere cada cenário como um pequeno produto independente: só quando os critérios de aceitação estiverem claros e o caminho de fallback estiver funcionando é que se pode dizer que se foi de “escolher o modelo” para “usar o modelo”.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar o kimi-k3.1-pro pela API do HiAPI: curl, Python e requisições prontas para executar
Um guia prático de integração que cobre endpoint, parâmetros de requisição, streaming, chamadas de ferramentas e solução de erros
-

Tutorial
API ElevenLabs Music no HiAPI: gerar música com curl, Python e receitas de prompts
Um tutorial prático para chamar elevenlabs/music-v2.5 através do HiAPI, com receitas de prompts prontas para copiar para estilo, humor e duração
-

Tutorial
Como usar gpt-image-2.5-sunburst/image-to-image com a API HiAPI: curl e Python
Requisições executáveis para desenvolvedores, fluxo de envio de imagem de referência e solução de erros