
Руководство по использованию
Действительно ли рендеринг текста в GPT Image 2 безупречен? Мы провели стресс-тест вывесок, постеров и этикеток
24 генерации с высокой текстовой нагрузкой за одну сессию работы с изображениями — заголовки, CJK-каллиграфия, встроенные этикетки, цифры, плотные инфографики — вот что мы измерили
Функция, которая сделала GPT Image 2 громким релизом, — это рендеринг текста. Большинство моделей изображений до сих пор выдают абракадабру или полуформированные глифы, когда их просят отрисовать типографику. GPT Image 2 должен был отличаться — чистое написание, точный кернинг, встроенные в изображение подписи без постобработки.
Спустя шесть недель и сотни генераций у нас достаточно данных, чтобы конкретно сказать, что выдерживает проверку, а что нет. Хорошая новость: основной рекламный тезис правдив. Более глубокая новость скрыта в пограничных случаях и производственных режимах отказа, о которых не упоминали в релизных демонстрациях.
Настройка теста
В процессе создания этого контент-кластера — шесть статей, десятки иллюстраций — мы намеренно прогнали через GPT Image 2 24 генерации с высокой текстовой нагрузкой. Каждая — одна генерация на промпт, без отбора. Категории задач следующие:
- Английские заголовки и подзаголовки — промо-постеры, брендовые баннеры, обложки для соцсетей
- CJK-каллиграфия — китайские и японские постеры чайной церемонии, дизайн фирменного стиля
- Многострочная инфографика — нумерованные списки шагов, диаграммы с подписями, в стиле научного постера
- Встроенные брендовые блоки — небольшие слоганы основателей, значки года "EST.", монограммы
- Цифры, валюты, спецсимволы — ценовые бейджи, годы, проценты
- UI-макеты — экраны интерфейсов с множеством отдельных текстовых строк
Ниже — выявленные нами закономерности, в порядке от "очевидно работает" до "требует внимания".
Что работает: английские заголовки
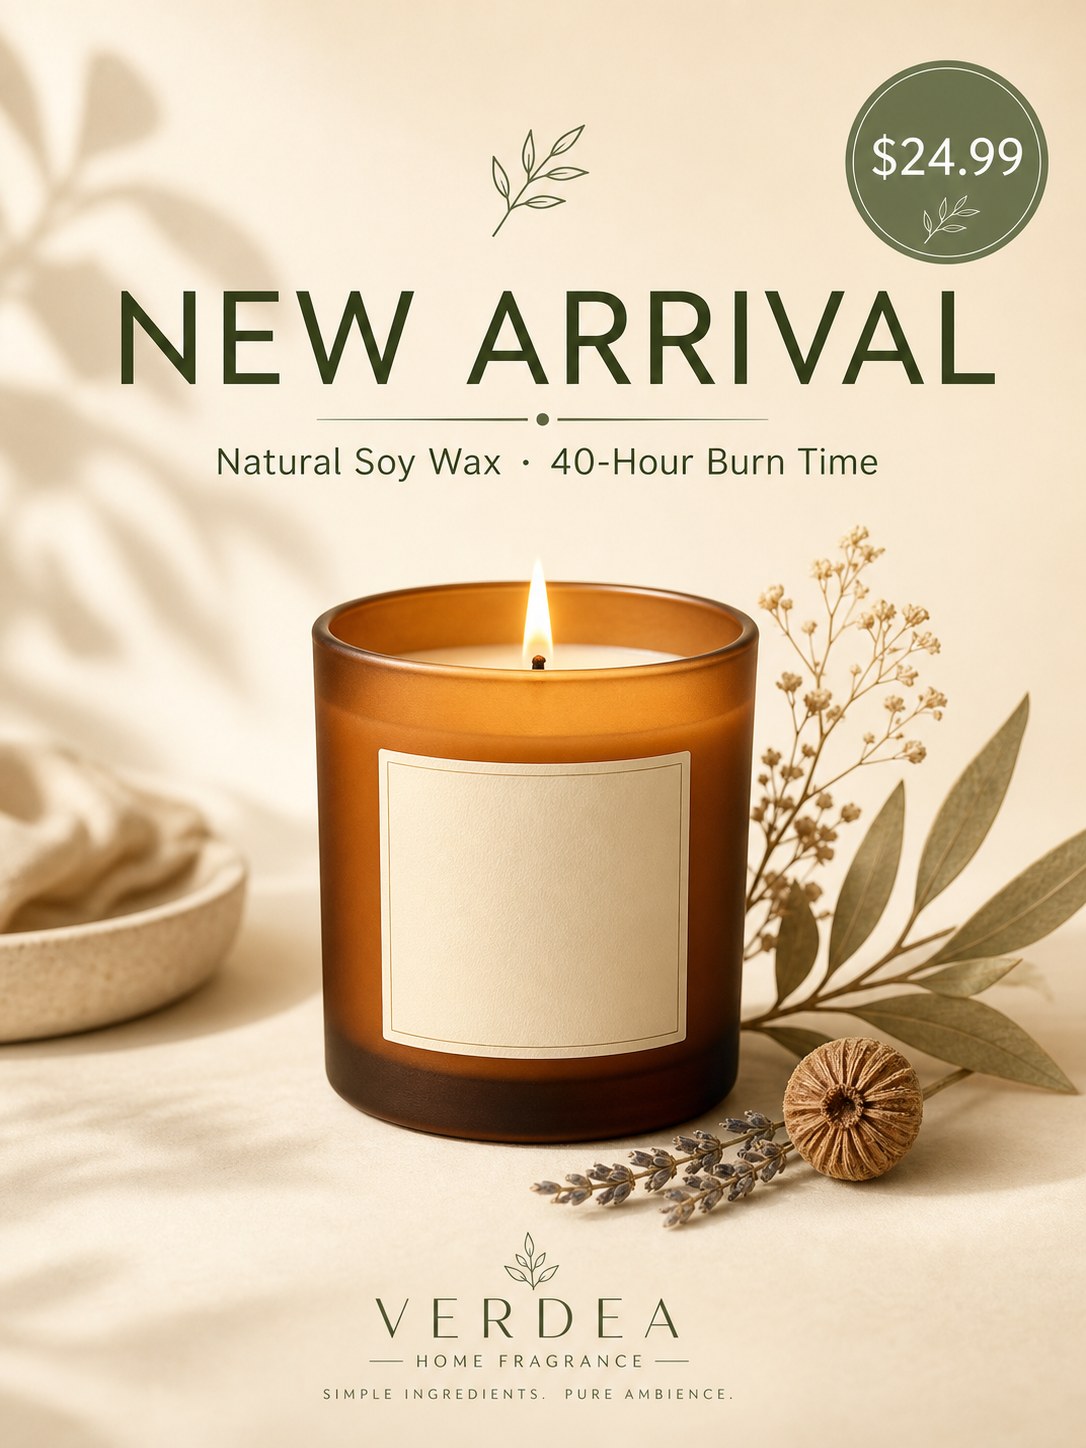
Жирные типографические заголовки отрисовались правильно в каждом протестированном случае. Постер выше содержит пять отдельных текстовых строк: основной заголовок (NEW ARRIVAL), подзаголовок (Natural Soy Wax · 40-Hour Burn Time), ценовой бейдж ($24.99), брендовый знак (VERDEA / HOME FRAGRANCE) и небольшой слоган (SIMPLE INGREDIENTS. PURE AMBIENCE.). Каждый написан правильно, с подходящим кернингом и в правильном иерархическом размере.
Средняя точка (·) между "Natural Soy Wax" и "40-Hour Burn Time" отрисована правильно. Символ валюты расположен верно. Перенос строки в брендовом знаке сохранён.
Это работает со всеми шрифтами — с засечками, без засечек, полузасечками, акцидентными и декоративными начертаниями, все отрисовываются с подходящими глифами. Модель выбирает подходящий шрифт по визуальному контексту (без засечек для современных постеров, с засечками для редакционных, рукописный для каллиграфии) без необходимости явно указывать шрифт.
Многословный цветовой акцент
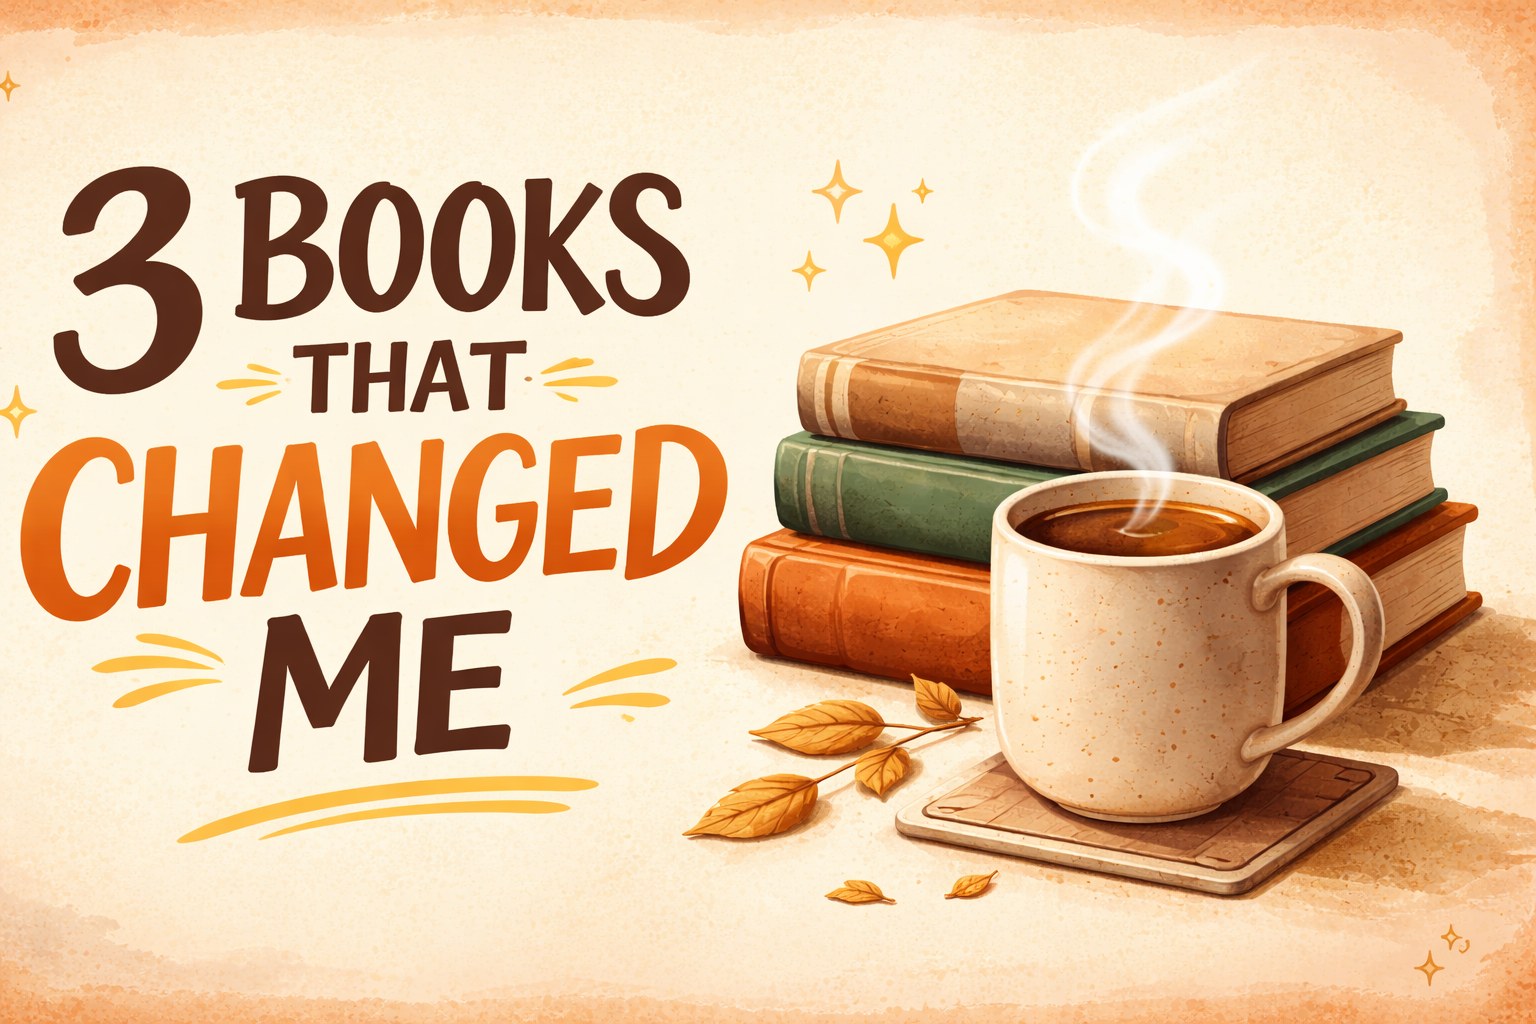
Когда вы указываете, что определённое слово должно быть выделено акцентным цветом (здесь "CHANGED" тёпло-оранжевый на фоне окружающего тёмно-коричневого), модель следует этому требованию. Акцентный цвет точно применяется к целевому слову, выбор цвета соответствует промпту, а окружающая типографика остаётся единообразной.
Что работает: CJK-каллиграфия
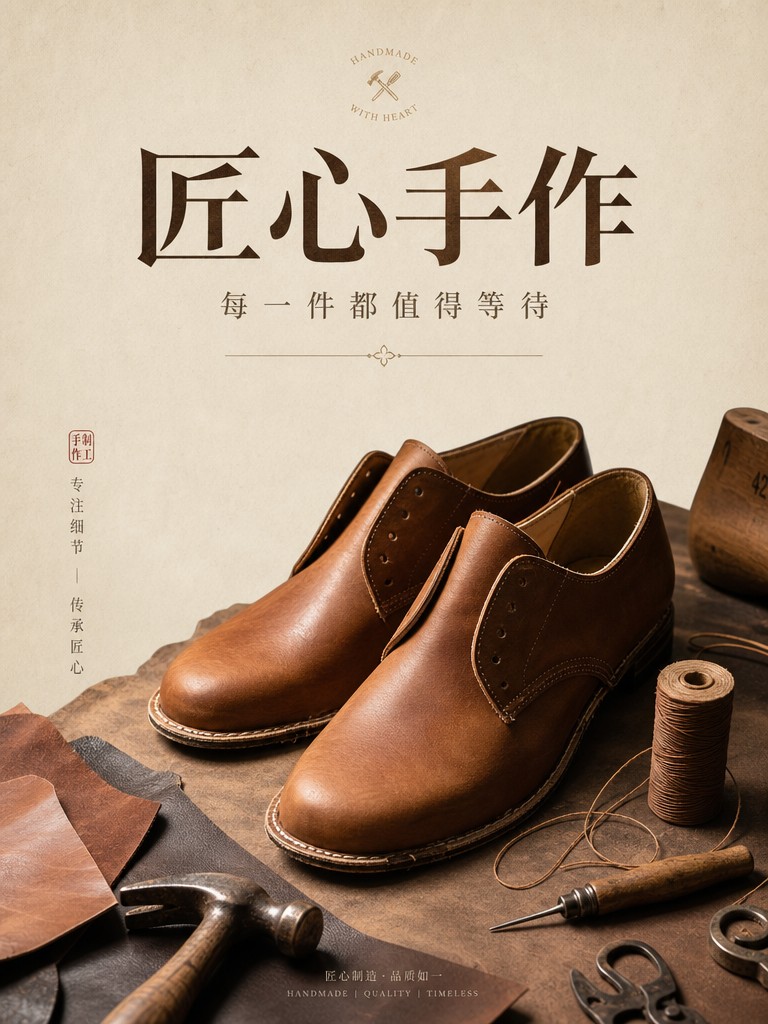
Китайская и японская каллиграфия — то, где большинство моделей изображений по-прежнему плохи. GPT Image 2 умеет отрисовывать символы в стилях кайшу, синшу и мазковыми стилями с правильным порядком черт, пропорциями знаков и фактурой туши. Постер выше, созданный для ремесленного бренда, использует китайский полузасечный шрифт с точными штрихами и хорошей структурой.
В нашем сравнении с Nano Banana 2 GPT Image 2 также правильно отрисовал заголовок «新春・茶道» и вертикальный подзаголовок «京都・春茶会 二〇二六年三月» — и добавил две уместные японские идиомы чайной церемонии (一期一会, 和敬清寂), которые мы не просили, но которые украсили дизайн.
Латиница и CJK-текст могут появляться на одном изображении. Смешанные китайско-английские заголовки (частые в двуязычном маркетинге) отрисовываются правильно, без проникновения символов или смещения пропорций.
Что работает: плотность множества строк
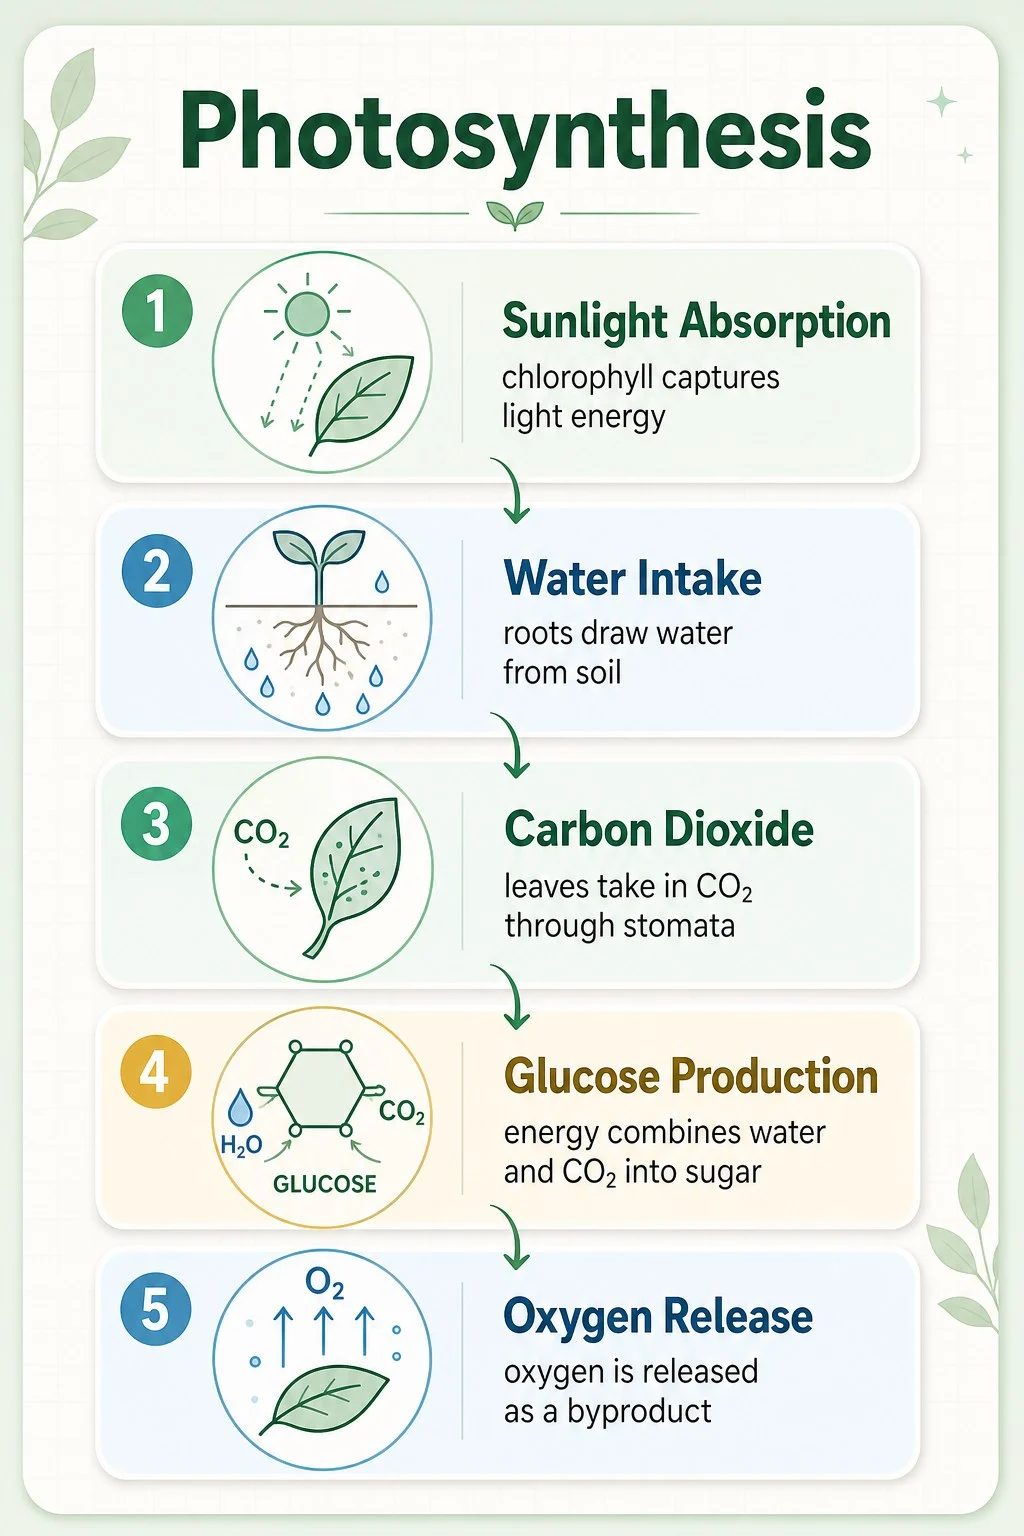
Это самый плотный текстовый тест, который мы запускали. Эта инфографика содержит:
- Заголовок (
Photosynthesis) - Пять пронумерованных заголовков шагов (
Sunlight Absorption,Water Intake,Carbon Dioxide,Glucose Production,Oxygen Release) - Пять кратких пояснений (по 8–12 слов каждое)
- Пять иконок с микроподписями
- Химические символы (
H₂O,CO₂,O₂,GLUCOSE)
Каждая текстовая строка отрисована правильно. Иерархия сохранена — заголовок жирнее, пояснения легче, микроподписи соответствующим образом мельче. Нумерованная последовательность (от 1 до 5) в правильном порядке. Стрелки потока соединяют правильные шаги.
Примечание: химические символы (H₂O, CO₂, O₂, GLUCOSE) модель добавила сама, без запроса. Она вывела тему и добавила соответствующие детали. Это повторяющееся поведение GPT Image 2 — чаще всего полезное, но его стоит учитывать, когда оно вам не нужно.
Что работает: цифры, валюты, спецсимволы
В тестовом наборе из 24 генераций:
- Символы валют корректно отрисованы для
$,¥(китайский кластер) и в контексте кавычек - Многозначные цены (
$24.99,$29,¥129) сохранили десятичные точки и запятые - Даты (
Tuesday, March 4) сохранили запятые и порядок слов - Временные строки (
9:41) отрисованы с правильным двоеточием - Тире (
—) и средняя точка (·) корректно отрисованы при включении в промпт как литеральные символы - Значки года (
EST. 2024,2026) сохранили точку и точность четырёх цифр
Закономерность: если вы включаете в промпт (в прямых кавычках) именно тот символ, который хотите, GPT Image 2 верно его воспроизводит. Типографские кавычки в промпте ("/") дают типографские кавычки в выводе. Прямые кавычки (") дают прямые кавычки. Модель точна в отношении символов — это значит, что вы должны осознанно выбирать символы, которые пишете.
Что работает: встроенные брендовые блоки
Самые интересные нежелательные добавления — это когда модель добавляла небольшие брендовые тексты, которых не было в промпте:
- На постер изделий из кожи добавились "CRAFTED TO LAST · EST. 2024" и монограмма "H | C"
- На постер запуска свечи внизу добавился блок "VERDEA / HOME FRAGRANCE / SIMPLE INGREDIENTS. PURE AMBIENCE."
- На этикетку продукта добавилось "BOIS DE SANTAL" как спецификация аромата
Это небольшие текстовые элементы, соответствующие языку дизайна окружающего изображения. В каждом случае написание и типографика правильные. Модель настолько хороша в этом, что такие добавления обычно улучшают вывод — но если вам нужен строгий контроль, добавьте явное условие no additional text or brand marks.
Подробнее об этом контекстном добавлении см. в нашем честном обзоре GPT Image 2.
Режимы отказа (тот 1%)
В наших 24 намеренно текст-насыщенных тестовых генерациях основные текстовые строки отрисовались правильно в 100% случаев. Это результат контролируемого теста. Честная производственная цифра ближе к 99%, потому что как только вы начинаете масштабировать, всплывают пограничные случаи:
1. Замена одного символа в мелком тексте
Самый частый отказ — не полная абракадабра, а изменение одного символа. "Burn" отрисовался как "Bum" в очень мелких подписях. В "Hours" не хватало одной R. Месяцы ("September") иногда с неправильным порядком букв в середине. Такое ускользает от периферийного зрения, и если вы не вычитываете при 100% масштабе, это уходит в продакшн.
Когда это происходит, повторная генерация по тому же промпту почти всегда исправляет (проблема в случайности сэмплирования, а не в структуре промпта).
2. Крошечный текст ниже 12pt
GPT Image 2 гораздо стабильнее предыдущих моделей на малых размерах — но есть порог, ниже которого глифы начинают размываться. Для питательных сведений на винных этикетках, предупреждений на медицинских этикетках или любого контента, который должен быть чётко читаемым при эквиваленте 8–10pt, ожидайте одну-две повторные генерации. Повышение запрашиваемого разрешения с 1K до 2K помогает — ценовая надбавка 33%, но улучшение читаемости мелкого текста реально.
3. Замена типографских кавычек
Если в вашем промпте есть типографские кавычки ("/", '/'), а вы хотите прямые кавычки в выводе (", '), модель верно отрисует типографские. Это не режим отказа модели — это проблема подготовки промпта. Если прямые кавычки важны, очистите промпт перед отправкой.
4. Нежелательные добавления в строгом контексте
В контекстах "без текста, без логотипов, без беспорядка" (чистые каталожные фото продукта) модель надёжна. В более свободных контекстах (лайфстайл, промо, редакционные) она иногда добавляет незапрошенные брендовые монограммы, бейджи или вспомогательный текст. Там, где нужен строгий контроль, добавляйте явные отрицательные условия.
Чек-лист вычитки для продакшна
После этих 24 текст-насыщенных генераций в тестовом наборе и многих других в продакшне, вот чек-лист, который мы используем перед сдачей любого изображения с отрисованным текстом:
- Открывайте при 100% масштабе или больше. Браузерные миниатюры и окна предпросмотра редакторов скрывают замены отдельных символов. Всегда смотрите на реальные отрисованные пиксели.
- Читайте вслух каждую текстовую строку или обводите по символам. Просмотр по диагонали — причина утечки опечаток. Обводите каждую букву, каждую цифру, каждый знак препинания.
- Сначала проверяйте самый мелкий текст. Отказы в заголовках видны невооружённым глазом. Подписи ниже 12pt проваливаются незаметно, пока клиент не сообщит об ошибке.
- При обнаружении ошибки перегенерируйте тот же промпт. Не пытайтесь редактировать изображение вручную — повторная генерация почти всегда дешевле, быстрее и визуально ближе к замыслу.
- Для масштабного текст-насыщенного вывода запрашивайте разрешение 2K. Для любого текста меньше выставочного размера надбавка 33% к стоимости оправдана читаемостью.
Этап вычитки занимает 30–60 секунд на изображение. Пропуск его — именно то, что порождает истории об "опечатках, сгенерированных ИИ, в сданных маркетинговых материалах", которые подрывают общее доверие к работе с ИИ-изображениями.
Когда выбирать GPT Image 2 для работы с текстом
Для любой работы с текст-насыщенными изображениями, где точность критична, GPT Image 2 — правильный выбор:
- Промо-постеры и баннеры — см. готовые шаблоны промптов для примеров, готовых к продакшну
- Карточки товаров на маркетплейсах с брендовыми этикетками — см. полный рабочий процесс для e-commerce изображений
- Многоязычный маркетинг — CJK-каллиграфия, постеры со смешанными языками
- Инфографика, научные постеры, диаграммы с подписями — плотность множества строк выдерживает проверку
- UI-макеты с реальным текстом интерфейса — см. тест текста на уровне экрана в сравнении с Nano Banana 2
При $0.03 за изображение в разрешении 1K стоимость позволяет вычитывать и перегенерировать по мере необходимости без беспокойства о бюджете. Реальная статья расходов — время (около 90–120 секунд на генерацию).
Честный взгляд на то, в чём GPT Image 2 выигрывает, а в чём нет, см. в нашем практическом обзоре.
Частые вопросы
Достаточно ли надёжен рендеринг текста в GPT Image 2 для сдачи коммерческой работы?
Да, но требуется этап вычитки. В нашем контролируемом тесте из 24 генераций основные строки отрисовались правильно в 100% случаев. В производственном масштабе эта доля падает примерно до 99% — это значит, что примерно 1 изображение из 100 будет иметь проблему с отдельным символом, требующую перегенерации. 30-секундная визуальная вычитка на изображение — это управляемый производственный показатель.
Одинаково ли точно отрисовывается китайский/японский текст по сравнению с английским?
В наших тестах — да. CJK-каллиграфия — то, где большинство моделей изображений серьёзно проваливаются. GPT Image 2 правильно отрисовывает порядок черт, пропорции знаков и фактуру туши. Распространённые китайские и японские иероглифы отрисовываются надёжно; более редкие или исторически специфические знаки (вариантные формы, классическая орфография) мы ещё не тестировали в масштабе.
А другие системы письменности — арабская, кириллическая, деванагари?
В этой сессии мы их не тестировали, поэтому не можем делать утверждений на основе доказательств. По анекдотическим данным, GPT Image 2 хорошо справляется с кириллицей и языками латинской письменности. Арабское письмо справа налево и сложные письменности с лигатурами (деванагари, тайская) — области, по которым у нас нет контролируемых тестовых данных.
Добавляет ли модель текст, который я не просил?
Иногда да. В нашем тесте из 24 генераций модель примерно в 4 случаях добавила контекстный текст (брендовые монограммы, значки EST., дополнительные строки спецификации продукта). Эти добавления всегда были написаны правильно и соответствовали дизайн-контексту. Если вам нужен строгий контроль, добавьте явное отрицательное условие no additional text.
Влияет ли запрашиваемое разрешение на рендеринг текста?
Да, особенно на мелкий текст. Разрешение 2K заметно лучше сохраняет читаемость ниже 12pt, чем 1K. Ценовая надбавка 33% — за текст-насыщенный вывод её стоит платить.
Итог
Рендеринг текста в GPT Image 2 оправдывает рекламные заявления на момент релиза. В наших 24 производственных тестовых генерациях с высокой текстовой нагрузкой — английские заголовки, CJK-каллиграфия, многострочная инфографика, встроенные брендовые блоки, валюты, спецсимволы — каждая основная строка отрисовалась правильно.
Около 1% производственных ошибок приходится на самый мелкий текст и почти всегда исправляется перегенерацией. Этап вычитки для сдачи не подлежит обсуждению. За этим исключением, это самая надёжная текстовая модель изображений, с которой мы работали — в работе, где точность текста является частью результата, качество типографики оправдывает более медленное время генерации.
Попробуйте сами текст-насыщенный промпт на странице модели GPT Image 2 — укажите несколько точных строк, задайте раскладку, запустите и вычитайте результат. Первая генерация обычно и есть та, что сдаётся в итоге.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков