
Guide d'utilisation
Le rendu de texte de GPT Image 2 est-il vraiment parfait ? Nous avons mis à l'épreuve enseignes, affiches et étiquettes
24 générations à forte densité de texte lors d'une seule session de création graphique — titres, calligraphie CJK, étiquettes intégrées, chiffres, infographies denses — voici ce que nous avons mesuré
La fonctionnalité qui a fait le succès immédiat de GPT Image 2 à son lancement, c'est le rendu de texte. La plupart des modèles d'image, lorsqu'on leur demande de rendre de la typographie, produisent encore des caractères illisibles ou à moitié formés. GPT Image 2 était censé être différent — orthographe propre, crénage précis, sous-titres intégrés à l'image sans retouche ultérieure.
Après six semaines et des centaines de générations, nous avons suffisamment de données pour dire concrètement ce qui tient la route et ce qui ne la tient pas. La bonne nouvelle : le discours marketing est vrai. La nouvelle plus profonde se cache dans les cas limites et les modes de défaillance en production dont les démos de lancement ne parlent jamais.
Configuration du test
En réalisant ce groupe de contenu — six articles, des dizaines d'illustrations — nous avons délibérément exécuté 24 générations à forte densité de texte via GPT Image 2. À chaque fois, une seule génération par prompt, sans sélection. Les catégories de tâches étaient les suivantes :
- Titres et sous-titres en anglais — affiches promotionnelles, bannières de marque, couvertures pour les réseaux sociaux
- Calligraphie CJK — affiches de cérémonie du thé en chinois et en japonais, design d'identité de marque
- Infographies multi-chaînes — listes d'étapes numérotées, graphiques avec légendes, style affiche scientifique
- Blocs de marque intégrés — petites accroches de fondateur, badges d'année « EST. », motifs de monogramme
- Chiffres, devises, caractères spéciaux — badges de prix, années, pourcentages
- Maquettes d'interface — écrans d'interface contenant de nombreuses chaînes de texte distinctes
Voici les tendances que nous avons constatées, classées de « manifestement efficace » à « à surveiller ».
Ce qui fonctionne : les titres en anglais
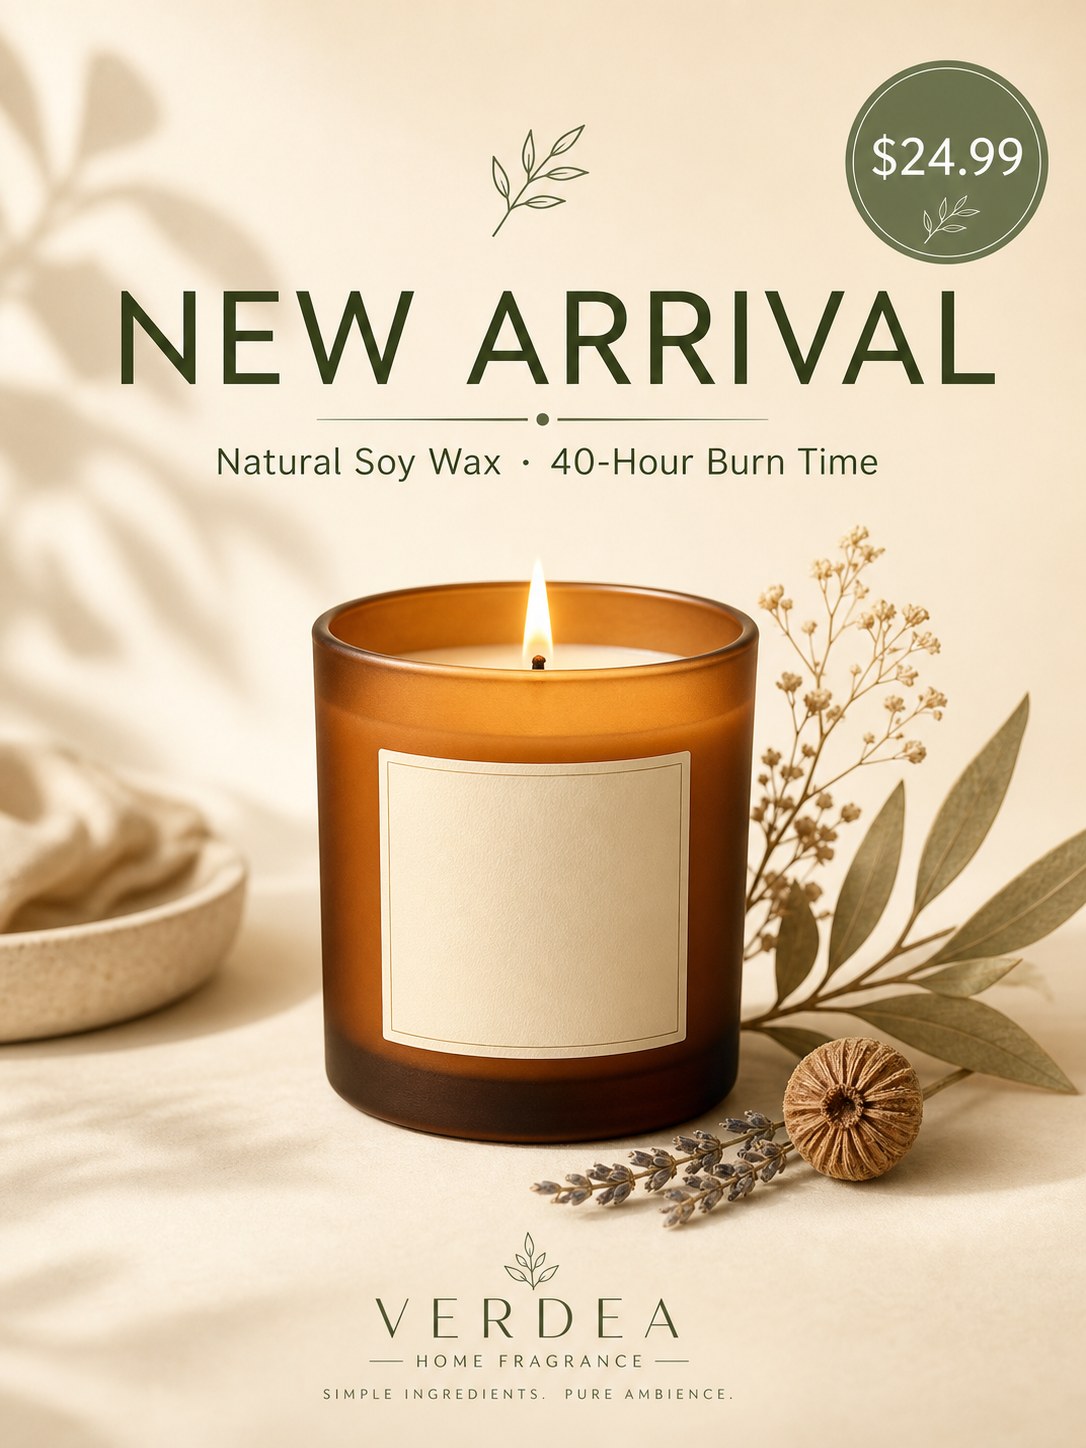
Les titres typographiques en gras se sont rendus correctement dans chaque cas que nous avons testé. L'affiche ci-dessus contient cinq chaînes de texte distinctes : le titre principal (NEW ARRIVAL), le sous-titre (Natural Soy Wax · 40-Hour Burn Time), le badge de prix ($24.99), l'identité de marque (VERDEA / HOME FRAGRANCE) et une petite accroche (SIMPLE INGREDIENTS. PURE AMBIENCE.). Chacune est correctement orthographiée, correctement crénée et présentée à la bonne taille hiérarchique.
Le point médian (·) entre « Natural Soy Wax » et « 40-Hour Burn Time » se rend correctement. Le symbole monétaire est bien positionné. Les sauts de ligne dans l'identité de marque sont préservés.
Cela fonctionne sur toutes les familles de polices — les graisses avec empattements, sans empattements, semi-empattements, d'affichage et décoratives se rendent toutes avec des glyphes appropriés. Le modèle choisit la police adaptée au contexte visuel (sans empattements pour une affiche moderne, avec empattements pour un usage éditorial, tracé au pinceau pour la calligraphie), sans que vous ayez à spécifier la police explicitement.
Accentuation colorée de plusieurs mots
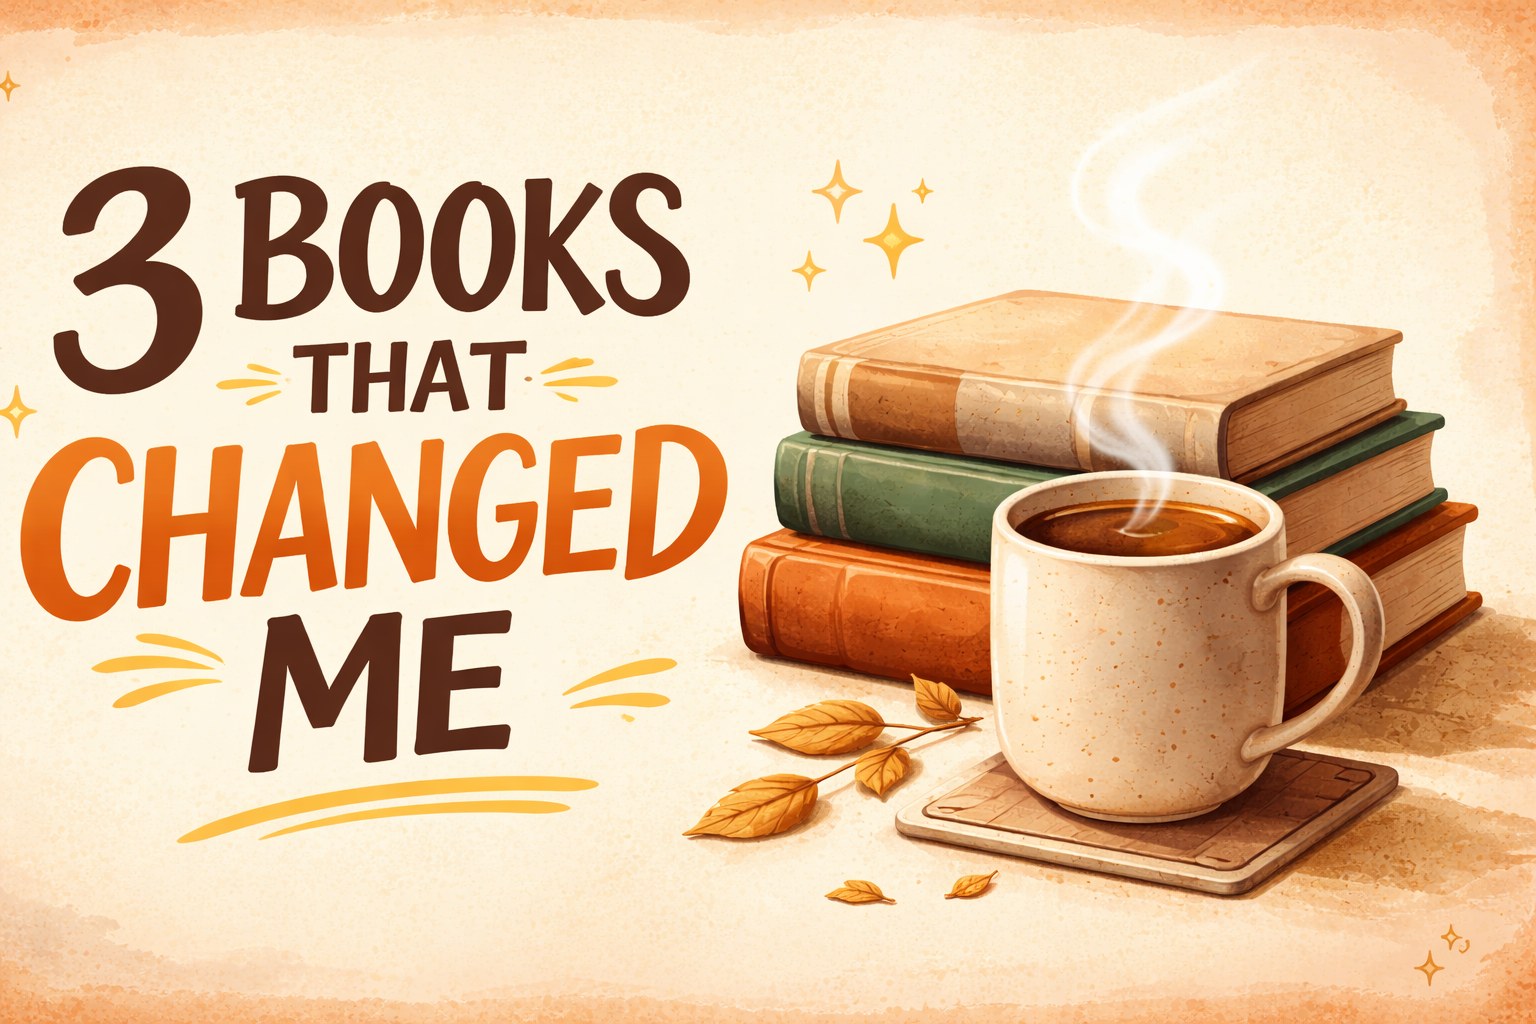
Lorsque vous précisez qu'un mot doit être dans une couleur d'accentuation (ici « CHANGED » apparaît en orange chaud sur fond brun foncé), le modèle respecte la consigne. La couleur d'accentuation s'applique précisément au mot ciblé, le choix de couleur correspond au prompt et la typographie environnante reste cohérente.
Ce qui fonctionne : la calligraphie CJK
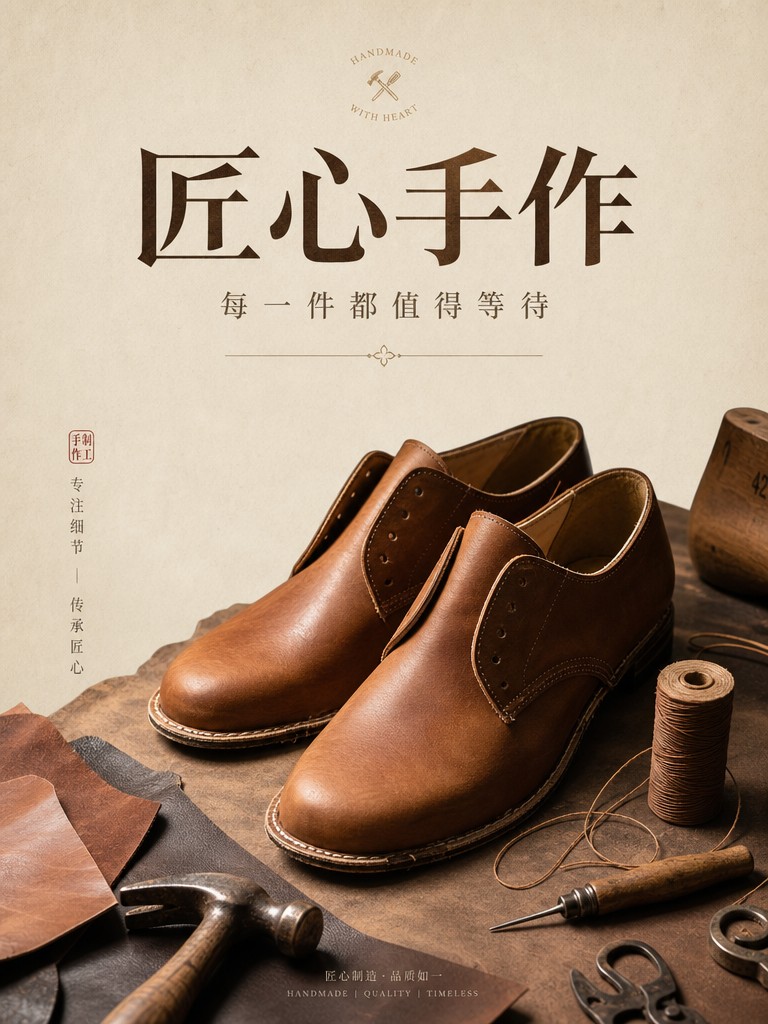
La calligraphie chinoise et japonaise est l'endroit où la plupart des modèles d'image échouent encore lamentablement. GPT Image 2 sait rendre des caractères en style régulier, en style cursif et au tracé au pinceau, avec un ordre des traits, des proportions de caractères et une texture d'encre tout à fait appropriés. L'affiche ci-dessus, réalisée pour une marque artisanale, utilise une police chinoise semi-empattée, avec des traits précis et bien structurés.
Dans notre comparaison avec Nano Banana 2, GPT Image 2 a également rendu correctement le titre « 新春・茶道 » et le sous-titre vertical « 京都・春茶会 二〇二六年三月 » — en ajoutant deux idiomes japonais de la cérémonie du thé adaptés au contexte (一期一会, 和敬清寂) que nous n'avions pas demandés, mais qui s'intégraient bien au design.
L'alphabet latin et les caractères CJK peuvent apparaître dans la même image. Les titres mixtes chinois-anglais (courants dans le marketing bilingue) se rendent correctement, sans infiltration de caractères ni décalage de proportions.
Ce qui fonctionne : la densité multi-chaînes
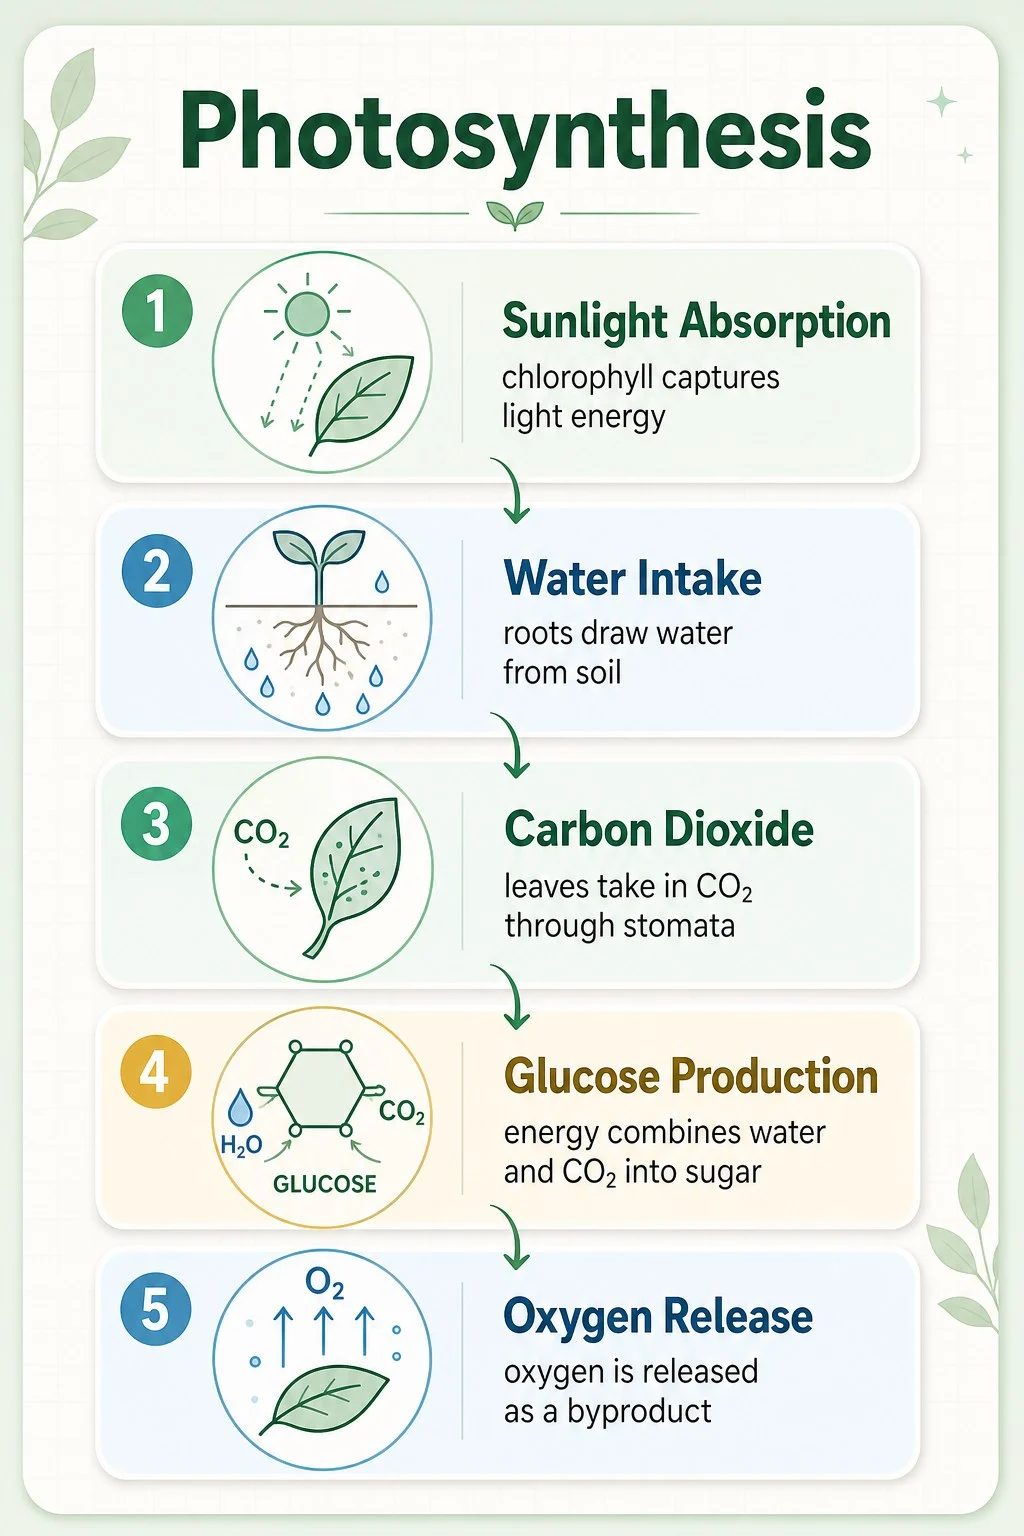
C'est le test de texte le plus dense que nous ayons exécuté. Cette infographie contient :
- un titre (
Photosynthesis) - cinq titres d'étapes numérotées (
Sunlight Absorption,Water Intake,Carbon Dioxide,Glucose Production,Oxygen Release) - cinq courtes descriptions (8 à 12 mots chacune)
- cinq icônes avec chacune une micro-étiquette
- des symboles chimiques (
H₂O,CO₂,O₂,GLUCOSE)
Chaque chaîne de texte s'est rendue correctement. La hiérarchie est préservée — graisse plus forte pour le titre, graisse plus légère pour les descriptions, taille appropriée et plus petite pour les micro-étiquettes. La séquence numérotée (de 1 à 5) est dans le bon ordre. Les flèches de flux relient les bonnes étapes.
À noter : les symboles chimiques (H₂O, CO₂, O₂, GLUCOSE) ont été ajoutés par le modèle sans qu'on le lui demande. Il a déduit le sujet et ajouté des détails pertinents. C'est un comportement récurrent de GPT Image 2 — utile la plupart du temps, mais à garder en tête quand vous n'en voulez pas.
Ce qui fonctionne : chiffres, devises, caractères spéciaux
Dans le jeu de test de 24 générations :
- les symboles monétaires se sont rendus correctement pour
$,¥(groupe chinois) ainsi que dans des contextes entre guillemets - les prix à plusieurs chiffres (
$24.99,$29,¥129) conservent la virgule décimale et les séparateurs - les dates (
Tuesday, March 4) conservent la virgule et l'ordre des mots - les chaînes horaires (
9:41) se rendent avec le bon deux-points - les tirets cadratins (
—) et les points médians (·) se rendent correctement lorsqu'ils sont inclus comme caractères littéraux dans le prompt - les badges d'année (
EST. 2024,2026) conservent le point et la précision des quatre chiffres
La règle est la suivante : si vous incluez dans le prompt (avec des guillemets droits) le caractère exact que vous voulez, GPT Image 2 le reproduit fidèlement. Les guillemets typographiques ("/") dans le prompt produisent des guillemets typographiques en sortie. Les guillemets droits (") produisent des guillemets droits. Le modèle est fidèle aux caractères — ce qui signifie que vous devez choisir délibérément les caractères que vous saisissez.
Ce qui fonctionne : les blocs de marque intégrés
Les ajouts non sollicités les plus intéressants sont venus du modèle qui a ajouté de petits textes de style marque absents du prompt :
- sur une affiche de maroquinerie, ajout de « CRAFTED TO LAST · EST. 2024 » et d'un monogramme « H | C »
- sur une affiche de lancement de bougie, ajout en bas d'un bloc « VERDEA / HOME FRAGRANCE / SIMPLE INGREDIENTS. PURE AMBIENCE. »
- sur une étiquette produit, ajout de « BOIS DE SANTAL » comme spécification olfactive
Ce sont de petits éléments textuels conformes au langage de design de l'image environnante. Dans chaque cas, l'orthographe et la typographie étaient correctes. Le modèle est suffisamment doué pour cela et ces ajouts améliorent souvent le rendu — mais si vous voulez un contrôle strict, ajoutez une clause explicite no additional text or brand marks.
Pour en savoir plus sur ce comportement d'ajout contextuel, consultez notre test pratique de GPT Image 2.
Modes de défaillance (ce 1 %)
Sur nos 24 générations de test délibérément à forte densité de texte, les chaînes de texte principales se sont rendues correctement à 100 %. C'est le résultat d'un test contrôlé. Le chiffre honnête en production est proche de 99 %, car dès qu'on passe à l'échelle, les cas limites apparaissent :
1. Substitution de caractère unique sur les petits textes
La défaillance la plus courante n'est pas un charabia complet — c'est un caractère unique modifié. Dans un très petit texte de légende, « Burn » se rend « Bum ». « Hours » perd un R. Un mois (« September ») a parfois des lettres du milieu dans le mauvais ordre. Cela échappe à la vision périphérique et passe en production si vous ne relisez pas à 100 % de zoom.
Lorsque cela se produit, une régénération avec le même prompt corrige presque toujours le problème (le problème relève du caractère aléatoire de l'échantillonnage, non de la structure du prompt).
2. Textes minuscules en dessous de 12 pt
GPT Image 2 est bien plus stable en petite taille que les modèles précédents — mais il existe un seuil en dessous duquel les glyphes commencent à s'embuer. Pour les mentions nutritionnelles d'étiquettes de vin, les avertissements d'étiquettes pharmaceutiques, ou tout contenu devant être lisible à l'équivalent de 8–10 pt, prévoyez une ou deux régénérations. Passer de la résolution 1K à 2K aide — le surcoût est de 33 %, mais le gain de lisibilité des petits caractères est réel.
3. Substitution des guillemets typographiques
Si votre prompt contient des guillemets typographiques ("/", '/') et que vous voulez des guillemets droits en sortie (", '), le modèle rendra fidèlement les guillemets typographiques. Ce n'est pas un mode de défaillance du modèle — c'est un problème de préparation du prompt. Si les guillemets droits sont importants, nettoyez le prompt avant l'envoi.
4. Ajouts non sollicités dans des contextes stricts
Pour les contextes « aucun texte, aucun logo, aucun encombrement » (photo de catalogue produit épurée), le modèle est fiable. Pour des contextes plus souples (lifestyle, promotionnel, éditorial), il ajoute parfois des monogrammes de marque, des badges ou du texte auxiliaire que vous n'avez pas demandés. Ajoutez des clauses négatives explicites là où un contrôle strict est nécessaire.
Liste de vérification pour la production
Après les 24 générations à forte densité de texte de ce jeu de test et bien d'autres en production, voici la liste de vérification que nous utilisons avant de livrer toute image contenant du texte rendu :
- Ouvrez à 100 % de zoom ou plus. Les vignettes du navigateur et les fenêtres d'aperçu des éditeurs masquent les substitutions de caractères uniques. Regardez toujours les pixels réellement rendus.
- Lisez à voix haute chaque chaîne de texte ou tracez caractère par caractère. C'est en survolant que les fautes de frappe passent. Tracez chaque lettre, chaque chiffre, chaque signe de ponctuation.
- Vérifiez d'abord le plus petit texte. Les défauts du titre sautent aux yeux. Les légendes en dessous de 12 pt échouent invisiblement jusqu'à ce que le client signale l'erreur.
- En cas d'erreur, régénérez avec le même prompt. N'essayez pas de retoucher l'image manuellement — une régénération est presque toujours moins chère, plus rapide et visuellement plus proche de votre intention.
- Pour les sorties à forte densité de texte à l'échelle, demandez la résolution 2K. Pour tout texte inférieur à la taille d'affichage, le surcoût de 33 % en vaut la peine en lisibilité.
L'étape de relecture prend 30 à 60 secondes par image. La sauter est précisément ce qui produit des histoires du type « fautes de frappe générées par IA dans des supports marketing livrés », qui nuisent à la crédibilité générale du travail d'image par IA.
Quand choisir GPT Image 2 pour le travail typographique
Pour tout travail d'image à forte densité de texte où l'exactitude est critique, GPT Image 2 est le bon choix :
- Affiches et bannières promotionnelles — voir les modèles de prompts utilisables pour des exemples directement exploitables en production
- Fiches produits e-commerce avec étiquettes de marque — voir le workflow complet d'images e-commerce
- Marketing multilingue — calligraphie CJK, affiches multilingues
- Infographies, affiches scientifiques, graphiques avec légendes — la densité multi-chaînes tient la route
- Maquettes d'interface avec du texte d'interface réel — voir les tests de texte au niveau de l'écran dans la comparaison avec Nano Banana 2
À 0,03 $ par image en résolution 1K, le coût vous permet de relire et régénérer à volonté sans vous soucier du budget. Le temps réel (environ 90 à 120 secondes par génération) est le véritable poste budgétaire.
Pour un avis honnête sur ce sur quoi GPT Image 2 excelle et ce sur quoi il échoue, consultez notre test pratique.
Questions fréquentes
Le rendu de texte de GPT Image 2 est-il suffisamment fiable pour livrer du travail commercial ?
Oui, mais une étape de relecture est nécessaire. Dans notre test contrôlé de 24 générations, les chaînes principales se sont rendues correctement à 100 %. À l'échelle de la production, ce taux descend à environ 99 % — ce qui signifie qu'environ 1 image sur 100 aura un problème de caractère unique nécessitant une régénération. Une relecture visuelle de 30 secondes par image, c'est un taux de production maîtrisable.
Le rendu du texte chinois/japonais est-il aussi précis que celui de l'anglais ?
Dans nos tests, oui. La calligraphie CJK est l'endroit où la plupart des modèles d'image échouent gravement. GPT Image 2 rend correctement l'ordre des traits, les proportions des caractères et la texture d'encre. Les caractères chinois et japonais courants se rendent de façon fiable ; les caractères plus rares ou plus spécifiques à une époque (variantes, orthographe classique) n'ont pas encore été testés à grande échelle.
Et les autres systèmes d'écriture — arabe, cyrillique, devanagari ?
Nous ne les avons pas testés dans cette session, nous ne pouvons donc pas nous prononcer sur la base de preuves. De manière anecdotique, GPT Image 2 rend bien les langues en écriture cyrillique et latine. L'arabe (écriture de droite à gauche) et les ligatures complexes des écritures (devanagari, thaï) sont des domaines pour lesquels nous n'avons pas de données de test contrôlé.
Le modèle ajoute-t-il du texte que je n'ai pas demandé ?
Parfois. Dans notre test de 24 générations, le modèle a ajouté du texte adapté au contexte dans environ 4 cas (monogrammes de marque, badges EST., lignes complémentaires de spécifications produit). Ces ajouts étaient toujours correctement orthographiés et conformes au contexte du design. Si vous avez besoin d'un contrôle strict, ajoutez une clause négative explicite no additional text.
La résolution demandée affecte-t-elle le rendu du texte ?
Oui, surtout pour les petits caractères. La résolution 2K est nettement meilleure que la 1K pour préserver la lisibilité en dessous de 12 pt. Le surcoût est de 33 % — cela vaut la peine de le payer pour les sorties à forte densité de texte.
En résumé
Le rendu de texte de GPT Image 2 est à la hauteur du battage de son lancement. Dans nos 24 générations à forte densité de texte en test de production — titres en anglais, calligraphie CJK, infographies multi-chaînes, blocs de marque intégrés, devises, caractères spéciaux — chaque chaîne principale s'est rendue correctement.
Le taux d'erreur d'environ 1 % en production apparaît sur les plus petits textes et se corrige presque toujours par régénération. L'étape de relecture est non négociable pour livrer. Au-delà de cela, c'est le modèle d'image à texte le plus fiable avec lequel nous ayons travaillé — et dans les travaux où l'exactitude du texte fait partie du livrable, la qualité typographique justifie les temps de génération plus lents.
Essayez vous-même un prompt à forte densité de texte sur la page du modèle GPT Image 2 — citez quelques chaînes exactes, spécifiez la mise en page, lancez-le et relisez le résultat. La première génération est généralement celle que vous livrerez.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax