
Guía de uso
¿Es realmente perfecta la representación de texto de GPT Image 2? Sometimos a prueba señalética, carteles y etiquetas
24 generaciones con alta densidad de texto en una sola sesión de generación de imágenes: titulares, caligrafía CJK, etiquetas integradas, números e infografías densas. Esto es lo que medimos
La función que hizo que GPT Image 2 causara sensación en su lanzamiento fue la representación de texto. La mayoría de los modelos de imagen, cuando se les pide renderizar texto tipográfico, siguen produciendo garabatos o glifos a medio formar. Se suponía que GPT Image 2 sería diferente: ortografía limpia, espaciado entre letras preciso, subtítulos integrados en la imagen sin necesidad de corrección posterior.
Después de seis semanas y cientos de generaciones, tenemos datos suficientes para precisar qué resiste y qué no. La buena noticia: la promesa principal es cierta. La noticia más profunda está en los casos límite y en los modos de fallo en producción que las demos de lanzamiento no mencionaron.
Configuración de la prueba
Mientras elaborábamos este clúster de contenido —seis artículos, decenas de imágenes de acompañamiento— ejecutamos deliberadamente 24 generaciones con alta densidad de texto a través de GPT Image 2. En cada caso, una sola generación por prompt, sin selección. Las categorías de tarea fueron las siguientes:
- Titulares y subtítulos en inglés: carteles promocionales, banners de marca, portadas para redes sociales
- Caligrafía CJK: carteles de ceremonia del té en chino y japonés, diseño de identidad de marca
- Infografías con múltiples cadenas de texto: listas de pasos numerados, gráficos con leyendas, estilo de cartel científico
- Bloques de marca integrados: lemas pequeños de fundadores, insignias de año "EST.", monogramas
- Números, monedas, caracteres especiales: insignias de precio, años, porcentajes
- Mockups de UI: pantallas de interfaz que contienen muchas cadenas de texto independientes
Estos son los patrones que encontramos, ordenados de "funciona claramente" a "requiere precaución".
Lo que funciona: titulares en inglés
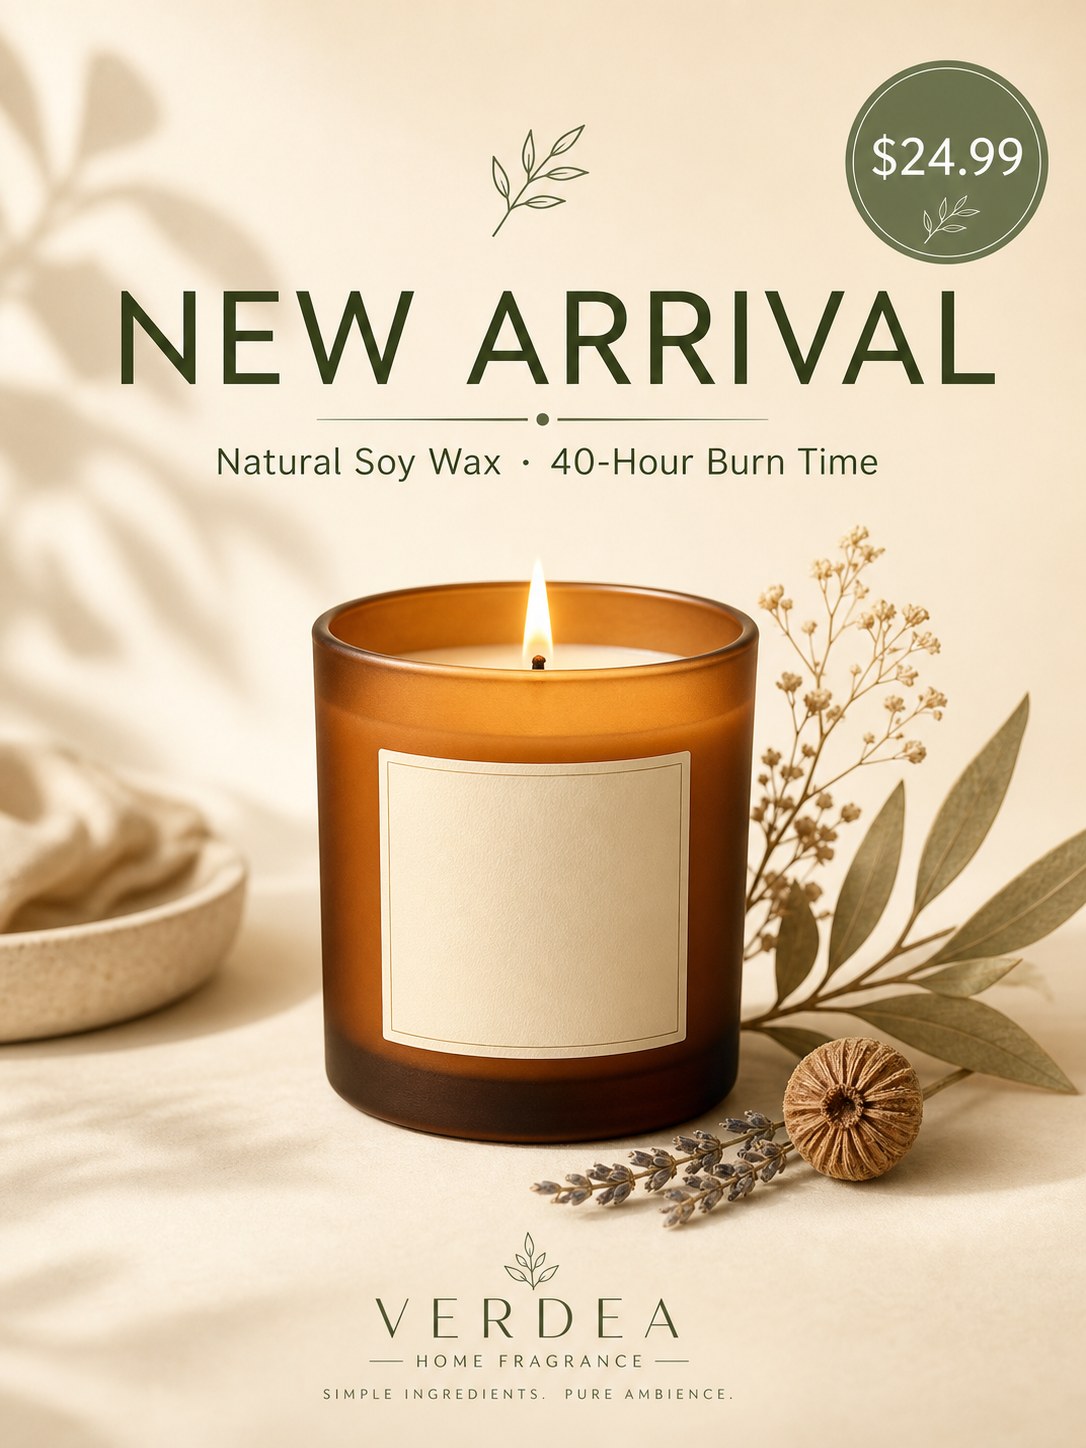
Los titulares tipográficos en negrita se renderizaron correctamente en todos los casos que probamos. El cartel de arriba contiene cinco cadenas de texto independientes: el titular principal (NEW ARRIVAL), el subtítulo (Natural Soy Wax · 40-Hour Burn Time), la insignia de precio ($24.99), la identidad de marca (VERDEA / HOME FRAGRANCE) y un pequeño lema (SIMPLE INGREDIENTS. PURE AMBIENCE.). Cada una está escrita correctamente, con espaciado adecuado y con el tamaño jerárquico correcto.
El carácter de punto medio (·) entre "Natural Soy Wax" y "40-Hour Burn Time" se renderizó correctamente. El símbolo de moneda está colocado correctamente. El salto de línea en la identidad de marca se mantuvo.
Esto funciona en una variedad de tipografías: serif, sans-serif, semi-serif, display y pesos decorativos se renderizan todos con glifos apropiados. El modelo elige una tipografía adecuada según el contexto visual (sans-serif para carteles modernos, serif para editorial, pinceladas para caligrafía), sin que tengas que especificar la fuente explícitamente.
Énfasis de color en varias palabras
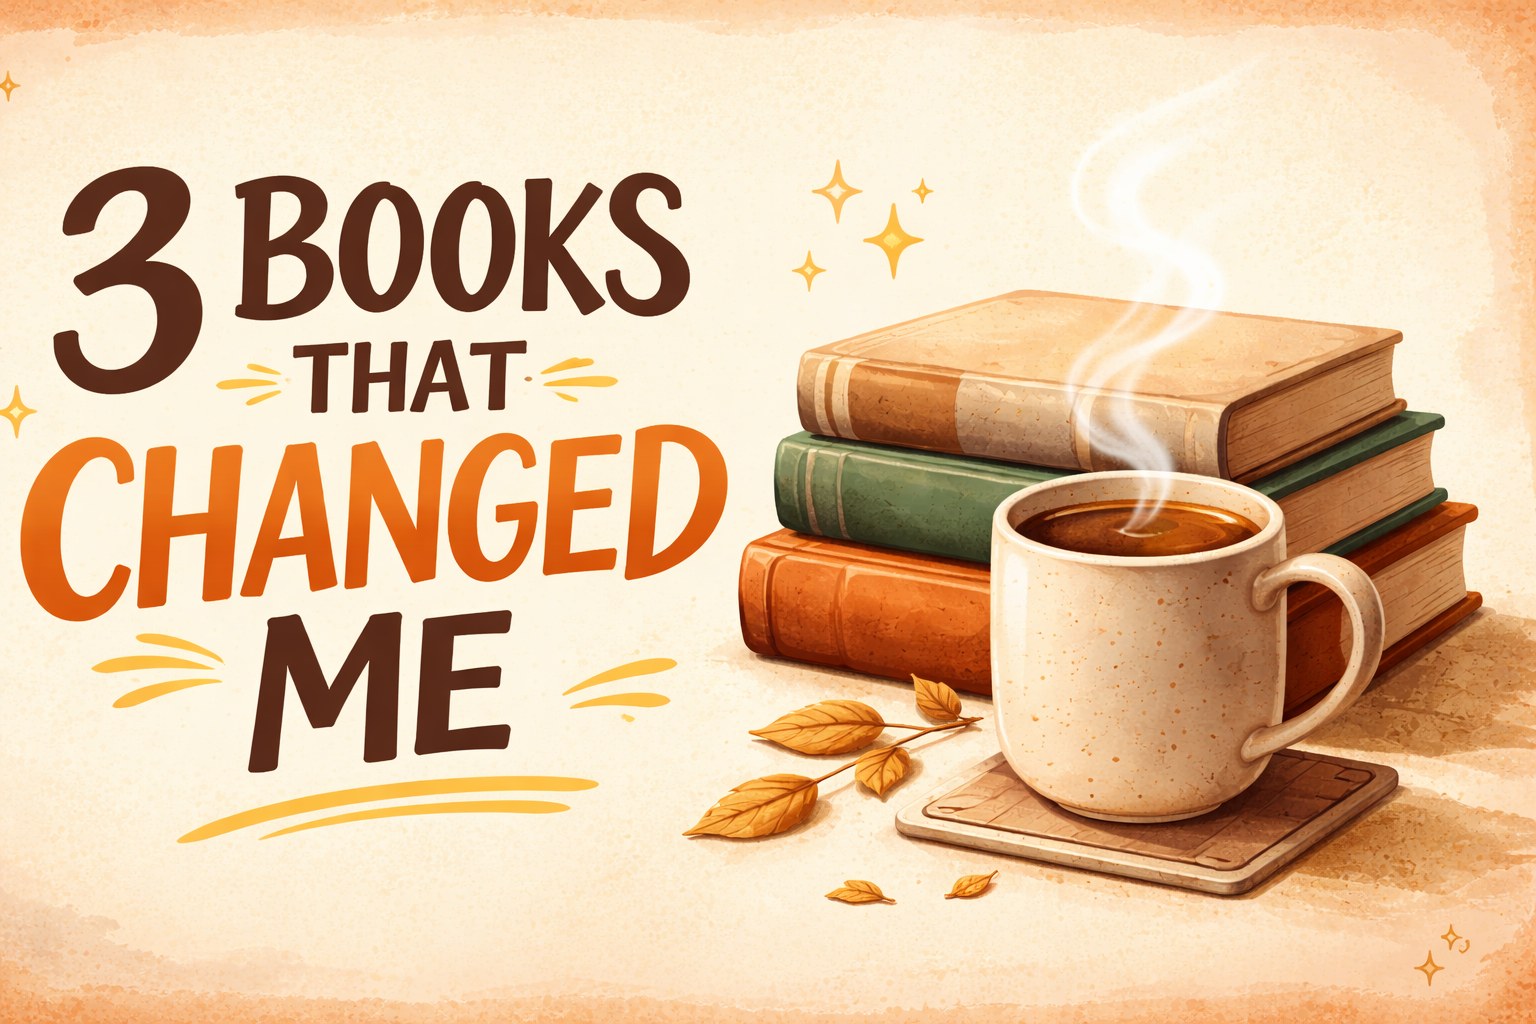
Cuando especificas que una palabra debe usar un color de énfasis (aquí "CHANGED" aparece en naranja cálido contra el marrón oscuro circundante), el modelo sigue la instrucción. El color de énfasis se aplica con precisión a la palabra objetivo, la elección de color encaja con el prompt y la tipografía circundante mantiene su coherencia.
Lo que funciona: caligrafía CJK
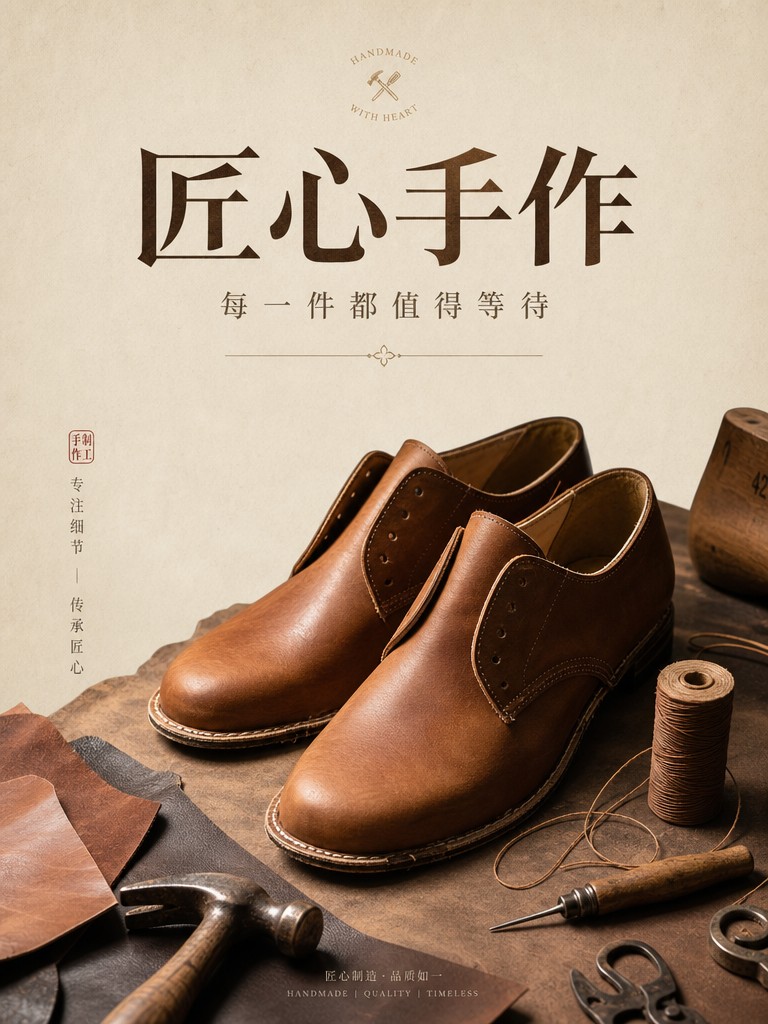
La caligrafía china y japonesa es donde la mayoría de los modelos de imagen todavía rinden pésimo. GPT Image 2 puede renderizar caracteres en estilos regular, semi-cursivo y pincelada, con orden de trazos, proporciones de los caracteres y textura de tinta adecuados. El cartel de arriba, hecho para una marca artesanal, usa una tipografía china semi-serif con trazos precisos y estructura bien formada.
En nuestra comparación con Nano Banana 2, GPT Image 2 también renderizó correctamente el título 「新春・茶道」 y el subtítulo vertical 「京都・春茶会 二〇二六年三月」, y añadió dos modismos japoneses de la ceremonia del té adecuados al contexto (一期一会, 和敬清寂) que no habíamos solicitado, pero que encajaban a la perfección con el diseño.
Las letras latinas y el texto CJK pueden aparecer en la misma imagen. Los titulares mixtos chino-inglés (habituales en marketing bilingüe) se renderizan correctamente, sin filtración de caracteres ni desviaciones de proporción.
Lo que funciona: densidad de múltiples cadenas
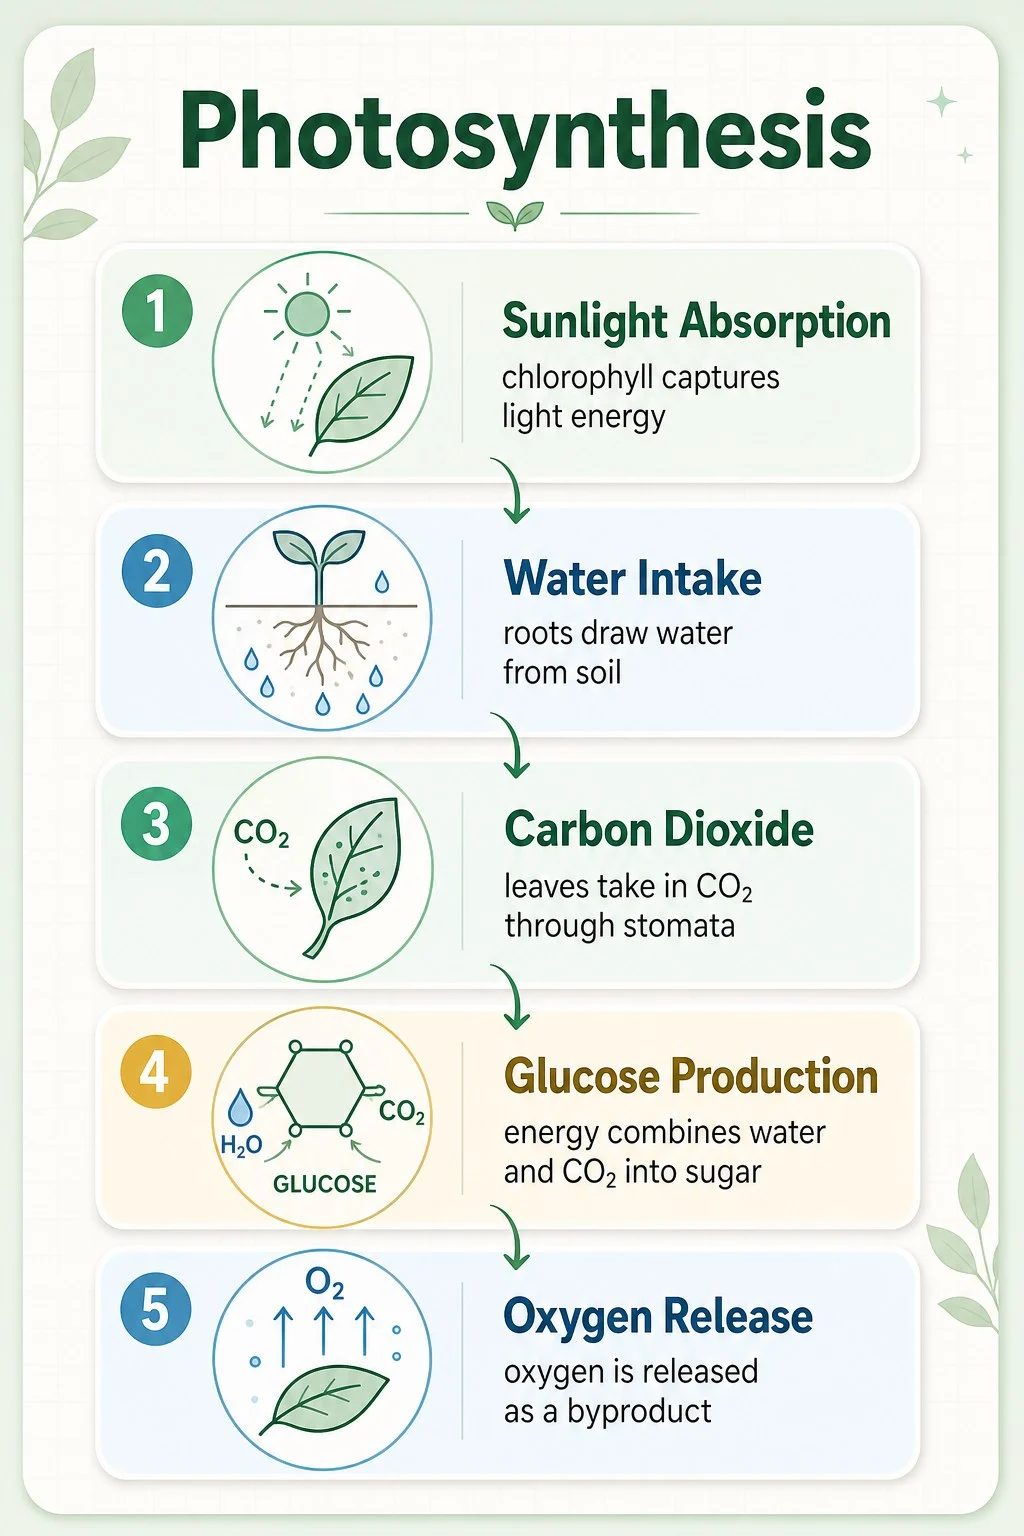
Esta fue la prueba de texto más densa que ejecutamos. La infografía contiene:
- Un título (
Photosynthesis) - Cinco títulos de pasos numerados (
Sunlight Absorption,Water Intake,Carbon Dioxide,Glucose Production,Oxygen Release) - Cinco descripciones breves (8–12 palabras cada una)
- Cinco iconos, cada uno con una microetiqueta
- Símbolos químicos (
H₂O,CO₂,O₂,GLUCOSE)
Cada cadena de texto se renderizó correctamente. La jerarquía se mantuvo: los títulos con mayor peso, las descripciones con menor peso, las microetiquetas con un tamaño adecuadamente pequeño. La secuencia de numeración (1 a 5) está en el orden correcto. Las flechas de flujo conectan los pasos correctos.
Nota: los símbolos químicos (H₂O, CO₂, O₂, GLUCOSE) fueron añadidos por el modelo sin que se le pidiera. Infirió el tema y añadió detalles coherentes con él. Este es un comportamiento recurrente de GPT Image 2: útil la mayoría de las veces, pero conviene tenerlo en cuenta cuando no lo necesitas.
Lo que funciona: números, monedas, caracteres especiales
En el conjunto de prueba de 24 generaciones:
- Los símbolos de moneda se renderizaron correctamente en
$,¥(clúster chino) y en contextos entre comillas - Los precios con varios dígitos (
$24.99,$29,¥129) conservaron los puntos decimales y las comas - Las fechas (
Tuesday, March 4) mantuvieron las comas y el orden de las palabras - Las cadenas de hora (
9:41) se renderizaron con los dos puntos correctos - Los guiones largos (
—) y el punto medio (·) se renderizaron correctamente cuando se incluyeron como caracteres literales en el prompt - Las insignias de año (
EST. 2024,2026) mantuvieron el punto y la precisión de cuatro dígitos
La regla es: si incluyes en el prompt (con comillas rectas) el carácter exacto que quieres, GPT Image 2 lo reproduce fielmente. Las comillas tipográficas ("/") en el prompt producen comillas tipográficas en la salida. Las comillas rectas (") producen comillas rectas. El modelo es fiel a los caracteres, lo que significa que tú debes elegir deliberadamente los caracteres que escribes.
Lo que funciona: bloques de marca integrados
Las adiciones no solicitadas más interesantes vinieron de que el modelo añadió pequeños textos de estilo de marca que no estaban en el prompt:
- En un cartel de artículos de cuero se añadieron "CRAFTED TO LAST · EST. 2024" y un monograma "H | C"
- En la parte inferior de un cartel de lanzamiento de velas se añadió el bloque "VERDEA / HOME FRAGRANCE / SIMPLE INGREDIENTS. PURE AMBIENCE."
- En una etiqueta de producto se añadió "BOIS DE SANTAL" como especificación de aroma
Estos son pequeños elementos de texto coherentes con el lenguaje de diseño de la imagen circundante. En cada caso, la ortografía y la tipografía eran correctas. El modelo es lo bastante bueno en esto como para que estas adiciones suelan mejorar la salida, pero si quieres un control estricto, añade la cláusula explícita no additional text or brand marks.
Para más información sobre este comportamiento de adición contextual, consulta nuestra reseña práctica de GPT Image 2.
Modos de fallo (ese 1%)
En nuestras 24 generaciones de prueba deliberadamente densas en texto, las cadenas de texto principales se renderizaron correctamente el 100% de las veces. Ese es el resultado de una prueba controlada. La cifra honesta en producción se acerca al 99%, porque los casos límite afloran en cuanto empiezas a ejecutar a escala:
1. Sustitución de un solo carácter en texto de cuerpo pequeño
El fallo más común no es un galimatías completo, sino un solo carácter alterado. En un texto explicativo muy pequeño, "Burn" se renderiza como "Bum". A "Hours" le falta una R. En el mes ("September") las letras centrales aparecen ocasionalmente en orden incorrecto. Esto se escapa de la visión periférica y se cuela si no lo revisas al 100% de zoom.
Cuando ocurre, regenerar con el mismo prompt casi siempre lo soluciona (el problema es de aleatoriedad del muestreo, no estructural del prompt).
2. Texto minúsculo por debajo de 12 pt
GPT Image 2 es mucho más estable a tamaños pequeños que las generaciones anteriores de modelos, pero hay un umbral por debajo del cual los glifos empiezan a volverse borrosos. Para la información nutricional de una etiqueta de vino, las advertencias de una etiqueta farmacéutica o cualquier cosa que deba ser legible con claridad a un equivalente de 8–10 pt, cuenta con tener que regenerar una o dos veces. Aumentar la resolución solicitada de 1K a 2K ayuda: el sobrecoste es del 33%, pero la mejora en legibilidad del texto pequeño es real.
3. Sustitución de comillas tipográficas
Si en tu prompt hay comillas tipográficas ("/", '/') y quieres que la salida use comillas rectas (", '), el modelo renderizará fielmente las comillas tipográficas. No es un modo de fallo del modelo, sino un problema de preparación del prompt. Si las comillas rectas importan, limpia el prompt antes de enviarlo.
4. Adiciones no solicitadas en contextos estrictos
En contextos de "sin texto, sin logotipos, sin ruido visual" (fotografía limpia de catálogo de producto), el modelo es fiable. En contextos más laxos (lifestyle, promocional, editorial), a veces añade monogramas de marca, insignias o texto auxiliar que no pediste. Añade cláusulas negativas explícitas donde necesites un control estricto.
Lista de verificación para producción
Tras las 24 generaciones densas en texto de este conjunto de prueba y muchas más en producción, esta es la lista de verificación que usamos antes de entregar cualquier imagen con texto renderizado:
- Ábrela al 100% de zoom o más. Las miniaturas del navegador y las ventanas de vista previa del editor ocultan sustituciones de un solo carácter. Mira siempre los píxeles realmente renderizados.
- Lee en voz alta cada cadena de texto o recórrela carácter a carácter. Hojear por encima es la causa de que se escapen las erratas. Recorre cada letra, cada dígito, cada signo de puntuación.
- Revisa primero el texto más pequeño. Los fallos en los titulares se ven a simple vista. El texto explicativo por debajo de 12 pt falla de forma invisible hasta que el cliente informa del error.
- Si encuentras un error, regenera con el mismo prompt. No intentes editar la imagen manualmente: la versión regenerada casi siempre es más barata, más rápida y visualmente más cercana a tu intención.
- Para salidas densas en texto a escala, solicita resolución 2K. Para cualquier texto por debajo del tamaño de exposición, el sobrecoste del 33% merece la pena en legibilidad.
El paso de revisión lleva de 30 a 60 segundos por imagen. Saltárselo es justo lo que genera historias del tipo "erratas generadas por IA en materiales de marketing ya entregados", que dañan la credibilidad general del trabajo con imágenes de IA.
Cuándo elegir GPT Image 2 para trabajo con texto
GPT Image 2 es la elección correcta para cualquier trabajo de imagen denso en texto donde la precisión sea crítica:
- Carteles y banners promocionales: consulta las plantillas de prompt disponibles para ejemplos listos para producción
- Listados de producto de e-commerce con etiquetas de marca: consulta el flujo de trabajo completo de imágenes para e-commerce
- Marketing multilingüe: caligrafía CJK, carteles de idiomas mixtos
- Infografías, carteles científicos, gráficos con leyendas: la densidad de múltiples cadenas resiste la prueba
- Mockups de UI con texto de interfaz realista: consulta las pruebas de texto a nivel de pantalla en la comparación con Nano Banana 2
A $0.03 por imagen en resolución 1K, el coste te permite revisar y regenerar según sea necesario sin preocuparte por el presupuesto. El tiempo real (unos 90–120 segundos por generación) es la verdadera partida presupuestaria.
Para una opinión honesta sobre en qué destaca y en qué no GPT Image 2, consulta nuestra reseña práctica.
Preguntas frecuentes
¿Es la representación de texto de GPT Image 2 lo bastante fiable para entregar trabajo comercial?
Sí, pero requiere un paso de revisión. En nuestra prueba controlada de 24 generaciones, las cadenas principales se renderizaron correctamente el 100% de las veces. A escala de producción, esa tasa baja a alrededor del 99%, lo que significa que aproximadamente 1 de cada 100 imágenes tendrá un problema de un solo carácter que requerirá regeneración. Con una revisión visual de 30 segundos por imagen, es una tasa de producción manejable.
¿Es la representación de texto chino/japonés tan precisa como la del inglés?
En nuestras pruebas, sí. La caligrafía CJK es donde la mayoría de los modelos de imagen fallan gravemente. GPT Image 2 renderiza adecuadamente el orden de trazos, las proporciones de los caracteres y la textura de la tinta. Los caracteres chinos y japoneses comunes se renderizan de forma fiable; los más raros o históricamente específicos (variantes, ortografía clásica) aún no los hemos probado a escala.
¿Y otros sistemas de escritura: árabe, cirílico, devanagari?
No probamos estos en esta sesión, así que no podemos hacer afirmaciones basadas en evidencia. Anecdóticamente, GPT Image 2 rinde bien con el cirílico y las lenguas de escritura latina. La escritura árabe de derecha a izquierda y las ligaduras de escrituras complejas (devanagari, tailandés) son áreas para las que no tenemos datos de pruebas controladas.
¿Añade el modelo texto que no le pedí?
A veces. En nuestras 24 generaciones de prueba, el modelo añadió texto coherente con el contexto en aproximadamente 4 casos (monogramas de marca, insignias EST., líneas de especificaciones complementarias del producto). Esas adiciones siempre estaban bien escritas y encajaban con el contexto del diseño. Si necesitas un control estricto, añade la cláusula negativa explícita no additional text.
¿Afecta la resolución solicitada a la representación de texto?
Sí, especialmente en el texto pequeño. La resolución 2K es claramente superior a la 1K a la hora de preservar la legibilidad por debajo de 12 pt. El sobrecoste es del 33%, algo que merece la pena para salidas densas en texto.
Resumen
La representación de texto de GPT Image 2 está a la altura de lo que prometía en su lanzamiento. En nuestras 24 generaciones densas en texto de la prueba de producción —titulares en inglés, caligrafía CJK, infografías con múltiples cadenas, bloques de marca integrados, monedas, caracteres especiales— cada cadena principal se renderizó correctamente.
La tasa de error de producción de aproximadamente el 1% aparece en el texto más pequeño y casi siempre se soluciona regenerando. El paso de revisión no es negociable para entregar. Más allá de eso, es el modelo de imagen con texto más fiable con el que hemos trabajado, y en trabajos donde la precisión del texto forma parte del entregable, la calidad tipográfica justifica los tiempos de generación más lentos.
Prueba tú mismo un prompt denso en texto en la página del modelo GPT Image 2: cita algunas cadenas exactas, especifica el diseño, ejecútalo y revisa el resultado. La primera generación suele ser la que se entrega.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores