
Benutzerhandbuch
Ist das Text-Rendering von GPT Image 2 wirklich fehlerfrei? Wir haben Schilder, Poster und Etiketten einem Stresstest unterzogen
24 textintensive Generierungen in einer einzigen Grafik-Session – Überschriften, CJK-Kalligrafie, eingebettete Etiketten, Zahlen, dichte Infografiken – hier sind die Ergebnisse unserer Messungen
Die Funktion, die GPT Image 2 zum Start einschlagen ließ, war das Text-Rendering. Die meisten Bildmodelle erzeugen immer noch Kauderwelsch oder halb geformte Glyphen, wenn man sie bittet, typografischen Text zu rendern. GPT Image 2 sollte anders sein – saubere Rechtschreibung, korrekte Laufweite, in das Bild eingebettete Untertitel ohne Nachbearbeitung.
Nach sechs Wochen und Hunderten von Generierungen haben wir genug Daten, um konkret zu sagen, was standhält und was nicht. Die gute Nachricht: Das Kernversprechen stimmt. Die tiefere Nachricht steckt in Randfällen und Produktionsausfällen, die in den Launch-Demos nie erwähnt wurden.
Testaufbau
Bei der Erstellung dieses Content-Clusters – sechs Artikel, Dutzende von Begleitbildern – haben wir bewusst 24 textintensive Generierungen über GPT Image 2 laufen lassen. Jedes Mal nur eine Generierung pro Prompt, keine Auswahl. Die Aufgabenkategorien waren:
- Englische Überschriften und Untertitel – Werbeposter, Markenbanner, Social-Media-Cover
- CJK-Kalligrafie – chinesische und japanische Teezeremonie-Poster, Markenidentitätsdesign
- Infografiken mit vielen Textzeichenketten – nummerierte Schrittlisten, beschriftete Diagramme, Wissenschaftsposter-Stil
- Eingebettete Markenblöcke – kleine Gründer-Slogans, "EST."-Jahresabzeichen, Monogramm-Muster
- Zahlen, Währungen, Sonderzeichen – Preisabzeichen, Jahreszahlen, Prozentangaben
- UI-Mockups – Interface-Bildschirme mit vielen einzelnen Textzeichenketten
Hier sind die Muster, die wir gefunden haben, geordnet von "offensichtlich funktioniert" bis "Vorsicht geboten".
Was funktioniert: Englische Überschriften
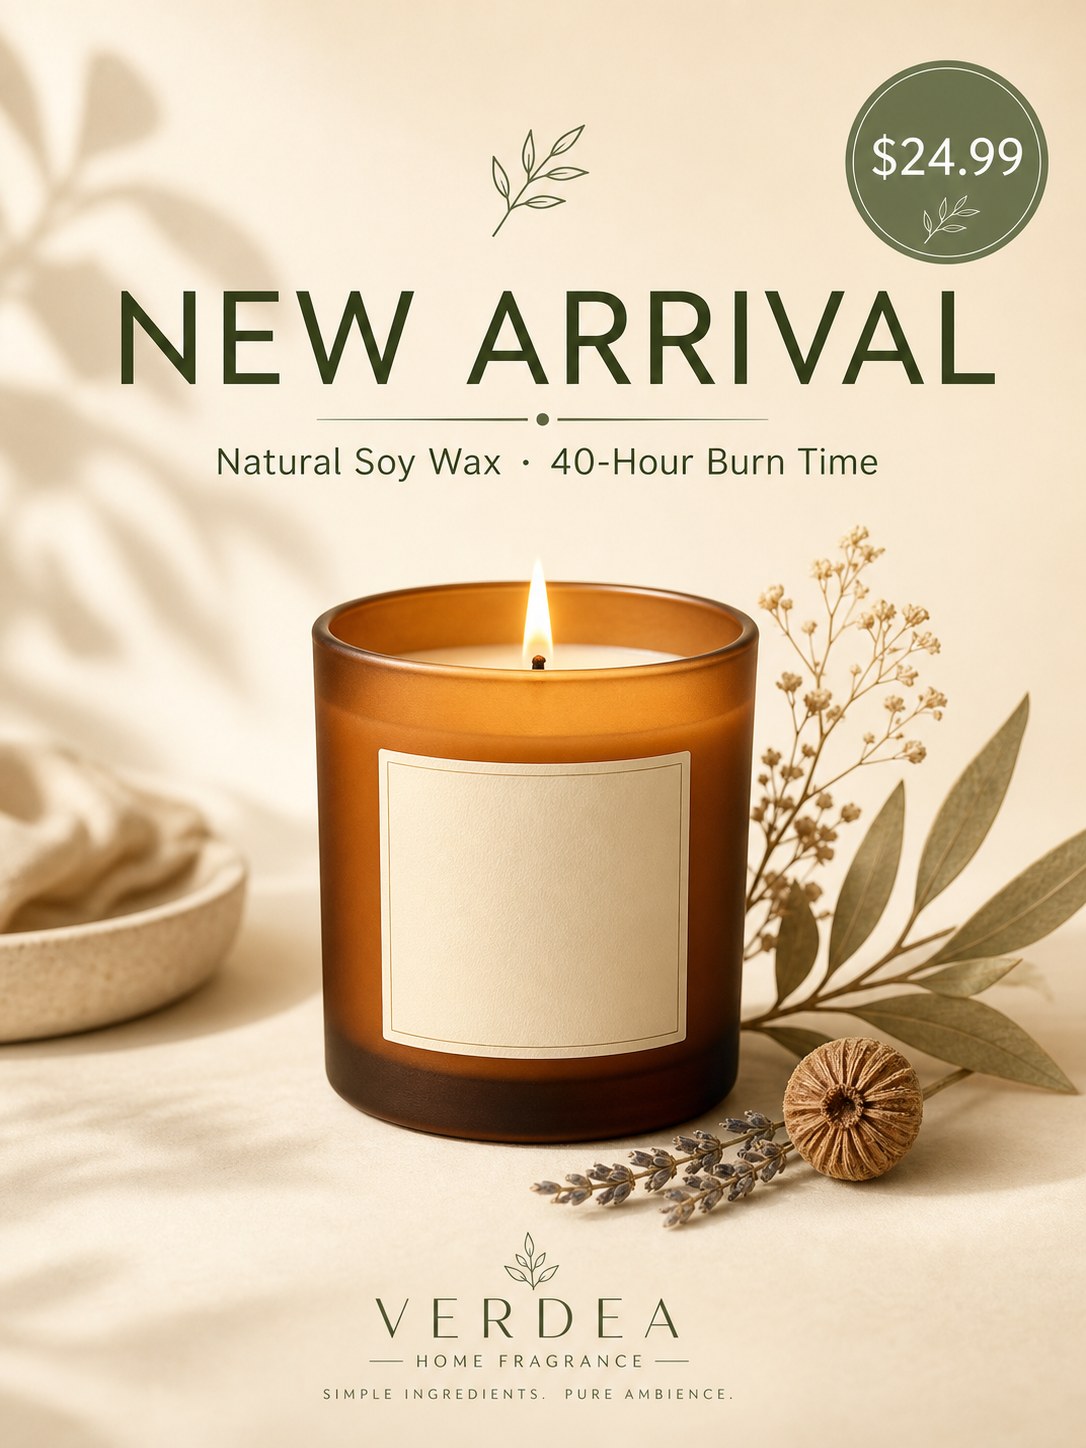
Fett gesetzte typografische Überschriften wurden in jedem getesteten Fall korrekt gerendert. Das Poster oben enthält fünf einzelne Textzeichenketten: die Hauptüberschrift (NEW ARRIVAL), den Untertitel (Natural Soy Wax · 40-Hour Burn Time), das Preisabzeichen ($24.99), die Markenidentität (VERDEA / HOME FRAGRANCE) und einen kleinen Slogan (SIMPLE INGREDIENTS. PURE AMBIENCE.). Jede davon ist korrekt geschrieben, angemessen in der Laufweite und in der richtigen Hierarchiegröße dargestellt.
Das Mittelpunktzeichen (·) zwischen "Natural Soy Wax" und "40-Hour Burn Time" wurde korrekt gerendert. Das Währungssymbol sitzt an der richtigen Stelle. Der Zeilenumbruch in der Markenidentität bleibt erhalten.
Das funktioniert über verschiedene Schriften hinweg – Serif, Sans-Serif, Halb-Serif, Display und dekorative Schnitte werden alle mit passenden Glyphen gerendert. Das Modell wählt die passende Schriftart je nach visuellem Kontext (Sans-Serif für moderne Poster, Serif für Redaktionelles, Pinselstriche für Kalligrafie), ohne dass man die Schriftart explizit angeben muss.
Farbbetonung für mehrere Wörter
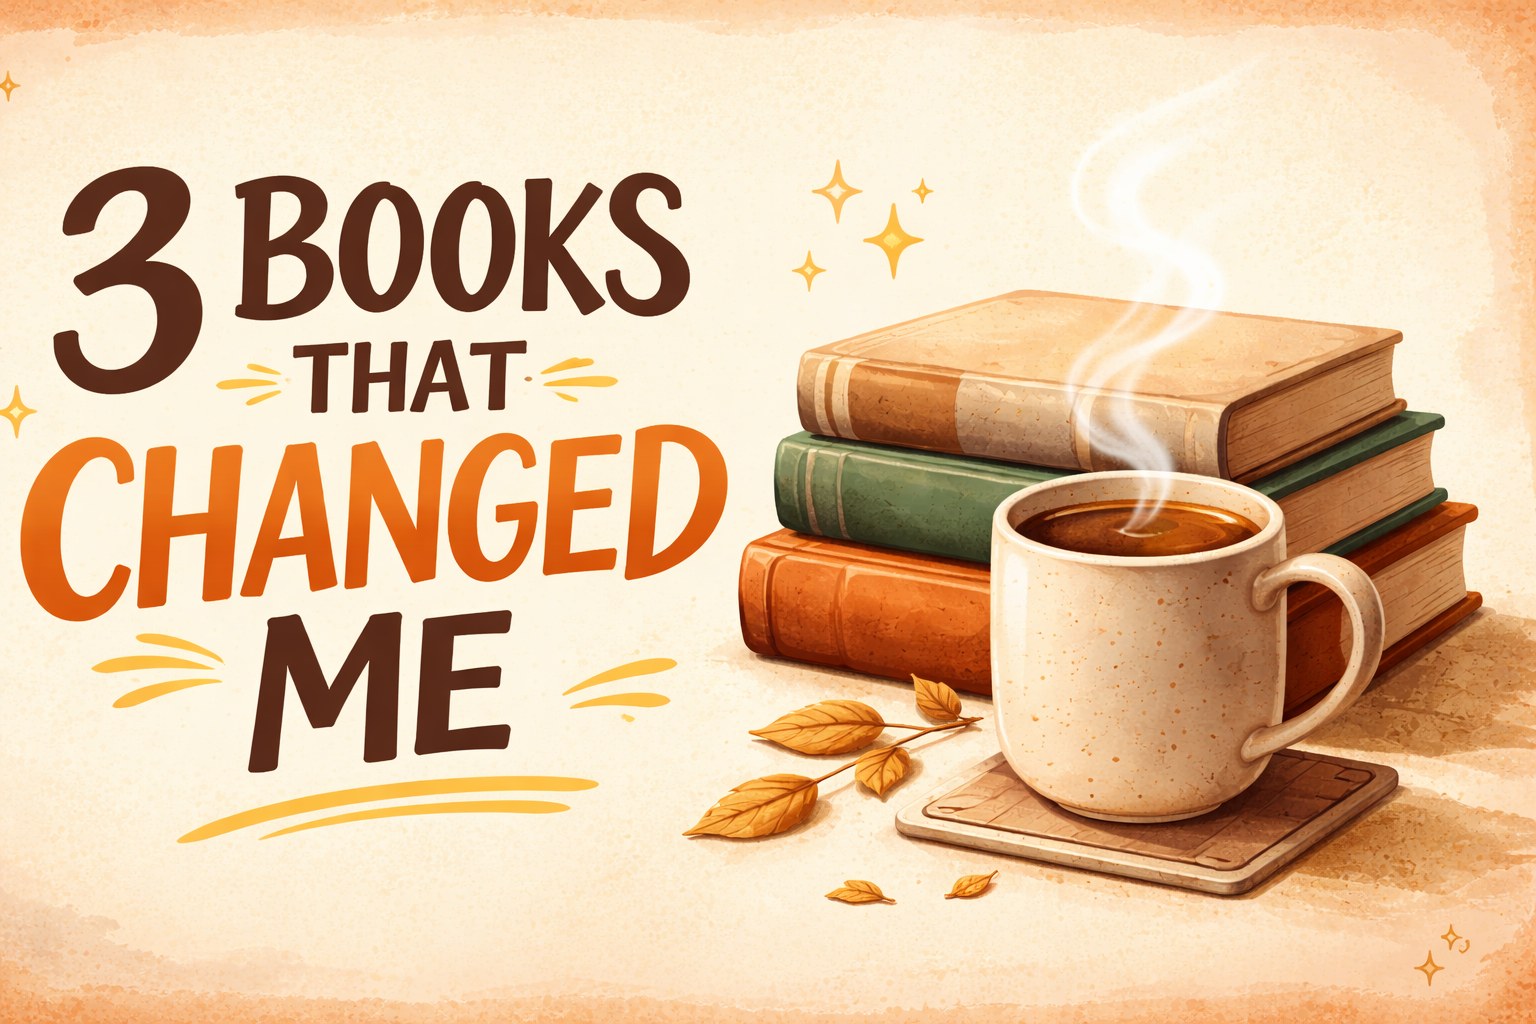
Wenn man angibt, dass ein bestimmtes Wort eine Akzentfarbe erhalten soll (hier erscheint "CHANGED" in warmem Orange vor dem umgebenden dunklen Braun), befolgt das Modell diese Anweisung. Die Akzentfarbe wirkt genau auf das Zielwort, die Farbwahl passt zum Prompt, und die umgebende Typografie bleibt einheitlich.
Was funktioniert: CJK-Kalligrafie
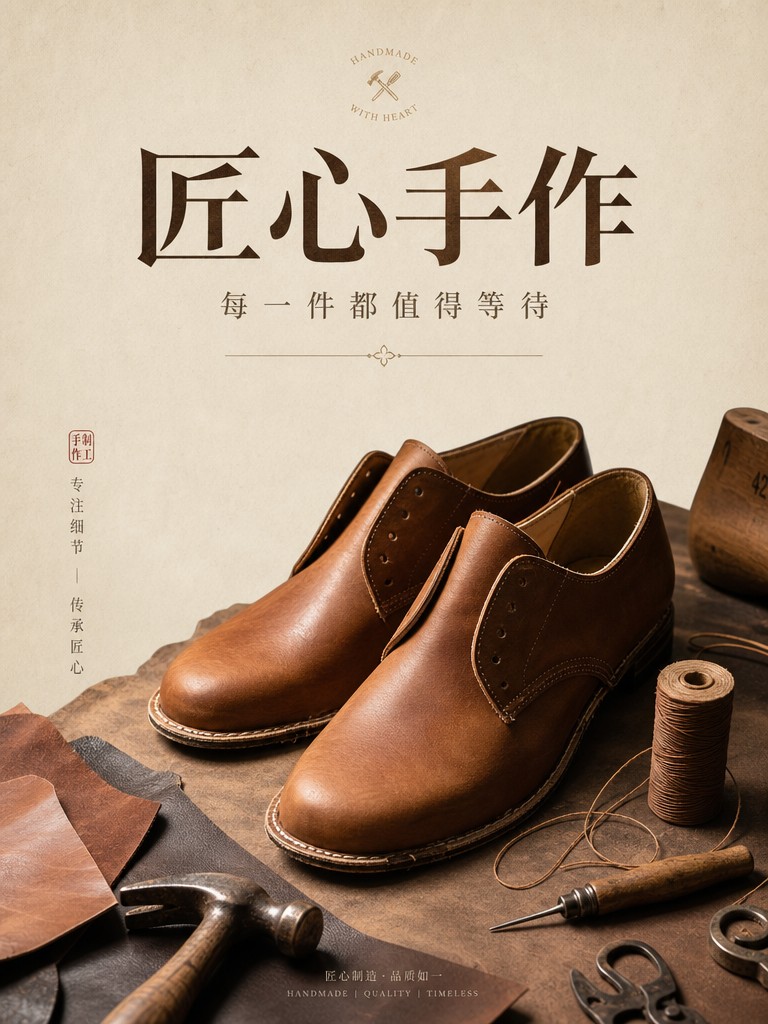
Chinesische und japanische Kalligrafie ist der Bereich, in dem die meisten Bildmodelle immer noch schlecht abschneiden. GPT Image 2 kann Zeichen im Regulärstil, im Halbkursivstil und im Pinselstrichstil mit angemessener Strichreihenfolge, Zeichenproportion und Tuschetextur rendern. Das Poster oben für eine Handwerksmarke verwendet eine chinesische Halb-Serif-Schrift mit korrekten Strichen und guter Struktur.
In unserem Vergleich mit Nano Banana 2 hat GPT Image 2 auch die Überschrift 「新春・茶道」 und den vertikalen Untertitel 「京都・春茶会 二〇二六年三月」 korrekt gerendert – und zwei kontextpassende japanische Teezeremonie-Idiome hinzugefügt (一期一会, 和敬清寂), die wir nicht verlangt hatten, die aber das Design bereichern.
Lateinische Buchstaben und CJK-Text können im selben Bild erscheinen. Gemischte chinesisch-englische Überschriften (häufig im bilingualen Marketing) werden korrekt gerendert, ohne Zeichendurchdringung oder Proportionsverschiebung.
Was funktioniert: Dichte mehrerer Textzeichenketten
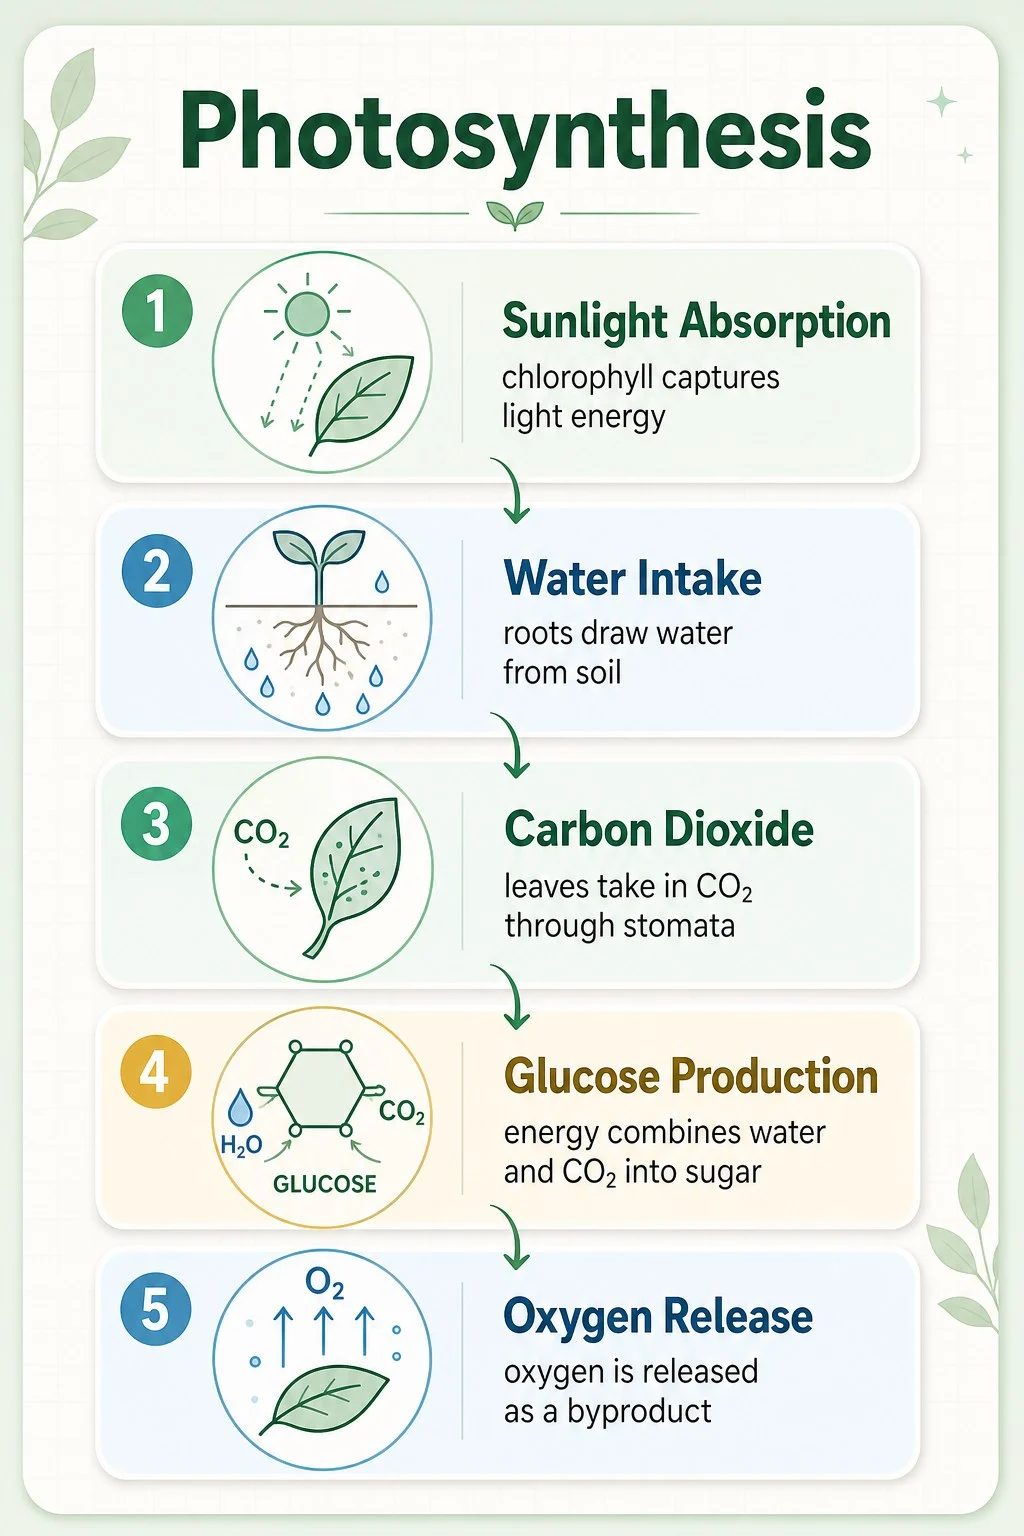
Dies war unser dichter Texttest. Die Infografik enthält:
- eine Überschrift (
Photosynthesis) - fünf nummerierte Schrittüberschriften (
Sunlight Absorption,Water Intake,Carbon Dioxide,Glucose Production,Oxygen Release) - fünf kurze Beschreibungen (je 8–12 Wörter)
- fünf Symbole mit je einem Mikro-Label
- chemische Symbole (
H₂O,CO₂,O₂,GLUCOSE)
Jede Textzeichenkette wurde korrekt gerendert. Die Hierarchie bleibt erhalten – die Überschrift ist schwerer, die Beschreibungen leichter, die Mikro-Labels angemessen kleiner. Die Nummerierungssequenz (1 bis 5) ist in der richtigen Reihenfolge. Die Prozesspfeile verbinden die richtigen Schritte.
Hinweis: Die chemischen Symbole (H₂O, CO₂, O₂, GLUCOSE) hat das Modell von sich aus hinzugefügt, ohne dass sie verlangt wurden. Es hat das Thema erschlossen und thematisch passende Details ergänzt. Das ist ein wiederkehrendes Verhalten von GPT Image 2 – meistens nützlich, aber erwähnenswert, wenn man es nicht braucht.
Was funktioniert: Zahlen, Währungen, Sonderzeichen
Im Testsatz der 24 Generierungen:
- Währungssymbole wurden korrekt gerendert bei
$,¥(chinesischer Cluster) sowie im Kontext von Anführungszeichen - Mehrstellige Preise (
$24.99,$29,¥129) behielten Dezimalpunkt und Komma - Daten (
Tuesday, March 4) behielten Komma und Wortstellung - Zeitzeichenketten (
9:41) wurden mit korrektem Doppelpunkt gerendert - Gedankenstriche (
—) und Mittelpunkte (·) wurden korrekt gerendert, wenn sie als Literalzeichen im Prompt enthalten waren - Jahresabzeichen (
EST. 2024,2026) behielten Punkt und die Genauigkeit der vierstelligen Zahl
Das Muster ist: Wenn man die gewünschten Zeichen exakt (mit geraden Anführungszeichen) in den Prompt aufnimmt, gibt GPT Image 2 sie originalgetreu wieder. Typografische Anführungszeichen ("/") im Prompt erzeugen typografische Anführungszeichen in der Ausgabe. Gerade Anführungszeichen (") erzeugen gerade Anführungszeichen. Das Modell ist den Zeichen gegenüber treu – das bedeutet, man selbst muss bewusst wählen, welche Zeichen man hineinschreibt.
Was funktioniert: Eingebettete Markenblöcke
Die interessantesten unaufgeforderten Ergänzungen waren kleine markenstilistische Texte, die das Modell hinzufügte und die nicht im Prompt standen:
- Auf einem Lederwaren-Poster wurden "CRAFTED TO LAST · EST. 2024" und ein "H | C"-Monogramm-Muster ergänzt
- Auf einem Kerzen-Launch-Poster wurde unten ein Block "VERDEA / HOME FRAGRANCE / SIMPLE INGREDIENTS. PURE AMBIENCE." ergänzt
- Auf einem Produktetiketten wurde "BOIS DE SANTAL" als Duftnote ergänzt
Das sind kleine Textelemente, die zur Designsprache des umgebenden Bildes passen. In jedem Fall waren Rechtschreibung und Typografie korrekt. Das Modell ist hierin so gut, dass diese Ergänzungen die Ausgabe oft verbessern – aber wenn man strenge Kontrolle will, sollte man die ausdrückliche Klausel no additional text or brand marks hinzufügen.
Mehr zu diesem kontextbezogenen Ergänzungsverhalten finden Sie in unserem GPT Image 2 Hands-on-Test.
Fehlermodi (das 1 %)
In unseren 24 bewusst textintensiven Testgenerierungen wurden die Haupttextzeichenketten zu 100 % korrekt gerendert. Das ist das Ergebnis kontrollierter Tests. Die ehrliche Produktionszahl liegt näher bei 99 %, denn sobald man in großem Maßstab arbeitet, treten Randfälle auf:
1. Einzelzeichen-Ersetzungen bei kleinem Text
Der häufigste Fehler ist nicht völliges Kauderwelsch – sondern ein einzelnes verändertes Zeichen. In sehr kleinen Beschriftungen wird "Burn" zu "Bum". Bei "Hours" fehlt ein R. Bei Monaten ("September") sind gelegentlich die mittleren Buchstaben in falscher Reihenfolge. Das entgeht dem peripheren Sehen, und wenn man nicht bei 100 % Zoom Korrektur liest, gelangt es nach draußen.
Wenn das passiert, behebt eine Neugenerierung mit demselben Prompt es fast immer (das Problem ist Sampling-Zufälligkeit, nicht Prompt-Struktur).
2. Winziger Text unter 12 pt
GPT Image 2 ist bei kleinen Größen weit stabiler als frühere Modelle – aber es gibt eine Schwelle, unterhalb derer die Glyphen weich werden. Für Nährwertangaben auf Weinetiketten, Warnhinweise auf Medikamentenetiketten oder alles, was bei äquivalent 8–10 pt klar lesbar sein muss, sollte man ein bis zwei Neugenerierungen einplanen. Die angeforderte Auflösung von 1K auf 2K zu erhöhen hilft – der Kostenaufschlag beträgt 33 %, aber die Verbesserung der Lesbarkeit kleiner Schrift ist real.
3. Ersetzung typografischer Anführungszeichen
Wenn der Prompt typografische Anführungszeichen ("/", '/') enthält und man in der Ausgabe gerade Anführungszeichen (", ') möchte, rendert das Modell originalgetreu die typografischen. Das ist kein Fehlermodus des Modells – sondern ein Problem der Prompt-Vorbereitung. Wenn gerade Anführungszeichen wichtig sind, sollte man den Prompt vor dem Senden bereinigen.
4. Unaufgeforderte Ergänzungen in strengen Kontexten
Für Kontexte mit "kein Text, kein Logo, kein Durcheinander" (saubere Produktkatalogfotos) ist das Modell zuverlässig. In lockereren Kontexten (Lifestyle, Werbung, Redaktionelles) fügt es manchmal Markenmonogramme, Abzeichen oder ergänzenden Text hinzu, die nicht verlangt wurden. Wo strenge Kontrolle nötig ist, sollte man ausdrückliche Negativklauseln hinzufügen.
Korrekturlese-Checkliste für die Produktion
Nach den 24 textintensiven Generierungen dieses Testsatzes und weiteren Generierungen in der Produktion verwenden wir vor der Auslieferung jedes Bildes mit gerendertem Text diese Korrekturlese-Checkliste:
- Bei 100 % oder höherer Zoomstufe öffnen. Browser-Miniaturansichten und Editor-Vorschaufenster verbergen Einzelzeichen-Ersetzungen. Immer die tatsächlich gerenderten Pixel prüfen.
- Jede Textzeichenkette laut vorlesen oder Zeichen für Zeichen nachfahren. Überfliegen ist der Grund, warum Tippfehler nach draußen gelangen. Jeden Buchstaben, jede Zahl, jedes Satzzeichen nachfahren.
- Zuerst den kleinsten Text prüfen. Fehler in Überschriften sind mit bloßem Auge sichtbar. Beschriftungen unter 12 pt scheitern unsichtbar, bis der Kunde den Fehler meldet.
- Bei einem Fehler denselben Prompt neu generieren. Nicht versuchen, das Bild manuell zu bearbeiten – die neu generierte Version ist fast immer günstiger, schneller und visuell näher an der Absicht.
- Für textintensive Ausgaben in großem Maßstab 2K-Auflösung anfordern. Für jeden Text unter Anzeigegröße lohnt sich der Kostenaufschlag von 33 % für die Lesbarkeit.
Der Korrekturleseschritt dauert 30–60 Sekunden pro Bild. Ihn zu überspringen ist genau das, was Geschichten über "in ausgeliefertem Marketingmaterial enthaltene KI-generierte Tippfehler" erzeugt, die die allgemeine Glaubwürdigkeit von KI-Bildarbeit schädigen.
Wann man GPT Image 2 für Textarbeit wählen sollte
Für jede textintensive Bildarbeit, bei der Genauigkeit entscheidend ist, ist GPT Image 2 die richtige Wahl:
- Werbeposter und Banner – siehe verwendbare Prompt-Vorlagen für produktionsreife Beispiele
- E-Commerce-Produktlisten mit Markenetiketten – siehe den vollständigen E-Commerce-Bildworkflow
- Mehrsprachiges Marketing – CJK-Kalligrafie, gemischtsprächige Poster
- Infografiken, Wissenschaftsposter, beschriftete Diagramme – die Dichte mehrerer Textzeichenketten hält stand
- UI-Mockups mit echtem Interface-Text – siehe die Bildschirmtext-Tests im Nano-Banana-2-Vergleich
Bei $0.03 pro Bild in 1K-Auflösung erlaubt es der Kostenrahmen, nach Bedarf zu korrigieren und neu zu generieren, ohne sich um das Budget zu sorgen. Der tatsächliche Zeitaufwand (ca. 90–120 Sekunden pro Generierung) ist der eigentliche Budgetposten.
Für eine ehrliche Einschätzung, wo GPT Image 2 gewinnt und wo nicht, siehe unseren Hands-on-Test.
Häufig gestellte Fragen
Ist das Text-Rendering von GPT Image 2 zuverlässig genug für die Auslieferung kommerzieller Arbeit?
Ja, aber mit Korrekturleseschritt. In unserem kontrollierten Test mit 24 Generierungen wurden die Hauptzeichenketten zu 100 % korrekt gerendert. In Produktionsmaßstab sinkt diese Quote auf etwa 99 % – das heißt, etwa 1 von 100 Bildern hat ein Einzelzeichen-Problem, das eine Neugenerierung erfordert. Ein visueller Korrekturleseschritt von 30 Sekunden pro Bild ist eine überschaubare Produktionsquote.
Ist das Rendering chinesischer/japanischer Texte genauso genau wie bei Englisch?
In unseren Tests ja. CJK-Kalligrafie ist der Bereich, in dem die meisten Bildmodelle schwer scheitern. GPT Image 2 rendert Strichreihenfolge, Zeichenproportion und Tuschetextur angemessen. Häufige chinesische und japanische Zeichen werden zuverlässig gerendert; seltenere oder historisch spezifischere Zeichen (Variantzeichen, klassische Orthografie) haben wir noch nicht im großen Maßstab getestet.
Was ist mit anderen Schriftsystemen – Arabisch, Kyrillisch, Devanagari?
Diese haben wir in dieser Session nicht getestet, daher können wir keine evidenzbasierte Aussage treffen. Anekdotisch rendert GPT Image 2 Sprachen mit kyrillischen und lateinischen Schriftsystemen gut. Rechts-nach-links-Schriften wie Arabisch und komplexe Schriftligaturen (Devanagari, Thai) sind Bereiche, für die wir keine kontrollierten Testdaten haben.
Fügt das Modell Text hinzu, den ich nicht verlangt habe?
Manchmal. In unserem Test mit 24 Generierungen hat das Modell in etwa 4 Fällen kontextpassenden Text hinzugefügt (Markenmonogramme, EST.-Abzeichen, ergänzende Produktspezifikationszeilen). Diese Ergänzungen waren immer korrekt geschrieben und passten zum Designkontext. Wenn man strenge Kontrolle braucht, sollte man die ausdrückliche Negativklausel no additional text hinzufügen.
Beeinflusst die angeforderte Auflösung das Text-Rendering?
Ja, besonders bei kleiner Schrift. 2K-Auflösung ist bei der Bewahrung der Lesbarkeit unter 12 pt deutlich besser als 1K. Der Kostenaufschlag beträgt 33 % – für textintensive Ausgaben lohnt er sich.
Zusammenfassung
Das Text-Rendering von GPT Image 2 hält, was das Launch-Marketing versprochen hat. In unseren 24 textintensiven Produktionstest-Generierungen – englische Überschriften, CJK-Kalligrafie, Infografiken mit mehreren Zeichenketten, eingebettete Markenblöcke, Währungen, Sonderzeichen – wurde jede Hauptzeichenkette korrekt gerendert.
Die verbleibende Produktionsfehlerquote von etwa 1 % tritt bei der kleinsten Schrift auf und lässt sich fast immer durch Neugenerierung beheben. Der Korrekturleseschritt ist für die Auslieferung nicht verhandelbar. Davon abgesehen ist dies das zuverlässigste Text-Bild-Modell, mit dem wir gearbeitet haben – bei Arbeiten, bei denen Textgenauigkeit Teil des Lieferumfangs ist, rechtfertigt die typografische Qualität die längeren Generierungszeiten.
Probieren Sie selbst einen textintensiven Prompt auf der GPT Image 2 Modellseite aus – zitieren Sie einige exakte Zeichenketten, geben Sie das Layout an, führen Sie es aus und korrigieren Sie das Ergebnis. Die erste Generierung ist oft diejenige, die letztlich ausgeliefert wird.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte