
Руководство по использованию
Создание короткого видео с помощью happyhorse-1.1/reference-to-video через API hiapi
Дайте ему несколько референсных изображений одного и того же персонажа — и получите многокадровое видео с согласованным персонажем.
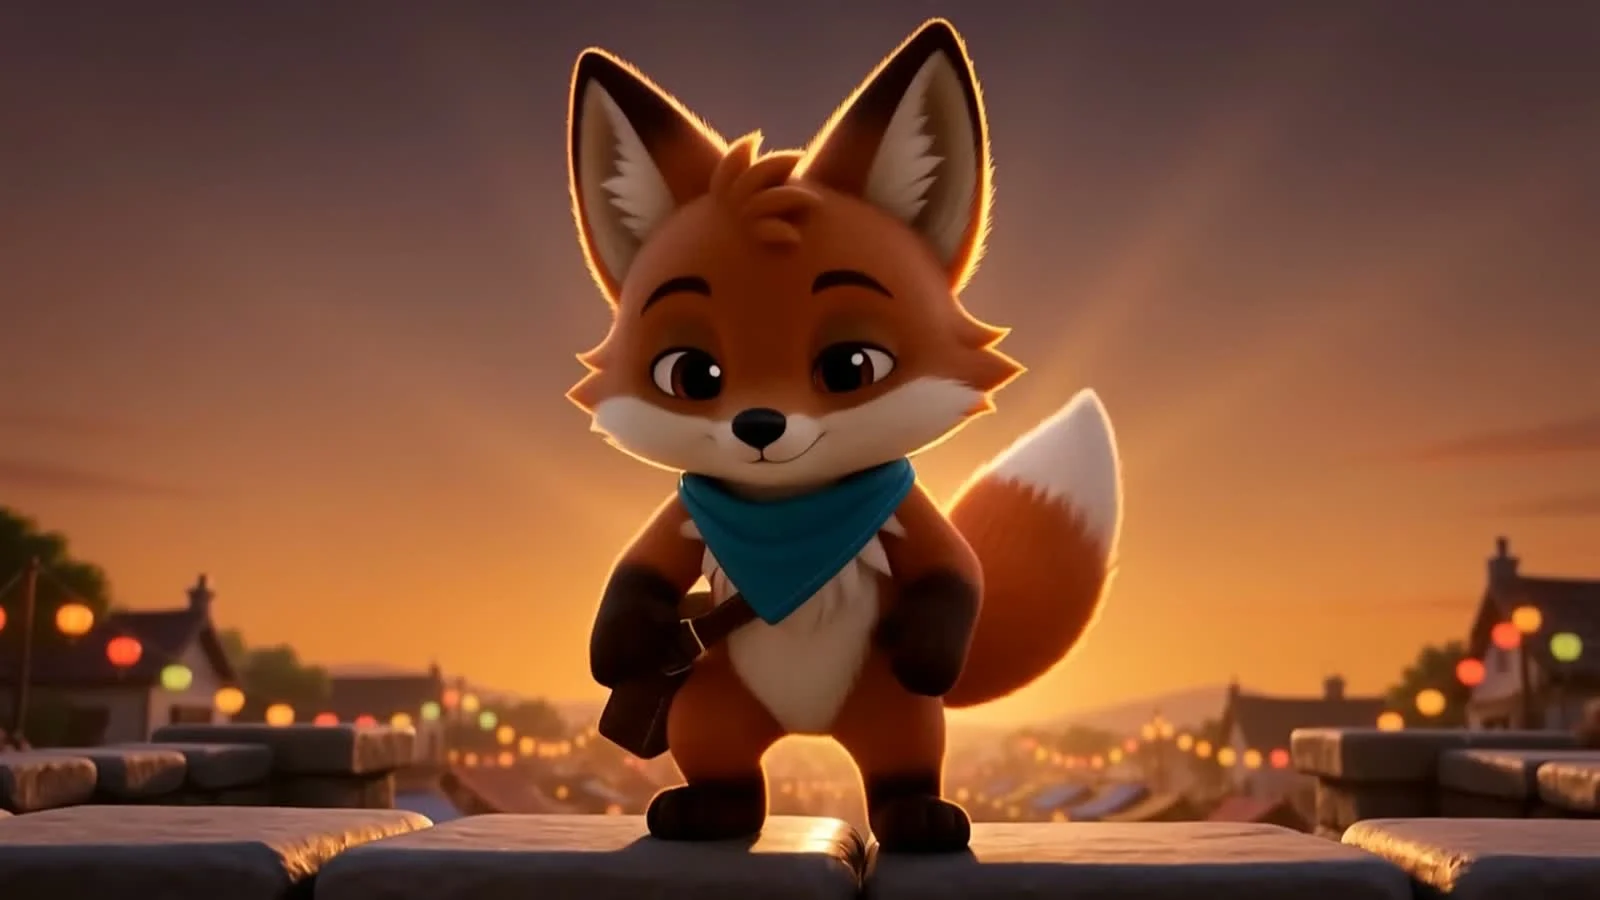
Большинство демонстраций «ИИ-видео» заканчиваются одним фрагментом и одним кадром. Как только вам нужно, чтобы один и тот же персонаж появился во втором или третьем кадре — например, маскот входит в кадр, затем бежит, затем празднует — и генерация видео по тексту, и генерация видео по одному изображению начинают сбиваться: при каждой повторной генерации другое лицо, другая одежда, другое освещение. happyhorse-1.1/reference-to-video в API hiapi создан именно для решения этой конкретной проблемы. Вы даёте ему до 9 референсных изображений одного и того же субъекта плюс промпт, описывающий действие между кадрами, и он возвращает единое непрерывное видео, сохраняя согласованность субъекта на всём протяжении — а не слайд-шоу из отдельных анимаций, склеенных в видеоредакторе.
Мы на практике создали и сдали 8-секундный фрагмент в 720p от начала до конца, чтобы посмотреть, как это работает на самом деле: промпт, вызов API, стоимость и результат. Вот полный процесс.
Почему reference-to-video — это другой инструмент
Генерация видео по тексту не даёт модели ничего, за что можно зацепить идентичность, поэтому при повторной генерации по одному и тому же промпту лицо и одежда персонажа могут меняться. Генерация видео по одному изображению закрепляет одну позу, что работает для одного такта, но ломается, как только вашему сюжету нужен второй ракурс или действие, которого не было на исходном изображении. reference-to-video находится посередине: несколько референсных изображений показывают модели один и тот же субъект с нескольких реальных точек зрения — анфас, в динамичной позе, любых, которые вы предоставите — и вместе используют эти изображения как якорь идентичности, позволяя видео пройти через несколько тактов, не теряя нити.
Это делает его подходящим для конкретной и распространённой потребности в коротких видео: объясняющие ролики с маскотом, контент для соцсетей с постоянным персонажем, нарратив с продуктовым персонажем — любой сценарий, где одно и то же «кто» должно продержаться через несколько «что» в одном непрерывном кадре.
Тестовый случай: лис-курьер, три такта
Мы придумали небольшого оригинального персонажа — Bramble, лиса-курьера — и, прежде чем вообще начинать делать видео, сначала сгенерировали два референсных изображения, чтобы установить его идентичность.
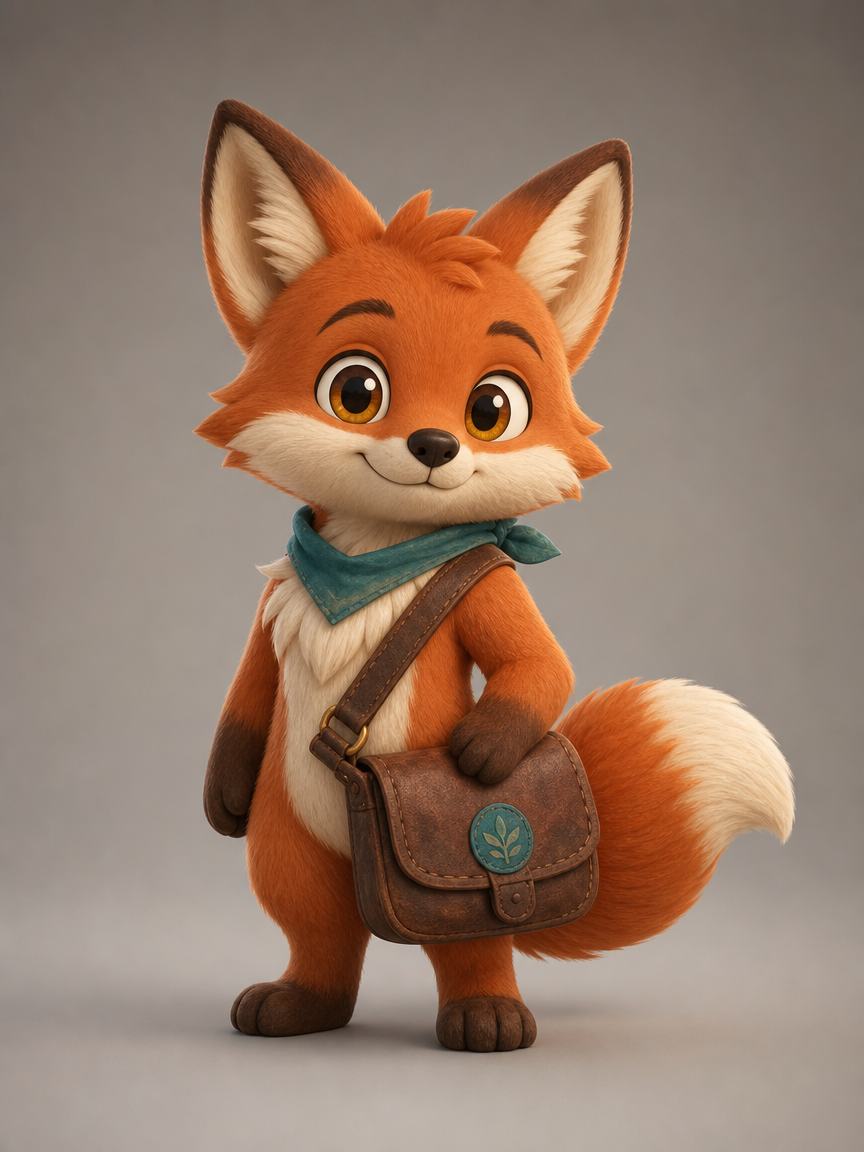
Использованный промпт: «Маленький большеглазый мультяшный лис по имени Bramble: оранжево-рыжая шерсть, кремовая морда и грудь, высокие заострённые уши с кремовой внутренней стороной, бирюзовый шейный платок, потёртая коричневая кожаная курьерская черезплечная сумка с маленьким круглым синим значком на ремне. Стиль 3D-анимационного полнометражного фильма, мягкий тёплый свет, полноростовой вид анфас, нейтральный фон, согласованный дизайн персонажа.»
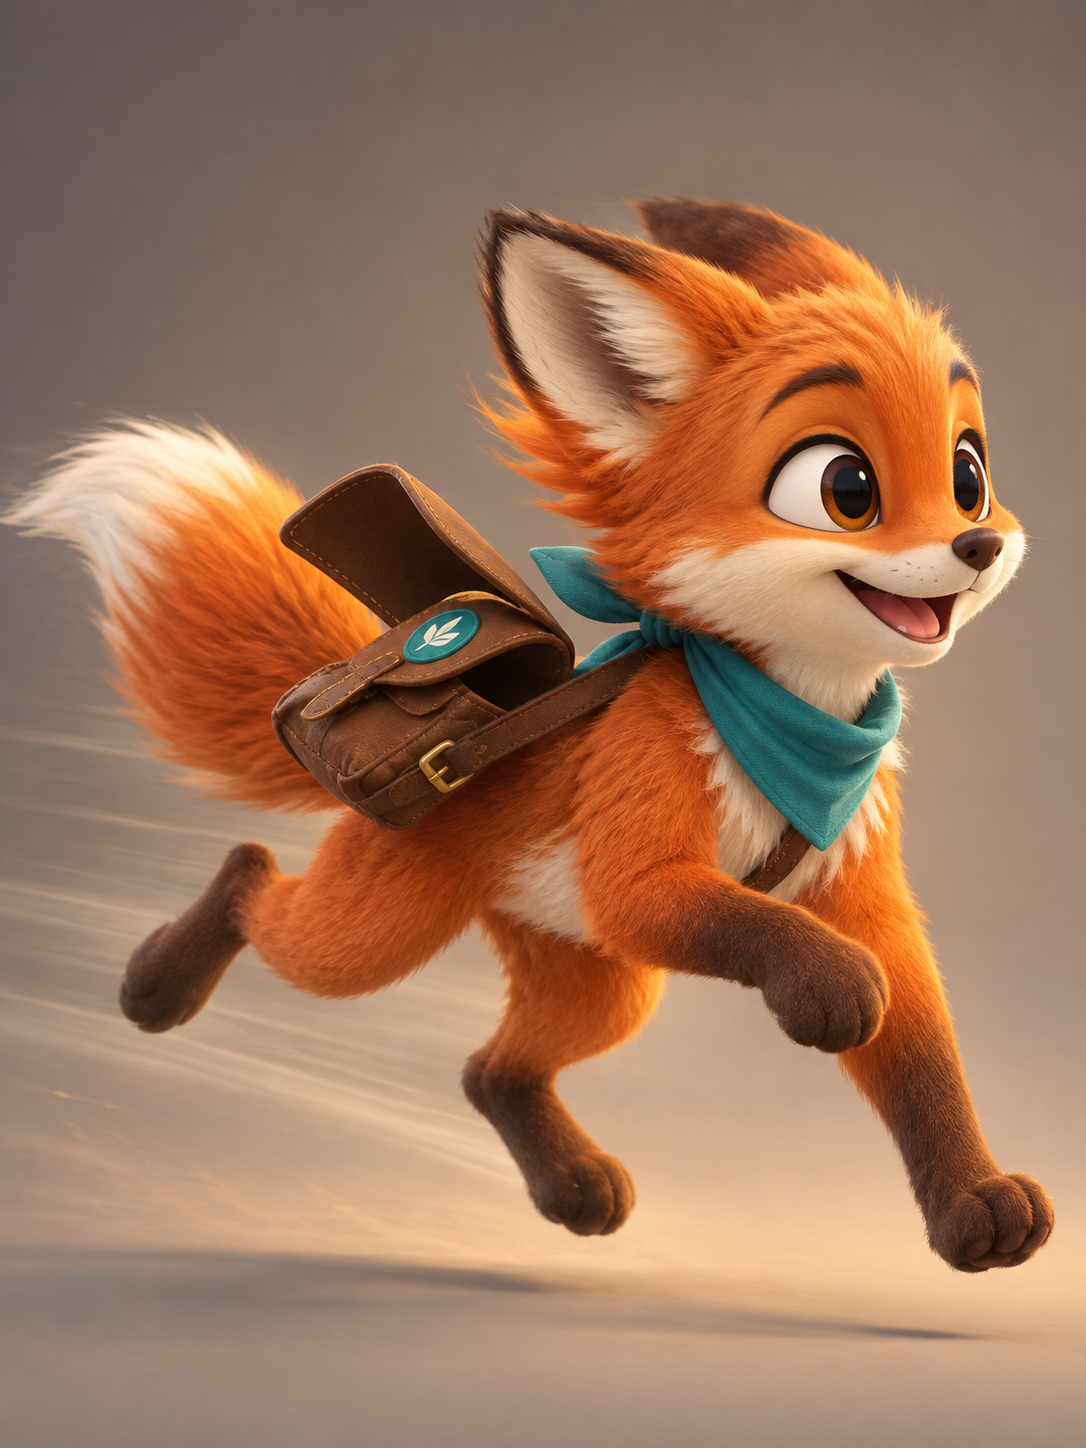
Использованный промпт: «Тот же лис-персонаж Bramble — оранжево-рыжая шерсть, кремовая морда, бирюзовый шейный платок, коричневая кожаная курьерская черезплечная сумка с синим значком — застывший в динамичной позе в беге в три четверти, одна рука выброшена вперёд, хвост развевается сзади, большие выразительные глаза, тот же стиль и пропорции 3D-анимационного полнометражного фильма, что и на референсном листе, нейтральный фон.»
Каждое изображение стоило $0.03 на генерацию. Вместе они составляют весь этап «кастинга» — пока персонаж не зафиксирован, ни одного вызова видео не происходит.
Вызов API
reference-to-video, как и все остальные модели на платформе, — это эндпоинт на основе задач: отправьте задачу, затем опрашивайте до завершения.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "happyhorse-1.1/reference-to-video",
    "input": {
      "prompt": "Bramble the fox courier picks up a glowing gift box at a warm, lantern-lit delivery station and looks at it with delight; cut to Bramble sprinting through a bustling night market strung with red lanterns, package tucked under one arm, tail flying; cut to Bramble standing proudly on a rooftop at golden-hour sunset, package delivered, looking out over the rooftops with a satisfied smile. Consistent character design throughout, cinematic 3D animated feature style, warm lighting, smooth camera motion.",
      "reference_image": [
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/01-bramble-front.png",
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/02-bramble-action.png"
      ],
      "duration": 8,
      "resolution": "720p",
      "aspect_ratio": "16:9"
    }
  }'
Это вернёт taskId. Опрашивайте его, пока status не достигнет терминального состояния:
curl -s https://api.hiapi.ai/v1/tasks/<taskId> \
  -H "Authorization: Bearer $HIAPI_API_KEY"
status последовательно проходит через queued → handling → (иногда) archiving → success или fail. В случае успеха готовый фрагмент — это временный URL в output[0].url — скачивайте сразу, ссылка истекает.
Поля, которые мы подтвердили как рабочие
| Поле | Тип | Использованное значение | Описание |
|---|---|---|---|
prompt |
Строка, обязательно | Описание сцены из 3 тактов | Пишите как мини-раскадровку, а не как одну общую фразу |
reference_image |
Массив URL изображений | 2 изображения | Платформа указывает поддержку до 9 на фрагмент |
duration |
Целое число, секунды | 8 |
Для серии happyhorse-1.1 диапазон 3–15 секунд |
resolution |
Строка | "720p" |
Доступно также "1080p" по более высокой цене |
aspect_ratio |
Строка | "16:9" |
Стандартное перечисление соотношений сторон |
Результат
Обратите внимание на поведение персонажа между склейками: тот же окрас, тот же бирюзовый шейный платок, та же черезплечная сумка с синим значком — от получения посылки в помещении до бега по ночному рынку и до заката на крыше. В этом весь смысл двух референсных изображений вместо одного — при смене сцены модели есть за что зацепиться помимо одного статичного изображения. Фрагмент также автоматически содержит встроенный нативный звук; отдельного аудиополя для настройки нет.
Многоразовый пример на Python
import json
import subprocess
import time

def generate_reference_video(prompt, reference_images, token,
                              duration=8, resolution="720p", aspect_ratio="16:9"):
    payload = {
        "model": "happyhorse-1.1/reference-to-video",
        "input": {
            "prompt": prompt,
            "reference_image": reference_images,
            "duration": duration,
            "resolution": resolution,
            "aspect_ratio": aspect_ratio,
        },
    }
    submit = subprocess.run(
        ["curl", "-s", "-X", "POST", "https://api.hiapi.ai/v1/tasks",
         "-H", f"Authorization: Bearer {token}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, check=True,
    )
    task_id = json.loads(submit.stdout)["data"]["taskId"]

    while True:
        poll = subprocess.run(
            ["curl", "-s", f"https://api.hiapi.ai/v1/tasks/{task_id}",
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, text=True, check=True,
        )
        task = json.loads(poll.stdout)["data"]
        if task["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if task["status"] != "success":
        raise RuntimeError(task.get("error"))
    return task["output"][0]["url"]
Сколько это стоит
| Пункт | Стоимость |
|---|---|
| Референсное изображение (анфас) | $0.03 |
| Референсное изображение (динамичная поза) | $0.03 |
| 8-секундный фрагмент @ 720p ($0.16/сек) | $1.28 |
| Итого для этой демонстрации | $1.34 |
720p стоит $0.16/сек; 1080p — $0.21/сек, поэтому тот же 8-секундный фрагмент в 1080p обойдётся в $1.68. Актуальные полные тарифы всегда на странице цен — сверяйтесь там, прежде чем увеличивать длину фрагмента или разрешение.
Советы по промптам для многокадровой согласованности
- Пишите промпт как список кадров, а не как одно предложение. «Такт 1 → такт 2 → такт 3», каждый такт с чётко описанным действием — именно это действительно задаёт разные кадры внутри одного фрагмента; единое общее описание, наоборот, легко размывается в одно непрерывное движение.
- Сами обеспечьте визуальную согласованность референсных изображений. Модель сохраняет то, что уже согласовано между вашими референсами; она не примиряет несоответствия. Если на вашем изображении анфас и изображении в движении разный оттенок шерсти или отсутствует значок, эта неоднозначность перейдёт в видео.
- Дайте ему позу, которой никогда не было на статичном изображении. Ценность нескольких референсов по сравнению с одним в том, что модель может синтезировать движения и ракурсы за пределами того, что показывает любое отдельное изображение — одного вида анфас плюс одной динамичной позы достаточно, чтобы поддержать и спокойные, и энергичные такты.
- Явно указывайте смены сцены. «Переход к», «затем» и конкретные названия мест в промпте напрямую соответствуют переходам между кадрами, которые вы видите в результате.
Частые вопросы
Сколько референсных изображений можно использовать? До 9 на фрагмент. В этой демонстрации мы использовали 2, и этого хватило, чтобы сохранить идентичность на трёх разных тактах.
Поддерживается ли 1080p? Да — 1080p стоит $0.21/сек против $0.16/сек для 720p.
А если у меня только одно референсное изображение?
Используйте happyhorse-1.1/image-to-video — та же серия, одно стартовое изображение, без многокадрового якоря идентичности.
Есть ли в той же серии вариант чистой генерации видео по тексту?
Да, happyhorse-1.1/text-to-video, с той же секундной ставкой, для случаев, когда у вас вообще нет референсных статичных изображений.
Содержит ли результат звук? Да, нативный звук генерируется автоматически вместе с изображением — отдельные аудиопараметры задавать не нужно.
Какой длины может быть фрагмент? Для серии happyhorse-1.1 — от 3 до 15 секунд; мы использовали 8 секунд, чтобы показать нарратив из трёх тактов.
Главное
happyhorse-1.1/reference-to-videoпревращает 2-9 статичных изображений в одно непрерывное видео, сохраняя одного и того же персонажа, одежду и художественный стиль в каждом кадре.- Полная работающая демонстрация — 2 референсных изображения плюс 8-секундный фрагмент в 720p — стоит $1.34 от начала до конца в API hiapi.
- Помимо промпта модели нужны только три поля:
reference_image(массив URL),duration(3-15 секунд) иresolution(720p или 1080p). - Пишите промпт как список кадров (такт 1 → такт 2 → такт 3), а не как общее описание — именно это действительно задаёт многокадровую структуру.
- Нативный звук генерируется автоматически вместе с видео, без отдельного этапа генерации аудио.
Готовы попробовать на своём персонаже? Начните со страницы модели happyhorse-1.1/reference-to-video или посмотрите похожий рабочий процесс для коротких видео в нашем практическом руководстве по Seedance 2.0 Mini.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков