
Guida all'uso
Creare un video breve con happyhorse-1.1/reference-to-video tramite l'API hiapi
Fornisci alcune immagini di riferimento dello stesso personaggio e otterrai un video multi-inquadratura con un personaggio coerente.
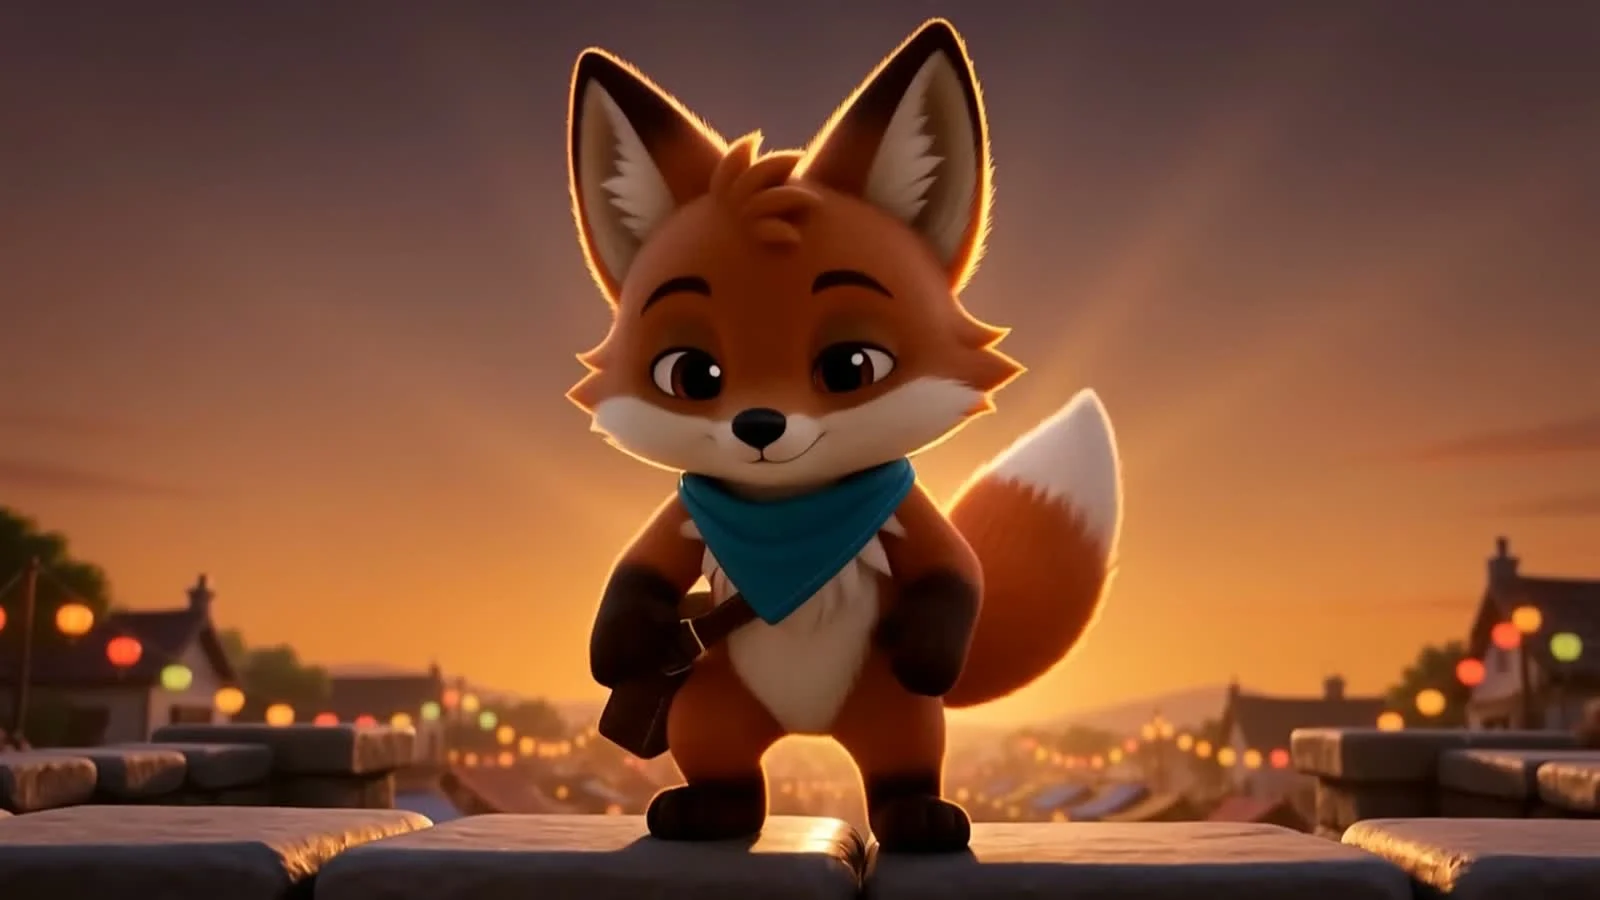
La maggior parte delle demo di "video AI" si esaurisce con un unico filmato e un'unica inquadratura. Nel momento in cui ti serve che lo stesso personaggio compaia nella seconda o terza inquadratura — ad esempio una mascotte che entra nell'inquadratura, poi corre, poi festeggia — sia il text-to-video sia l'image-to-video iniziano a sbagliare: a ogni rigenerazione cambiano volto, abbigliamento e illuminazione. happyhorse-1.1/reference-to-video su API hiapi esiste proprio per risolvere questo problema specifico. Gli fornisci fino a 9 immagini di riferimento dello stesso soggetto, più un prompt che descrive l'azione attraverso le inquadrature, e restituisce un singolo video continuo che mantiene il soggetto coerente per tutta la durata — non una presentazione di animazioni separate montate insieme nel software di editing.
Abbiamo realizzato e consegnato davvero una clip di 8 secondi a 720p dall'inizio alla fine, per vedere come funziona in pratica: prompt, chiamata API, costi e output. Ecco il processo completo.
Perché reference-to-video è uno strumento diverso
Il text-to-video non dà al modello nulla a cui ancorare l'identità, quindi rigenerando lo stesso prompt il volto e l'abbigliamento del personaggio possono cambiare. L'image-to-video ancora una posa, il che funziona per un singolo momento, ma non appena la tua storia richiede una seconda angolazione o un'azione che l'immagine di partenza non mostra mai, smette di funzionare. Il reference-to-video sta nel mezzo: più immagini di riferimento mostrano al modello lo stesso soggetto da più angolazioni reali — frontale, posa in azione, tutto ciò che fornisci — e le usa insieme come ancoraggio dell'identità, così il video può attraversare più momenti senza perdere il filo.
Questo lo rende adatto a un'esigenza specifica e comune dei video brevi: clip di presentazione con mascotte, contenuti social con un personaggio ricorrente, narrazione con un personaggio di prodotto — qualsiasi situazione in cui lo stesso "chi" deve reggere più "cosa" all'interno di un'unica ripresa continua.
Caso di test: una volpe corriere, tre momenti
Abbiamo ideato un piccolo personaggio originale — Bramble, una volpe corriere — e, prima ancora di iniziare a fare il video, abbiamo generato due immagini di riferimento per stabilirne l'identità.
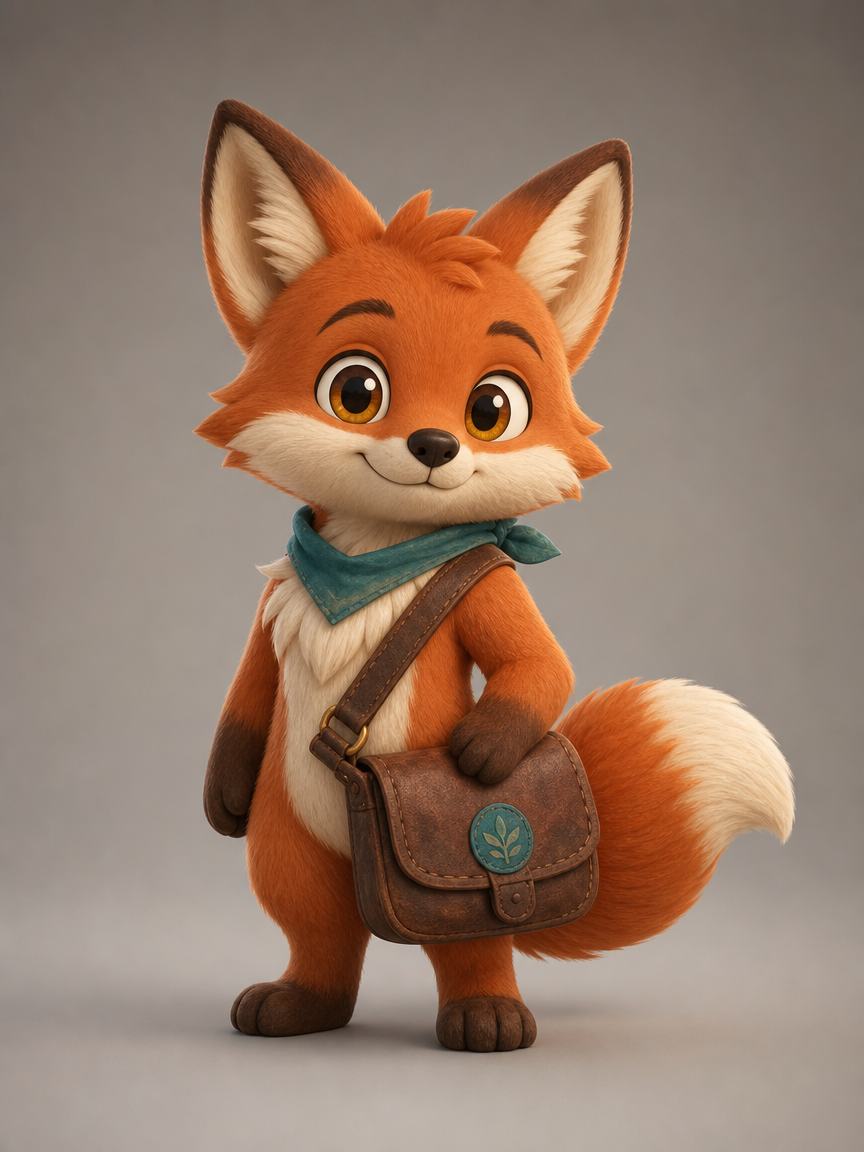
Prompt utilizzato: "Un piccolo personaggio volpe dei cartoni animati con grandi occhi di nome Bramble: pelo arancione-rossastro, muso e petto color crema, orecchie alte e appuntite con l'interno color crema, indossa una bandana verde acqua e porta una vecchia borsa a tracolla in pelle marrone da corriere, con una piccola spilla rotonda blu sulla cinghia. Stile lungometraggio d'animazione 3D, luce calda e morbida, posa di rotazione a figura intera rivolta verso l'osservatore, sfondo neutro uniforme, design del personaggio coerente."
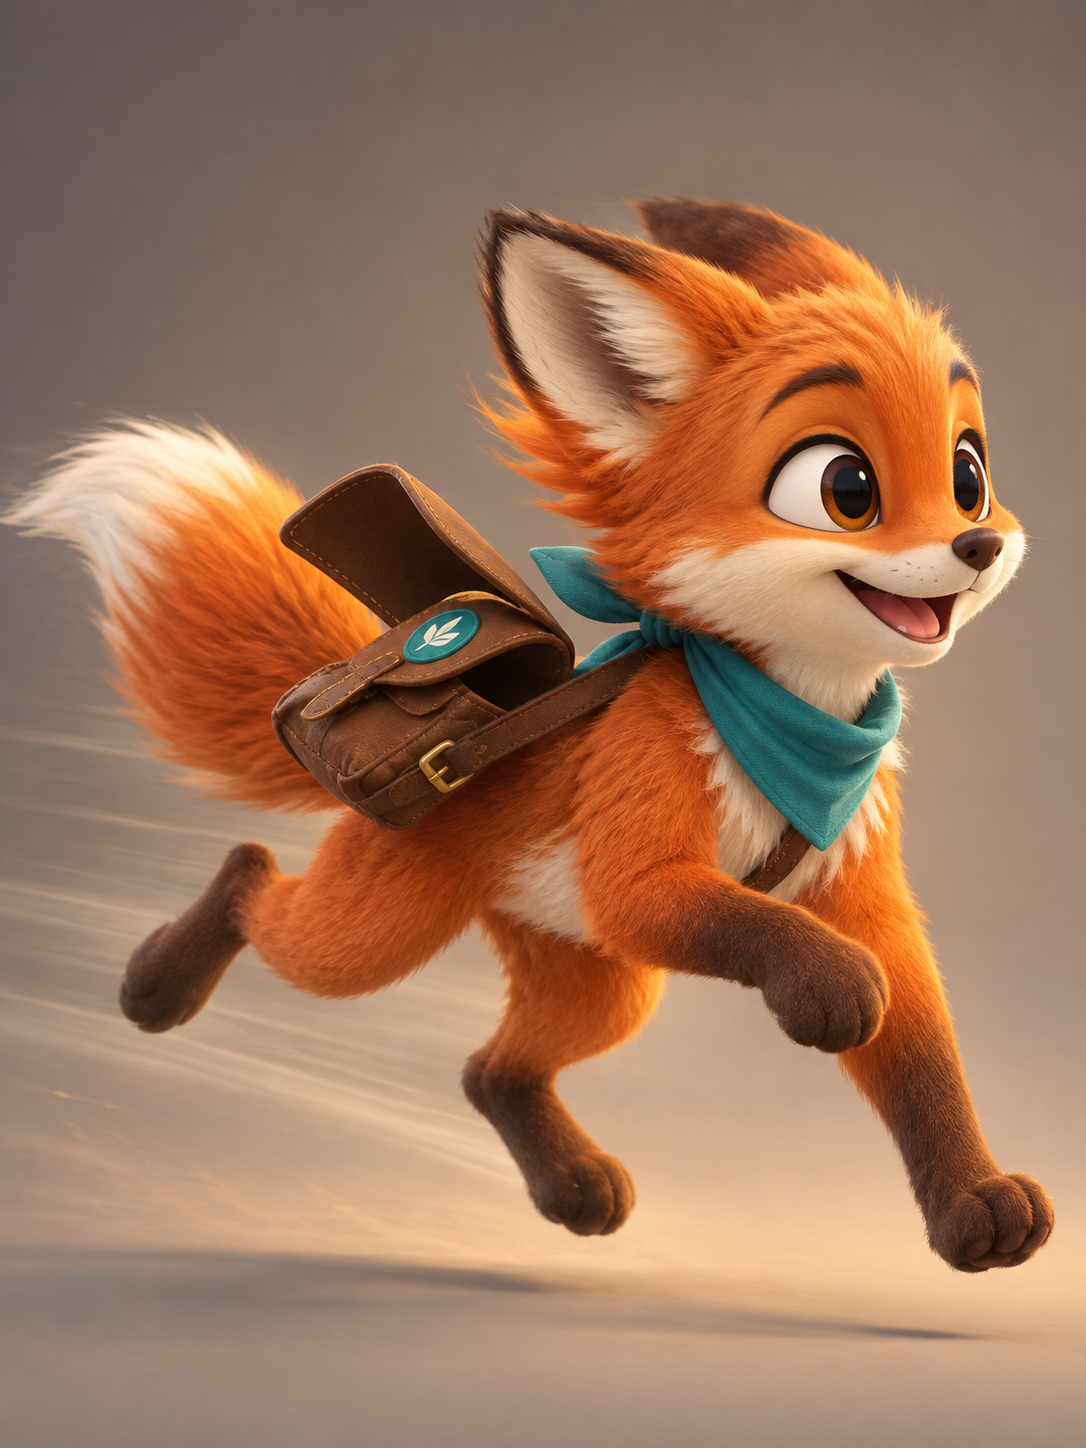
Prompt utilizzato: "Lo stesso personaggio volpe Bramble — pelo arancione-rossastro, muso color crema, bandana verde acqua, borsa a tracolla in pelle marrone da corriere con spilla blu — colto in corsa in una dinamica posa d'azione di tre quarti, un braccio slanciato in avanti, coda che ondeggia all'indietro, grandi occhi espressivi, stesso stile e proporzioni da lungometraggio d'animazione 3D del foglio di riferimento, sfondo neutro uniforme."
Ciascuna immagine è costata $0.03 da generare. Insieme costituiscono l'intera fase di "casting" — finché il personaggio non è fissato, non avviene nessuna chiamata video.
Chiamare l'API
reference-to-video, come tutti gli altri modelli della piattaforma, è un endpoint basato su task: invii e poi fai polling finché non è completato.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "happyhorse-1.1/reference-to-video",
    "input": {
      "prompt": "Bramble the fox courier picks up a glowing gift box at a warm, lantern-lit delivery station and looks at it with delight; cut to Bramble sprinting through a bustling night market strung with red lanterns, package tucked under one arm, tail flying; cut to Bramble standing proudly on a rooftop at golden-hour sunset, package delivered, looking out over the rooftops with a satisfied smile. Consistent character design throughout, cinematic 3D animated feature style, warm lighting, smooth camera motion.",
      "reference_image": [
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/01-bramble-front.png",
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/02-bramble-action.png"
      ],
      "duration": 8,
      "resolution": "720p",
      "aspect_ratio": "16:9"
    }
  }'
Restituisce un taskId. Fai polling finché status non raggiunge uno stato terminale:
curl -s https://api.hiapi.ai/v1/tasks/<taskId> \
  -H "Authorization: Bearer $HIAPI_API_KEY"
status passa in sequenza da queued → handling → (a volte) archiving → success o fail. In caso di successo, la clip completata è un URL temporaneo su output[0].url — scaricala subito, il link scade.
Campi che abbiamo verificato come funzionanti
| Campo | Tipo | Valore usato | Note |
|---|---|---|---|
prompt |
Stringa, obbligatorio | Descrizione delle inquadrature in 3 momenti | Scrivilo come una mini lista di storyboard, non come una frase generica |
reference_image |
Array di URL di immagini | 2 immagini | La piattaforma indica il supporto di un massimo di 9 per clip |
duration |
Intero, secondi | 8 |
La serie happyhorse-1.1 va da 3 a 15 secondi |
resolution |
Stringa | "720p" |
Anche "1080p" è disponibile, a un prezzo più alto |
aspect_ratio |
Stringa | "16:9" |
Enumerazione standard dei rapporti d'aspetto |
Risultato
Osserva il comportamento del personaggio tra un taglio e l'altro: stesso colore del pelo, stessa bandana verde acqua, stessa borsa a tracolla con spilla blu, dal ritiro in interni alla corsa nel mercato notturno fino al tramonto sul tetto. È proprio questo il senso di dargli due immagini di riferimento invece di una: di fronte a un cambio di scena, il modello ha più cose a cui ancorarsi rispetto a una singola immagine statica. La clip include inoltre automaticamente audio nativo; non c'è alcun campo audio separato da configurare.
Esempio Python riutilizzabile
import json
import subprocess
import time

def generate_reference_video(prompt, reference_images, token,
                              duration=8, resolution="720p", aspect_ratio="16:9"):
    payload = {
        "model": "happyhorse-1.1/reference-to-video",
        "input": {
            "prompt": prompt,
            "reference_image": reference_images,
            "duration": duration,
            "resolution": resolution,
            "aspect_ratio": aspect_ratio,
        },
    }
    submit = subprocess.run(
        ["curl", "-s", "-X", "POST", "https://api.hiapi.ai/v1/tasks",
         "-H", f"Authorization: Bearer {token}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, check=True,
    )
    task_id = json.loads(submit.stdout)["data"]["taskId"]

    while True:
        poll = subprocess.run(
            ["curl", "-s", f"https://api.hiapi.ai/v1/tasks/{task_id}",
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, text=True, check=True,
        )
        task = json.loads(poll.stdout)["data"]
        if task["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if task["status"] != "success":
        raise RuntimeError(task.get("error"))
    return task["output"][0]["url"]
Quanto costa
| Voce | Costo |
|---|---|
| Immagine di riferimento (frontale) | $0.03 |
| Immagine di riferimento (posa in azione) | $0.03 |
| Clip di 8 secondi @ 720p ($0.16/secondo) | $1.28 |
| Totale di questa demo | $1.34 |
720p costa $0.16/secondo; 1080p costa $0.21/secondo, quindi la stessa clip di 8 secondi a 1080p costerebbe $1.68. Le tariffe complete aggiornate sono sempre nella pagina dei prezzi — controlla lì prima di aumentare la durata o la risoluzione delle clip.
Consigli sui prompt per la coerenza multi-inquadratura
- Scrivi il prompt come una lista di inquadrature, non come una frase. "Momento 1 → momento 2 → momento 3", ciascuno con un'azione chiara, è ciò che guida davvero inquadrature diverse all'interno di una clip — una singola descrizione generica tende invece a sfumare in un movimento continuo.
- Garantisci tu stesso la coerenza visiva tra le immagini di riferimento. Il modello preserva ciò che è già coerente tra le tue immagini di riferimento; non concilia le incoerenze. Se la tua immagine frontale e quella in azione hanno tonalità di pelo diverse o mancano della spilla, quell'ambiguità si trasferisce nel video.
- Fornisci una posa che l'immagine statica non mostra mai. Il valore delle immagini di riferimento multiple rispetto a una sola sta nel fatto che il modello può sintetizzare azioni e angolazioni che vanno oltre quanto mostrato da qualsiasi singola immagine — un'immagine frontale di rotazione più una posa in azione bastano a sostenere momenti calmi e momenti energici.
- Indica esplicitamente i cambi di scena. "Stacco su", "poi" e nomi di luoghi specifici nel prompt corrispondono direttamente ai cambi di inquadratura che vedi nell'output.
Domande frequenti
Quante immagini di riferimento posso usare? Fino a 9 per clip. In questa demo ne abbiamo usate 2, sufficienti a mantenere l'identità attraverso tre momenti diversi.
È supportato il 1080p? Sì — il 1080p costa $0.21/secondo, contro $0.16/secondo del 720p.
E se ho una sola immagine di riferimento?
Usa happyhorse-1.1/image-to-video — stessa serie, immagine iniziale singola, nessun ancoraggio dell'identità da più immagini di riferimento.
C'è un'opzione puramente text-to-video nella stessa serie?
Sì, happyhorse-1.1/text-to-video, con la stessa tariffa al secondo, adatta ai casi in cui non hai affatto un'immagine statica di riferimento.
L'output include l'audio? Sì, l'audio nativo viene generato automaticamente insieme alle immagini — non ci sono parametri audio separati da impostare.
Quanto può essere lunga una clip? La serie happyhorse-1.1 va da 3 a 15 secondi; noi ne abbiamo usati 8 per raccontare una narrazione in tre momenti.
Punti chiave
happyhorse-1.1/reference-to-videotrasforma 2-9 immagini statiche in un video continuo, mantenendo lo stesso personaggio, abbigliamento e stile artistico in ogni inquadratura.- Una demo completa e funzionante — 2 immagini di riferimento più una clip di 8 secondi a 720p — costa $1.34 end-to-end sull'API hiapi.
- Oltre al prompt, il modello richiede solo tre campi:
reference_image(array di URL),duration(3-15 secondi) eresolution(720p o 1080p). - Scrivi il prompt come una lista di inquadrature (momento 1 → momento 2 → momento 3), non come una descrizione generica — è questo che guida davvero la struttura multi-inquadratura.
- L'audio nativo viene generato automaticamente insieme al video, senza bisogno di un passaggio separato di generazione audio.
Vuoi provarlo sui tuoi personaggi? Inizia dalla pagina del modello happyhorse-1.1/reference-to-video, oppure dai un'occhiata a un flusso di lavoro simile per video brevi nel nostro tutorial pratico su Seedance 2.0 Mini.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori