
使用ガイド
happyhorse-1.1/reference-to-video で hiapi API を使ってショート動画を制作する
同じキャラクターの参照画像を数枚渡すだけで、キャラクターが一貫したマルチショット動画が得られます。
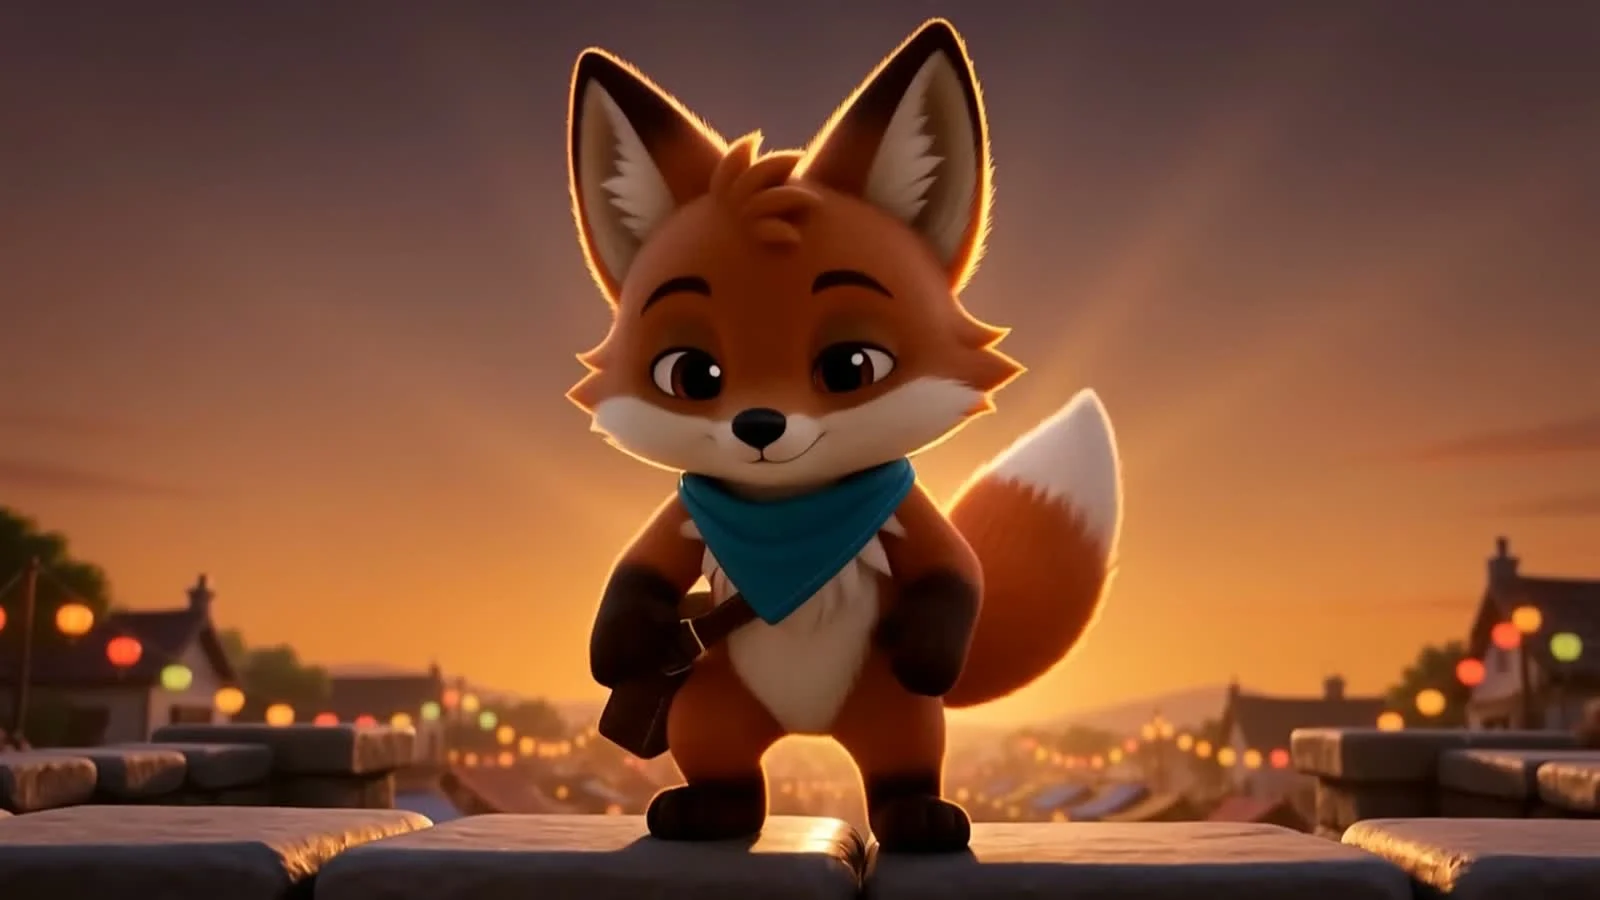
ほとんどの「AI 動画」デモは、1 本の素材、1 つのショットで終わります。しかし、同じキャラクターを 2 つ目、3 つ目のショットに登場させたい瞬間——たとえばマスコットが画面に入り、走り出し、そして祝う——テキスト・トゥ・ビデオも単一画像・トゥ・ビデオも破綻し始めます。再生成のたびに顔が違い、服装が違い、ライティングも違ってしまうからです。hiapi API 上の happyhorse-1.1/reference-to-video は、まさにこの具体的な問題を解決するためにあります。同じ主体の参照画像を最大 9 枚と、ショットをまたぐ動きを記述したプロンプトを渡すと、主体が一貫したまま連続した 1 本の動画を返します——編集ソフトで別々のアニメーションをつなぎ合わせたスライドショーではありません。
私たちは実際に 8 秒・720p のクリップを最初から最後まで制作し、納品して、実際の仕上がりを確認しました:プロンプト、API 呼び出し、コスト、出力です。以下がその全工程です。
reference-to-video が別のツールである理由
テキスト・トゥ・ビデオはモデルにアイデンティティを固定するものを何も与えないため、同じプロンプトで再生成するとキャラクターの顔や服装が変わり得ます。単一画像・トゥ・ビデオは1 つのポーズを固定するので単一のビートには有効ですが、物語が 2 つ目のアングルを必要としたり、元画像が決して見せなかった動きを必要としたりすると破綻します。reference-to-video はその中間です:複数の参照画像によってモデルは同じ主体を複数の実在する視点——正面、アクションポーズ、あなたが提供したものすべて——から見て、それらの画像をまとめてアイデンティティのアンカーとすることで、動画は複数のビートを経ても手がかりを失わずに進めます。
これにより、特定かつよくあるショート動画のニーズに適しています:マスコット解説クリップ、レギュラーキャラクターのソーシャルコンテンツ、プロダクトキャラクターのストーリーテリング——同じ「誰」が 1 つの連続ショットの中で複数の「何をする」を乗り切らなければならないあらゆる場面です。
テストケース:配達ギツネ、3 つのビート
小さなオリジナルキャラクター——配達ギツネの Bramble——をデザインし、動画制作を本格的に始める前に、まず 2 枚の参照画像を生成してそのアイデンティティを確立しました。
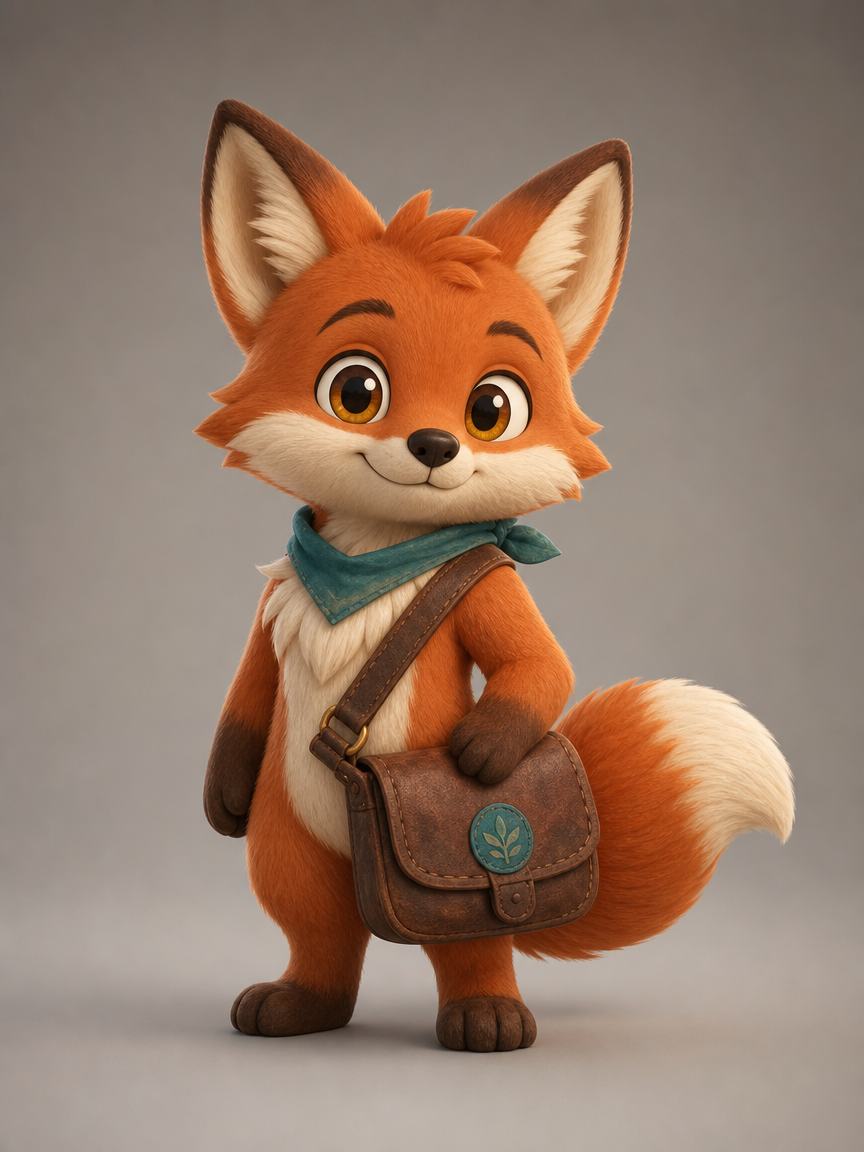
使用したプロンプト:「Bramble という名前の小柄で大きな目のカートゥーンギツネのキャラクター:オレンジレッドの毛、クリーム色の口元と胸、内側がクリーム色の高く尖った耳、青緑色のスカーフを付け、使い込まれた茶色の革製メッセンジャーバッグを背負い、ストラップには小さな丸い青いバッジが付いている。3D アニメーション長編映画スタイル、柔らかな暖色の光、カメラに向かって正面向きの全身ターンアラウンドポーズ、無地のニュートラルな背景、一貫したキャラクターデザイン。」
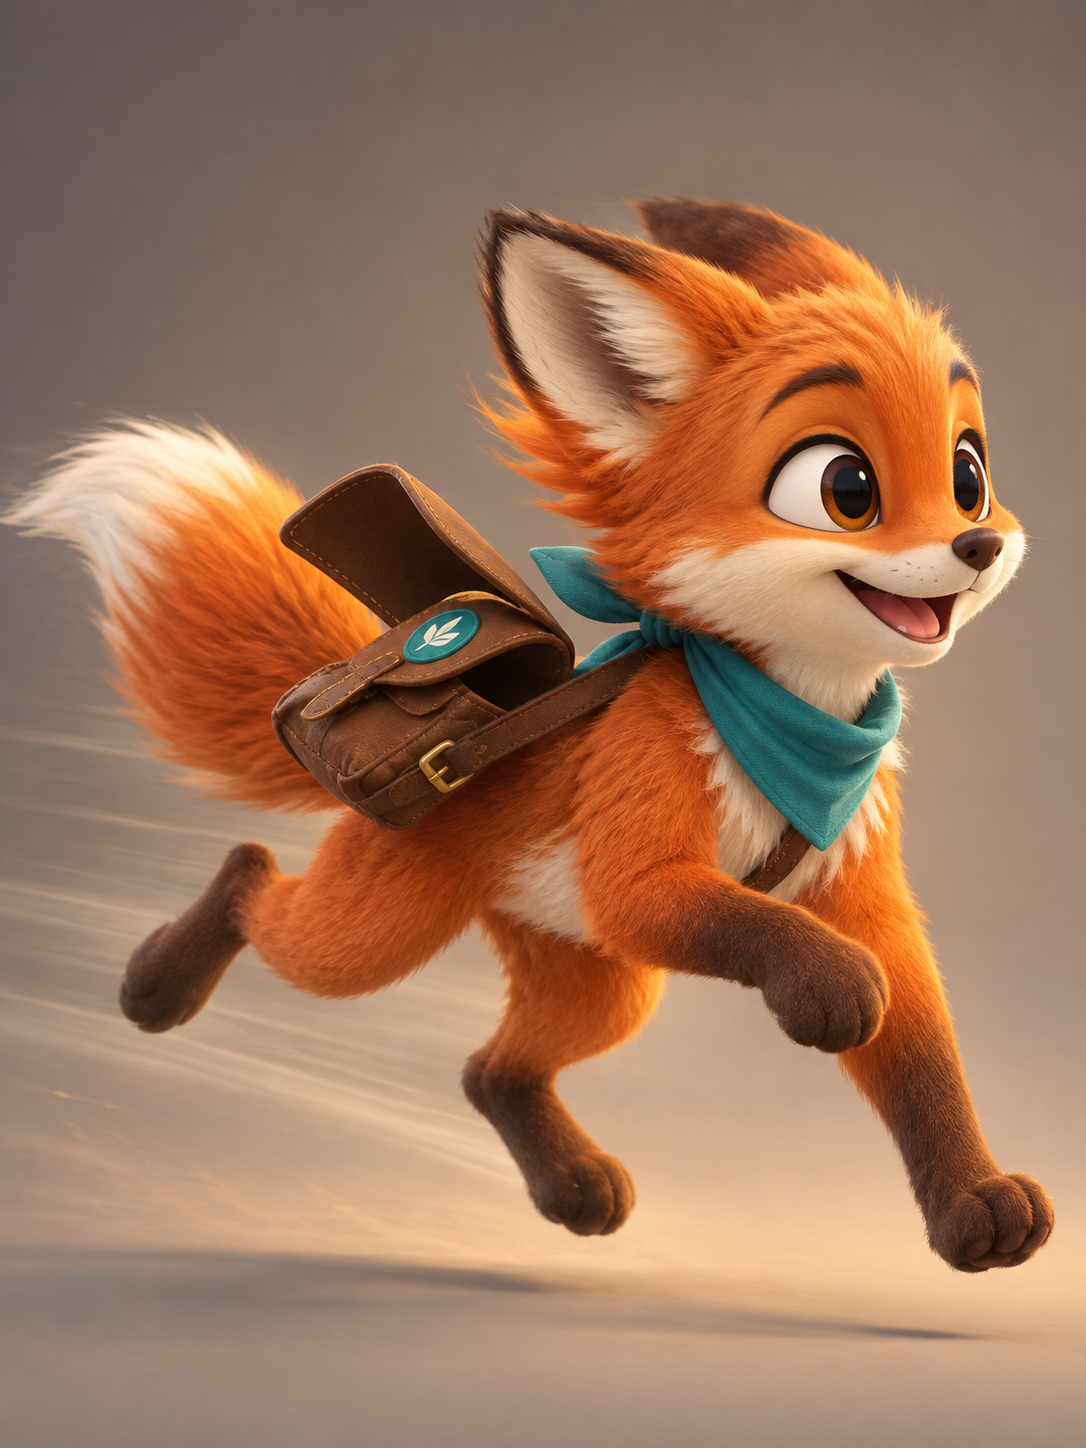
使用したプロンプト:「同じギツネのキャラクター Bramble——オレンジレッドの毛、クリーム色の口元、青緑色のスカーフ、青いバッジ付きの茶色の革製メッセンジャーバッグ——走っている最中の動的な 4 分の 3 側面のアクションポーズで静止させ、片腕を前に振り、尻尾を後ろになびかせ、大きく表情豊かな目、参照設定画と同じ 3D アニメーション長編映画スタイルとプロポーション、無地のニュートラルな背景。」
2 枚の画像はそれぞれ $0.03 で生成されました。これらを合わせて「キャスティング」工程のすべてです——キャラクターが確定する前に、動画の呼び出しは一切発生しません。
API を呼び出す
reference-to-video はプラットフォーム上の他のすべてのモデルと同様、タスクベースのエンドポイントです:送信し、完了するまでポーリングします。
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "happyhorse-1.1/reference-to-video",
    "input": {
      "prompt": "Bramble the fox courier picks up a glowing gift box at a warm, lantern-lit delivery station and looks at it with delight; cut to Bramble sprinting through a bustling night market strung with red lanterns, package tucked under one arm, tail flying; cut to Bramble standing proudly on a rooftop at golden-hour sunset, package delivered, looking out over the rooftops with a satisfied smile. Consistent character design throughout, cinematic 3D animated feature style, warm lighting, smooth camera motion.",
      "reference_image": [
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/01-bramble-front.png",
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/02-bramble-action.png"
      ],
      "duration": 8,
      "resolution": "720p",
      "aspect_ratio": "16:9"
    }
  }'
これで taskId が返ります。status が終了状態になるまでポーリングします:
curl -s https://api.hiapi.ai/v1/tasks/<taskId> \
  -H "Authorization: Bearer $HIAPI_API_KEY"
status は queued → handling →(場合によっては)archiving → success または fail と遷移します。成功時、完成したクリップは output[0].url 上の期限付き URL です——すぐにダウンロードしてください、リンクは失効します。
動作を確認したフィールド
| フィールド | 型 | 使用した値 | 説明 |
|---|---|---|---|
prompt |
文字列、必須 | 3 つのビートのショット記述 | 漠然とした一文ではなく、ミニ絵コンテリストのように書く |
reference_image |
画像 URL の配列 | 画像 2 枚 | プラットフォームの説明ではクリップごとに最大 9 枚まで対応 |
duration |
整数、秒 | 8 |
happyhorse-1.1 シリーズの範囲は 3〜15 秒 |
resolution |
文字列 | "720p" |
"1080p" も利用可能、価格は高め |
aspect_ratio |
文字列 | "16:9" |
標準的なアスペクト比の列挙値 |
結果
カット間でキャラクターがどう振る舞うかを見てください:室内での受け取りから夜市の疾走、屋上の夕日まで、同じ毛色、同じ青緑色のスカーフ、同じ青いバッジ付きのバッグです。参照画像を 1 枚ではなく 2 枚渡すことの意義はまさにここにあります——シーンが切り替わっても、モデルは単一の静止画よりも多くのものをアンカーにできます。このクリップにはネイティブ音声も自動的に組み込まれます;設定すべき個別の音声フィールドはありません。
再利用可能な Python サンプル
import json
import subprocess
import time

def generate_reference_video(prompt, reference_images, token,
                              duration=8, resolution="720p", aspect_ratio="16:9"):
    payload = {
        "model": "happyhorse-1.1/reference-to-video",
        "input": {
            "prompt": prompt,
            "reference_image": reference_images,
            "duration": duration,
            "resolution": resolution,
            "aspect_ratio": aspect_ratio,
        },
    }
    submit = subprocess.run(
        ["curl", "-s", "-X", "POST", "https://api.hiapi.ai/v1/tasks",
         "-H", f"Authorization: Bearer {token}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, check=True,
    )
    task_id = json.loads(submit.stdout)["data"]["taskId"]

    while True:
        poll = subprocess.run(
            ["curl", "-s", f"https://api.hiapi.ai/v1/tasks/{task_id}",
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, text=True, check=True,
        )
        task = json.loads(poll.stdout)["data"]
        if task["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if task["status"] != "success":
        raise RuntimeError(task.get("error"))
    return task["output"][0]["url"]
コストはいくらか
| 項目 | コスト |
|---|---|
| 参照画像(正面) | $0.03 |
| 参照画像(アクションポーズ) | $0.03 |
| 8 秒クリップ @ 720p($0.16/秒) | $1.28 |
| 本デモの合計 | $1.34 |
720p は $0.16/秒;1080p は $0.21/秒なので、同じ 8 秒クリップを 1080p で作ると $1.68 かかります。最新の完全な料金は常に料金ページにあります——クリップの長さや解像度を拡大する前にそちらを確認してください。
マルチショット一貫性のためのプロンプトのコツ
- プロンプトは一文ではなくショットリストとして書く。「ビート 1 → ビート 2 → ビート 3」と、各ビートに明確な動作動詞を持たせることこそが、1 つのクリップ内の異なるショットを実際に駆動します——単一の漠然とした記述はむしろ 1 つの連続した動きにぼやけがちです。
- 参照画像間の視覚的一貫性は自分で確保する。モデルは参照画像間ですでに一貫している部分を保持します;不一致を調和させることはしません。正面図とアクション図で毛色の濃淡が異なったりバッジが欠けていたりすると、その曖昧さが動画に引き継がれます。
- 静止画が決して見せなかったポーズを与える。複数参照画像の単一画像に対する価値は、モデルがどの単一画像が示す以上に動作とアングルを合成できることです——正面向きのターンアラウンド図 1 枚とアクションポーズ図 1 枚で、穏やかなビートと活気あるビートの両方を支えるのに十分です。
- シーンの変化を明示する。プロンプト中の「カットして」「そして」、具体的な場所名は、出力で見られるショット切り替えに直接対応します。
よくある質問
参照画像は何枚まで使えますか? クリップごとに最大 9 枚です。本デモでは 2 枚を使い、3 つの異なるビートでアイデンティティを保つのに十分でした。
1080p は対応していますか? はい——1080p は $0.21/秒、720p は $0.16/秒です。
参照画像が 1 枚しかない場合は?
happyhorse-1.1/image-to-video に切り替えてください——同じシリーズで、開始画像 1 枚、複数参照によるアイデンティティ固定はありません。
同じシリーズに純粋なテキスト・トゥ・ビデオのオプションはありますか?
あります、happyhorse-1.1/text-to-video で、1 秒あたりの料金は同じで、参照用の静止画がまったくない場合に適しています。
出力に音声は含まれますか? 含まれます、ネイティブ音声は映像とともに自動生成されます——設定すべき個別の音声パラメータはありません。
クリップはどのくらいの長さにできますか? happyhorse-1.1 シリーズは 3 秒から 15 秒です;私たちは 3 ビートの物語を表現するために 8 秒を使いました。
要点
happyhorse-1.1/reference-to-videoは 2〜9 枚の静止画を 1 本の連続動画に変え、各ショットで同じキャラクター、服装、アートスタイルを保ちます。- 完全に動作するデモ——参照画像 2 枚と 8 秒の 720p クリップ——は hiapi API 上でエンドツーエンドで $1.34 かかります。
- プロンプト以外に、モデルが必要とするのは 3 つのフィールドだけです:
reference_image(URL 配列)、duration(3〜15 秒)、resolution(720p または 1080p)。 - プロンプトは漠然とした説明ではなくショットリスト(ビート 1 → ビート 2 → ビート 3)として書く——これこそが実際にマルチショット構造を駆動するものです。
- ネイティブ音声は動画とともに自動生成され、別個の音声生成ステップは不要です。
自分のキャラクターで試してみませんか?happyhorse-1.1/reference-to-video モデルページから始めるか、私たちの Seedance 2.0 Mini 実践チュートリアルで同様のショート動画ワークフローをご覧ください。


