
사용 가이드
happyhorse-1.1/reference-to-video로 hiapi API를 통해 숏폼 영상 만들기
같은 캐릭터의 참조 이미지를 몇 장 주면, 캐릭터가 일관된 멀티 샷 영상을 얻을 수 있습니다.
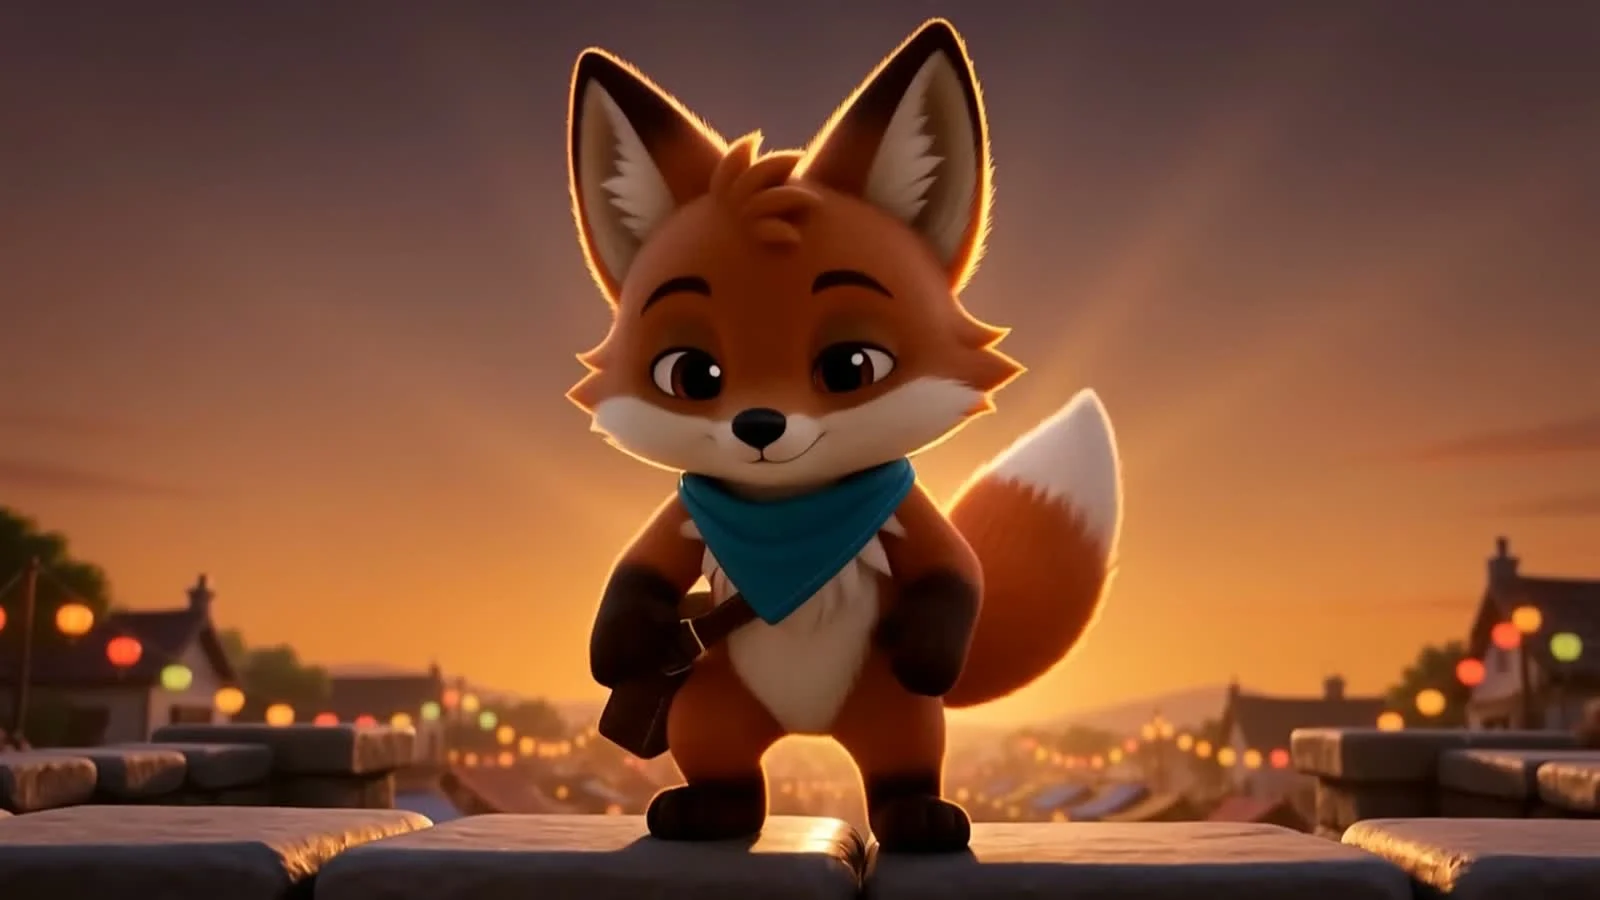
대부분의 "AI 영상" 데모는 소재 하나, 샷 하나로 끝납니다. 하지만 같은 캐릭터가 두 번째나 세 번째 샷에도 등장해야 하는 순간—예를 들어 마스코트가 화면에 들어와 달리고, 그리고 축하하는 장면—텍스트-투-비디오와 단일 이미지-투-비디오는 모두 어긋나기 시작합니다. 다시 생성할 때마다 얼굴이 다르고, 의상이 다르고, 조명도 다릅니다. hiapi API의 happyhorse-1.1/reference-to-video는 바로 이 구체적인 문제를 해결하기 위해 존재합니다. 동일한 피사체의 참조 이미지를 최대 9장, 그리고 샷을 넘나드는 동작을 설명하는 프롬프트를 주면, 피사체 일관성을 처음부터 끝까지 유지한 하나의 연속 영상을 반환합니다—편집 소프트웨어에서 독립적인 애니메이션 몇 개를 이어 붙인 슬라이드 쇼가 아니라요.
우리는 처음부터 끝까지 8초, 720p 클립을 실제로 제작하고 전달해 보며 실제 효과가 어떤지 확인했습니다: 프롬프트, API 호출, 비용, 출력까지. 아래에 전체 과정을 정리합니다.
reference-to-video가 다른 도구인 이유
텍스트-투-비디오는 모델이 정체성을 고정할 대상을 전혀 주지 않기 때문에, 같은 프롬프트로 다시 생성하면 캐릭터의 얼굴과 의상이 바뀔 수 있습니다. 단일 이미지-투-비디오는 하나의 포즈를 고정하는데, 이는 단일 비트에는 효과적이지만 스토리에 두 번째 각도나 원본 이미지에 없던 동작이 필요해지는 순간 무너집니다. reference-to-video는 그 중간에 있습니다: 여러 참조 이미지가 모델에게 동일 피사체를 여러 실제 시점—정면, 동작 포즈, 제공한 무엇이든—에서 보게 하고, 그 이미지들을 함께 정체성 앵커로 사용해 영상이 여러 비트를 거쳐도 실마리를 잃지 않게 합니다.
이 때문에 특정하면서도 흔한 숏폼 수요에 적합합니다: 마스코트 설명 클립, 고정 캐릭터 소셜 콘텐츠, 제품 캐릭터 스토리텔링—같은 "누가"가 하나의 연속 샷 안에서 여러 "무엇을"을 견뎌야 하는 모든 장면입니다.
테스트 사례: 배달 여우, 세 비트
우리는 작은 오리지널 캐릭터—배달 여우 Bramble—을 디자인하고, 영상 제작을 완전히 시작하기 전에 정체성을 확립할 참조 이미지 두 장을 먼저 생성했습니다.
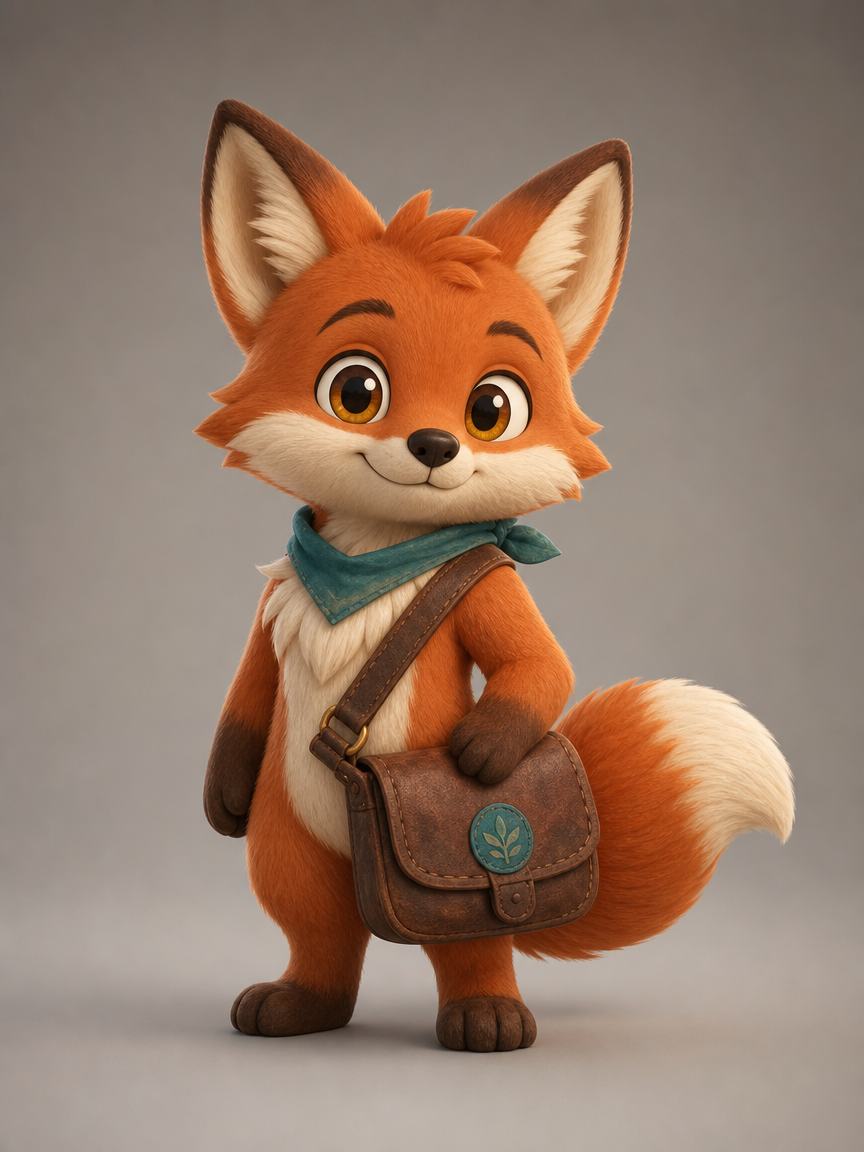
사용한 프롬프트: "Bramble이라는 이름의 작고 큰 눈의 카툰 여우 캐릭터: 주황빛 붉은 털, 크림색 주둥이와 가슴, 크고 뾰족한 귀 안쪽은 크림색, 청록색 스카프를 두르고, 낡은 갈색 가죽 배달 숄더백을 메고 있으며 가방끈에 작고 둥근 파란 배지가 있음. 3D 애니메이션 장편 스타일, 부드러운 따뜻한 조명, 정면을 향한 전신 턴어라운드 포즈, 순수 중립 배경, 일관된 캐릭터 디자인."
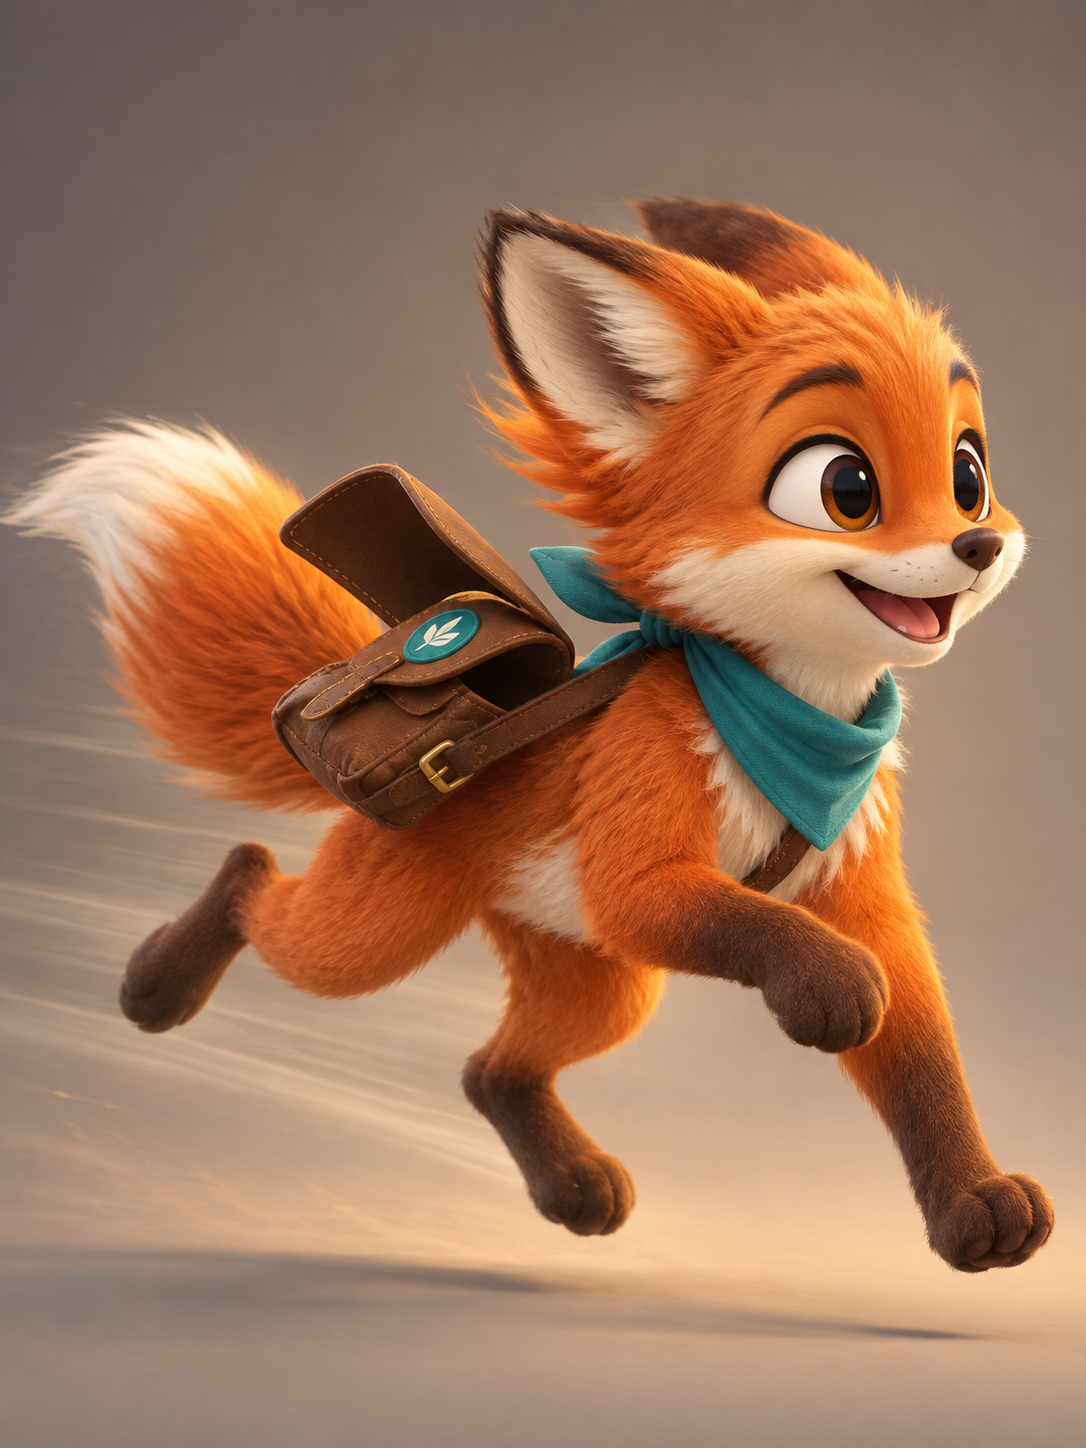
사용한 프롬프트: "같은 여우 캐릭터 Bramble—주황빛 붉은 털, 크림색 주둥이, 청록색 스카프, 파란 배지가 달린 갈색 가죽 배달 숄더백—역동적인 4분의 3 측면 동작 포즈로 달리는 순간을 포착, 한쪽 팔을 앞으로 흔들고 꼬리는 뒤로 날리며, 크고 표정 풍부한 눈, 참조 설정图와 동일한 3D 애니메이션 장편 스타일과 비율, 순수 중립 배경."
두 이미지 각각 생성 비용은 $0.03입니다. 이 둘이 합쳐져 전체 "캐스팅" 단계가 됩니다—캐릭터가 확정되기 전에는 어떤 영상 호출도 발생하지 않습니다.
API 호출하기
reference-to-video는 플랫폼의 다른 모든 모델과 마찬가지로 작업 기반 엔드포인트입니다: 제출한 다음 완료될 때까지 폴링합니다.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "happyhorse-1.1/reference-to-video",
    "input": {
      "prompt": "Bramble the fox courier picks up a glowing gift box at a warm, lantern-lit delivery station and looks at it with delight; cut to Bramble sprinting through a bustling night market strung with red lanterns, package tucked under one arm, tail flying; cut to Bramble standing proudly on a rooftop at golden-hour sunset, package delivered, looking out over the rooftops with a satisfied smile. Consistent character design throughout, cinematic 3D animated feature style, warm lighting, smooth camera motion.",
      "reference_image": [
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/01-bramble-front.png",
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/02-bramble-action.png"
      ],
      "duration": 8,
      "resolution": "720p",
      "aspect_ratio": "16:9"
    }
  }'
이 호출은 taskId를 반환합니다. status가 종료 상태에 도달할 때까지 폴링하세요:
curl -s https://api.hiapi.ai/v1/tasks/<taskId> \
  -H "Authorization: Bearer $HIAPI_API_KEY"
status는 queued → handling → (때때로) archiving → success 또는 fail 순으로 진행됩니다. 성공하면 완성된 클립은 output[0].url의 제한된 시간 URL입니다—즉시 다운로드하세요, 링크는 만료됩니다.
우리가 확인한 사용 가능한 필드
| 필드 | 유형 | 우리가 사용한 값 | 설명 |
|---|---|---|---|
prompt |
문자열, 필수 | 3개 비트의 샷 설명 | 한 줄의 막연한 문장이 아니라 미니 스토리보드 목록처럼 작성하세요 |
reference_image |
이미지 URL 배열 | 이미지 2장 | 플랫폼 설명상 클립당 최대 9장 지원 |
duration |
정수, 초 | 8 |
happyhorse-1.1 시리즈 범위는 3–15초 |
resolution |
문자열 | "720p" |
"1080p"도 사용 가능하나 가격이 더 높음 |
aspect_ratio |
문자열 | "16:9" |
표준 화면 비율 열거형 |
결과
편집 전환 사이에서 캐릭터가 어떻게 보이는지 주목하세요: 동일한 털 색, 동일한 청록색 스카프, 동일한 파란 배지 숄더백이 실내 픽업에서 야시장 달리기, 그리고 옥상의 일몰까지 이어집니다. 참조 이미지를 한 장이 아니라 두 장 준 이유가 바로 여기에 있습니다—장면 전환 앞에서 모델이 단일 정지 이미지보다 더 많은 것을 고정할 수 있습니다. 해당 클립에는 네이티브 오디오도 자동으로 내장됩니다; 구성할 별도의 오디오 필드는 없습니다.
재사용 가능한 Python 예제
import json
import subprocess
import time

def generate_reference_video(prompt, reference_images, token,
                              duration=8, resolution="720p", aspect_ratio="16:9"):
    payload = {
        "model": "happyhorse-1.1/reference-to-video",
        "input": {
            "prompt": prompt,
            "reference_image": reference_images,
            "duration": duration,
            "resolution": resolution,
            "aspect_ratio": aspect_ratio,
        },
    }
    submit = subprocess.run(
        ["curl", "-s", "-X", "POST", "https://api.hiapi.ai/v1/tasks",
         "-H", f"Authorization: Bearer {token}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, check=True,
    )
    task_id = json.loads(submit.stdout)["data"]["taskId"]

    while True:
        poll = subprocess.run(
            ["curl", "-s", f"https://api.hiapi.ai/v1/tasks/{task_id}",
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, text=True, check=True,
        )
        task = json.loads(poll.stdout)["data"]
        if task["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if task["status"] != "success":
        raise RuntimeError(task.get("error"))
    return task["output"][0]["url"]
비용은 얼마인가
| 항목 | 비용 |
|---|---|
| 참조 이미지 (정면) | $0.03 |
| 참조 이미지 (동작 포즈) | $0.03 |
| 8초 클립 @ 720p ($0.16/초) | $1.28 |
| 이 데모 총계 | $1.34 |
720p는 $0.16/초; 1080p는 $0.21/초이므로 동일한 8초 클립을 1080p로 만들면 $1.68이 듭니다. 현재 전체 요금은 항상 가격 페이지에 있습니다—클립 길이나 해상도를 늘리기 전에 그곳을 확인하세요.
멀티 샷 일관성을 위한 프롬프트 팁
- 프롬프트를 한 문장이 아니라 샷 목록으로 작성하세요. "비트 1 → 비트 2 → 비트 3"처럼 각 비트에 명확한 동작 구가 있어야 한 클립 안의 서로 다른 샷을 실제로 이끌어냅니다—단일 막연한 설명은 오히려 하나의 연속 동작으로 흐려지기 쉽습니다.
- 참조 이미지 간의 시각적 일관성은 직접 확보하세요. 모델은 참조 이미지들 사이에서 이미 일관된 부분을 유지합니다; 불일치를 조정하지는 않습니다. 정면 이미지와 동작 이미지의 털 색조가 다르거나 배지가 빠져 있다면, 그 모호함이 영상까지 이어집니다.
- 정지 이미지가 결코 보여주지 않은 포즈를 주세요. 다중 참조 이미지가 단일 이미지보다 나은 가치는 모델이 어떤 단일 이미지가 보여주는 것 이상의 동작과 각도를 합성할 수 있다는 점입니다—정면 턴어라운드 한 장에 동작 포즈 한 장이면 차분한 비트와 활기찬 비트를 모두 뒷받침하기에 충분합니다.
- 장면 변화를 명확히 설명하세요. 프롬프트의 "컷 투", "그다음" 그리고 구체적인 장소 이름은 출력에서 보이는 샷 전환에 직접 대응합니다.
자주 묻는 질문
참조 이미지를 몇 장 사용할 수 있나요? 클립당 최대 9장입니다. 이 데모에서는 2장을 사용했고, 세 가지 다른 비트에서 정체성을 유지하기에 충분했습니다.
1080p를 지원하나요? 지원합니다—1080p 가격은 $0.21/초이고 720p는 $0.16/초입니다.
참조 이미지가 한 장뿐이라면 어떻게 하나요?
happyhorse-1.1/image-to-video를 사용하세요—같은 시리즈, 단일 시작 이미지, 다중 참조 이미지 정체성 앵커링은 없습니다.
같은 시리즈에 순수 텍스트-투-비디오 옵션이 있나요?
있습니다, happyhorse-1.1/text-to-video, 초당 요금은 동일하며 참조 정지 이미지가 전혀 없을 때 적합합니다.
출력에 소리가 포함되나요? 포함됩니다, 네이티브 오디오가 화면과 함께 자동 생성됩니다—설정할 별도의 오디오 파라미터는 없습니다.
클립은 얼마나 길 수 있나요? happyhorse-1.1 시리즈는 3~15초입니다; 우리는 세 비트 내러티브를 담기 위해 8초를 사용했습니다.
핵심 요약
happyhorse-1.1/reference-to-video은 2-9장의 정지 이미지를 하나의 연속 영상으로 바꾸고, 모든 샷에서 동일한 캐릭터, 의상, 아트 스타일을 유지합니다.- 완전히 실행 가능한 데모—참조 이미지 2장에 8초 720p 클립—는 hiapi API에서 엔드투엔드로 $1.34가 듭니다.
- 프롬프트 외에 모델에 필요한 필드는 세 가지뿐입니다:
reference_image(URL 배열),duration(3-15초),resolution(720p 또는 1080p). - 프롬프트를 막연한 설명이 아니라 샷 목록(비트 1 → 비트 2 → 비트 3)으로 작성하세요—이것이 멀티 샷 구조를 실제로 이끄는 요소입니다.
- 네이티브 오디오가 영상과 함께 자동 생성되므로 별도의 오디오 생성 단계가 필요 없습니다.
자신의 캐릭터로 시도해 볼 준비가 되셨나요? happyhorse-1.1/reference-to-video 모델 페이지에서 시작하거나, Seedance 2.0 Mini 실전 튜토리얼에서 유사한 숏폼 워크플로를 살펴보세요.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트