
使用指南
使用 happyhorse-1.1/reference-to-video 通过 hiapi API 制作短视频
给它几张同一个角色的参考图,就能得到一段角色一致的多镜头视频。
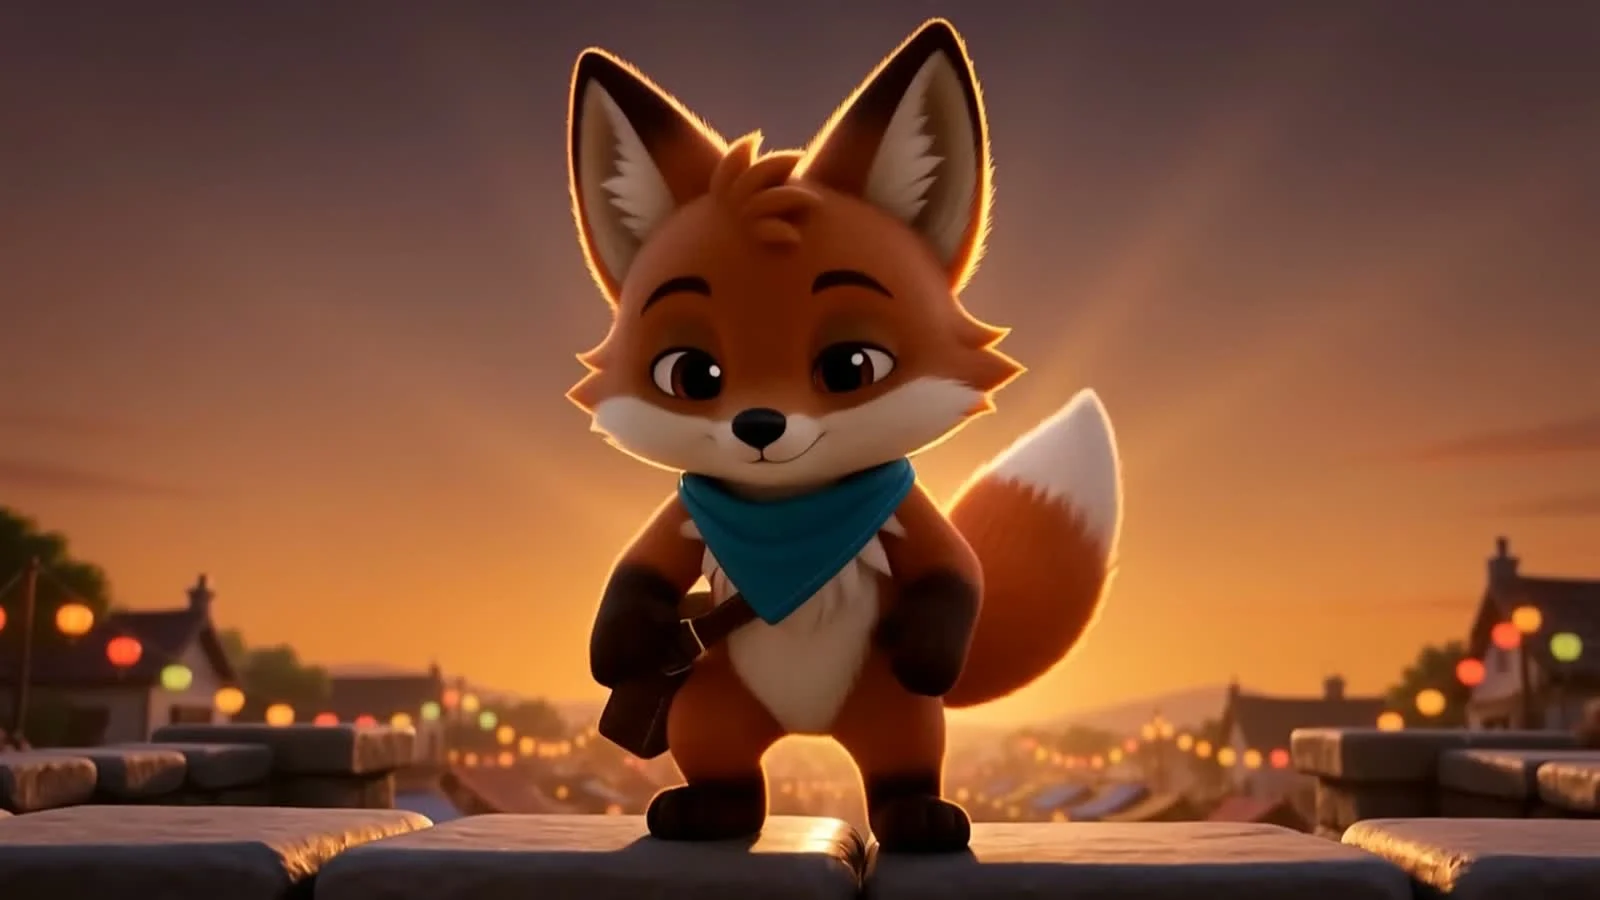
大多数"AI 视频"演示都是一段素材、一个镜头就结束了。一旦你需要同一个角色出现在第二个或第三个镜头里——比如一个吉祥物走进画面,然后狂奔,然后庆祝——文生视频和单图生视频都开始跑偏:每次重新生成,脸不一样、服装不一样、布光也不一样。hiapi API 上的 happyhorse-1.1/reference-to-video 正是为了解决这个具体问题。你给它最多 9 张同一主体的参考图,再加一段描述跨镜头动作的提示词,它就会返回一段连续的单个视频,全程保持主体一致——而不是在剪辑软件里把几段独立动画拼起来的幻灯片。
我们从头到尾实际制作并交付了一段 8 秒、720p 的片段,看看实际效果到底如何:提示词、API 调用、成本和输出。下面是完整过程。
为什么 reference-to-video 是另一种工具
文生视频没有给模型任何可以锚定身份的东西,所以同一个提示词重新生成时,角色的脸和服装都可能变化。单图生视频锚定的是一个姿势,这对单个节拍有效,但一旦你的故事需要第二个角度,或者需要源图从未展示过的动作,就会失效。reference-to-video 介于两者之间:多张参考图让模型从多个真实视角看到同一主体——正面、动作姿势,凡是你提供的都行——并把这些图一起作为身份锚点,让视频可以走过多个节拍而不丢失线索。
这使它适合一种特定且常见的短视频需求:吉祥物讲解片段、常驻角色的社交内容、产品角色叙事——任何同一个"谁"必须在同一个连续镜头里撑过多个"做什么"的场景。
测试案例:一只快递狐狸,三个节拍
我们设计了一个小原创角色——Bramble,一只快递狐狸——并在完全开始做视频之前,先生成两张参考图来确立它的身份。
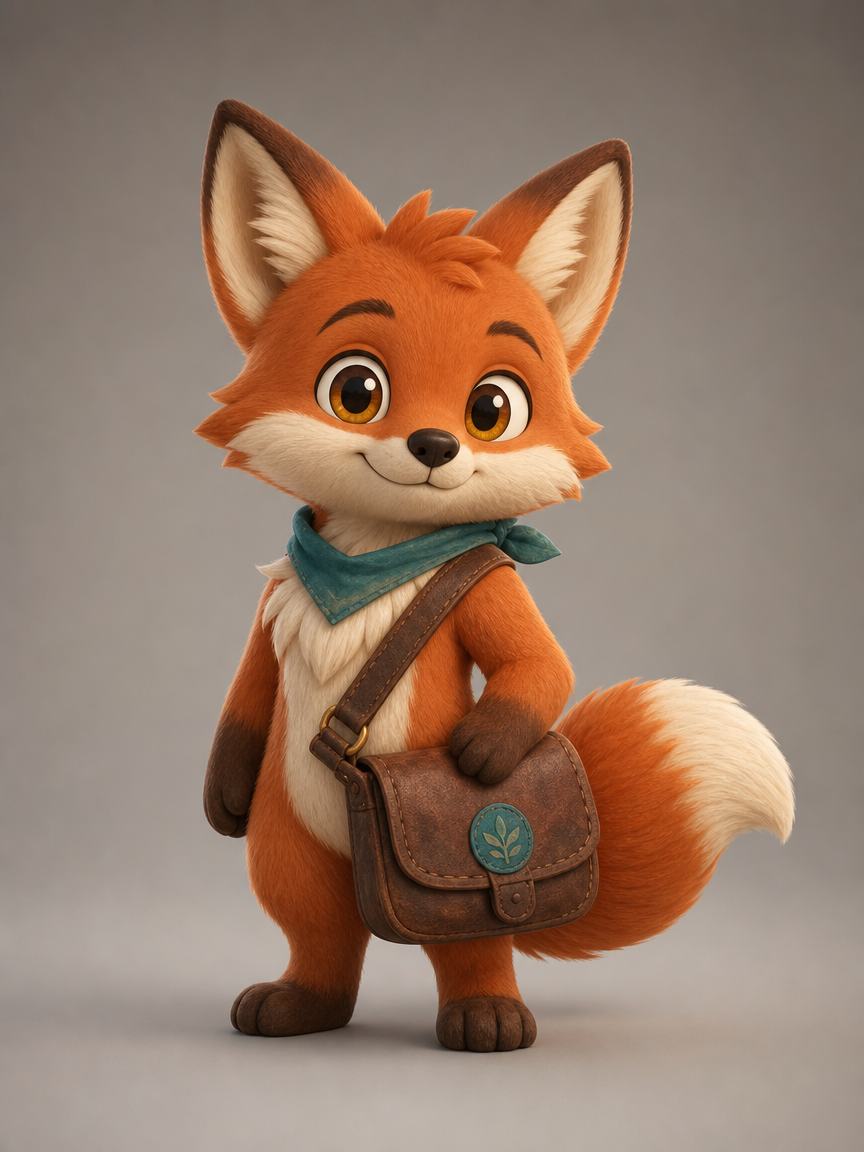
使用的提示词:"一个名叫 Bramble 的小个子、大眼睛卡通狐狸角色:橙红色毛发,奶油色口鼻和胸口,高耸尖耳且内侧为奶油色,戴青绿色领巾,背着一个破旧的棕色皮革快递挎包,包带上有一枚小圆形蓝色徽章。3D 动画长片风格,柔和暖光,正面朝向镜头的全身转面姿势,纯中性背景,角色设计一致。"
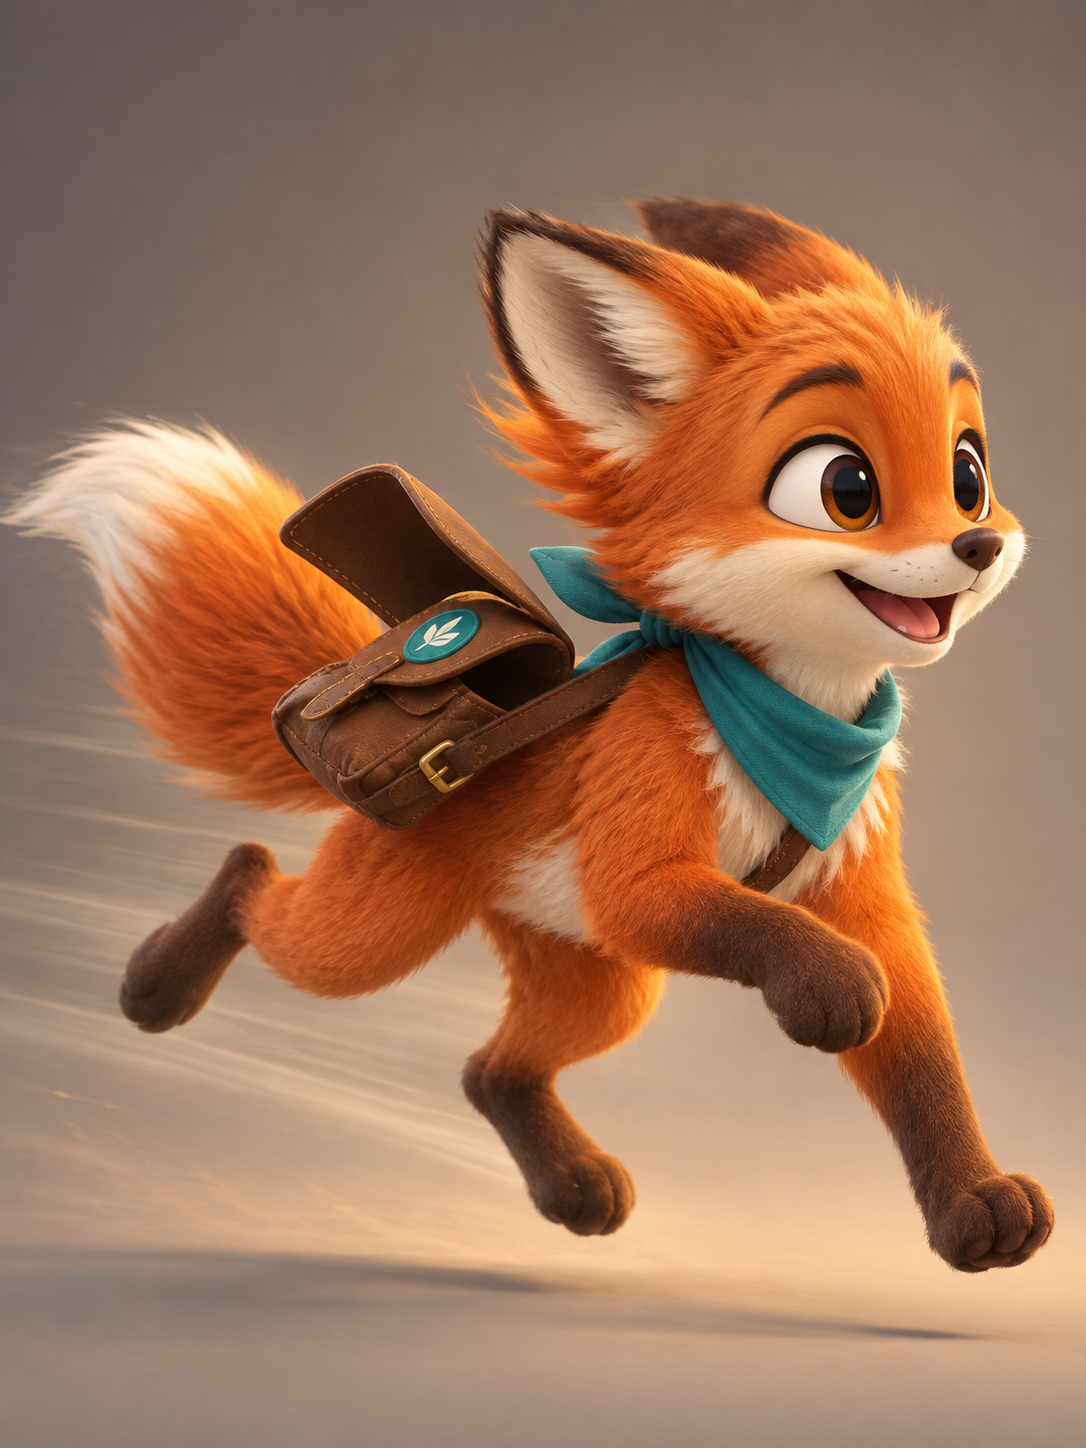
使用的提示词:"同一个狐狸角色 Bramble——橙红色毛发、奶油色口鼻、青绿色领巾、带蓝色徽章的棕色皮革快递挎包——以动态的四分之三侧面动作姿势定格在奔跑中,一只手臂向前摆动,尾巴向后飘动,大而富有表现力的眼睛,与参考设定图相同的 3D 动画长片风格和比例,纯中性背景。"
两张图各花费 $0.03 生成。它们合起来就是整个"选角"步骤——在角色锁定之前,不会发生任何视频调用。
调用 API
reference-to-video 和平台上其他所有模型一样,是基于任务的端点:提交,然后轮询直到完成。
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "happyhorse-1.1/reference-to-video",
    "input": {
      "prompt": "Bramble the fox courier picks up a glowing gift box at a warm, lantern-lit delivery station and looks at it with delight; cut to Bramble sprinting through a bustling night market strung with red lanterns, package tucked under one arm, tail flying; cut to Bramble standing proudly on a rooftop at golden-hour sunset, package delivered, looking out over the rooftops with a satisfied smile. Consistent character design throughout, cinematic 3D animated feature style, warm lighting, smooth camera motion.",
      "reference_image": [
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/01-bramble-front.png",
        "https://static.hiapi.ai/blog/happyhorse-1-1-reference-to-video-short-form-video/02-bramble-action.png"
      ],
      "duration": 8,
      "resolution": "720p",
      "aspect_ratio": "16:9"
    }
  }'
这会返回一个 taskId。轮询它,直到 status 达到终止状态:
curl -s https://api.hiapi.ai/v1/tasks/<taskId> \
  -H "Authorization: Bearer $HIAPI_API_KEY"
status 会依次经过 queued → handling →(有时)archiving → success 或 fail。成功时,完成的片段是 output[0].url 上的一个限时 URL——立即下载,链接会过期。
我们确认可用的字段
| 字段 | 类型 | 我们用的值 | 说明 |
|---|---|---|---|
prompt |
字符串,必填 | 3 个节拍的镜头描述 | 像写迷你分镜列表一样写,而不是一句泛泛的话 |
reference_image |
图片 URL 数组 | 2 张图片 | 平台说明每个片段最多支持 9 张 |
duration |
整数,秒 | 8 |
happyhorse-1.1 系列范围为 3–15 秒 |
resolution |
字符串 | "720p" |
"1080p" 也可用,价格更高 |
aspect_ratio |
字符串 | "16:9" |
标准宽高比枚举 |
结果
观察角色在剪辑点之间的表现:相同的毛色、相同的青绿色领巾、相同的带蓝色徽章挎包,从室内取件到夜市奔跑再到屋顶日落。这正是给它两张参考图而不是一张的全部意义——面对场景切换,模型有比单张静止图更多的东西可以锚定。该片段还会自动内置原生音频;没有单独的音频字段需要配置。
可复用的 Python 示例
import json
import subprocess
import time

def generate_reference_video(prompt, reference_images, token,
                              duration=8, resolution="720p", aspect_ratio="16:9"):
    payload = {
        "model": "happyhorse-1.1/reference-to-video",
        "input": {
            "prompt": prompt,
            "reference_image": reference_images,
            "duration": duration,
            "resolution": resolution,
            "aspect_ratio": aspect_ratio,
        },
    }
    submit = subprocess.run(
        ["curl", "-s", "-X", "POST", "https://api.hiapi.ai/v1/tasks",
         "-H", f"Authorization: Bearer {token}",
         "-H", "Content-Type: application/json",
         "-d", json.dumps(payload)],
        capture_output=True, text=True, check=True,
    )
    task_id = json.loads(submit.stdout)["data"]["taskId"]

    while True:
        poll = subprocess.run(
            ["curl", "-s", f"https://api.hiapi.ai/v1/tasks/{task_id}",
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, text=True, check=True,
        )
        task = json.loads(poll.stdout)["data"]
        if task["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if task["status"] != "success":
        raise RuntimeError(task.get("error"))
    return task["output"][0]["url"]
成本是多少
| 项目 | 成本 |
|---|---|
| 参考图(正面) | $0.03 |
| 参考图(动作姿势) | $0.03 |
| 8 秒片段 @ 720p($0.16/秒) | $1.28 |
| 本演示总计 | $1.34 |
720p 为 $0.16/秒;1080p 为 $0.21/秒,所以同样的 8 秒片段在 1080p 下会花费 $1.68。当前完整费率始终在定价页上——在扩大片段长度或分辨率之前先查看那里。
多镜头一致性的提示词技巧
- 把提示词写成镜头列表,而不是一句话。"节拍 1 → 节拍 2 → 节拍 3",每个节拍都有清晰的动作用,这才真正驱动一个片段内的不同镜头——单一的泛泛描述反而容易模糊成一段连续运动。
- 自己保证参考图之间视觉一致。模型会保留你的参考图之间已经一致的部分;它不会调和不一致。如果你的正面图和动作图毛色深浅不同或缺少徽章,这种歧义会延续到视频里。
- 给它一个静止图从未展示过的姿势。多参考图相对于单张的价值在于,模型可以合成超乎任何单张图像所展示的动作和角度——一张正面转面图加一张动作姿势图,足以支撑平静和充满活力的节拍。
- 明确说明场景变化。提示词中的"切到"、"然后"以及具体地点名称,直接对应你在输出中看到的镜头切换。
常见问题
我可以使用多少张参考图? 每个片段最多 9 张。本演示我们用了 2 张,就足以在三个不同节拍中保持身份。
支持 1080p 吗? 支持——1080p 价格为 $0.21/秒,而 720p 为 $0.16/秒。
如果我只有一张参考图怎么办?
改用 happyhorse-1.1/image-to-video——同一系列,单张起始图,没有多参考图身份锚定。
同一系列有纯文生视频选项吗?
有,happyhorse-1.1/text-to-video,每秒费率相同,适用于你完全没有参考静止图的情况。
输出包含声音吗? 包含,原生音频会随画面自动生成——没有单独的音频参数需要设置。
片段可以多长? happyhorse-1.1 系列为 3 到 15 秒;我们用了 8 秒来呈现一个三节拍叙事。
要点
happyhorse-1.1/reference-to-video把 2-9 张静止图变成一段连续视频,并在每个镜头中保持相同的角色、服装和艺术风格。- 一个完整可运行的演示——2 张参考图加一段 8 秒 720p 片段——在 hiapi API 上端到端花费 $1.34。
- 除提示词外,模型只需要三个字段:
reference_image(URL 数组)、duration(3-15 秒)和resolution(720p 或 1080p)。 - 把提示词写成镜头列表(节拍 1 → 节拍 2 → 节拍 3),而不是一段泛泛的描述——这才是真正驱动多镜头结构的东西。
- 原生音频会随视频自动生成,无需单独的音频生成步骤。
准备在你自己的角色上试试吗?从 happyhorse-1.1/reference-to-video 模型页开始,或者看看我们的 Seedance 2.0 Mini 实战教程中的类似短视频工作流。


