
Руководство по использованию
Рецепты промптов для Qwen Image 3.0: готовые к копированию промпты и реальные результаты
API преобразования текста в изображение Qwen Image 3.0 особенно хорошо справляется с одной задачей, которую большинство графических моделей до сих пор не осиливают: точная отрисовка текста — включая смешанные китайско-английские надписи — настолько чистая, что результат можно сдавать без доработок. Именно поэтому модель заслуживает отдельного сборника промптов, а не очередной обобщённой статьи «как писать промпты для ИИ».
Ниже — 6 полных, готовых к копированию промптов, которые мы сами написали и реально прогнали на qwen-image-3.0/text-to-image, каждый с настоящим неотредактированным результатом. Каждый промпт стоит рядом со своим изображением, так что вы можете взять его как есть или заменить субъект на свой.
В чём именно сильна эта модель
Прежде чем перейти к рецептам, стоит знать три вещи, чтобы не потратить генерацию впустую:
- Точная отрисовка текста. Если вы в кавычках напишете точные символы, которые хотите получить — китайские, английские или оба сразу на одном изображении, — модель в большинстве случаев отрисует их чётко и читаемо. Перед публикацией обязательно вычитывайте результат; ошибки в штрихах или буквах всё ещё возможны.
- Список поддерживаемых соотношений сторон уже, чем вы думаете. API принимает только
1:1,3:2,2:3,4:3,3:4,16:9,9:16и21:9. Такие распространённые пропорции, как4:5или5:4, сразу вернут чистый400ещё до списания средств — подробнее ниже. - Единая цена за изображение. На момент написания статьи эндпоинт задач тарифицируется единообразно — $0.0358 за изображение независимо от соотношения сторон (проверено по актуальным тарифам hiapi).
6 рецептов промптов
1. Двуязычная вывеска магазина
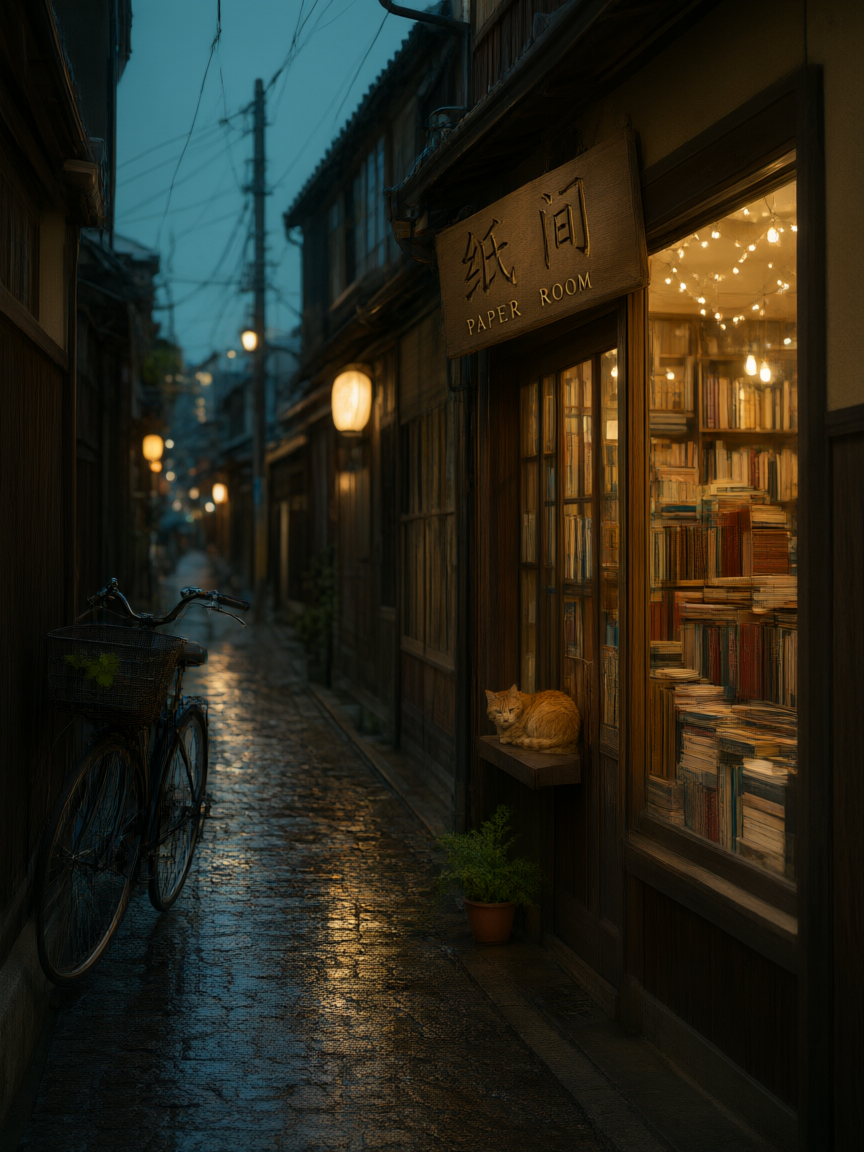
Кинематографичный уличный снимок: небольшой независимый книжный магазин в узком переулке Киото на закате, тёплый свет вольфрамовых ламп выливается из высокого стеклянного окна на мокрую булыжную мостовую. На двери висит нарисованная от руки деревянная табличка, на которой вырезаны только точные китайские иероглифы «纸间», а прямо под ними — мелкие буквы из патинированной латуни с точными английскими словами «PAPER ROOM». Сквозь окно видны стопки книг, над ними мягкое боке от гирлянды лампочек. На подоконнике сидит кошка. Документальный стиль уличной фотографии, естественная асимметричная композиция, мягкая бирюзово-янтарная цветовая гамма, деликатное плёночное зерно, малая глубина резкости, вертикальная композиция 3:4.
Почему работает: точные китайская и английская строки размещены каждая в своём предложении в кавычках — это даёт модели явную текстовую цель, а не прячет её в длинных описательных придаточных. Вертикальный формат 3:4 также соответствует тому, как обычно кадрируют реальные фотографии вывесок магазинов.
2. Главное изображение товара для e-commerce
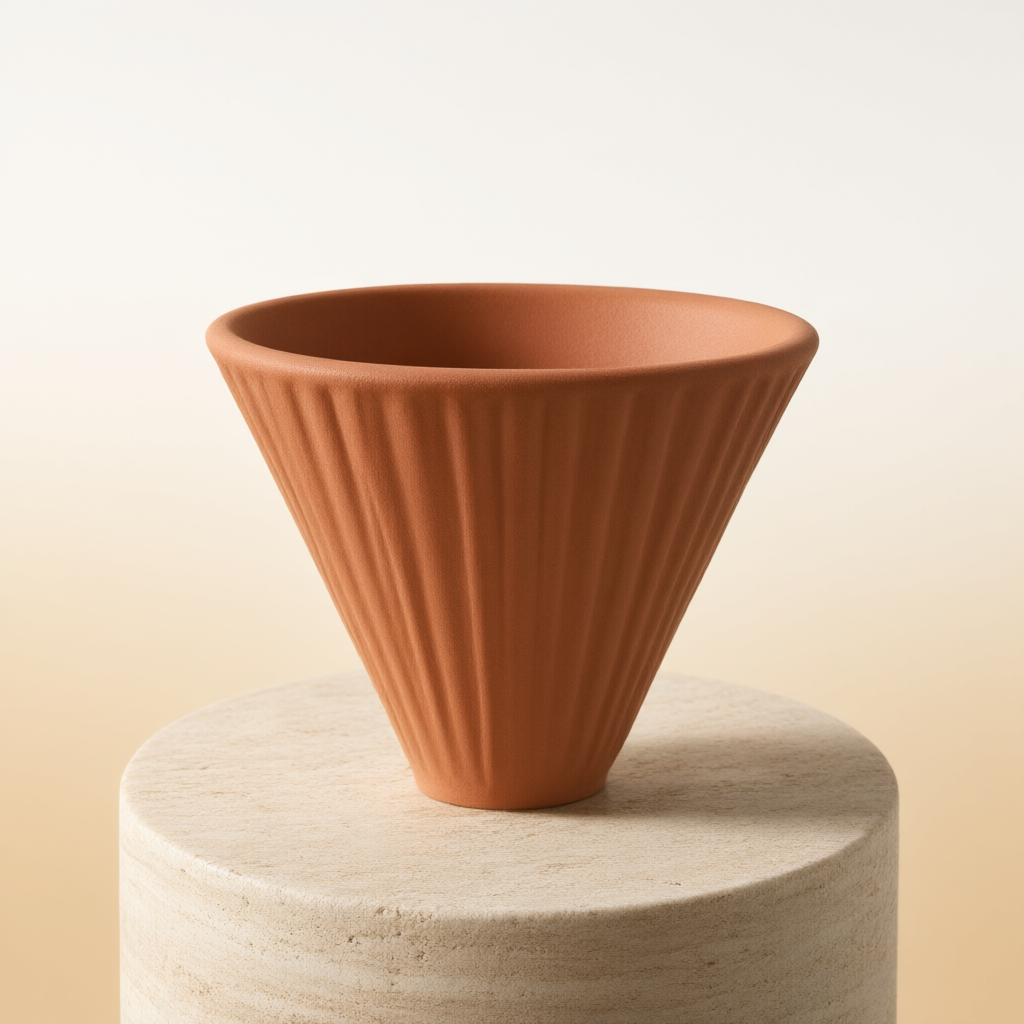
Минималистичная студийная съёмка товара: матовая керамическая воронка для пуровера тёплого терракотового цвета на круглой травертиновой подставке, фон — мягкий градиент от бледно-песочного к тёплому белому. Одиночный направленный софтбокс слева сверху создаёт мягкий контурный блик на текстуре воронки, снизу — тонкая мягкая тень. Без текста, без реквизита, без рук. Чистая коммерческая e-commerce фотография, всё в фокусе, нейтральный цветовой баланс, квадратная композиция 1:1.
Почему работает: явное указание «без текста, без реквизита, без рук» сдерживает склонность модели добавлять лишние детали в товарные снимки. 1:1 — самое безопасное соотношение по умолчанию для карточек товаров на торговых площадках, а указание направления света даёт всему каталогу единый воспроизводимый вид.
3. Концептуальный портрет персонажа
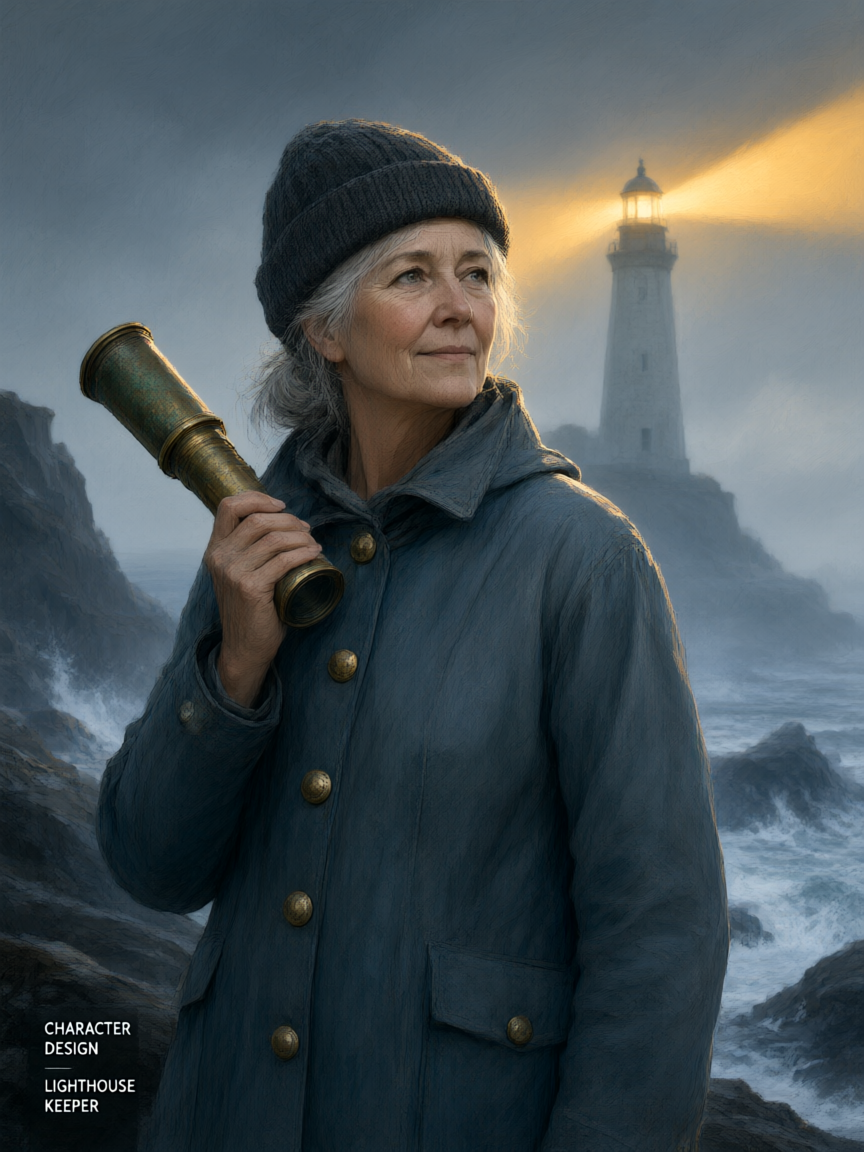
Поясной концепт-арт портрет: видавшая виды смотрительница маяка лет шестидесяти с лишним, в плотной просмолённой куртке с латунными пуговицами, седые волосы убраны назад под вязаной шапкой, вокруг спокойных серых глаз глубокие морщинки от улыбки. На плече у неё старая латунная подзорная труба. Фон — мягко размытая штормовая береговая линия, луч зажёгшегося маяка пробивается сквозь туман. Живописная цифровая иллюстрация, фактурные мазки, мягкая холодная сине-серая палитра с тёплым янтарным светом маяка, драматичный контурный свет, вертикальная композиция 3:4.
Почему работает: детали возраста, одежды и реквизита («плотная просмолённая куртка с латунными пуговицами», «старая латунная подзорная труба») дают модели конкретные объекты для отрисовки, а не расплывчатые прилагательные. Обратите внимание на композицию — в первой попытке мы использовали 4:5, а этого формата нет в списке принимаемых соотношений сторон, и запрос вернул 400 без списания средств. После смены на 3:4 (ближайшее поддерживаемое вертикальное соотношение) следующая попытка удалась.
4. Интерьер в редакционном стиле
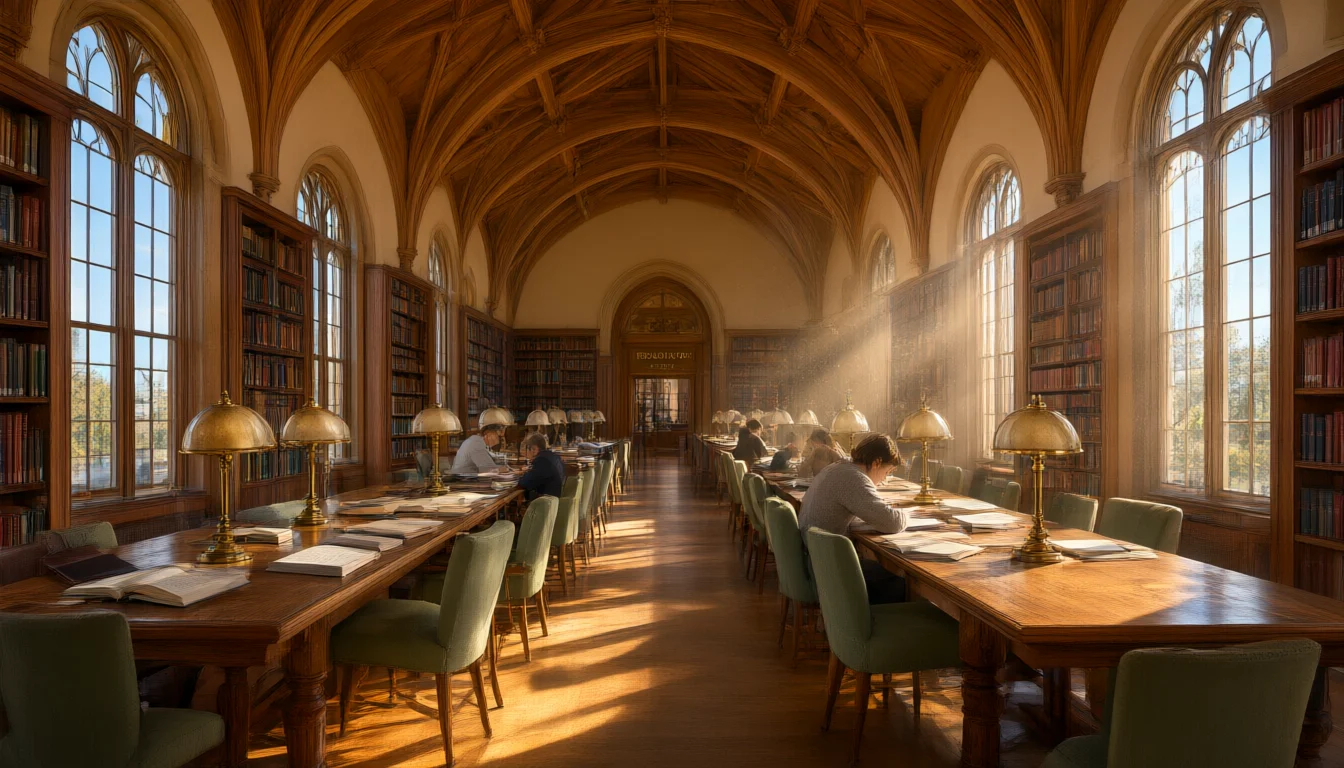
Широкоформатная архитектурная фотография: залитый солнцем университетский читальный зал, высокие сводчатые потолки и ряды высоких арочных окон. Вдоль центра тянутся длинные дубовые столы, на каждом — латунная настольная лампа для чтения, несколько студентов в мягком расфокусе тихо занимаются. В косых послеполуденных лучах отчётливо видны пылинки. Тёплое медовое дерево, мягкие кресла цвета шалфея, симметричная композиция с одной точкой схода, сверхдетализированные текстуры, высокий динамический диапазон, широкоформатная композиция 16:9.
Почему работает: прямое указание приёма композиции («симметричная композиция с одной точкой схода») — один из более надёжных способов управления в архитектурной и интерьерной фотографии: это конкретная инструкция, которой модель может следовать, а не просто слово о настроении. 16:9 подходит для широкоформатного редакционного главного изображения или шапки блога.
5. Фуд-фотография сверху
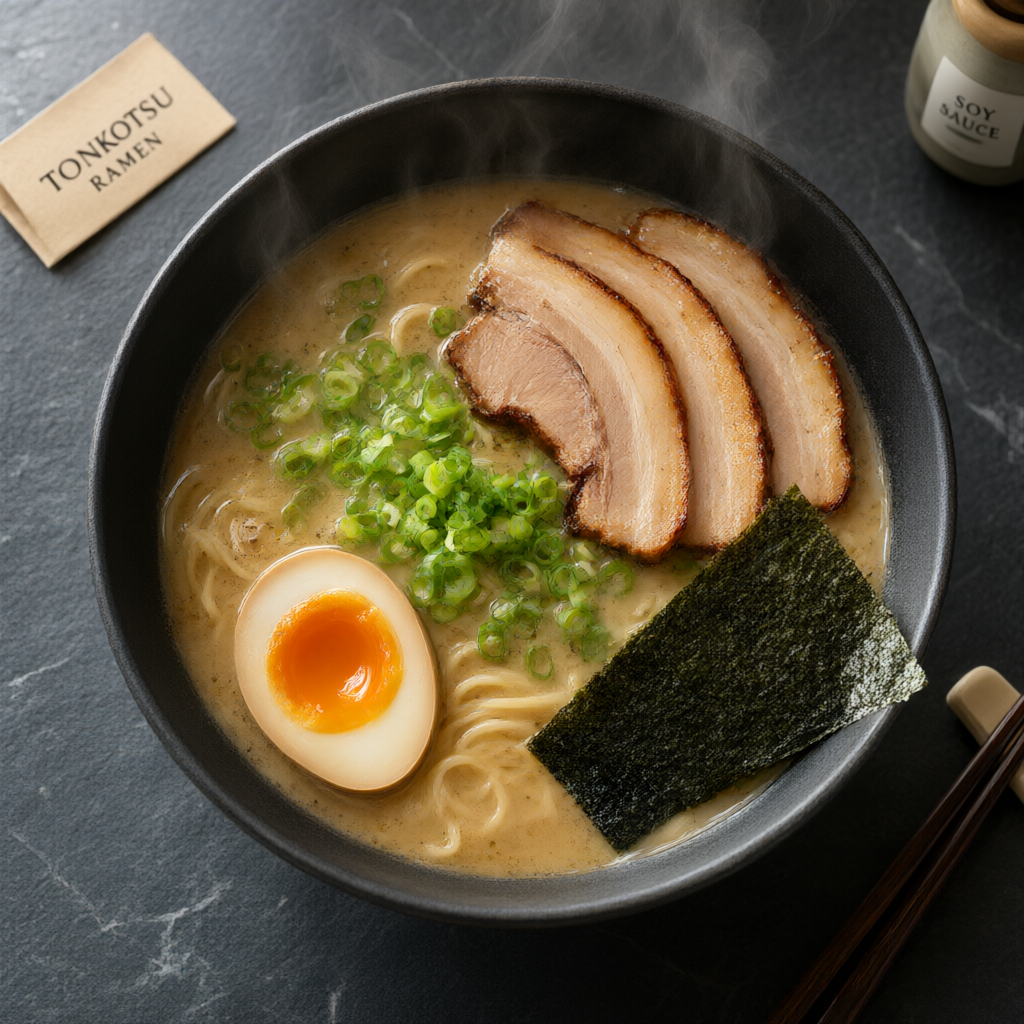
Макрофотография сверху: дымящаяся миска рамена тонкоцу на тёмном сланцевом столе, густой мутный бульон отражает мягкий оконный свет, глянцевые ломтики тясю веером разложены по лапше, варёное яйцо разрезано пополам и показывает жидковатый желток, рассыпанный зелёный лук и лист нори прислонён к краю миски. Тонкая струйка видимого пара поднимается вверх. Палочки лежат рядом с миской на маленькой керамической подставке. Естественный дневной свет, малая глубина резкости по краям, аппетитная редакционная подача блюда, квадратная композиция 1:1.
Почему работает: промпты для еды выигрывают от наслоения слов о текстуре («глянцевые», «жидковатый», «мутный») поверх деталей сервировки — именно это сочетание отделяет аппетитную отрисовку от плоской. «Тонкая струйка видимого пара поднимается вверх» здесь играет большую роль; пар — одна из более стабильных деталей, которые модель отрисовывает хорошо.
6. Двуязычный постер к релизу приложения
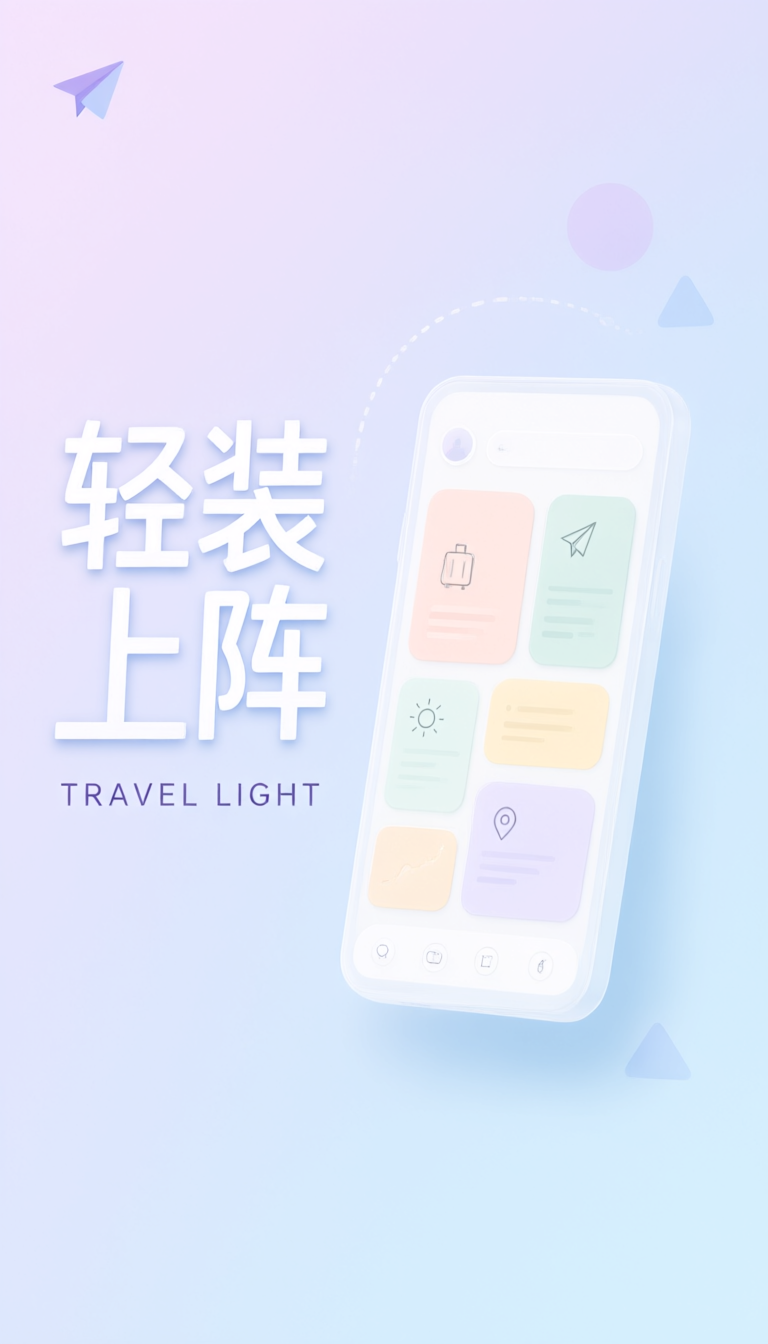
Чистый современный постер к релизу мобильного приложения, мягкий градиентный фон от лавандового к бледно-голубому. Макет телефона слегка наклонён и парит справа от центра, на экране — упрощённый абстрактный интерфейс приложения с мягкими карточками со скруглёнными углами. Слева крупный жирный заголовок без засечек с точными китайскими иероглифами «轻装上阵», а прямо под ним, меньшим начертанием — точные английские слова «TRAVEL LIGHT». Вокруг телефона минималистичные геометрические фигуры и мягкая тень для добавления объёма. Плоский современный маркетинговый дизайн, много свободного пространства, вертикальная композиция 9:16.
Почему работает: тот же приём, что и в рецепте №1 — точный текст заголовка изолирован в отдельном придаточном, а также указаны относительное начертание и размер («прямо под ним, меньшим начертанием»), так что модель получает не только текст, но и иерархию. 9:16 соответствует тому, как это изображение реально будет размещаться — в магазине мобильных приложений или в соцсетях.
Реально работающие соотношения сторон
qwen-image-3.0/text-to-image принимает только восемь соотношений сторон: 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16 и 21:9. Любое значение вне этого списка — 4:5 и 5:4 чаще всего используют по привычке — сразу вернёт 400 INVALID_REQUEST вместо плохой отрисовки, так что за эту ошибку вы не платите. Если вы переносите промпты с модели с более широким списком соотношений, перед отправкой сопоставьте их с ближайшим поддерживаемым значением (4:5 → 3:4, 5:4 → 4:3).
Частые вопросы
Поддерживает ли qwen-image-3.0/text-to-image редактирование изображений (image-to-image)? Это руководство посвящено исключительно эндпоинту преобразования текста в изображение. Прежде чем строить рабочий процесс вокруг редактирования изображений, загляните на страницу модели, чтобы узнать актуальный список поддерживаемых режимов.
Сколько стоит одно изображение? На момент написания статьи эндпоинт задач тарифицируется по $0.0358 за изображение. Цены могут меняться, поэтому перед масштабной оценкой затрат уточните актуальные цифры на странице тарифов hiapi.
Почему мой запрос вернул 400 вместо изображения?
Самая частая причина — неподдерживаемое значение aspect_ratio; точный список допустимых значений приведён выше. API отклоняет запрос ещё до начала генерации, поэтому 400 здесь не влечёт никаких расходов.
Можно ли смешивать китайский и английский на одном изображении? Да — рецепты №1 и №6 выше именно так и делают. Помещайте точный текст каждого языка в кавычки в отдельном придаточном, а не объединяйте в одну фразу, и обязательно вычитывайте результат перед использованием в любом публичном материале.
Попробуйте сами
Все шесть промптов выше можно скопировать прямо в ваш запрос. Начните с руководства по быстрому старту, чтобы сделать первый вызов, или перейдите на страницу модели qwen-image-3.0/text-to-image, чтобы посмотреть полный справочник параметров.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков