
Guía de uso
Recetas de prompts para Qwen Image 3.0: prompts listos para copiar y resultados reales
La API de texto a imagen de Qwen Image 3.0 destaca especialmente en una cosa que la mayoría de los modelos de imagen todavía no logran dominar: renderizar texto con precisión —incluida la mezcla de chino e inglés— con una nitidez suficiente para entregarlo sin retoques. Por eso merece su propio manual de prompts y no otro artículo genérico sobre «cómo escribir prompts de IA».
A continuación presentamos 6 prompts completos y listos para copiar que escribimos nosotros mismos y ejecutamos realmente en qwen-image-3.0/text-to-image, cada uno acompañado de su resultado real sin editar. Cada prompt está junto a su imagen para que puedas tomarlo tal cual o sustituir el sujeto por el tuyo.
En qué destaca realmente este modelo
Antes de entrar en las recetas, hay tres cosas que conviene saber para no desperdiciar una generación:
- Renderizado de texto preciso. Si escribes entre comillas los caracteres exactos que quieres —chino, inglés o ambos en la misma imagen—, el modelo la mayoría de las veces los renderiza de forma clara y legible. Revisa siempre antes de publicar; todavía pueden aparecer trazos o letras erróneos.
- La lista de relaciones de aspecto admitidas es más estrecha de lo que crees. La API solo acepta
1:1,3:2,2:3,4:3,3:4,16:9,9:16y21:9. Relaciones habituales como4:5o5:4devuelven directamente un400limpio antes de facturar; consulta los detalles más abajo. - Precio uniforme por imagen. En el momento de redactar este artículo, el endpoint de tareas factura una tarifa uniforme de $0.0358 por imagen, independientemente de la relación de aspecto (verificado con los precios en tiempo real de hiapi).
6 recetas de prompts
1. Rótulo de escaparate bilingüe
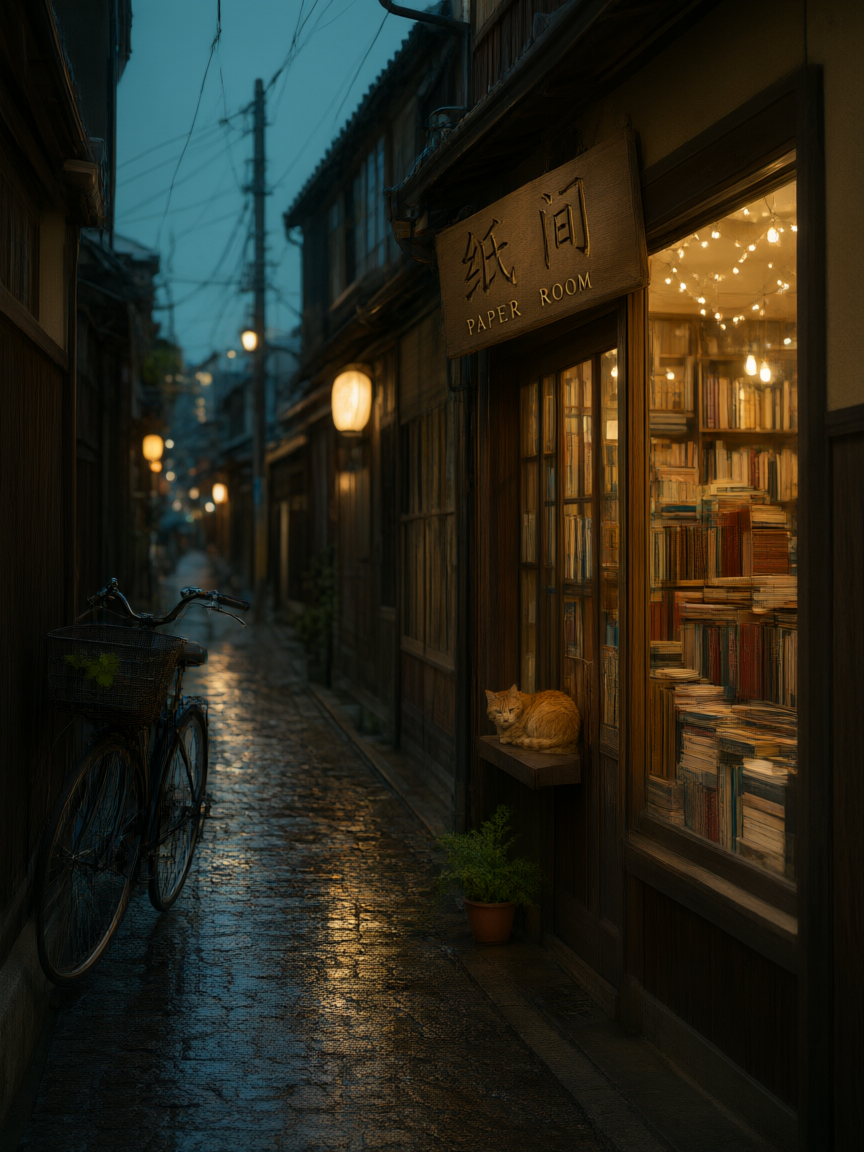
Fotografía cinematográfica de calle, una pequeña librería independiente en un estrecho callejón de Kioto al atardecer, luz cálida de tungsteno derramándose desde la ventana alta hasta el suelo de adoquines húmedos. En la puerta cuelga un rótulo de madera pintado a mano que lleva solo los caracteres chinos exactos «纸间», y justo debajo, en letras de latón cepillado más pequeñas, la palabra inglesa exacta «PAPER ROOM». Pilas de libros visibles a través de la ventana, suave bokeh de las luces de guirnalda superiores. Un gato sentado en el alféizar. Estilo de fotografía callejera documental, composición asimétrica natural, paleta suave de verde azulado y ámbar, grano de película delicado, poca profundidad de campo, composición vertical 3:4.
Por qué funciona: colocar las cadenas exactas en chino e inglés en comillas dentro de cláusulas separadas le da al modelo un objetivo de texto claro, en lugar de enterrarlo en subordinadas descriptivas largas. El formato vertical 3:4 también coincide con cómo se suelen componer las fotos reales de rótulos de escaparate.
2. Imagen principal de producto para ecommerce
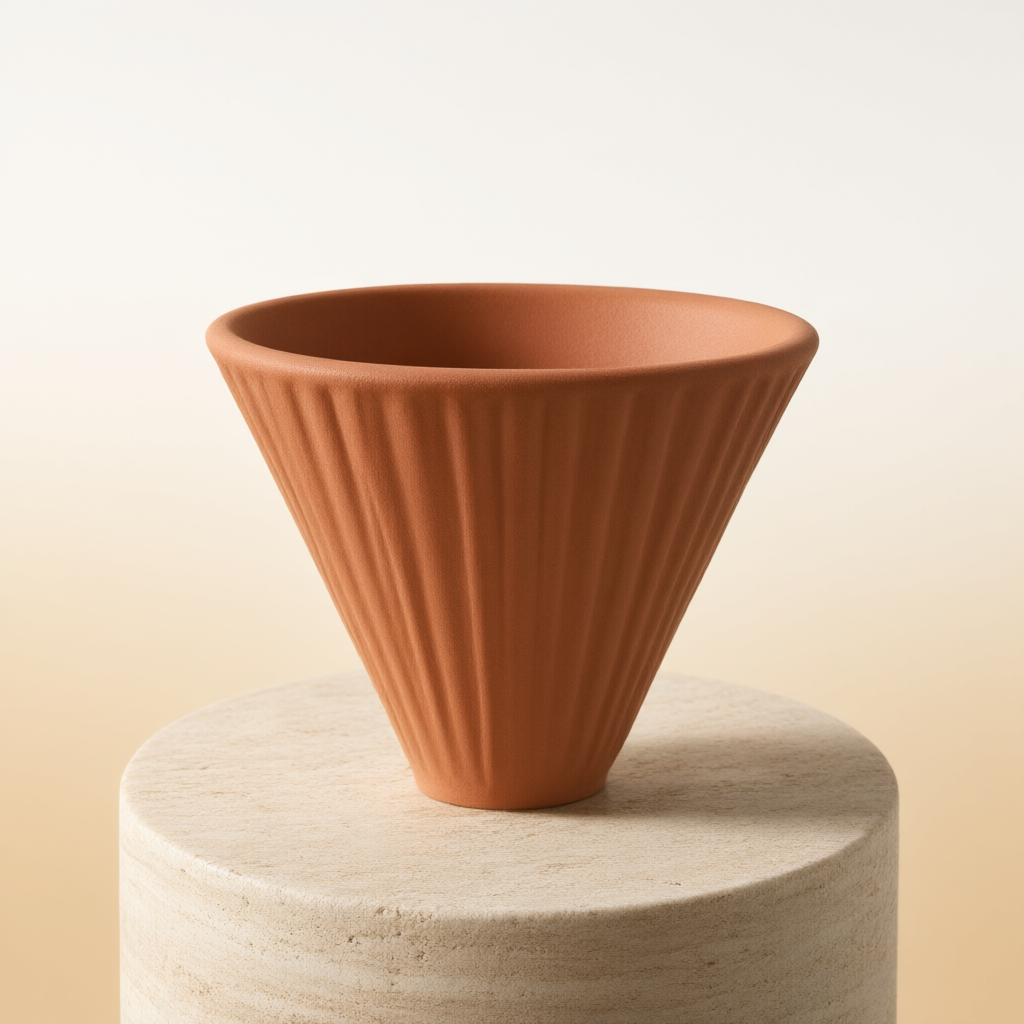
Fotografía de producto de estudio minimalista, un cono de filtro de café pour-over de cerámica mate en cálido color terracota sobre una base circular de travertino, con un suave fondo degradado de arena pálida a blanco cálido. Un único softbox de luz suave desde arriba a la izquierda crea un suave reflejo de contorno en las estrías del cono, con una sutil sombra suave debajo. Sin texto, sin atrezzo, sin manos. Fotografía comercial de ecommerce limpia, enfoque nítido en todo, balance de color neutro, composición cuadrada 1:1.
Por qué funciona: especificar explícitamente «sin texto, sin atrezzo, sin manos» frena la tendencia del modelo a añadir elementos superfluos en las imágenes de producto. 1:1 es la relación predeterminada más segura para las imágenes de producto en las plataformas de ecommerce, e indicar la dirección de la luz aporta una apariencia coherente y reproducible en todo un catálogo de productos.
3. Retrato conceptual de personaje
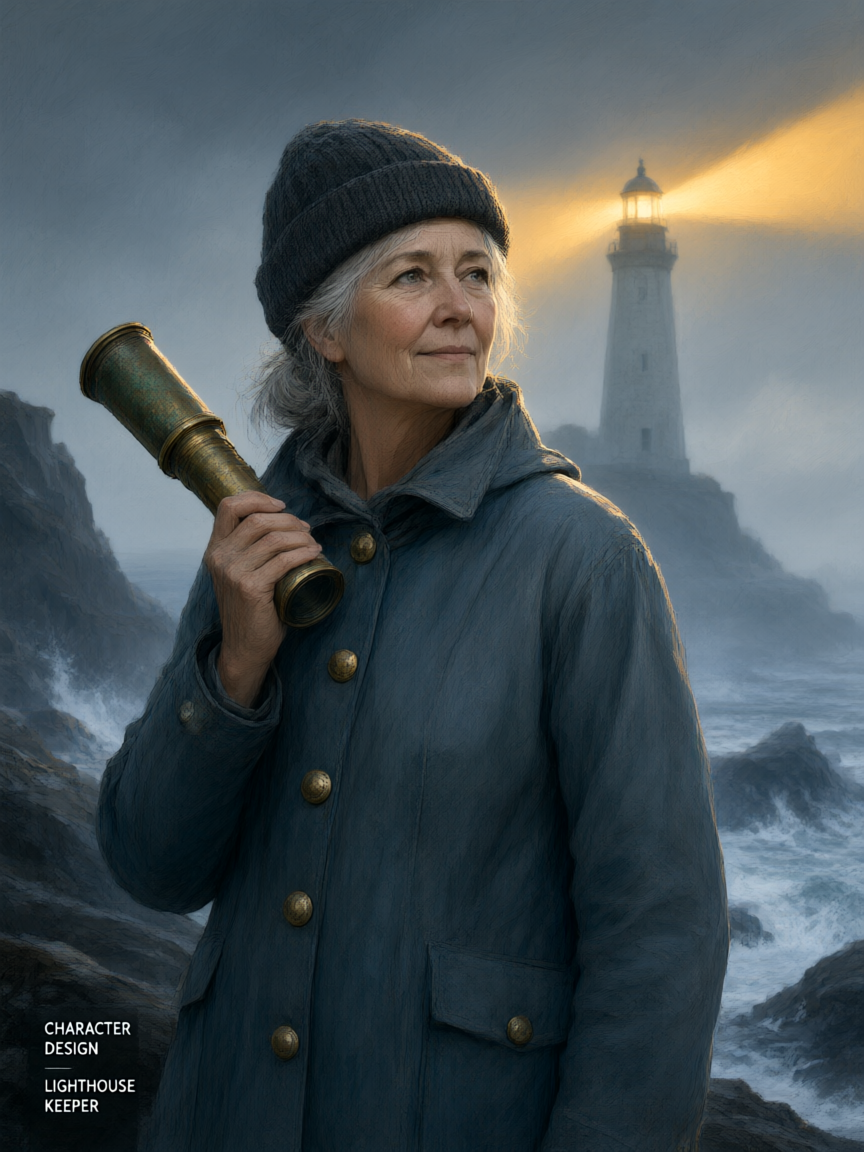
Retrato conceptual de medio cuerpo, un farero curtido por el tiempo de unos sesenta años, con un pesado abrigo de hule con botones de latón, cabello plateado recogido hacia atrás bajo un gorro de punto, profundas arrugas de expresión alrededor de unos ojos grises serenos. Lleva al hombro un viejo catalejo de latón. El fondo es una costa tormentosa desenfocada, con un haz de luz de faro encendido atravesando la niebla. Ilustración digital de estilo pictórico, pinceladas texturizadas, paleta suave de gris azulado frío con luz ámbar cálida de faro, iluminación de contorno dramática, composición vertical 3:4.
Por qué funciona: los detalles de edad, vestimenta y atrezzo («pesado abrigo de hule con botones de latón», «viejo catalejo de latón») le dan al modelo objetos concretos que renderizar, en lugar de adjetivos vagos. Fíjate en la composición: nuestro primer intento usó 4:5, que no está en la lista de relaciones de aspecto aceptadas por el modelo, y devolvió un 400 sin facturación. Al cambiar a 3:4 (la relación vertical admitida más cercana), el siguiente intento funcionó.
4. Interior arquitectónico de estilo editorial
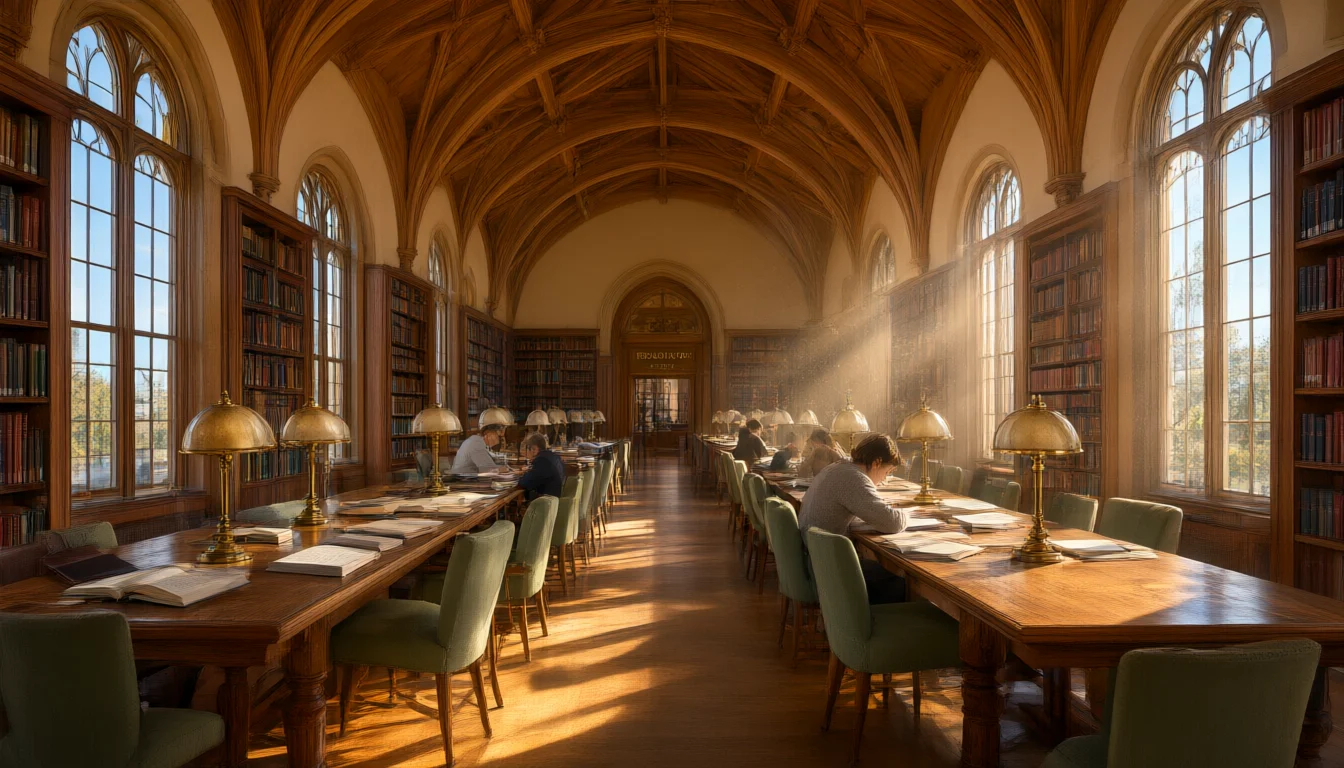
Fotografía arquitectónica de gran angular, una sala de lectura universitaria bañada por el sol, con altos techos abovedados y hileras de grandes ventanas en arco. Largas mesas de roble se extienden por el centro, cada una con una lámpara de lectura de latón, y unos pocos estudiantes estudian en silencio en un suave desenfoque. El polvo flota con nitidez en los gruesos haces de luz de la tarde. Madera cálida color miel, sillas suaves en verde salvia, composición simétrica de punto de fuga único, texturas ultradetalladas, alto rango dinámico, composición principal 16:9.
Por qué funciona: nombrar directamente la técnica de composición («simétrica de punto de fuga único») es uno de los controles más fiables en fotografía de arquitectura e interiores: es una instrucción concreta que el modelo puede seguir, no solo una palabra de ambiente. 16:9 funciona bien como imagen principal editorial de gran formato o cabecera de blog.
5. Fotografía gastronómica cenital
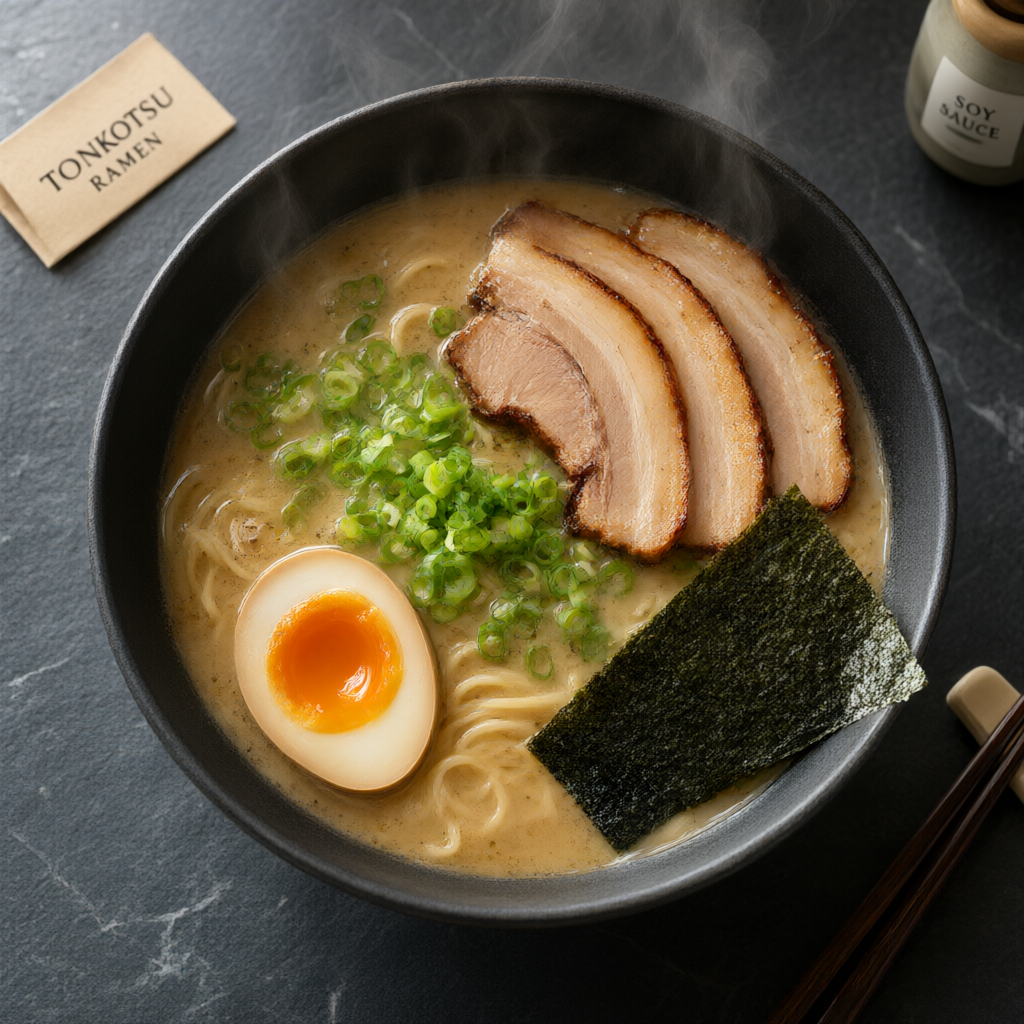
Fotografía macro cenital, un cuenco humeante de ramen tonkotsu sobre una mesa de pizarra oscura, con un caldo rico y turbio que refleja la suave luz de la ventana, láminas de chashu brillantes de grasa dispuestas en abanico sobre los fideos, un huevo poché cortado por la mitad que deja ver la yema líquida, cebolleta picada esparcida y una hoja de nori apoyada en el borde del cuenco. Finas volutas de vapor visibles elevándose. Palillos apoyados en un pequeño reposapalillos de cerámica junto al cuenco. Luz natural del día, poca profundidad de campo en los bordes, apetitoso estilismo gastronómico editorial, composición cuadrada 1:1.
Por qué funciona: los prompts de comida se benefician de superponer palabras de textura («brillantes de grasa», «yema líquida», «turbio») a los detalles de emplatado; esa combinación marca la diferencia entre un renderizado apetitoso y uno plano. «Finas volutas de vapor visibles elevándose» aporta mucho aquí; el vapor es uno de los detalles más estables que el modelo renderiza bien.
6. Póster de lanzamiento de app bilingüe
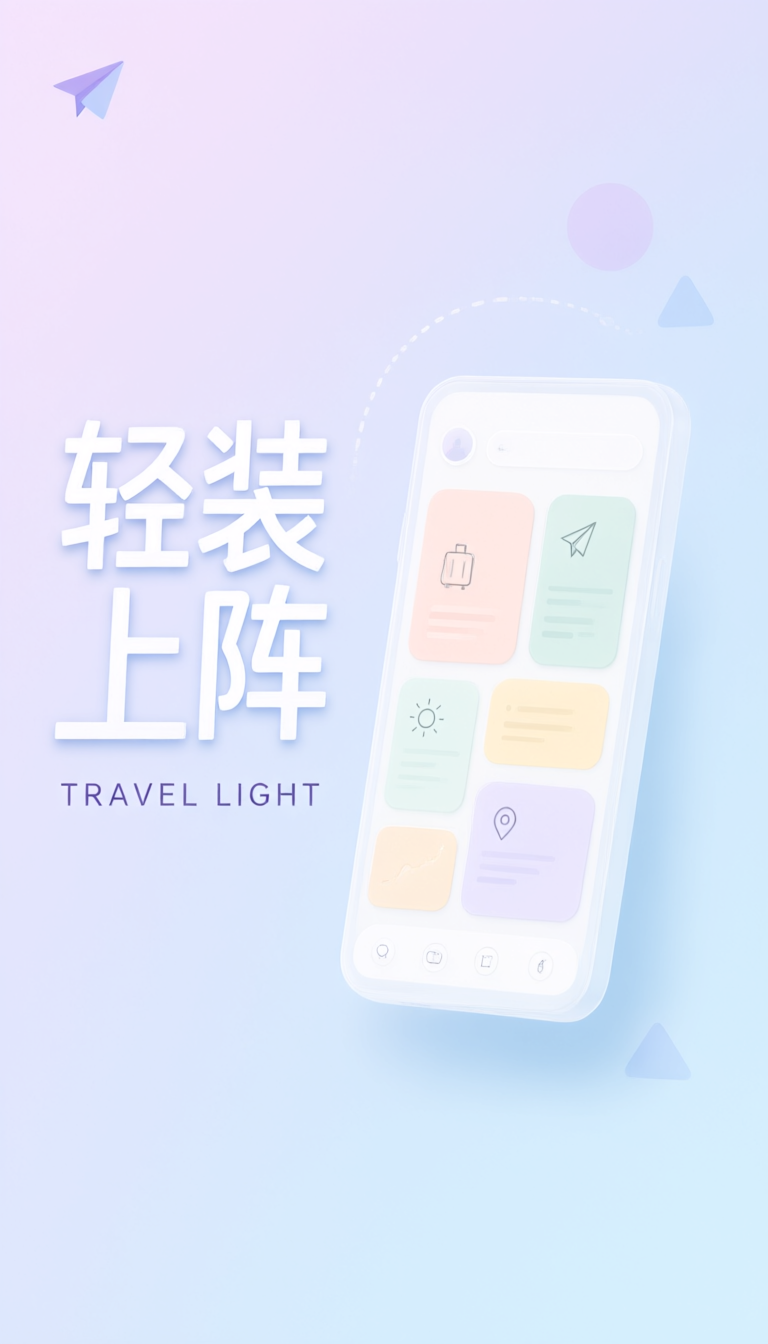
Póster de lanzamiento de app móvil moderno y limpio, con un suave fondo degradado de lavanda a azul pálido. Un mockup de teléfono flota ligeramente inclinado hacia el centro-derecha, con una interfaz de app abstracta simplificada en pantalla, con tarjetas suaves de esquinas redondeadas. A la izquierda, un titular grande en negrita sans serif que dice solo los caracteres chinos exactos «轻装上阵», y justo debajo, en un grosor menor, la palabra inglesa exacta «TRAVEL LIGHT». Alrededor del teléfono, formas geométricas minimalistas y sombras suaves para añadir profundidad. Diseño de marketing moderno y plano, mucho espacio en blanco, composición vertical 9:16.
Por qué funciona: el mismo truco que en la receta n.º 1 —aislar el texto exacto del titular en su propia cláusula e indicar el grosor y tamaño relativos («justo debajo, en un grosor menor»)— hace que el modelo no solo reciba el texto, sino que capte la jerarquía. 9:16 coincide con cómo se publicará realmente esta imagen como material en una tienda de apps o en promociones sociales.
Relaciones de aspecto realmente disponibles
qwen-image-3.0/text-to-image solo acepta ocho relaciones de aspecto: 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16 y 21:9. Cualquier valor fuera de esa lista —4:5 y 5:4 son los dos que la gente suele usar por costumbre— devuelve inmediatamente un 400 INVALID_REQUEST, en lugar de un renderizado deficiente, así que no pagarás por ese error. Si migras prompts de un modelo con una lista de relaciones de aspecto más amplia, asigna el valor admitido más cercano antes de enviar (4:5 → 3:4, 5:4 → 4:3).
Preguntas frecuentes
¿qwen-image-3.0/text-to-image admite edición de imagen a imagen? Esta guía trata específicamente del endpoint de texto a imagen. Antes de construir un flujo de trabajo en torno a la edición de imágenes, consulta la página del modelo para ver la lista de modos admitidos actualmente.
¿Cuánto cuesta cada imagen? En el momento de redactar este artículo, el endpoint de tareas cuesta $0.0358 por imagen. Los precios pueden cambiar, así que confirma la cifra actual en la página de precios de hiapi antes de estimar costes a gran escala.
¿Por qué mi solicitud devuelve 400 en lugar de una imagen?
La causa más común es un valor de aspect_ratio no admitido; la lista exacta de valores aceptables está más arriba. La API rechaza la solicitud antes de que empiece la generación, así que un 400 aquí no te genera ningún coste.
¿Puedo mezclar chino e inglés en la misma imagen? Sí; las recetas n.º 1 y n.º 6 de arriba lo hacen. Coloca el texto exacto de cada idioma entre comillas en su propia cláusula, en lugar de combinarlo en una sola frase, y revisa siempre el resultado renderizado antes de usarlo en cualquier contenido público.
Pruébalo tú mismo
Los seis prompts anteriores se pueden copiar directamente en tu solicitud. Empieza con la guía de inicio rápido para hacer tu primera llamada, o visita la página del modelo qwen-image-3.0/text-to-image para consultar la referencia completa de parámetros.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores