
Guia de uso
Receitas de prompts do Qwen Image 3.0: prompts prontos para copiar e saídas reais
O endpoint de geração de imagens a partir de texto do Qwen Image 3.0 é excepcionalmente bom em uma coisa que a maioria dos modelos de imagem ainda não consegue fazer: renderizar texto com precisão — inclusive texto misto em chinês e inglês — de forma tão limpa que pode ser entregue sem retrabalho. Isso faz dele merecedor de um guia de prompts próprio, e não de mais um artigo genérico sobre «como escrever prompts de IA».
Abaixo estão 6 prompts completos e prontos para copiar, que escrevemos e executamos de fato em qwen-image-3.0/text-to-image, cada um acompanhado de uma saída real e não editada. Cada prompt fica logo ao lado da sua imagem, para você usar como está ou substituir pelo seu próprio sujeito.
No que este modelo é realmente bom
Antes de entrar nas receitas, vale saber três coisas para não desperdiçar uma geração:
- Renderização precisa de texto. Se você escrever entre aspas os caracteres exatos que deseja — chinês, inglês ou ambos na mesma imagem — o modelo na maioria das vezes consegue renderizá-los de forma nítida e legível. Sempre revise antes de publicar; ainda podem ocorrer erros de traços ou letras.
- A lista de proporções de aspecto suportadas é mais restrita do que você imagina. A API aceita apenas
1:1,3:2,2:3,4:3,3:4,16:9,9:16e21:9. Proporções comuns como4:5ou5:4retornam um400limpo antes da cobrança — detalhes abaixo. - Preço uniforme por imagem. Até o momento em que este texto foi escrito, o endpoint de tarefas cobra um valor uniforme de $0.0358 por imagem, independentemente da proporção (verificado com os preços em tempo real do hiapi).
6 receitas de prompts
1. Letreiro de loja bilíngue
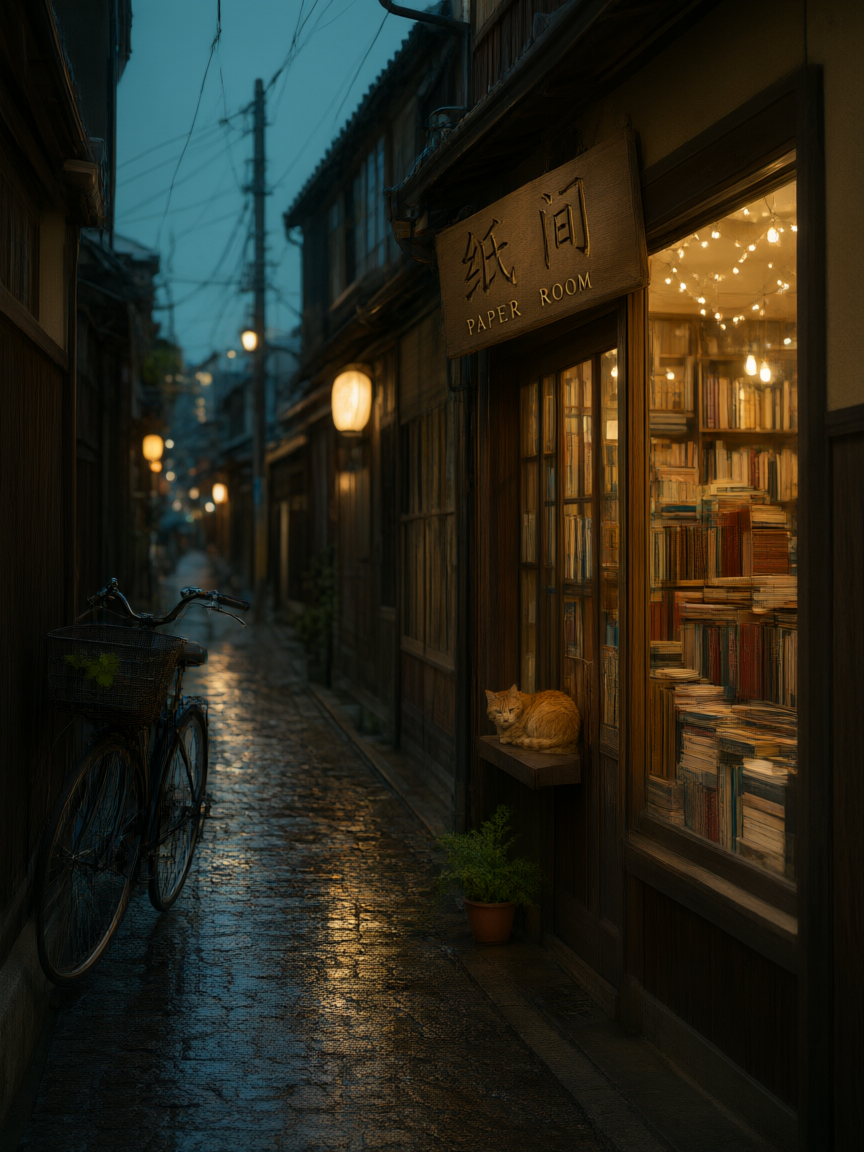
Fotografia cinematográfica de rua, uma pequena livraria independente em um beco estreito de Kyoto ao anoitecer, luz de tungstênio quente derramando-se das janelas altas sobre o chão de paralelepípedos molhados. Na porta, uma placa de madeira pintada à mão traz apenas os caracteres chineses exatos «纸间», e logo abaixo, em letras de bronze escovado menores, a palavra inglesa exata «PAPER ROOM». Pilhas de livros visíveis pela janela, bokeh suave de lâmpadas em série acima. Um gato sentado no parapeito. Estilo de fotografia de rua documental, composição natural e assimétrica, paleta suave de tons verde-azulados e âmbar, granulação de filme delicada, profundidade de campo rasa, composição vertical 3:4.
Por que funciona: colocar a string exata em chinês e em inglês, cada uma em sua própria frase e entre aspas, dá ao modelo um alvo textual claro, em vez de enterrá-lo em orações descritivas longas. A proporção vertical 3:4 também corresponde à forma como fotos reais de letreiros de loja costumam ser enquadradas.
2. Imagem principal de produto para e-commerce
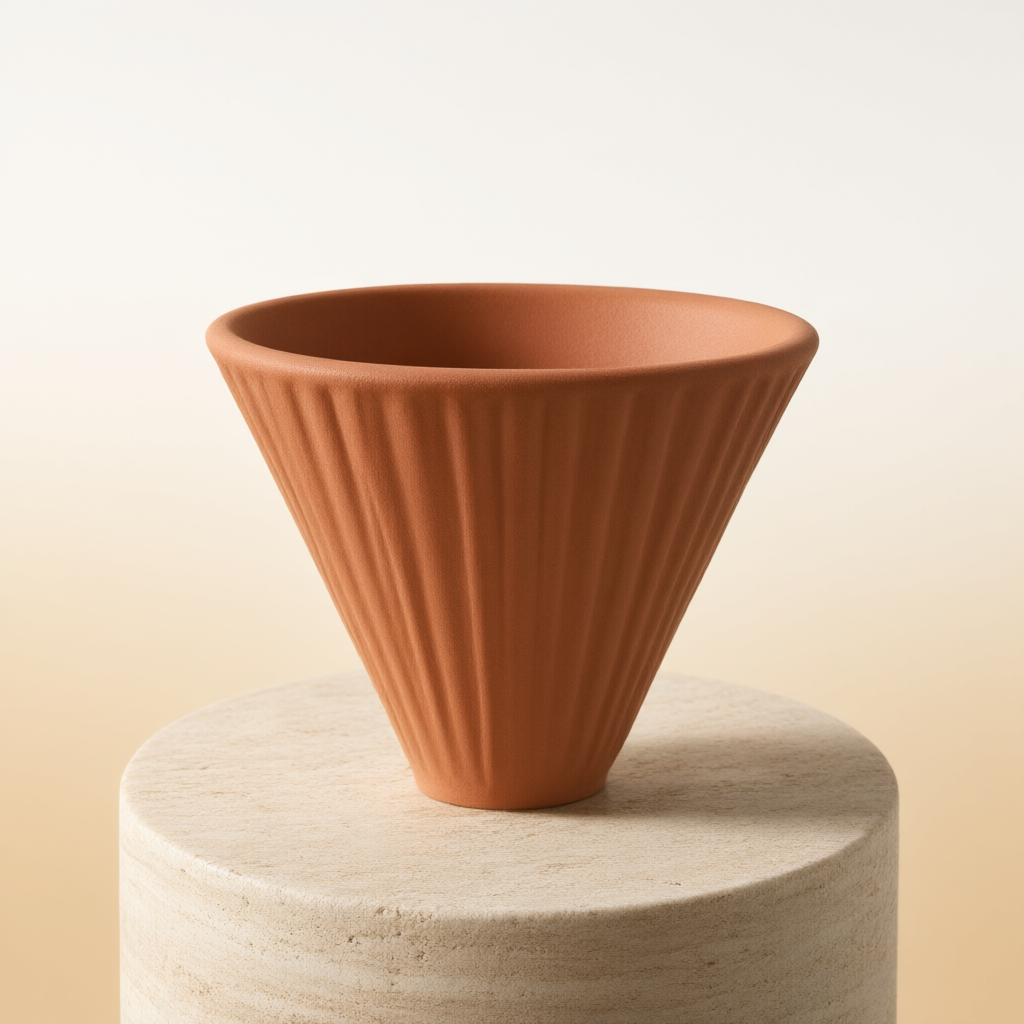
Fotografia de produto de estúdio minimalista, um porta-filtro de café de cerâmica fosca, em tom terracota quente, sobre uma base circular de travertino, com fundo em gradiente suave de areia clara para branco quente. Um único softbox direcional no canto superior esquerdo cria um realce suave de contorno nas ranhuras do porta-filtro, com uma sombra suave e sutil abaixo. Sem texto, sem adereços, sem mãos. Fotografia comercial limpa para e-commerce, foco nítido em toda a imagem, balanço de cores neutro, composição quadrada 1:1.
Por que funciona: declarar explicitamente «sem texto, sem adereços, sem mãos» impede a tendência do modelo de adicionar elementos dispersos em fotos de produto. 1:1 é a proporção padrão mais segura para imagens de produto em marketplaces, e indicar a direção da luz garante um visual consistente e reproduzível em todo o catálogo.
3. Retrato conceitual de personagem
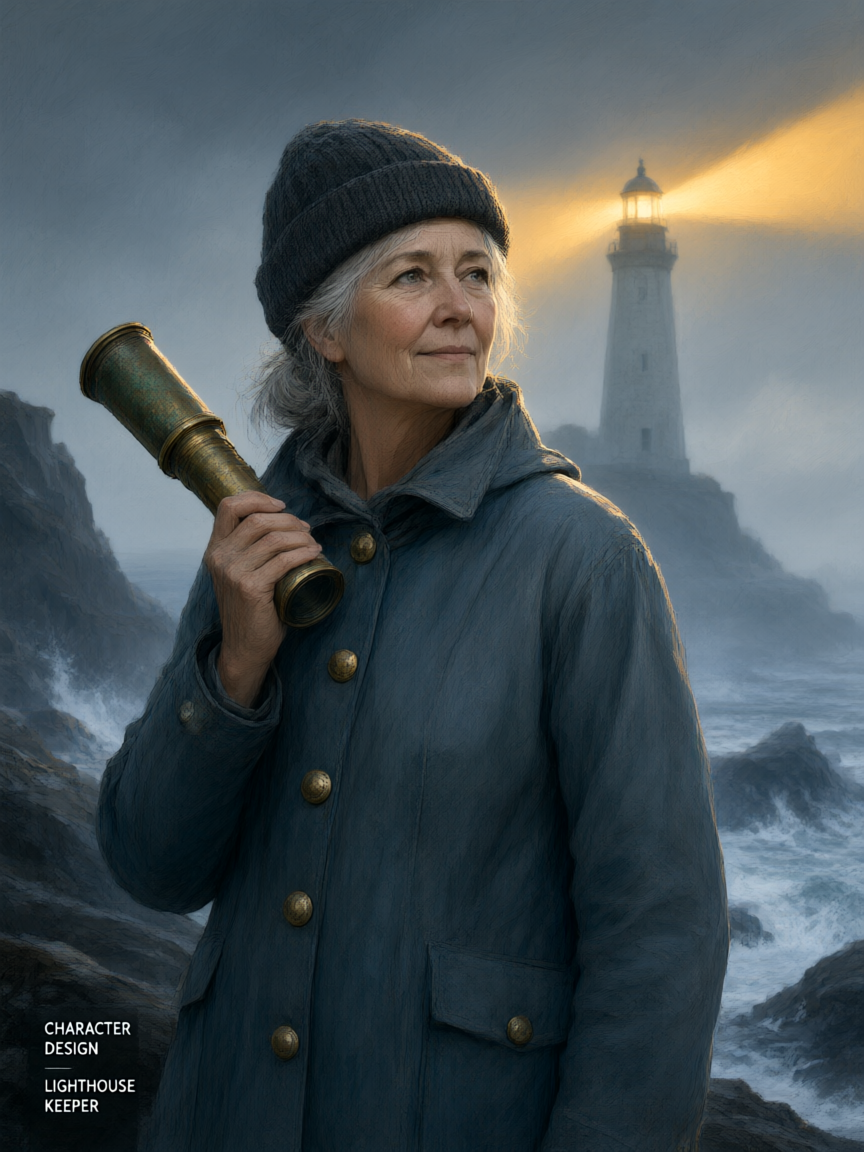
Retrato conceitual de meio corpo, uma faroleira veterana na casa dos sessenta anos, vestindo um casaco pesado de oleado com botões de latão, cabelos prateados presos para trás sob um gorro de tricô, rugas de sorriso profundas ao redor de olhos cinzentos calmos. Ela carrega um telescópio de latão antigo sobre o ombro. O fundo é uma costa tempestuosa em foco suave, com um feixe de farol aceso atravessando a névoa. Ilustração digital em estilo pictórico, pinceladas texturizadas, paleta suave de azul-acinzentado frio com luz âmbar quente do farol, luz de contorno dramática, composição vertical 3:4.
Por que funciona: detalhes de idade, vestuário e adereços («casaco pesado de oleado com botões de latão», «telescópio de latão antigo») dão ao modelo objetos concretos para renderizar, em vez de adjetivos vagos. Observe a composição aqui — nossa primeira tentativa usou 4:5, que não está na lista de proporções aceitas pelo modelo, e retornou um 400 sem cobrança. Depois de mudar para 3:4 (a proporção vertical suportada mais próxima), a tentativa seguinte funcionou.
4. Interior arquitetônico em estilo editorial
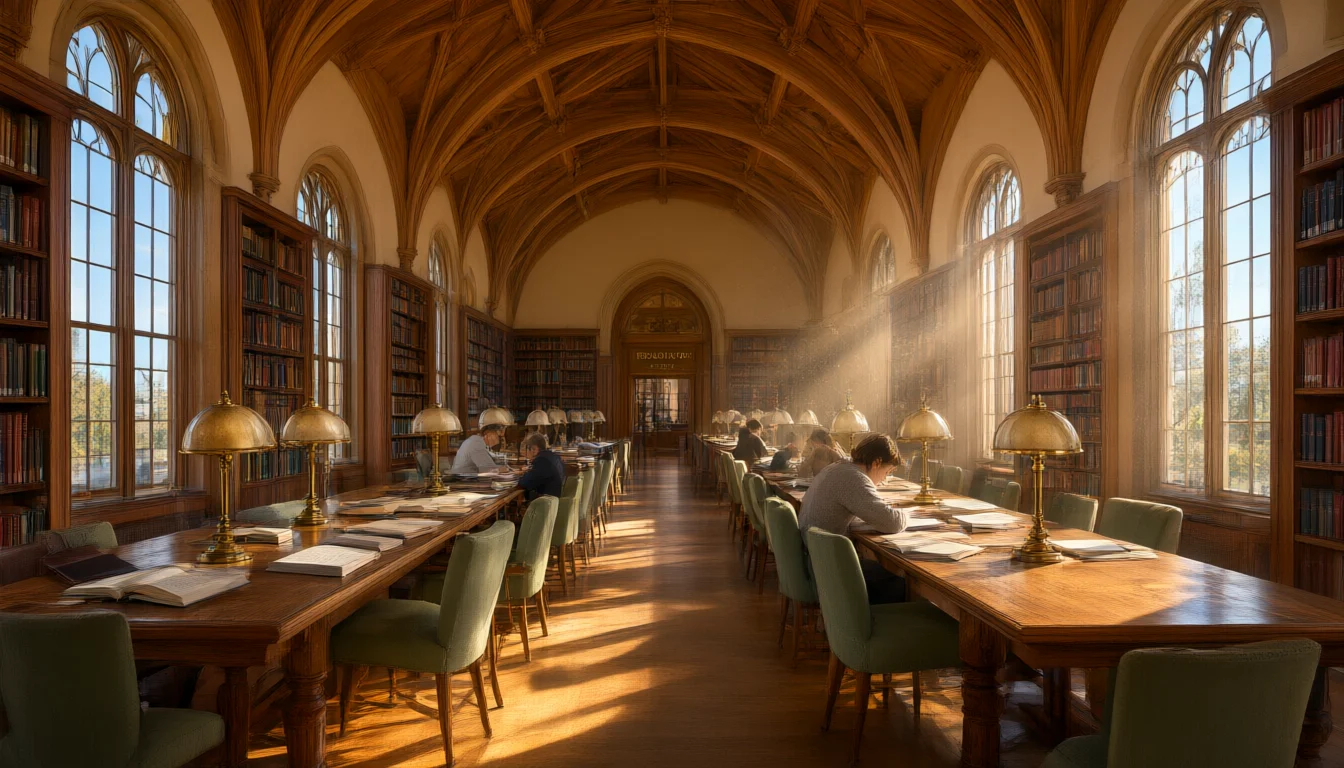
Fotografia arquitetônica em formato amplo, sala de leitura universitária banhada de sol, teto abobadado altíssimo e fileiras de janelas altas em arco. Longas mesas de carvalho se estendem pelo centro, cada uma com uma luminária de leitura de latão, e alguns estudantes estudam em silêncio em foco suave. Poeira flutua visivelmente nos grossos feixes de luz da tarde. Madeira em tom mel quente, cadeiras em verde-sálvia suave, composição simétrica com ponto de fuga único, texturas ultradetalhadas, alta faixa dinâmica, composição de destaque 16:9.
Por que funciona: nomear diretamente a técnica de composição («simétrica com ponto de fuga único») é um dos controles mais confiáveis em fotografia de arquitetura e interiores — é uma instrução concreta que o modelo consegue seguir, e não apenas uma palavra de atmosfera. 16:9 é adequado para uma imagem principal editorial ampla ou para o cabeçalho de um blog.
5. Fotografia gastronômica vista de cima
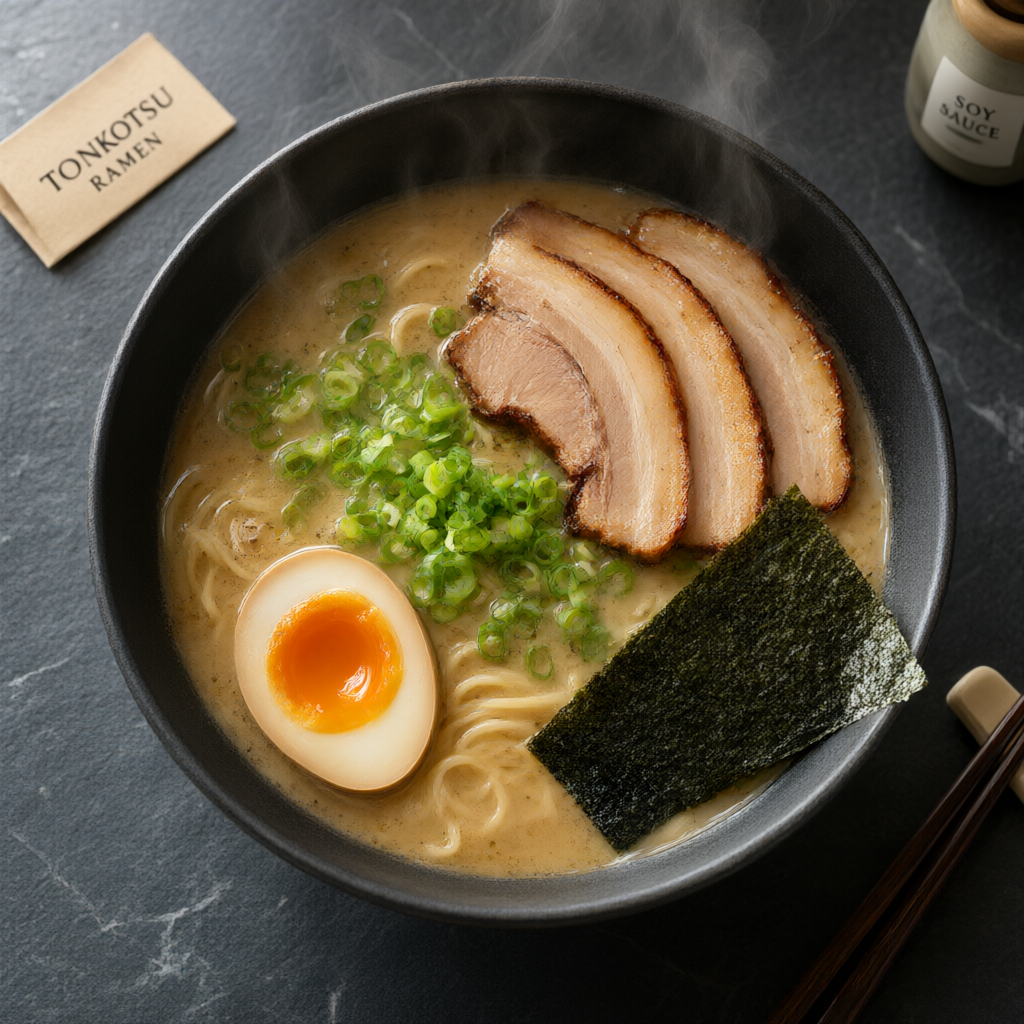
Foto macro vista de cima, uma tigela fumegante de ramen tonkotsu sobre uma mesa de ardósia escura, caldo rico e opaco refletindo a luz suave da janela, fatias brilhantes de chashu dispostas em leque sobre o macarrão, um ovo mole cortado ao meio revelando a gema cremosa, cebolinha picada espalhada e uma folha de nori apoiada na borda da tigela. Fios finos e visíveis de vapor subindo. Hashi apoiados em um pequeno descanso de cerâmica ao lado da tigela. Luz natural do dia, profundidade de campo rasa nas bordas, styling gastronômico editorial apetitoso, composição quadrada 1:1.
Por que funciona: prompts de comida se beneficiam de palavras de textura («brilhantes», «cremosa», «opaco») somadas a detalhes de montagem — essa combinação é o que separa uma renderização apetitosa de uma sem graça. «Fios finos e visíveis de vapor subindo» faz muita diferença aqui; o vapor é um dos detalhes mais estáveis que o modelo renderiza bem.
6. Pôster de lançamento de app bilíngue
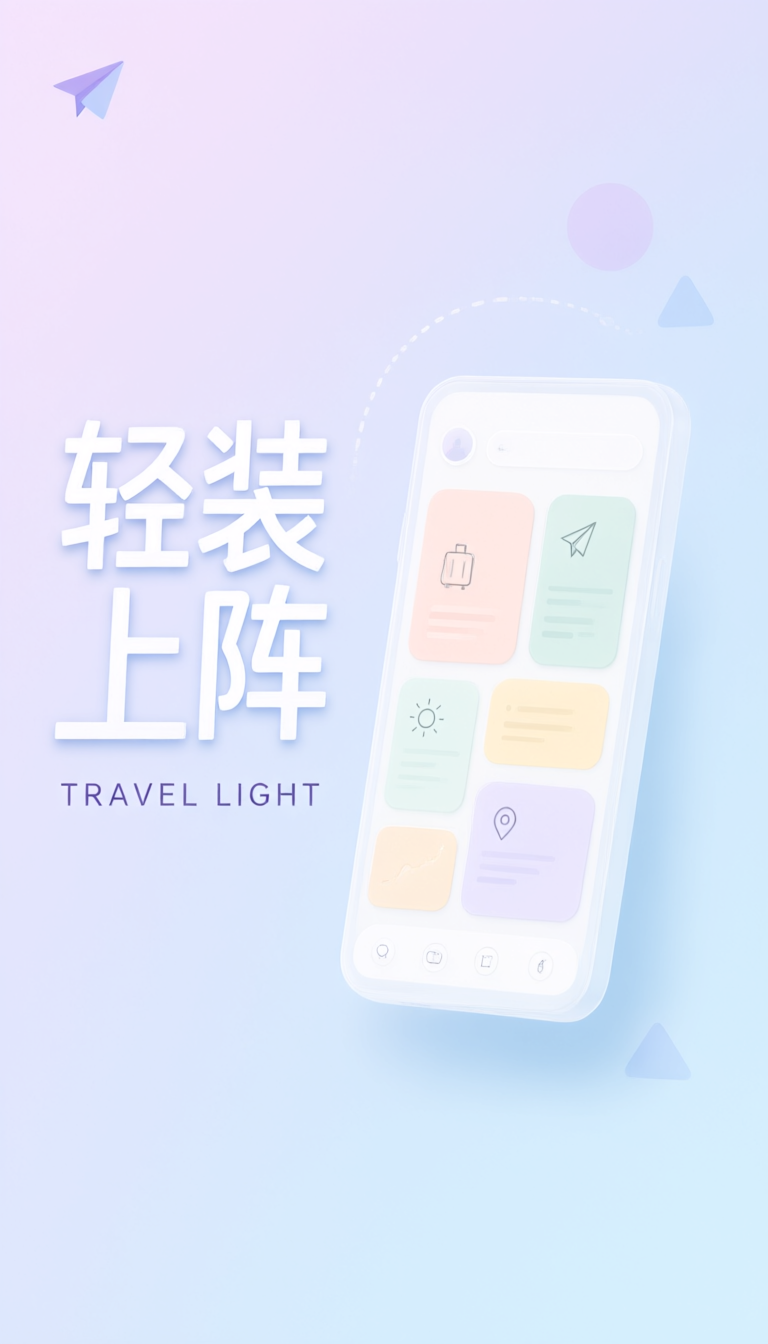
Pôster de lançamento de aplicativo móvel moderno e limpo, fundo em gradiente suave de lavanda para azul-claro. Um mockup de celular flutua levemente inclinado no centro-direita, com a tela mostrando uma interface de app abstrata e simplificada, com cartões suaves de cantos arredondados. No lado esquerdo, um título grande em negrito, sem serifa, traz apenas os caracteres chineses exatos «轻装上阵», e logo abaixo, em peso menor, a palavra inglesa exata «TRAVEL LIGHT». Formas geométricas minimalistas e sombras suaves ao redor do celular para dar profundidade. Design de marketing moderno e plano, muito espaço em branco, composição vertical 9:16.
Por que funciona: o mesmo truque da receita #1 — isolar o texto exato do título em uma oração separada e indicar o peso/tamanho relativo («logo abaixo, em peso menor») para que o modelo não receba apenas o texto, mas também a hierarquia. 9:16 corresponde à forma como esta imagem será realmente veiculada como material em app store ou divulgação social.
Proporções de aspecto realmente utilizáveis
qwen-image-3.0/text-to-image aceita apenas oito proporções de aspecto: 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16 e 21:9. Qualquer valor fora dessa lista — 4:5 e 5:4 são os dois mais usados por hábito — retorna imediatamente 400 INVALID_REQUEST, em vez de uma renderização ruim, então você não paga por esse erro. Se você está migrando prompts de um modelo com uma lista mais ampla de proporções, mapeie para o valor suportado mais próximo antes de enviar (4:5 → 3:4, 5:4 → 4:3).
Perguntas frequentes
O qwen-image-3.0/text-to-image suporta edição de imagem para imagem? Este guia trata especificamente do endpoint de texto para imagem. Antes de construir um fluxo de trabalho em torno da edição de imagens, consulte a página do modelo para ver a lista atual de modos suportados.
Quanto custa cada imagem? Até o momento em que este texto foi escrito, o endpoint de tarefas cobra $0.0358 por imagem. Os preços podem mudar, então confirme o valor atual na página de preços do hiapi antes de estimar custos em grande escala.
Por que minha requisição retorna 400 em vez de uma imagem?
A causa mais comum é um valor de aspect_ratio não suportado — a lista exata de valores aceitos está acima. A API rejeita a requisição antes de iniciar a geração, então um 400 aqui não gera nenhum custo para você.
Posso misturar chinês e inglês na mesma imagem? Sim — as receitas #1 e #6 acima fazem isso. Coloque o texto exato de cada idioma em sua própria oração entre aspas, em vez de juntá-los em uma única frase, e sempre revise o resultado renderizado antes de usá-lo em qualquer conteúdo voltado ao público.
Experimente você mesmo
Todos os seis prompts acima podem ser copiados diretamente para a sua requisição. Comece pelo guia de início rápido para fazer sua primeira chamada, ou acesse a página do modelo qwen-image-3.0/text-to-image para consultar a referência completa de parâmetros.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores