
Guide d'utilisation
Recettes de prompts Qwen Image 3.0 : prompts prêts à copier et résultats réels
L'API texte-image de Qwen Image 3.0 excelle dans un domaine que la plupart des modèles d'image ne maîtrisent toujours pas : le rendu précis de texte — y compris le mélange chinois-anglais — assez propre pour être livré sans retouche. Cela justifie un manuel de prompts dédié, plutôt qu'un énième article générique sur « comment écrire des prompts IA ».
Voici 6 prompts complets et directement copiables, que nous avons rédigés nous-mêmes et exécutés réellement sur qwen-image-3.0/text-to-image, chacun accompagné de sa sortie réelle non éditée. Chaque prompt est placé juste à côté de son image, pour que vous puissiez le reprendre tel quel ou remplacer le sujet par le vôtre.
Ce que ce modèle sait vraiment faire
Avant d'entrer dans les recettes, trois choses valent la peine d'être connues pour ne pas gaspiller une génération :
- Rendu de texte précis. Si vous écrivez entre guillemets les caractères exacts souhaités — en chinois, en anglais, ou les deux dans la même scène — le modèle parvient la plupart du temps à les rendre nets et lisibles. Relisez toujours avant publication ; des traits ou des lettres erronés restent possibles.
- La liste des ratios d'aspect pris en charge est plus étroite que prévu. L'API n'accepte que
1:1,3:2,2:3,4:3,3:4,16:9,9:16et21:9. Des ratios courants comme4:5ou5:4renvoient directement un400propre avant toute facturation — voir plus bas. - Tarification uniforme par image. À la date de rédaction, l'endpoint de tâche facture uniformément 0,0358 $ par image, quel que soit le ratio d'aspect (vérifié sur la tarification en temps réel de hiapi).
6 recettes de prompts
1. Enseigne de vitrine bilingue
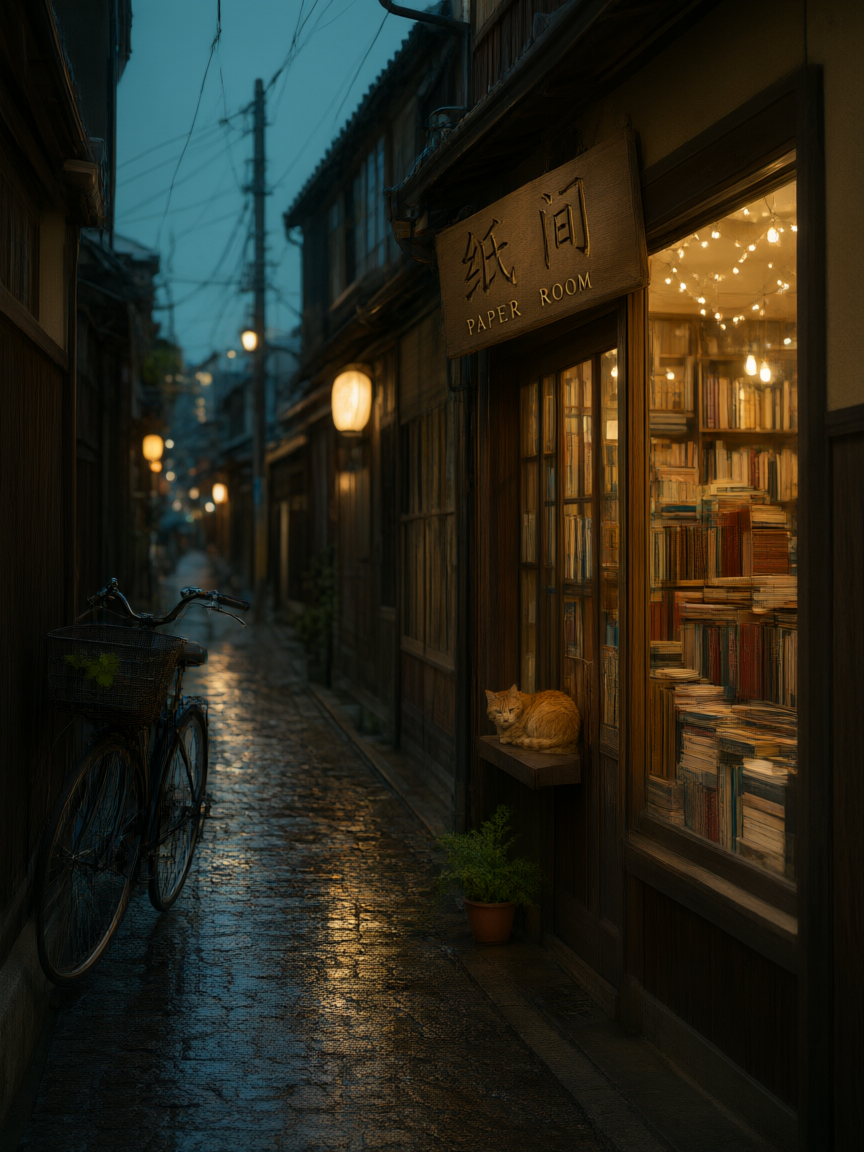
Photo de rue cinématographique, une petite librairie indépendante dans une ruelle étroite de Kyoto au crépuscule, une chaude lumière de tungstène se déversant des hautes fenêtres vitrées sur les pavés humides. Sur la porte est suspendue une enseigne en bois peinte à la main, portant uniquement les caractères chinois exacts « 纸间 », et juste en dessous, en petites lettres de laiton brossé, le mot anglais exact « PAPER ROOM ». Des piles de livres visibles à travers la vitrine, un doux bokeh de guirlandes lumineuses au-dessus. Un chat assis sur le rebord de la fenêtre. Style photographie de rue documentaire, composition naturellement asymétrique, palette douce sarcelle et ambre, grain de film fin, faible profondeur de champ, composition verticale 3:4.
Pourquoi cela fonctionne : placer les chaînes exactes en chinois et en anglais dans des phrases distinctes, entre guillemets, donne au modèle une cible textuelle explicite au lieu de l'enfouir dans une longue proposition descriptive. Le format vertical 3:4 correspond aussi à la façon dont les photos d'enseignes de vitrine réelles sont généralement cadrées.
2. Image produit principale e-commerce
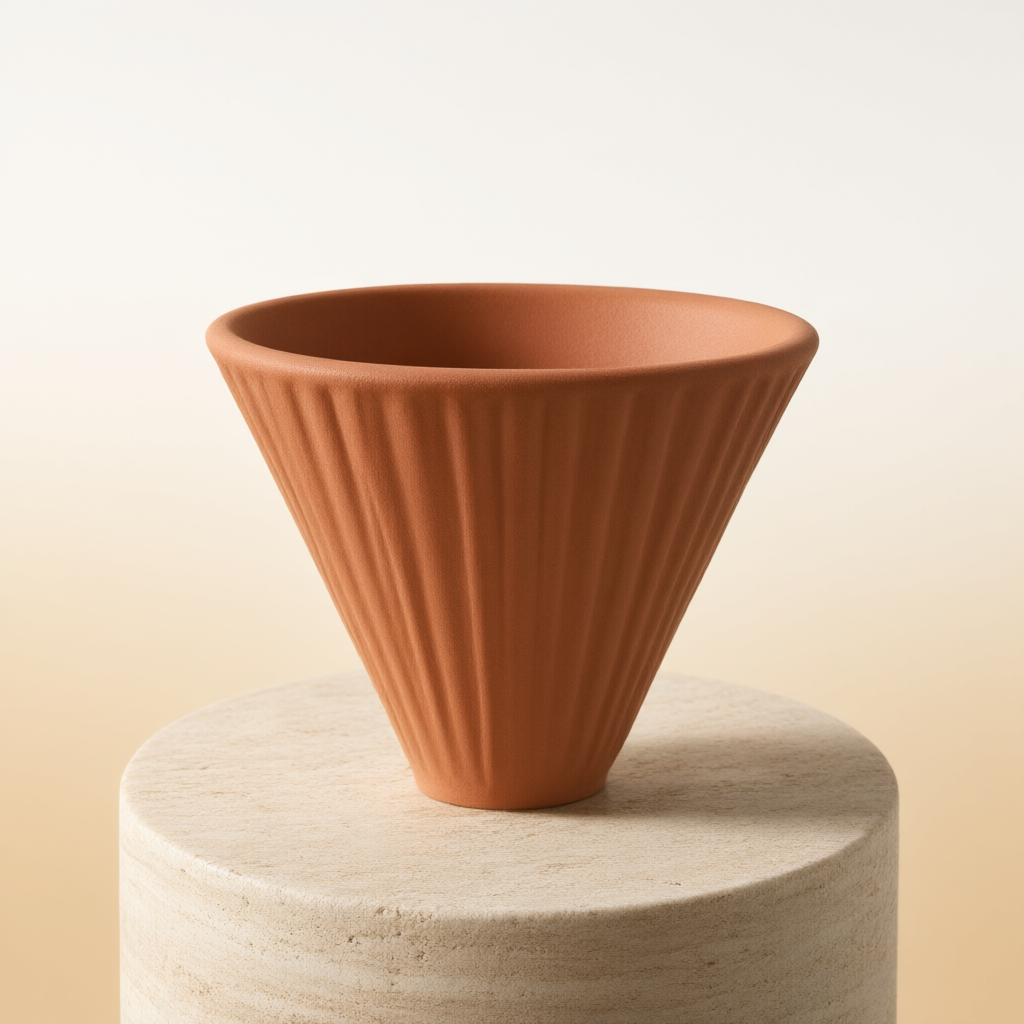
Photographie produit studio minimaliste, un filtre à café pour infusion manuelle en céramique mate, d'un chaud coloris terre cuite, posé sur un socle circulaire en travertin, sur un fond dégradé doux passant du sable pâle au blanc chaud. Une softbox directionnelle unique en haut à gauche crée un léger reflet de contour sur les nervures du filtre, avec une ombre douce et subtile en dessous. Aucun texte, aucun accessoire, aucune main. Photographie commerciale e-commerce propre, netteté sur toute l'image, balance des couleurs neutre, composition carrée 1:1.
Pourquoi cela fonctionne : écrire explicitement « aucun texte, aucun accessoire, aucune main » empêche la tendance du modèle à ajouter des éléments superflus dans les images produit. 1:1 est le ratio par défaut le plus sûr pour les visuels de fiche produit sur les plateformes e-commerce, et préciser la direction de la lumière donne un rendu cohérent et reproductible sur tout un catalogue.
3. Portrait conceptuel de personnage
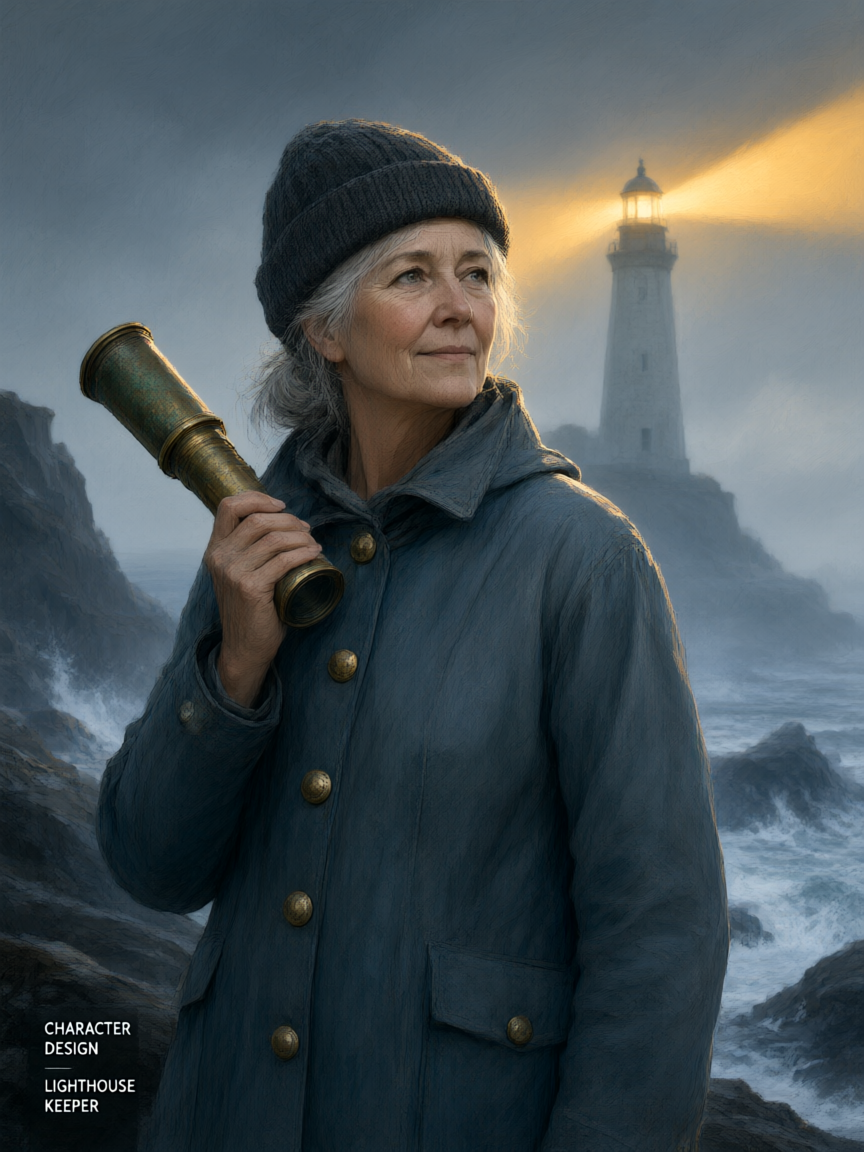
Portrait conceptuel en buste, une gardienne de phare burinée d'une soixantaine d'années, portant un lourd manteau de toile huilée à boutons de laiton, des cheveux argentés ramenés en arrière sous un bonnet en tricot, de profondes rides du sourire autour de yeux gris sereins. Elle porte sur l'épaule une longue-vue en laiton usée. En arrière-plan, une côte battue par la tempête en flou artistique, un faisceau de phare allumé perçant la brume. Illustration numérique de style pictural, coups de pinceau texturés, palette douce de gris-bleu froid rehaussée d'une chaude lumière ambrée de phare, éclairage de contour dramatique, composition verticale 3:4.
Pourquoi cela fonctionne : les détails d'âge, de vêtement et d'accessoire (« lourd manteau de toile huilée à boutons de laiton », « longue-vue en laiton usée ») donnent au modèle des objets concrets à rendre, plutôt que des adjectifs vagues. Notez le cadrage ici — notre premier essai utilisait 4:5, qui ne figure pas dans la liste des ratios d'aspect acceptés par le modèle, et a renvoyé un 400 non facturé. En passant à 3:4 (le ratio vertical pris en charge le plus proche), la tentative suivante a réussi.
4. Intérieur architectural de style éditorial
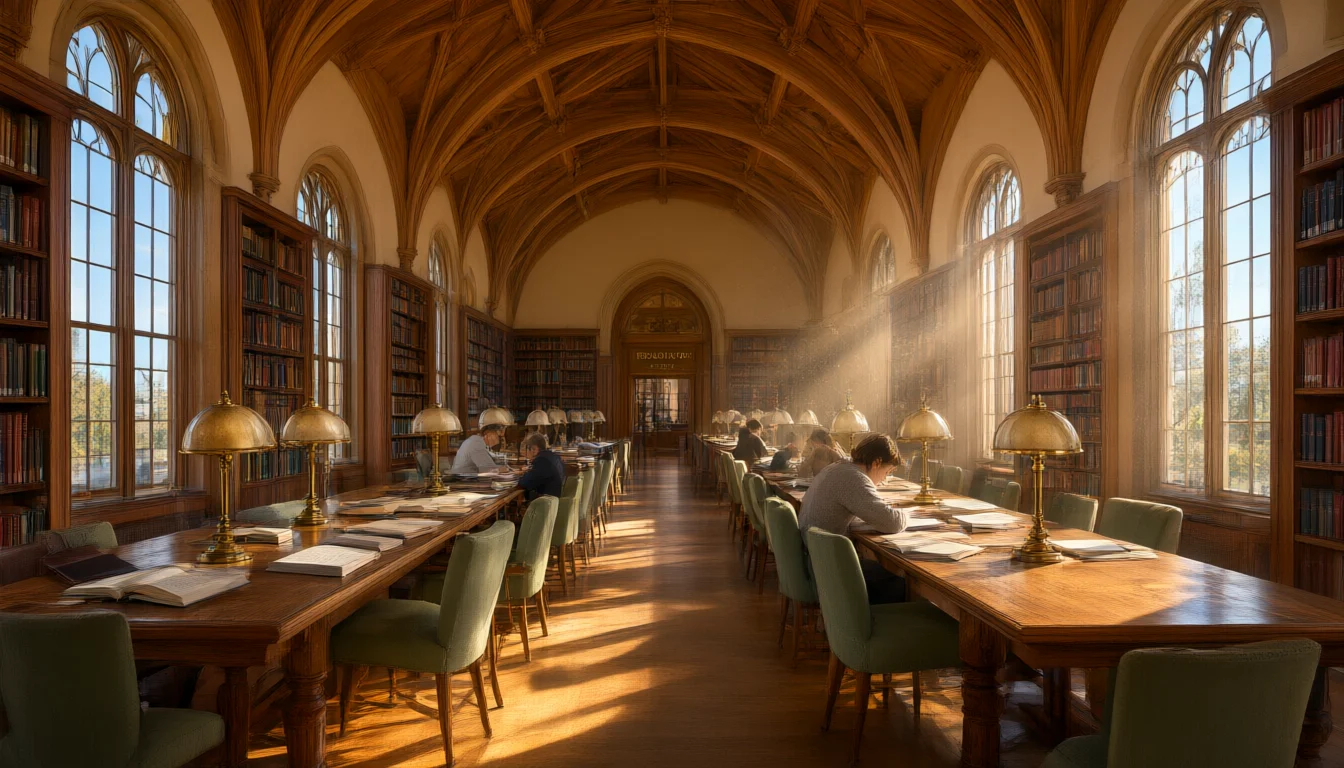
Photographie d'architecture grand format, une salle de lecture universitaire baignée de soleil, avec un haut plafond voûté et des rangées de hautes fenêtres en arc. De longues tables en chêne s'étendent le long de l'axe central, chacune portant une lampe de lecture en laiton, quelques étudiants étudiant paisiblement dans un flou doux. La poussière flotte visiblement dans les épais rais de lumière de l'après-midi. Bois chaud couleur miel, chaises douces vert sauge, composition symétrique à point de fuite unique, textures ultra-détaillées, plage dynamique élevée, composition visuelle principale 16:9.
Pourquoi cela fonctionne : nommer directement la technique de composition (« perspective symétrique à point de fuite unique ») est l'un des leviers les plus fiables en photographie d'architecture et d'intérieur — c'est une instruction concrète que le modèle peut suivre, pas seulement un mot d'ambiance. 16:9 convient comme visuel principal éditorial large ou image d'en-tête de blog.
5. Photographie culinaire en plongée
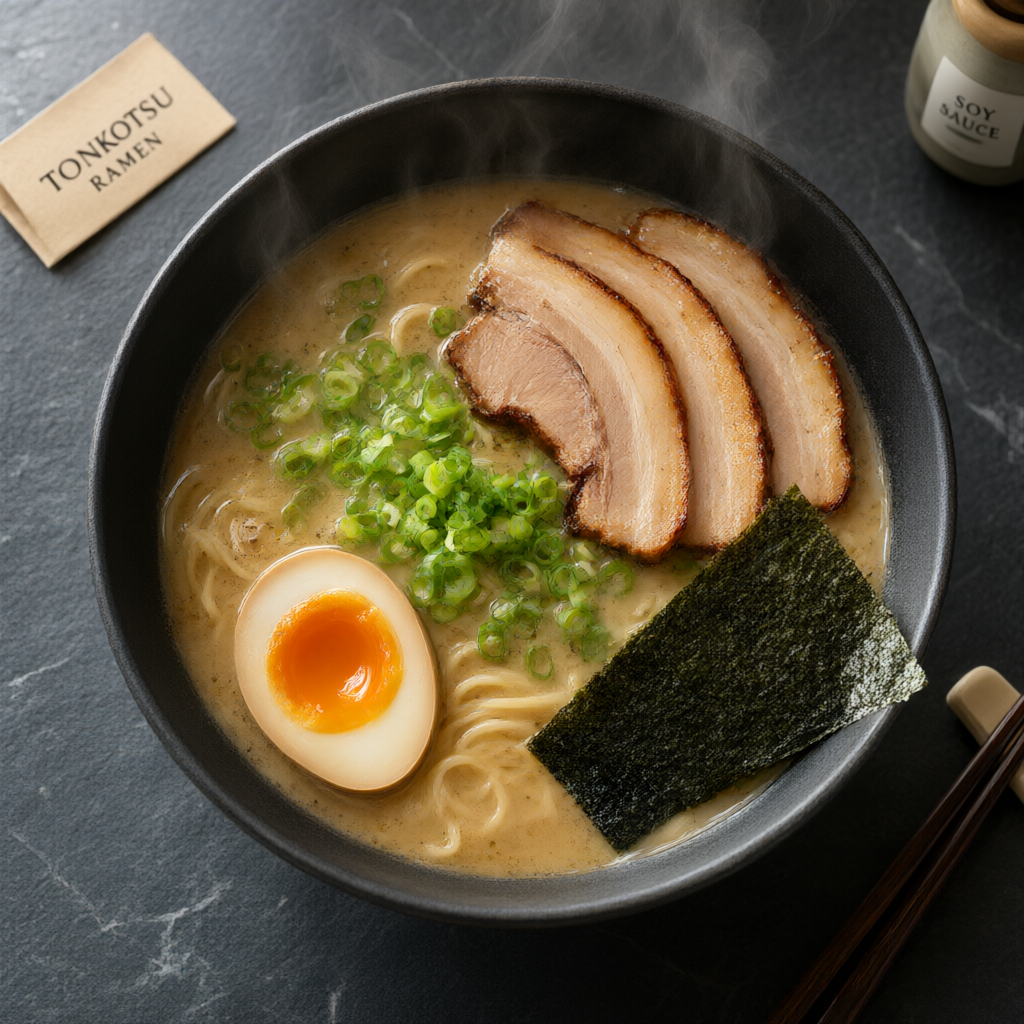
Photo macro en plongée, un bol de ramen tonkotsu fumant posé sur une table en ardoise sombre, un bouillon riche et trouble reflétant une douce lumière de fenêtre, des tranches de chashu brillantes disposées en éventail sur les nouilles, un œuf mi-cuit coupé en deux révélant un jaune coulant, des échalotes vertes éparpillées et une feuille de nori appuyée contre le bord du bol. De fines volutes de vapeur visibles s'élevant. Des baguettes posées sur un petit repose-baguettes en céramique à côté du bol. Lumière naturelle du jour, faible profondeur de champ sur les bords, stylisme culinaire éditorial appétissant, composition carrée 1:1.
Pourquoi cela fonctionne : les prompts culinaires gagnent à superposer des mots de texture (« brillant », « coulant », « trouble ») aux détails de dressage — c'est cette combinaison qui sépare un rendu appétissant d'un rendu fade. « De fines volutes de vapeur visibles s'élevant » joue ici un grand rôle ; la vapeur est l'un des détails les plus stables que le modèle rend bien.
6. Affiche de lancement d'application bilingue
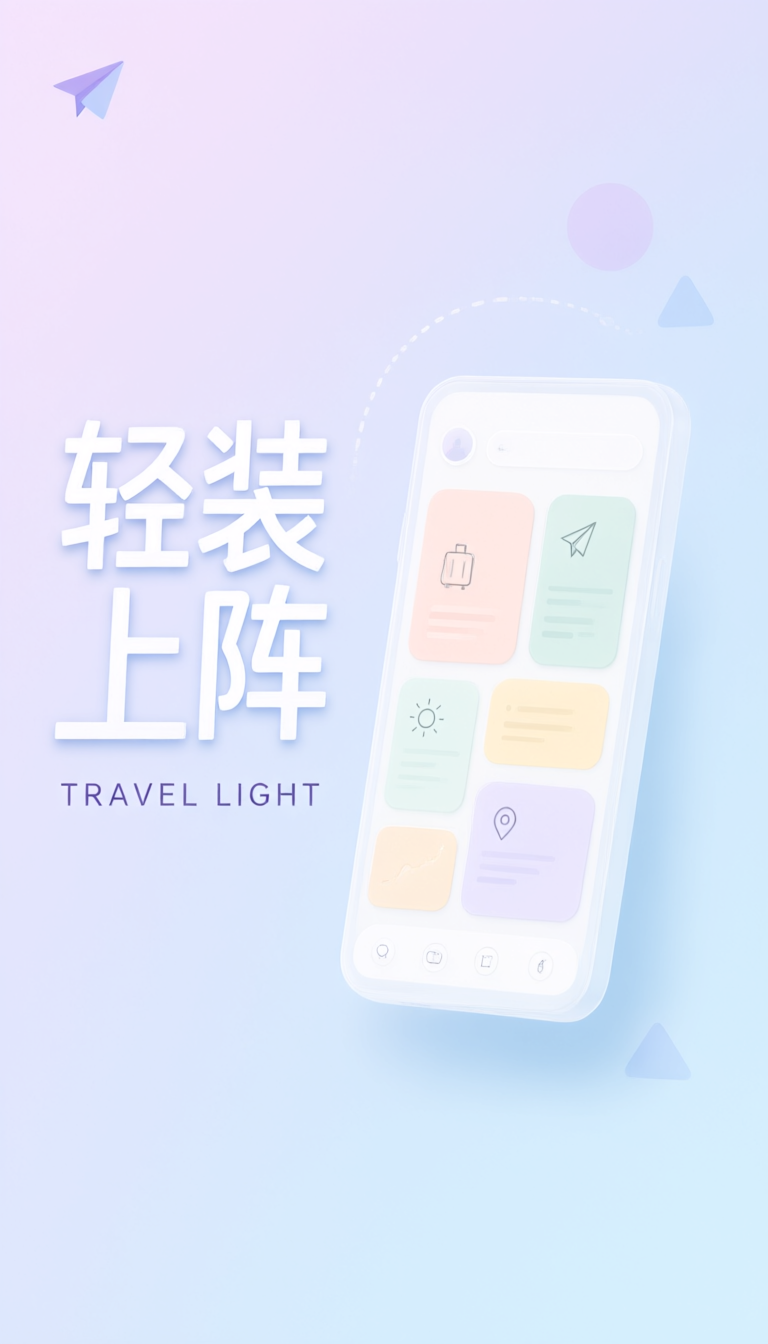
Affiche de lancement d'application mobile moderne et épurée, fond en dégradé doux passant du violet lavande au bleu pâle. Un mockup de téléphone flotte légèrement incliné au centre droit, son écran affichant une interface d'application abstraite simplifiée avec des cartes douces aux coins arrondis. À gauche, un grand titre en gras sans empattement portant uniquement les caractères chinois exacts « 轻装上阵 », et juste en dessous, dans un corps plus petit, le mot anglais exact « TRAVEL LIGHT ». Autour du téléphone, des formes géométriques minimalistes et des ombres douces pour ajouter de la profondeur. Design marketing plat et moderne, beaucoup d'espace blanc, composition verticale 9:16.
Pourquoi cela fonctionne : même astuce que la recette n° 1 — isoler le texte exact du titre dans une proposition distincte et préciser le poids/la taille relatifs (« juste en dessous, dans un corps plus petit ») permet au modèle de saisir non seulement le texte, mais aussi la hiérarchie. 9:16 correspond à la façon dont cette image sera réellement diffusée, sur une boutique d'applications mobiles ou comme visuel promotionnel sur les réseaux sociaux.
Les ratios d'aspect réellement disponibles
qwen-image-3.0/text-to-image n'accepte que huit ratios d'aspect : 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16 et 21:9. Toute valeur hors de cette liste — 4:5 et 5:4 étant les deux que les gens utilisent le plus par habitude — renvoie immédiatement un 400 INVALID_REQUEST, et non un mauvais rendu, donc vous ne payez pas pour cette erreur. Si vous migrez des prompts depuis un modèle dont la liste de ratios est plus large, convertissez-les vers la valeur prise en charge la plus proche avant de soumettre (4:5 → 3:4, 5:4 → 4:3).
Questions fréquentes
qwen-image-3.0/text-to-image prend-il en charge l'édition image-vers-image ? Ce guide porte spécifiquement sur l'endpoint texte-image. Avant de construire un flux de travail autour de l'édition d'image, consultez la page du modèle pour connaître la liste actuelle des modes pris en charge.
Combien coûte chaque image ? À la date de rédaction, l'endpoint de tâche facture 0,0358 $ par image. Les tarifs peuvent changer, donc avant d'estimer un coût à grande échelle, vérifiez le chiffre actuel sur la page de tarification hiapi.
Pourquoi ma requête renvoie-t-elle un 400 au lieu d'une image ?
La cause la plus fréquente est une valeur aspect_ratio non prise en charge — la liste exacte des valeurs acceptées figure plus haut. L'API rejette la requête avant que la génération ne commence, donc ce 400 ne vous coûte rien.
Puis-je mélanger chinois et anglais dans une même image ? Oui — les recettes n° 1 et n° 6 ci-dessus le font. Citez le texte exact de chaque langue dans des propositions distinctes, plutôt que de les fusionner en une seule phrase, et relisez toujours le rendu avant de l'utiliser dans un contenu destiné au public.
Essayez par vous-même
Les six prompts ci-dessus peuvent être copiés directement dans votre requête. Commencez par le guide de démarrage rapide pour lancer votre premier appel, ou rendez-vous sur la page du modèle qwen-image-3.0/text-to-image pour consulter la référence complète des paramètres.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax