
Руководство
Промпт для видео Seedance 2.0: 15-секундный продуктовый ролик, разбор по секундам
Полный промпт для непрерывного 15-секундного продуктового ролика Seedance 2.0, включая точный облёт камеры, разделение слоёв и финальный кадр, на который можно наложить заголовок.
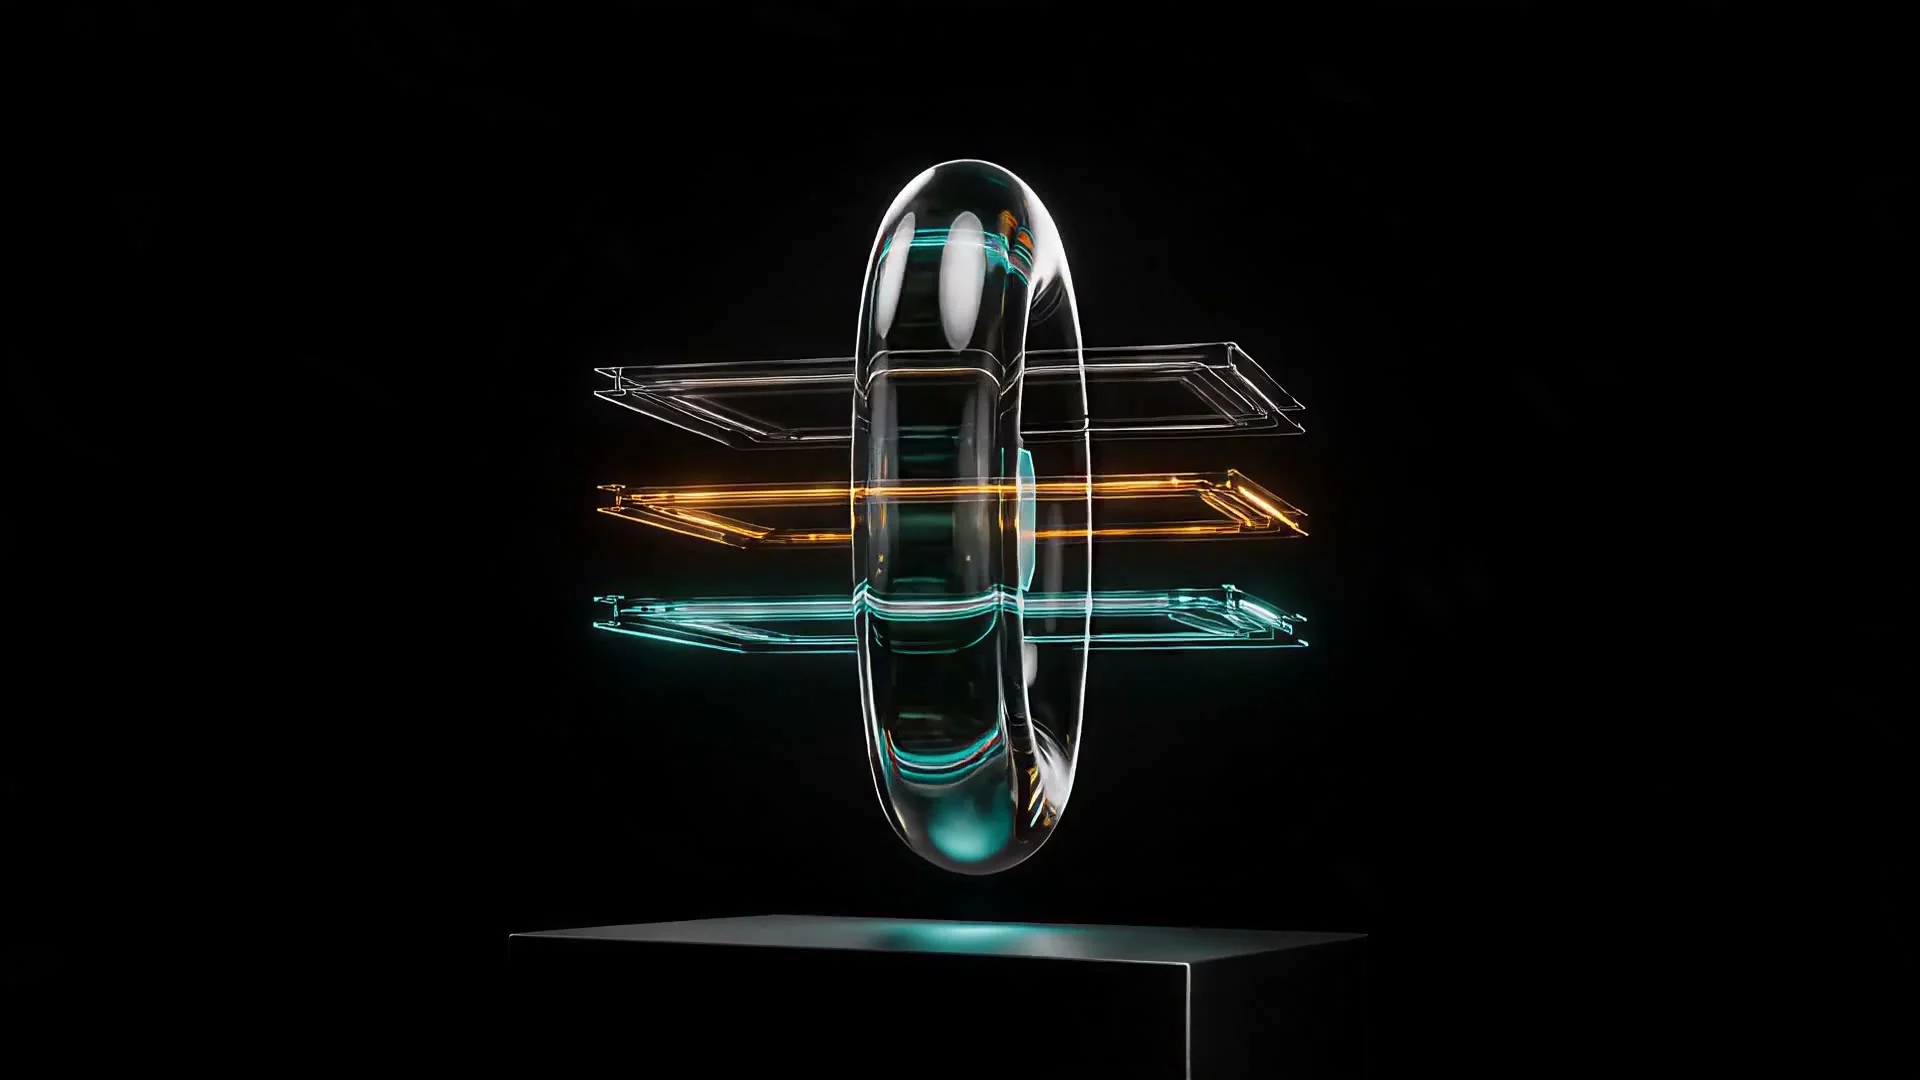
Большинство советов по «промптам для видео» ограничиваются описанием сцены. Это работает для одного статичного кадра, но ломается, когда вы просите модель снять непрерывный 15-секундный дубль: субъект дрейфует, освещение меняется на полпути, а финал не имеет ничего общего с началом. Промпт ниже — реальный случай, взятый из собственной библиотеки материалов HiAPI, а не написанный специально для этой статьи — он удерживает один и тот же стеклянный продукт стабильным на протяжении медленного облёта камеры, трёхслойного внутреннего превращения и последнего спокойного кадра, без единой монтажной склейки.
Здесь мы воспроизводим исходный результат рендеринга, а не генерируем заново, поэтому вы видите именно то, что выдал промпт при первом запуске.
Полный промпт
Вот полный, неотредактированный промпт — скопируйте его как отправную точку для собственного продуктового ролика:
One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered translucent glass monolith while maintaining nearly constant subject scale. During the arc, the dense inner architecture separates with precise mechanical elegance into three ultra-thin luminous layers representing image, video, and audio; the layers glide in orderly parallel paths, then converge into one unified API core. The faceted outer glass shell progressively consolidates with controlled physical continuity into the simpler rounded glass portal shown in the closing keyframe. Cyan-teal and warm amber reflections travel subtly across the glass while the black studio and pedestal remain stable. From second ten to twelve, the camera decelerates smoothly into the closing viewpoint. From second twelve to fifteen, hold the final product frame calm and nearly motionless for a brand title overlay. The sequence stays centered, elegant, quiet, photorealistic, and stabilized; the clean frame contains only the glass product and pedestal, with coherent material, shadows, perspective, and lighting throughout.
Разбор по частям: почему это работает
Этот промпт читается как раскадровка с секундомером, а не как мудборд. В этом и есть главный приём: каждая инструкция привязана к интервалу в секундах, поэтому у модели нет никакой двусмысленности относительно того, когда что-то должно произойти.
Секунды 0–1: сначала статика, потом движение
«Hold the exact opening composition for the first second» даёт модели чистый опорный кадр перед началом движения. Пропуск этого такта — самая частая причина дрожащего начала AI-видео: камера и субъект ещё борются за положение в первом кадре, вместо того чтобы стартовать с уже стабильного изображения.
Секунды 1–10: одно действие, описано один раз
Облёт на 12 градусов намеренно сделан небольшим, но охватывает самый длинный отрезок ролика. «Maintaining nearly constant subject scale» — это предложение, которое действительно работает: оно говорит модели не приближаться и не дрейфовать во время вращения, а это типичный режим отказа облётных кадров (субъект растёт от кадра к кадру, и к восьмой секунде композиция разваливается).
Превращение происходит послойно, а не одновременно
В одном и том же десятисекундном окне параллельно происходят три независимые визуальные идеи: внутренние слои (изображение/видео/аудио) разделяются и снова сходятся, при этом внешняя оболочка упрощается до формы из финального ключевого кадра. Явное называние каждого слоя — вместо просто «продукт трансформируется» — как раз и помогает избежать того, что три несвязанных визуальных изменения слипаются в одну неаккуратную деформацию.
Секунды 10–12: замедление перед приземлением
Резкая остановка движущейся камеры читается как ошибка, а не как выбор. Явный двухсекундный такт замедления перед выходом в финальную композицию — это то, что делает концовку осмысленной, а не обрезанной.
Секунды 12–15: пустой кадр — это и есть суть
Последние три секунды почти не требуют движения — «hold the final product frame calm and nearly motionless for a brand title overlay». Это производственная инструкция, а не творческая: она оставляет чистое, неподвижное экранное пространство для текста или логотипа, которые будут добавлены позже. Во встроенном выше видео нет заранее запечённого текста заголовка — это сделано намеренно. Версия с брендовым шрифтом собирается на постпродакшене и накладывается на тот же самый финальный кадр — вот почему никогда не стоит просить видеомодель напрямую отрисовывать ваше настоящее название продукта или слоган как экранный текст в процессе генерации.
Якоря непрерывности: детали, предотвращающие дрейф
«Cyan-teal and warm amber reflections», «the black studio and pedestal remain stable» и «coherent material, shadows, perspective, and lighting throughout» — это не декоративные обороты, а защита от дрейфа. В непрерывном 15-секундном дубле, если вы не повторяете, что должно оставаться неизменным, а указываете только то, что должно измениться, модель с радостью переосмыслит оттенок вашего освещения или цвет пьедестала на полпути.
Воспроизведение: пример вызова API
Этот ролик был сгенерирован на seedance-2.0 в режиме image-to-video с привязкой к первому кадру (открывающая композиция) и последнему кадру (финальный ключевой кадр), а не только по текстовому промпту — именно поэтому модель сводит форму оболочки к конкретной цели, а не угадывает. Ниже — эквивалентный вызов /v1/tasks:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered subject while maintaining nearly constant subject scale...",
      "first_frame_url": "https://your-cdn.example.com/opening-frame.jpg",
      "last_frame_url": "https://your-cdn.example.com/closing-frame.jpg",
      "duration": 15,
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
Опрашивайте возвращённую задачу, пока она не перейдёт в терминальное состояние, затем заберите готовый ролик из output[0].url. В 1080p seedance-2.0 тарифицируется по $0.729 за секунду — 15-секундный ролик, как этот, обойдётся в $10.94 суммарно. Если вы сначала прототипируете тайминг перед полноценным рендером по полной цене, можно снизить до 480p ($0.136/с, около $2.04 за 15 секунд), чтобы проверить ритм, а затем перерендерить финальную версию в 1080p.
Частые вопросы
Могу я скачать именно этот ролик и использовать его как собственное продуктовое видео? Нет — это внутренний материал HiAPI, показанный здесь для демонстрации приёмов промптинга. Используйте собственную продуктовую съёмку в качестве первого/последнего кадра и адаптируйте временную структуру промпта под свой субъект.
Почему разбивать промпт на посекундные такты, а не на одно плавное описание? Потому что непрерывный 15-секундный дубль должен выдержать несколько разных событий (фиксация, облёт, внутреннее превращение, замедление, финальная остановка) без единой склейки, которая сбросила бы понимание модели. Проставление временных меток для каждого такта — это то, что позволяет физике и композиции оставаться согласованными сквозь все эти события, вместо того чтобы модель выбрала одну интерпретацию и дрейфовала по ней до конца.
Что делать, если у меня нет готовых первого и последнего кадров?
seedance-2.0 также умеет text-to-video только по промпту — уберите поля first_frame_url/last_frame_url и оставьте duration, resolution и aspect_ratio. У вас будет меньше контроля над точной открывающей и финальной композицией, поэтому компенсируйте это, уточнив в промпте описание начального кадра.
Отрисует ли модель мой текст заголовка прямо на видео? Не рассчитывайте на это — видеомодели гораздо менее надёжны в отрисовке чистого экранного текста, чем модели изображений. Именно поэтому данный промпт требует почти неподвижный финальный кадр в конце, а не просит модель рисовать текст: наложите заголовок на этот чистый кадр на постпродакшене.
Попробуйте сами
Если вам нужен полный список параметров — диапазоны разрешений, входные данные референсного видео и аудио, цены по разрешениям — на странице модели seedance-2.0 есть актуальная схема и текущая детализация цен. Если хотите применить ту же модель с другим приёмом камеры для однодубльного POV, смотрите наш разбор промпта для однодубльного POV.
Похожие статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата