
Tutoriale
Prompt video Seedance 2.0: un filmato di lancio prodotto da 15 secondi, analizzato secondo per secondo
Il prompt completo di un filmato prodotto Seedance 2.0 continuo di 15 secondi, con orbita precisa della camera, separazione dei livelli e finale con titolo sovrapponibile.
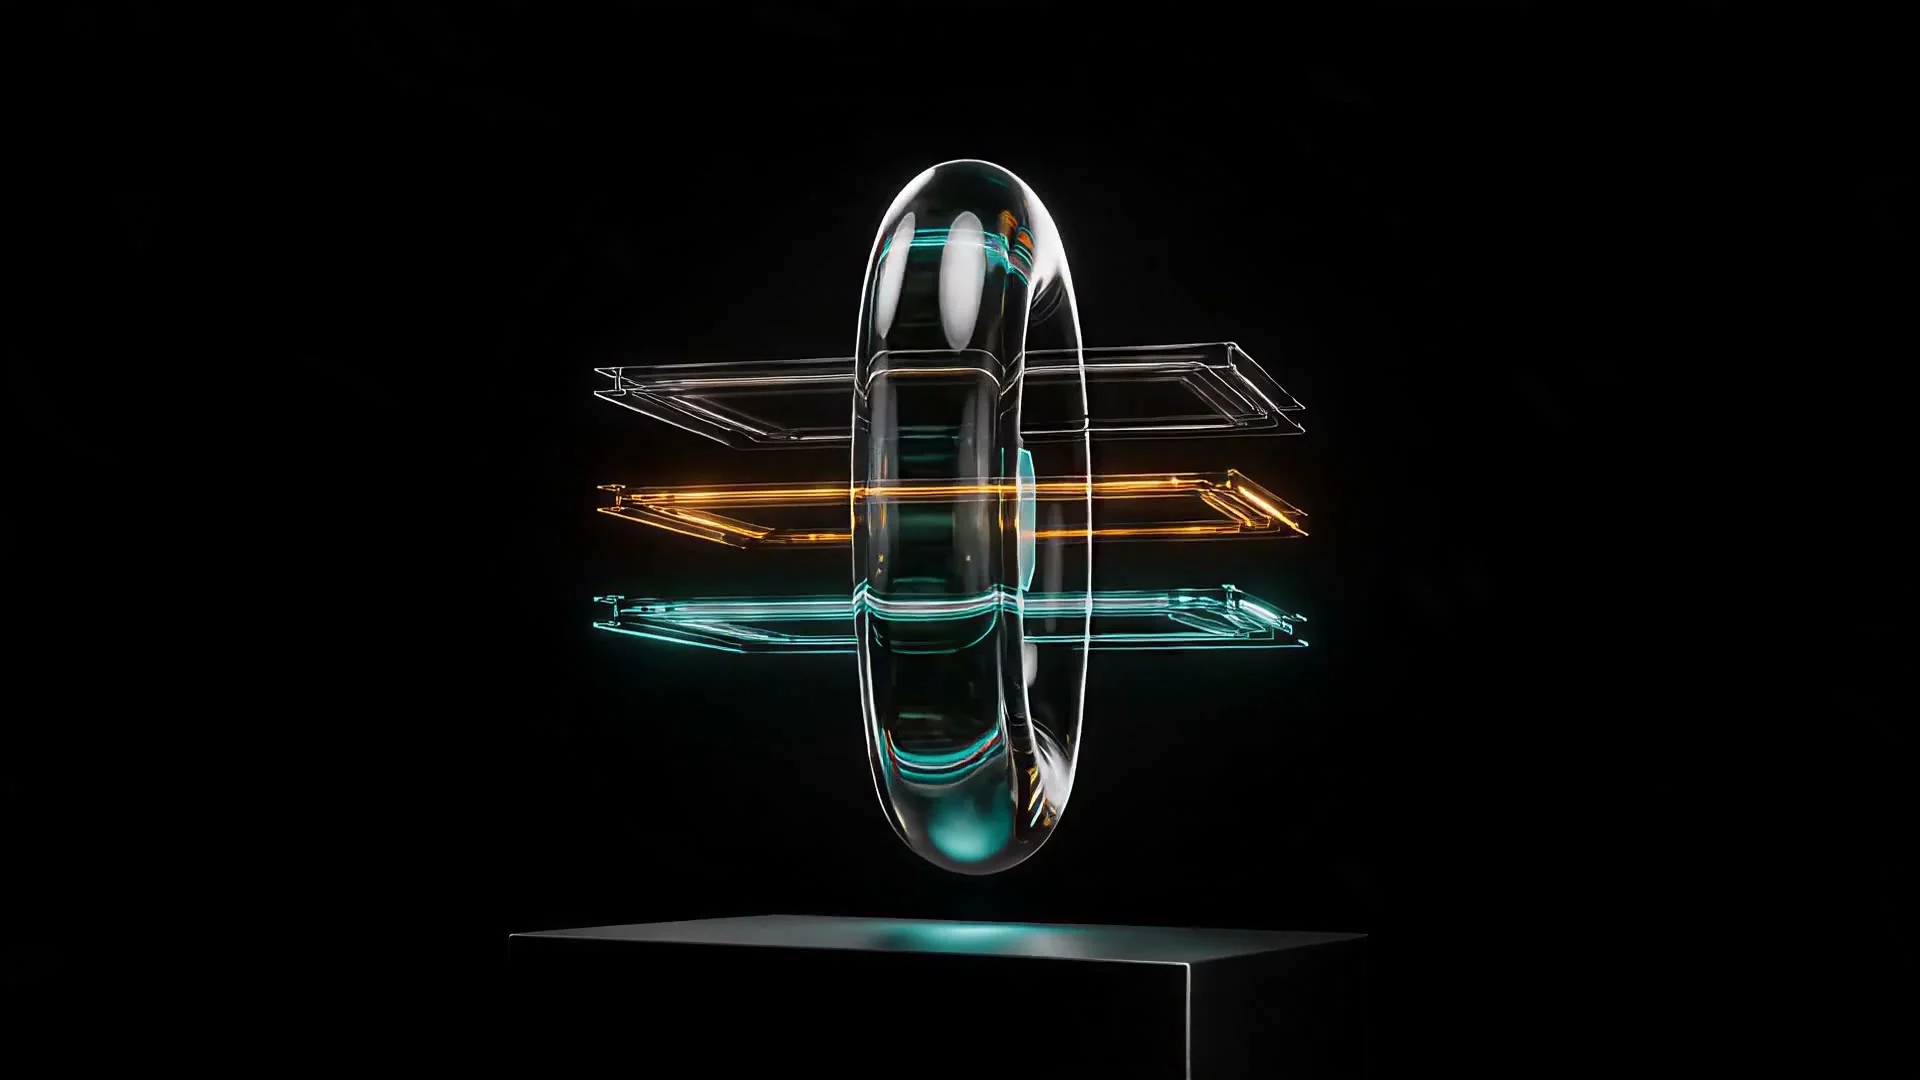
La maggior parte dei consigli sui «prompt video» si ferma a descrivere la scena. Funziona per un singolo piano statico, ma crolla quando chiedi al modello un piano sequenza continuo di 15 secondi: il soggetto va alla deriva, l'illuminazione cambia a metà, il finale non assomiglia per niente all'inizio. Il prompt qui sotto è un caso reale — preso dalla libreria di materiali di HiAPI stessa, non scritto per questo articolo — che mantiene lo stesso prodotto in vetro stabile durante un lento orbitare della camera, una trasformazione interna a tre livelli e un fermo immagine calmo finale, senza un solo punto di montaggio.
Qui riutilizziamo il rendering originale, non una rigenerazione, quindi quello che vedi è l'output della prima esecuzione del prompt.
Il prompt completo
Questo è il prompt completo e non modificato — puoi copiarlo come modello di partenza per i tuoi filmati prodotto:
One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered translucent glass monolith while maintaining nearly constant subject scale. During the arc, the dense inner architecture separates with precise mechanical elegance into three ultra-thin luminous layers representing image, video, and audio; the layers glide in orderly parallel paths, then converge into one unified API core. The faceted outer glass shell progressively consolidates with controlled physical continuity into the simpler rounded glass portal shown in the closing keyframe. Cyan-teal and warm amber reflections travel subtly across the glass while the black studio and pedestal remain stable. From second ten to twelve, the camera decelerates smoothly into the closing viewpoint. From second twelve to fifteen, hold the final product frame calm and nearly motionless for a brand title overlay. The sequence stays centered, elegant, quiet, photorealistic, and stabilized; the clean frame contains only the glass product and pedestal, with coherent material, shadows, perspective, and lighting throughout.
Analisi sezione per sezione: perché funziona
Questo prompt si legge come una lista di inquadrature con il cronometro, non come una moodboard. È questa la tecnica centrale: ogni istruzione è ancorata a un intervallo di secondi, così il modello non ha alcuna ambiguità su quando deve accadere qualcosa.
Secondi 0–1: prima fermati, poi muoviti
«Hold the exact opening composition for the first second» dà al modello un frame di ancoraggio pulito prima che inizi il movimento. Saltare questo battito è la causa più comune dei tremolii all'inizio dei video AI — la camera e il soggetto si contendono ancora la posizione nel primo frame, invece di partire da un'immagine già stabile.
Secondi 1–10: un solo movimento, descritto una sola volta
L'orbita di 12 gradi è volutamente piccola, ma copre l'arco più lungo della clip. «Maintaining nearly constant subject scale» è la frase che fa davvero la differenza — dice al modello di non avvicinarsi né andare alla deriva durante la rotazione, che è il tipico modo in cui fallisce un'orbita (il soggetto diventa più grande a ogni frame e all'ottavo secondo la composizione è rovinata).
La trasformazione è a strati, non simultanea
Nella stessa finestra di dieci secondi, tre idee visive distinte avvengono in parallelo: i livelli interni (immagine/video/audio) si separano e si ricompongono, mentre il guscio esterno si semplifica nella forma del keyframe finale. Nominare esplicitamente ogni strato — invece di dire solo «il prodotto si trasforma» — è la chiave per evitare che tre cambi visivi scorrelati si fondano in una deformazione disordinata.
Secondi 10–12: rallenta prima di atterrare
Un arresto brusco di una camera in movimento si legge come un errore, non come una scelta. Dare al modello un battito di decelerazione esplicito di due secondi prima della composizione finale fa sembrare la chiusura intenzionale, non troncata.
Secondi 12–15: il frame vuoto è il punto
Gli ultimi tre secondi non richiedono quasi nessun movimento — «hold the final product frame calm and nearly motionless for a brand title overlay». È un'istruzione di produzione, non creativa: riserva uno spazio su schermo pulito e fermo per il testo o il logo che verrà aggiunto dopo. Il video incorporato qui sopra non ha testo del titolo pre-registrato — ed è voluto. La versione con il font del brand viene composta in post-produzione, sovrapposta allo stesso frame fermo, ed è per questo che non bisognerebbe mai chiedere a un modello video di renderizzare direttamente il nome reale del prodotto o lo slogan come testo su schermo durante la generazione.
Ancore di continuità: i dettagli che prevengono la deriva
«Cyan-teal and warm amber reflections», «the black studio and pedestal remain stable» e «coherent material, shadows, perspective, and lighting throughout» non sono ornamenti retorici — servono a prevenire la deriva. In un piano sequenza di 15 secondi, se non ribadisci quali cose devono restare invariate e indichi solo cosa deve cambiare, il modello sarà felicissimo di reinterpretare a metà strada la tonalità della tua luce o il colore del piedistallo.
Riprodurlo: un esempio API
Questo filmato è stato generato su seedance-2.0 in modalità image-to-video, ancorato con il primo frame (composizione iniziale) e l'ultimo frame (keyframe finale) invece che solo con il prompt testuale — ed è proprio questo che permette al modello di consolidare la forma del guscio verso un obiettivo concreto invece di tirare a indovinare. Ecco la chiamata equivalente a /v1/tasks:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered subject while maintaining nearly constant subject scale...",
      "first_frame_url": "https://your-cdn.example.com/opening-frame.jpg",
      "last_frame_url": "https://your-cdn.example.com/closing-frame.jpg",
      "duration": 15,
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
Interroga ripetutamente il task restituito finché non raggiunge lo stato terminale, poi recupera la clip completata da output[0].url. A 1080p, seedance-2.0 costa $0.729 al secondo — una clip di 15 secondi come questa costa in totale $10.94. Se vuoi prima prototipare il ritmo temporale prima di impegnarti in un rendering a prezzo pieno, puoi scendere a 480p ($0.136/s, circa $2.04 per 15 secondi) per controllare il ritmo, poi ri-renderizzare la versione finale a 1080p.
Domande frequenti
Posso scaricare questa esatta clip e usarla come mio video prodotto? No — è materiale interno di HiAPI, mostrato qui per illustrare la tecnica del prompt. Usa le tue foto di prodotto come primo/ultimo frame e adatta la struttura temporale del prompt al tuo soggetto.
Perché spezzare il prompt in battiti secondo per secondo invece di una descrizione fluida? Perché un piano sequenza di 15 secondi deve sostenere più eventi distinti (un fermo, un'orbita, una trasformazione interna, una decelerazione, un fermo finale) senza alcun punto di montaggio che azzeri la comprensione del modello. Dare un timestamp a ogni battito è ciò che mantiene coerenti fisica e composizione attraverso tutti questi eventi, invece di lasciare che il modello scelga un'interpretazione e vada alla deriva.
E se non ho un primo e un ultimo frame già pronti?
seedance-2.0 può anche fare text-to-video solo dal prompt — rimuovi i campi first_frame_url/last_frame_url e mantieni duration, resolution e aspect_ratio. Avrai meno controllo sulle esatte composizioni iniziale e finale, quindi compensa stringendo la descrizione della scena iniziale nel prompt.
Il modello renderizzerà direttamente il testo del mio titolo sul video? Non contarci — i modelli video sono molto meno affidabili dei modelli immagine nel renderizzare una tipografia pulita su schermo. È proprio per questo che questo prompt richiede un frame fermo quasi immobile alla fine, invece di chiedere al modello di disegnare il testo: componi il titolo su quell'immagine pulita in post-produzione.
Provalo tu stesso
Se vuoi l'elenco completo dei parametri — livelli di risoluzione, input di video di riferimento e audio di riferimento, prezzi per risoluzione — la pagina del modello seedance-2.0 ha lo schema live e il dettaglio prezzi aggiornato. Se vuoi lo stesso modello con una tecnica di camera diversa per un POV a piano unico, consulta la nostra analisi del prompt POV a piano unico.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato