
Tutorial
Prompts de video de Seedance 2.0: un cortometraje de lanzamiento de producto de 15 segundos, desglosado segundo a segundo
El prompt completo de un cortometraje de producto continuo de 15 segundos con Seedance 2.0, que abarca un órbita de cámara precisa, separación de capas y un cierre con espacio para superponer títulos.
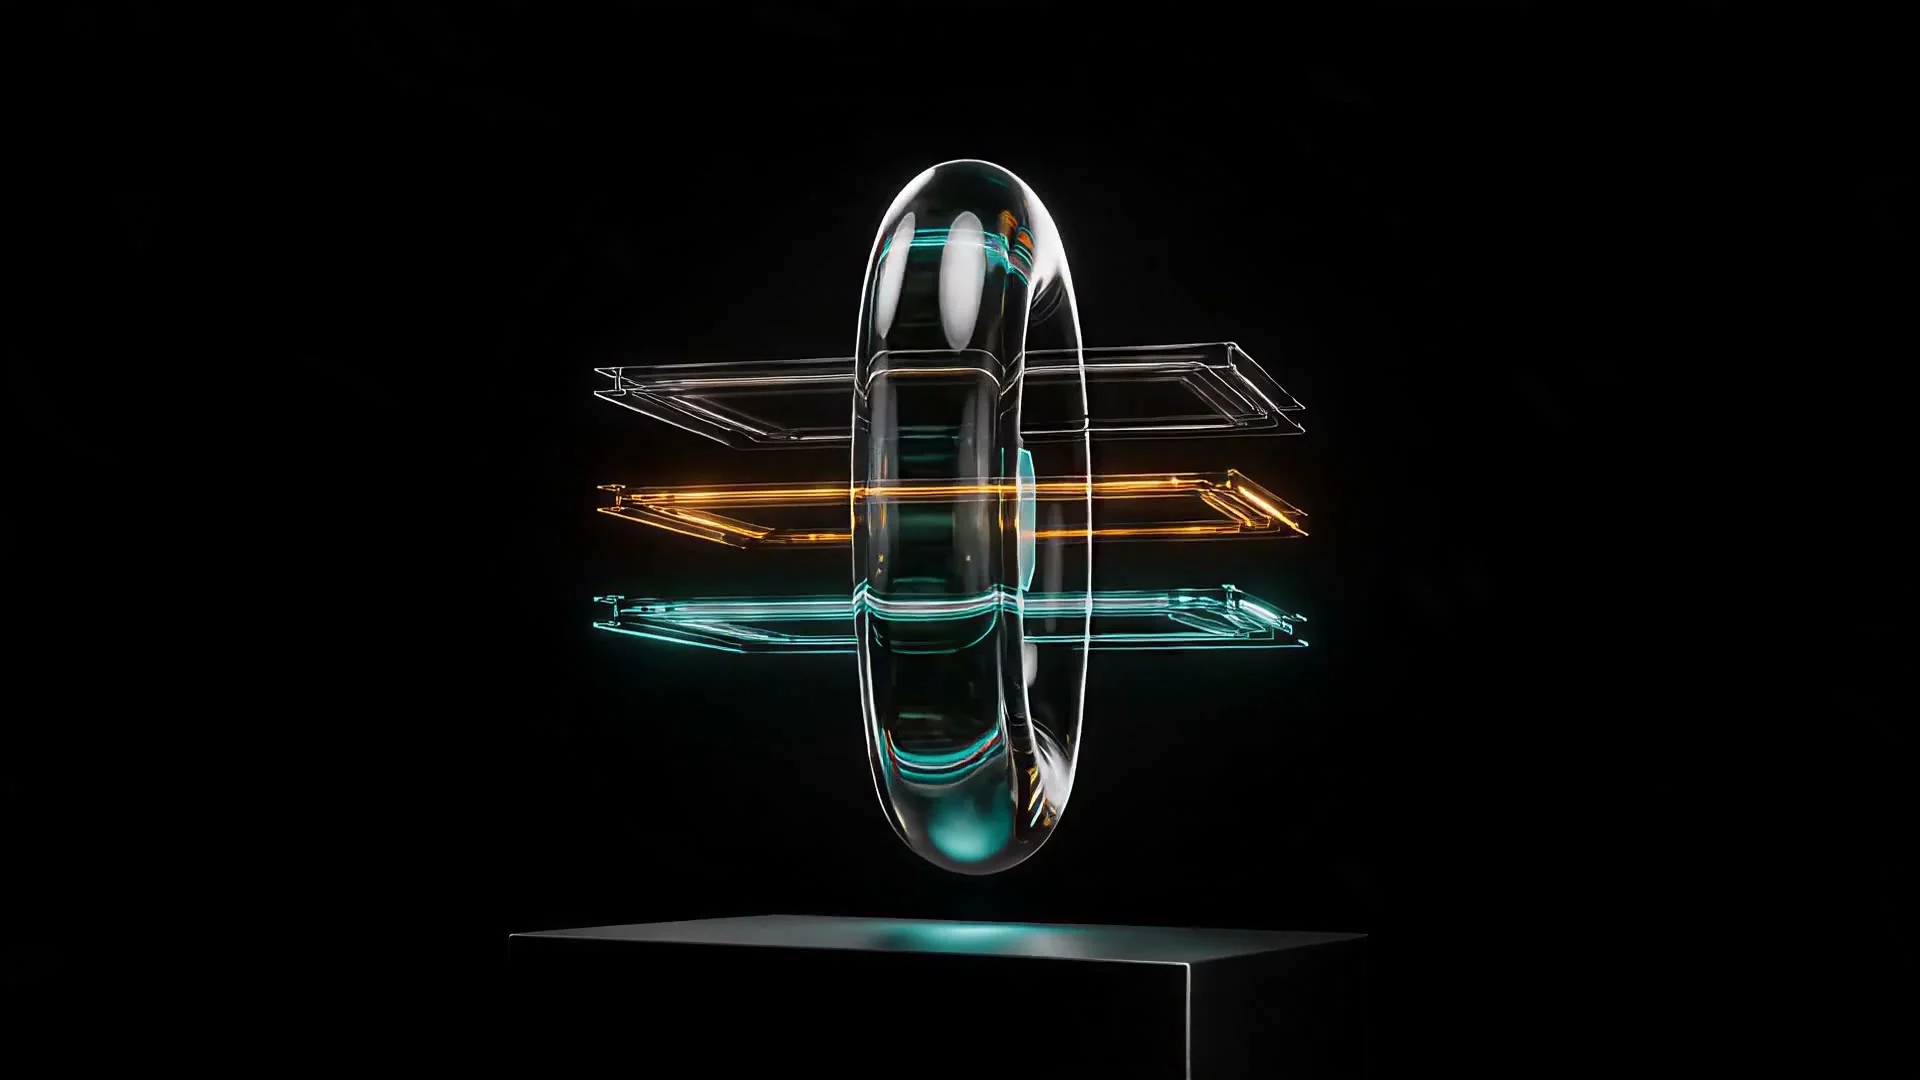
La mayoría de los consejos sobre «prompts de video» se limitan a describir la escena. Eso funciona para un único plano estático, pero se desmorona cuando le pides al modelo un plano continuo de 15 segundos: el sujeto se desplaza, la iluminación cambia a mitad de camino y el final no se parece en nada al principio. El prompt que aparece a continuación es un caso real —extraído del propio banco de recursos de HiAPI, no escrito para este artículo— que mantiene estable el mismo producto de vidrio a lo largo de un lento órbita de cámara, una transición interna en tres capas y un cierre tranquilo y fijo, todo sin un solo punto de corte.
Aquí reutilizamos el render original, no una regeneración, así que lo que ves es lo que produjo el prompt en su primera ejecución.
El prompt completo
Este es el prompt completo y sin editar —cópialo como plantilla de partida para tu propio plano de producto:
One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered translucent glass monolith while maintaining nearly constant subject scale. During the arc, the dense inner architecture separates with precise mechanical elegance into three ultra-thin luminous layers representing image, video, and audio; the layers glide in orderly parallel paths, then converge into one unified API core. The faceted outer glass shell progressively consolidates with controlled physical continuity into the simpler rounded glass portal shown in the closing keyframe. Cyan-teal and warm amber reflections travel subtly across the glass while the black studio and pedestal remain stable. From second ten to twelve, the camera decelerates smoothly into the closing viewpoint. From second twelve to fifteen, hold the final product frame calm and nearly motionless for a brand title overlay. The sequence stays centered, elegant, quiet, photorealistic, and stabilized; the clean frame contains only the glass product and pedestal, with coherent material, shadows, perspective, and lighting throughout.
Desglose por segmentos: por qué funciona
Este prompt se lee como una lista de planos con cronómetro, no como un moodboard. Esa es la técnica central: cada instrucción está anclada a un intervalo de segundos, de modo que el modelo no tiene ninguna ambigüedad sobre cuándo debe ocurrir algo.
Segundos 0–1: primero fija, luego mueve
«Hold the exact opening composition for the first second» le da al modelo un fotograma de anclaje limpio antes de que empiece el movimiento. Saltarse este compás es la causa más común de que los videos de IA parezcan temblar al inicio: la cámara y el sujeto todavía compiten por su posición en el primer fotograma, en lugar de partir de una imagen ya estabilizada.
Segundos 1–10: una sola acción, descrita una sola vez
El órbita de 12 grados es deliberadamente pequeño, pero cubre el tramo más largo del clip. «Maintaining nearly constant subject scale» es la frase que realmente hace el trabajo: le dice al modelo que no se acerque ni derive hacia el sujeto mientras gira, que es el modo de fallo típico de los planos de órbita (el sujeto crece fotograma a fotograma y, para el octavo segundo, la composición ya se ha roto).
La transición es por capas, no simultánea
Dentro de la misma ventana de diez segundos ocurren en paralelo tres ideas visuales independientes: las capas internas (imagen/video/audio) se separan y se vuelven a unir, mientras la carcasa exterior se simplifica hacia la forma del fotograma clave final. Nombrar explícitamente cada capa —en lugar de decir solo «el producto se transforma»— es precisamente lo que evita que tres cambios visuales inconexos se fundan en una deformación caótica.
Segundos 10–12: desacelera antes de aterrizar
Una parada brusca de una cámara en movimiento se lee como un error, no como una decisión. Darle al modelo un compás de desaceleración explícito de dos segundos antes de entrar en la composición final hace que el cierre parezca intencionado en lugar de cortado.
Segundos 12–15: el encuadre vacío es lo importante
Los últimos tres segundos casi no piden movimiento alguno: «hold the final product frame calm and nearly motionless for a brand title overlay». Es una instrucción de producción, no creativa: reserva un espacio de pantalla limpio y estático para el texto o el logotipo que se añadirán después. El video incrustado arriba no tiene texto de título pregrabado —y eso es deliberado. La versión con la tipografía de la marca se compone en posproducción, superpuesta sobre ese mismo fotograma congelado, y por eso nunca deberías pedirle a un modelo de video que renderice directamente tu nombre de producto o eslogan reales como texto en pantalla durante la generación.
Anclajes de continuidad: los detalles que evitan la deriva
«Cyan-teal and warm amber reflections», «the black studio and pedestal remain stable» y «coherent material, shadows, perspective, and lighting throughout» no son adornos retóricos: están ahí para evitar la deriva. En un plano continuo de 15 segundos, si no reiteras qué cosas deben permanecer iguales y solo indicas qué debe cambiar, el modelo reinterpretará encantado el tono de tu iluminación o el color del pedestal a mitad de camino.
Reprodúcelo: un ejemplo de API
Este plano se generó con seedance-2.0 en modo imagen a video, anclado con un primer fotograma (la composición de apertura) y un último fotograma (el fotograma clave de cierre), en lugar de depender solo del prompt de texto —que es justo lo que hace que el modelo consolide la forma de la carcasa hacia un objetivo concreto en vez de adivinar. Esta es la llamada equivalente a /v1/tasks:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered subject while maintaining nearly constant subject scale...",
      "first_frame_url": "https://your-cdn.example.com/opening-frame.jpg",
      "last_frame_url": "https://your-cdn.example.com/closing-frame.jpg",
      "duration": 15,
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
Consulta repetidamente la tarea devuelta hasta que llegue a un estado terminal y luego toma el clip terminado de output[0].url. A 1080p, seedance-2.0 se factura a $0.729 por segundo —un clip de 15 segundos como este cuesta $10.94 en total. Si quieres prototipar el ritmo temporal antes de comprometerte con un render a precio completo, puedes bajar a 480p ($0.136/s, unos $2.04 por 15 segundos) para comprobar el ritmo y luego volver a renderizar la versión final a 1080p.
Preguntas frecuentes
¿Puedo descargar este clip exacto y usarlo como video de mi propio producto? No: es material interno de HiAPI y se muestra aquí para ilustrar la técnica del prompt. Usa tu propia fotografía de producto como primer/último fotograma y adapta la estructura temporal del prompt a tu sujeto.
¿Por qué dividir el prompt en compases por segundo en lugar de una descripción fluida? Porque un plano continuo de 15 segundos debe soportar varios eventos distintos (una fijación, un órbita, una transición interna, una desaceleración y una fijación final) sin un solo punto de corte que reinicie la comprensión del modelo. Poner una marca temporal a cada compás es lo que mantiene la física y la composición coherentes a lo largo de todos esos eventos, en lugar de dejar que el modelo elija una interpretación y derive con ella.
¿Qué pasa si no tengo un primer y un último fotograma listos?
seedance-2.0 también puede hacer texto a video solo con el prompt: elimina los campos first_frame_url/last_frame_url y conserva duration, resolution y aspect_ratio. Tendrás menos control sobre la composición exacta de apertura y cierre, así que compénsalo ajustando más la descripción del encuadre inicial en el prompt.
¿Renderizará el modelo el texto de mi título directamente sobre el video? No cuentes con ello: los modelos de video son mucho menos fiables que los de imagen a la hora de renderizar tipografía limpia en pantalla. Por eso este prompt pide un fotograma congelado casi estático al final, en lugar de pedirle al modelo que dibuje texto: compón el título sobre esa imagen limpia en posproducción.
Pruébalo tú mismo
Si quieres la lista completa de parámetros —niveles de resolución, entradas de video de referencia y audio de referencia, precios por resolución—, la página del modelo seedance-2.0 tiene el esquema en vivo y el desglose de precios actual. Si quieres el mismo modelo con una técnica de cámara distinta para un POV de un solo plano, consulta nuestro desglose del prompt POV de un solo plano.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado