
Tutoriel
Prompts vidéo Seedance 2.0 : un film de lancement produit de 15 secondes, décomposé seconde par seconde
Le prompt complet d'un film produit Seedance 2.0 continu de 15 secondes, couvrant une rotation précise de la caméra, la séparation des calques et une fin avec titre superposable.
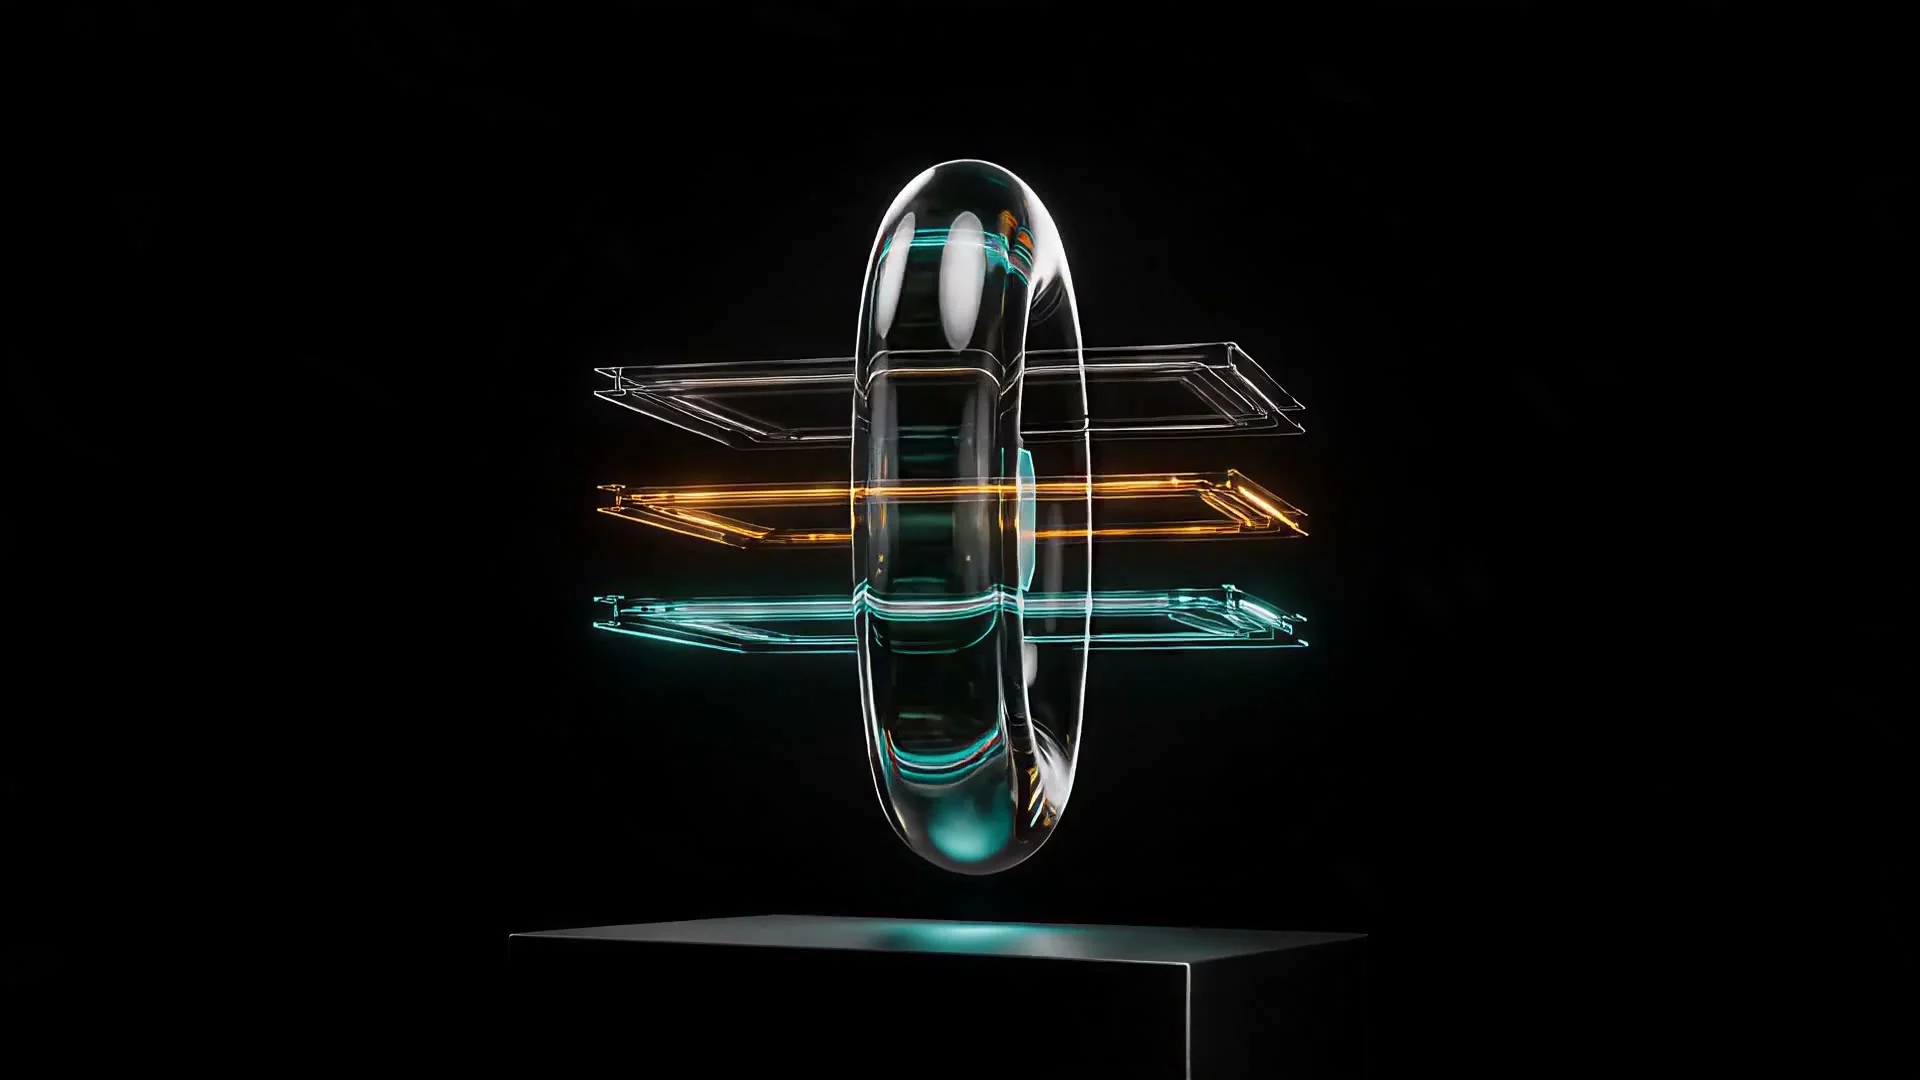
La plupart des conseils sur les « prompts vidéo » se limitent à décrire une scène. Cela fonctionne pour un plan statique unique, mais s'effondre lorsque vous demandez au modèle de tenir un long plan continu de 15 secondes : le sujet dérive, l'éclairage change en cours de route et la fin ne ressemble plus du tout au début. Le prompt ci-dessous est un cas réel — issu de la banque d'assets de HiAPI elle-même, et non écrit pour cet article — qui maintient le même produit en verre stable à travers une lente rotation de caméra, trois couches de transformation interne et un dernier arrêt paisible sur image, sans un seul point de montage.
Nous réutilisons ici le rendu original, et non une régénération, vous voyez donc exactement ce que le prompt a produit lors de sa première exécution.
Le prompt complet
Voici le prompt complet, non édité — copiez-le comme modèle de départ pour vos propres plans produit :
One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered translucent glass monolith while maintaining nearly constant subject scale. During the arc, the dense inner architecture separates with precise mechanical elegance into three ultra-thin luminous layers representing image, video, and audio; the layers glide in orderly parallel paths, then converge into one unified API core. The faceted outer glass shell progressively consolidates with controlled physical continuity into the simpler rounded glass portal shown in the closing keyframe. Cyan-teal and warm amber reflections travel subtly across the glass while the black studio and pedestal remain stable. From second ten to twelve, the camera decelerates smoothly into the closing viewpoint. From second twelve to fifteen, hold the final product frame calm and nearly motionless for a brand title overlay. The sequence stays centered, elegant, quiet, photorealistic, and stabilized; the clean frame contains only the glass product and pedestal, with coherent material, shadows, perspective, and lighting throughout.
Décomposition segment par segment : pourquoi cela fonctionne
Ce prompt se lit comme une liste de plans minutée au chronomètre, et non comme une planche d'ambiance. C'est là le cœur de l'astuce : chaque instruction est ancrée sur un intervalle de secondes, de sorte que le modèle n'a aucune ambiguïté sur le moment où chaque chose doit se produire.
Secondes 0–1 : d'abord figer, ensuite bouger
« Hold the exact opening composition for the first second » donne au modèle une image d'ancrage propre avant que le mouvement ne commence. Sauter ce temps d'arrêt est la cause la plus fréquente des débuts tremblotants en vidéo IA — la caméra et le sujet se disputent encore leur position sur la première image au lieu de partir d'un cadre déjà stabilisé.
Secondes 1–10 : un seul mouvement, décrit une seule fois
L'arc de 12 degrés est volontairement réduit, mais il couvre la plus longue portion du clip. « Maintaining nearly constant subject scale » est la phrase qui fait réellement le travail — elle indique au modèle de ne pas se rapprocher ni dériver pendant la rotation, ce qui est le mode d'échec typique des plans en orbiting (le sujet grossit image après image et la composition s'effondre à la huitième seconde).
La transformation s'opère par couches, non simultanément
Dans cette même fenêtre de dix secondes, trois idées visuelles distinctes se déroulent en parallèle : les calques internes (image/vidéo/audio) se séparent puis reconvergent, tandis que la coque extérieure se simplifie vers la forme de l'image clé finale. Nommer explicitement chaque couche — au lieu de dire simplement « le produit se transforme » — est précisément ce qui évite que trois changements visuels sans rapport ne se fondent en une bouillie de morphing chaotique.
Secondes 10–12 : ralentir avant d'atterrir
Un arrêt brusque d'une caméra en mouvement se lit comme une erreur, pas comme un choix. Donner au modèle un temps de décélération explicite de deux secondes avant d'entrer dans la composition finale est ce qui fait paraître la fin intentionnelle plutôt que tronquée.
Secondes 12–15 : l'image vide est tout l'intérêt
Les trois dernières secondes n'exigent presque aucun mouvement — « hold the final product frame calm and nearly motionless for a brand title overlay ». C'est une instruction de production, pas une instruction créative : elle réserve un espace-écran propre et immobile pour un texte ou un logo ajouté par la suite. La vidéo intégrée ci-dessus n'a pas de titre incrusté préalablement — c'est délibéré. La version avec la typographie de la marque est composée en post-production, superposée à cette même image fixe, et c'est pourquoi il ne faut jamais demander à un modèle vidéo de rendre directement le vrai nom de votre produit ou votre slogan en texte à l'écran pendant la génération.
Les ancres de continuité : les détails qui empêchent la dérive
« Cyan-teal and warm amber reflections », « the black studio and pedestal remain stable » et « coherent material, shadows, perspective, and lighting throughout » ne sont pas des fioritures décoratives — elles servent à empêcher la dérive. Sur un plan continu de 15 secondes, si vous ne réaffirmez pas ce qui doit rester inchangé et ne précisez que ce qui doit changer, le modèle réinterprétera volontiers en cours de route la teinte de votre éclairage ou la couleur du socle.
Le reproduire : un exemple d'API
Ce plan a été généré sur seedance-2.0 en image-vers-vidéo, ancré par une première image (composition d'ouverture) et une dernière image (image clé finale) plutôt que par le seul prompt textuel — c'est précisément ce qui pousse le modèle à faire converger la forme de la coque vers une cible concrète au lieu de deviner. Voici l'appel équivalent vers /v1/tasks :
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "One continuous fifteen-second premium technology product film. Hold the exact opening composition for the first second. From second one through second ten, the camera performs a very slow, restrained 12-degree arc to the right around the centered subject while maintaining nearly constant subject scale...",
      "first_frame_url": "https://your-cdn.example.com/opening-frame.jpg",
      "last_frame_url": "https://your-cdn.example.com/closing-frame.jpg",
      "duration": 15,
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
Interrogez la tâche renvoyée jusqu'à ce qu'elle atteigne un état terminal, puis récupérez le clip terminé dans output[0].url. En 1080p, seedance-2.0 est facturé 0,729 $ par seconde — un clip de 15 secondes comme celui-ci revient à 10,94 $ au total. Si vous voulez prototyper le rythme temporel avant d'engager le coût d'un rendu complet, vous pouvez passer en 480p (0,136 $/s, environ 2,04 $ pour 15 s) pour vérifier le rythme, puis refaire le rendu final en 1080p.
Questions fréquentes
Puis-je télécharger exactement ce clip pour l'utiliser comme ma propre vidéo produit ? Non — c'est un asset interne de HiAPI, montré ici pour illustrer une technique de prompt. Utilisez vos propres photos produit comme première/dernière image et adaptez la structure temporelle du prompt à votre sujet.
Pourquoi découper le prompt en temps seconde par seconde plutôt qu'en une description fluide ? Parce qu'un plan continu de 15 secondes doit supporter plusieurs événements distincts (un arrêt, une rotation, une transformation interne, une décélération, un arrêt final), sans aucun point de montage pour réinitialiser la compréhension du modèle. Horodater chaque temps est ce qui permet à la physique et à la composition de rester cohérentes à travers tous ces événements, au lieu de laisser le modèle choisir une interprétation et dériver sans fin.
Et si je n'ai pas de première et de dernière image prêtes ?
seedance-2.0 peut aussi faire du texte-vers-vidéo à partir du seul prompt — retirez les champs first_frame_url/last_frame_url et conservez duration, resolution et aspect_ratio. Vous aurez moins de contrôle sur la composition exacte d'ouverture et de fin, alors resserrez la description de l'image d'ouverture dans le prompt pour compenser.
Le modèle va-t-il rendre mon titre directement sur la vidéo ? Ne comptez pas dessus — les modèles vidéo sont bien moins fiables que les modèles d'image pour rendre une typographie propre à l'écran. C'est précisément pourquoi ce prompt demande une image fixe presque immobile à la fin plutôt que de demander au modèle de dessiner du texte : composez le titre en post-production sur cette image propre.
Essayez par vous-même
Si vous voulez la liste complète des paramètres — paliers de résolution, entrées vidéo de référence et audio de référence, tarification par résolution — la page du modèle seedance-2.0 contient le schéma en temps réel et le détail tarifaire actuel. Si vous souhaitez appliquer le même modèle à une autre technique de caméra pour un POV en un seul plan, consultez notre décomposition du prompt POV en un seul plan.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat