
使用指南
GLM 5.3 结构化提取实战:让每个 JSON 字段都有原文依据
用 JSON 对象模式做字段抽取,靠缺失值、引用与业务校验把错误挡在入库之前

本页内容
为什么结构化输出还需要"原文依据"
JSON 对象模式(response_format: {"type": "json_object"})解决的是「输出形式是不是 JSON 对象」的问题,而不是「这次请求一定成功、内容一定完整、解析一定不抛异常」。请求可能失败,模型可能拒答,输出可能因长度限制被截断,流式传输可能中断,返回内容也可能不完整或畸形;客户端必须处理这些情况以及 json.loads 的解析异常。必须先确认响应正常完成、内容完整,再进入解析。能解析也不等于能用:格式正确不代表事实正确。字段值是不是从原文里抽出来的、有没有被模型顺手补全、某个字段到底是「原文没写」还是「原文写了空」,这些都不在格式约束的覆盖范围内。
把一份字段模板写进提示词,本质上是给模型一份「填表模板」,而不是一份「证据清单」。当字段缺少原文支撑时,模型倾向于给出一个看起来合理的值——这在抽取任务里是最危险的失败模式,因为它不会报错,只会安静地污染下游数据。
所以本文的抽取契约由三部分组成:字段与类型定义、每个值配套的原文引用、以及显式的缺失值建模。三者合起来,让「这句话是从哪来的」成为输出的一部分,而不是事后猜测。
设计抽取契约:字段、类型与可空约定
契约先从字段清单开始。假设任务是从一段招聘/合作描述里抽取结构化信息,先把目标字段写死:
title:字符串,必填budget:数字,可空deadline:字符串(ISO 日期),可空contact:字符串,可空skills:字符串数组,可为空数组
关键在「可空」不等于「可以不写」。约定每个字段都必须出现在输出里,未知时显式给 null 或空数组,不允许省略键。省略键会让下游无法区分「模型判断为空」和「模型压根没处理这个字段」。
类型上还要收紧到能被机器判定的粒度:budget 只接受数字,不接受 "面议" 这类字符串;deadline 约定 YYYY-MM-DD 格式;skills 必须是字符串数组,不允许用逗号拼接的单个字符串糊过去。类型越具体,后文的校验层就越能拦住问题。
下面这段是写进提示词的字段说明,不是请求参数;请求参数只负责开启 JSON 对象模式。
请输出 JSON 对象,包含且仅包含以下键:
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
所有键必须出现。无法从原文确定时填 null(数组填空数组),不要猜测。
让每个字段带上引用片段
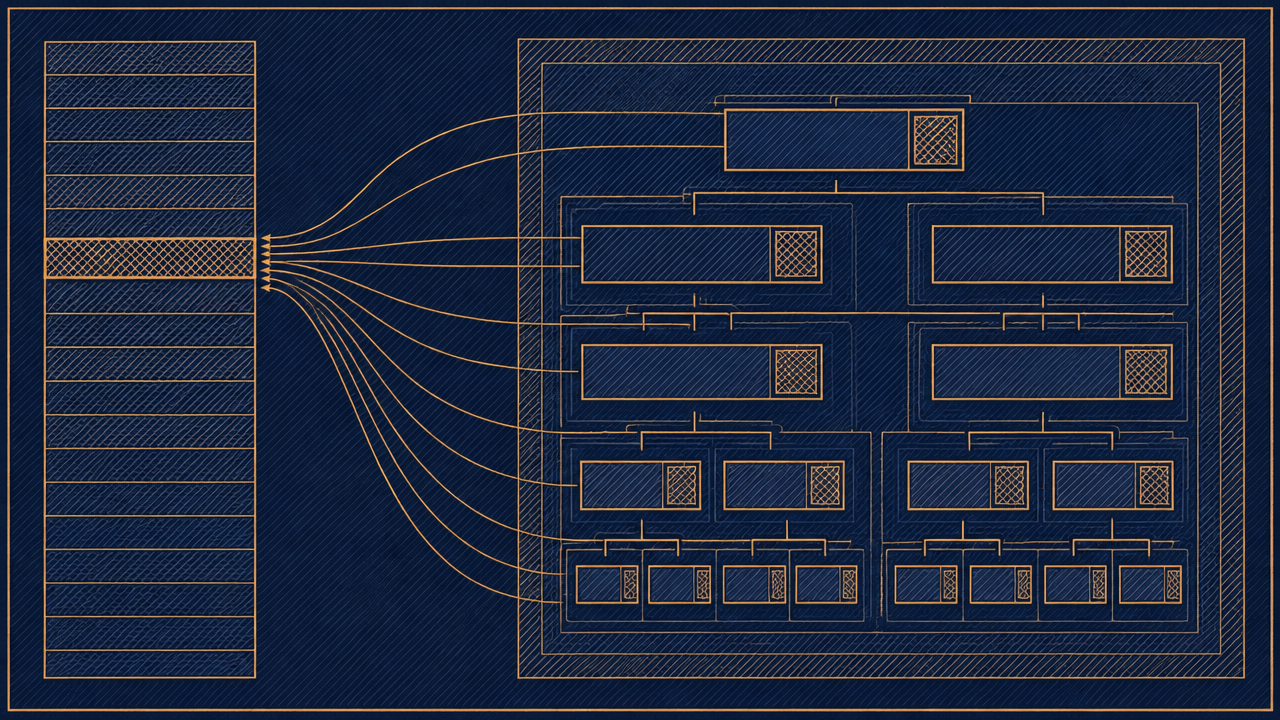
只给值不给来源,等于放弃了追溯能力。做法是把每个可抽取字段改造成成对结构:值与引用同出。
{
  "title": {"value": "数据分析实习生", "evidence": "招聘数据分析实习生 2 名"},
  "budget": {"value": 300, "evidence": "日薪 300 元"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "简历投递至 hr@example.com"},
  "skills": [
    {"value": "SQL", "evidence": "要求熟悉 SQL"},
    {"value": "Python", "evidence": "掌握 Python 优先"}
  ]
}
几个要点。第一,evidence 要求是原文的连续片段,不是模型的转述或总结——转述会让引用失去比对价值。第二,值为 null 时 evidence 也必须是 null,这条约束本身就能压住一部分臆造:模型如果编了值,通常编不出对应原文片段,格式上就自相矛盾。第三,数组字段按元素给引用,而不是给整段数组一个引用,否则一个错误元素会污染整组的可信度。第四,引用片段要尽量短,只覆盖支撑该值的最小文本,方便后续做字符串包含比对。
这样输出的体积会变大,但换来的是:任何一条入库记录都能回答「这个字段依据原文哪句话」。
显式处理缺失值与不确定
抽取任务里模型最容易犯的错不是抽错,而是「补全」。要在契约层面把三种情形分开建模。
缺失。 原文完全没有相关信息,字段填 null。这个语义必须和「值为空字符串」区分开:空字符串是一个被抽到的值,null 是抽不到。上游约定清楚,下游才能决定是跳过还是告警。
模糊。 原文有相关表述但不足以确定。例如只写「薪资面议」,此时 budget 应为 null,同时在提示词中明确:不要把定性描述转成数字,也不要把「面议」映射成 0。
多候选。 原文出现两个联系方式或两个日期,而契约只接受单值。此时可选的做法是让字段结构支持候选列表,或在提示词中规定优先级(如取首个出现的)。无论选哪种,都必须写进契约,否则模型每次的取舍策略都可能不同,结果难以稳定复现。
再加一条兜底:允许模型输出一个 unresolved 数组,列出它无法归入任何字段的关键信息。这比强行塞进某个字段安全得多,也给你留了观察模型失败模式的入口。
入库前的三层业务校验
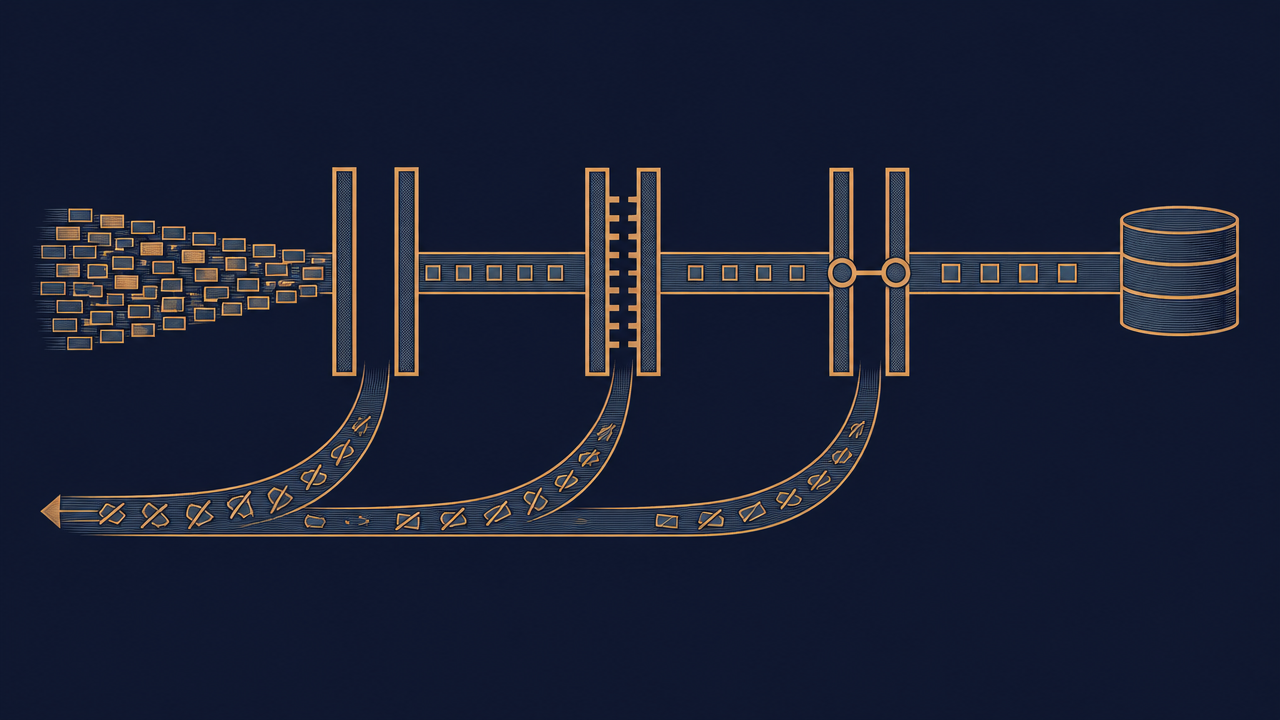
JSON 对象模式只约束输出形式,解析仍可能失败。校验按顺序执行:先确认响应完整性,再做客户端结构与业务校验,最后做证据核对;前一层不过就不进下一层。
解析前先检查:请求是否成功返回、是否出现拒答、结束原因是否显示因长度被截断、流式响应是否正常结束、内容是否为空。确认响应正常完成且内容完整后,再执行 json.loads;解析异常直接进入失败处理,不把半截内容送进后续校验。解析成功后,才进入下面的三层校验。
第一层:类型与结构
键是否齐全、类型是否匹配、deadline 是否满足日期格式、budget 是否为有限数字。这一层用普通代码即可,成本低,拦截率最高。
第二层:枚举与取值域
把业务上不可能的值挡掉:金额为负、日期早于今天、skills 里出现空字符串或重复项、字符串长度超出字段上限。如果字段本身有受控词表(如行业、职级),在这里做白名单匹配,并预留同义词归一化的位置。
第三层:跨字段一致性
单字段合法不代表整条记录成立。典型检查包括:budget 非空时 deadline 是否也非空(很多业务场景两者绑定)、contact 是否与 skills 所暗示的岗位类型矛盾、同一批次内同一 title 的记录字段分布是否异常集中。这一层最接近业务语义,也最需要你写测试。
别忘了对 evidence 做机械校验:值非空时,evidence 必须非空,且应能在输入原文中通过字符串包含或模糊匹配命中。命中失败不一定要直接丢弃,但至少要打上低置信标记进入人工队列。
把校验失败变成下一轮提示词
校验失败后最差的做法是原样重发请求,指望这次抽对。更好的是把失败原因结构化地回灌:
上一次输出未通过校验:
- deadline 的值 "尽快" 不符合 YYYY-MM-DD 格式
- skills[2] 的 evidence 未能在原文中找到
请仅修正上述问题,其余字段保持不变,重新输出完整 JSON。
三个细节值得注意。一是错误信息要指向具体字段路径,让模型能做局部修正,而不是整份重来。二是明确要求「其余字段保持不变」,否则容易引入新错误,出现修一个坏一个的震荡。三是设定重试上限(例如两轮),超过上限就落人工队列,而不是无限循环——无限重试既拖长延迟,也会把成本推高。
如果同一类错误在重试中反复出现,那通常不是模型的问题,而是契约写得含糊。此时应该回头看字段定义与示例,而不是继续加提示词。
调用方式与本篇边界
在 HiAPI 上,glm-5.3 通过 OpenAI Chat Completions 兼容协议调用,开启 JSON 对象模式的方式是在请求里设置 response_format 为对象类型,具体参数与字段名以模型页面的接口说明为准。能力标记 jsonObject=true 表示模型支持 JSON 对象模式,不代表接口支持 JSON Schema 响应模式,也不意味着可以依赖服务端按 Schema 校验;本文的字段结构、类型和业务约束都在客户端解析后本地校验。抽取逻辑、引用字段与校验层都写在你自己的服务端,模型只负责按契约产出文本。
本文只讨论契约设计与校验流程,不涉及计费数字与性能承诺;实时价格与配额请以站点价格面板为准。字段定义、引用校验、重试策略这三件事做完,才算把「格式合法」推进到「语义可用」;格式正确不等于事实正确,固定 seed 也不保证完全复现,重试策略仍需配合上限与人工队列。


