
使用指南
Kimi K3 响应处理实战:完整 JSON、流式中断与重试边界

本页内容
先分清两条响应路径
同一个 Kimi K3 接口,你拿到的可能是两种完全不同的东西:一次完整的 JSON 响应,或者一串按顺序到达的流式数据块。前者是「一问一答」的文档投递,后者是「边生成边推送」的增量序列。很多响应处理 bug 的根源不是解析写错了,而是一开始就没搞清楚自己站在哪条路上。
两条路径共享同一套请求协议(openai_chat_completions,契约版本 2),差异集中在消费方式:
- 非流式:请求返回后,你拿到一个完整的响应体,正文、推理内容、用量都在里面,一次读完即可。
- 流式:响应以可选模式开启,服务端持续推送 chunk,最终以 SSE 的
[DONE]标记结束流。中途你可能拿到几十上百个块,也可能在中途断掉;[DONE]只表示流结束,不代表内容完整。
先确认这件事,后面所有讨论才有意义。如果你的业务链路里同时存在两种调用(比如后台批处理和前端对话共用一个封装),建议在客户端显式标注路径,而不是靠「有没有回调」这种隐式判断来区分——那会在重构时埋下反序列化失败的地雷。
一个简单的判断规则:需要给用户逐字展示、或输出可能很长时用流式;需要一次性拿到结构化结果、后续要落库或二次加工时用非流式。两条路径的解析代码应当分开写,共用的只有请求构造和错误映射部分。
解析完整 JSON:正文、推理内容与结构化字段
非流式响应遵循 OpenAI Chat Completions 的响应体格式,但有一个容易被忽略的点:正文和推理内容是两个不同的字段。
正文在标准的消息内容位置,而 Kimi K3 的推理过程通过 reasoning_content 字段交付。这意味着你的解析层至少要做三件事:
- 从消息内容取面向用户的最终答案;
- 判断
reasoning_content是否存在,存在时决定是记录日志、展示给用户,还是直接丢弃; - 单独保存
usage,用于计费与配额核算。
把 reasoning_content 当正文展示是常见事故:它面向的是调试与可解释性场景,直接进入产品文案或客服回复,语气和内容都不合适。正确做法是给它一条独立的消费路径,比如落到调试日志或「查看推理过程」这类可选入口。
结构化输出怎么用
该契约支持 response_format 参数与 jsonObject 结构化输出能力。你可以要求模型返回 JSON 对象,从而省掉一层脆弱的正则提取。但有两个前提需要说清楚:jsonObject 能力不等于支持 JSON Schema 模式;结构化输出也不是「一定成功」的保证。
只在响应正常完成且内容完整后,才尝试解析 JSON。解析之后仍要处理三类失败:
- 解析失败:返回内容不是合法 JSON,或字段缺失、类型不符。此时不应把原始字符串直接抛给上游业务,而应进入降级分支。
- Schema 校验失败:JSON 语法合法,但不符合你声明的结构。
jsonObject不保证 JSON Schema 级别的约束,业务侧仍需自行校验字段、类型与必填项。 - 截断:输出长度触达该型号的输出 token 上限(131072)时,
finish_reason可能为length,JSON 可能在中途结束。不能把length当作 JSON 完整成功。一个残缺的 JSON 解析器会报错,而更危险的情况是它「勉强解析成功」了,你却拿着半个对象继续跑业务逻辑。
建议在解析后加一道业务字段完整性与证据校验,而不是只依赖 JSON 语法合法性。上下文窗口为 1000000,长文档场景下输入不是瓶颈,但输出截断依然是真实存在的边界。
流式读取:[DONE]、finish_reason 与用量
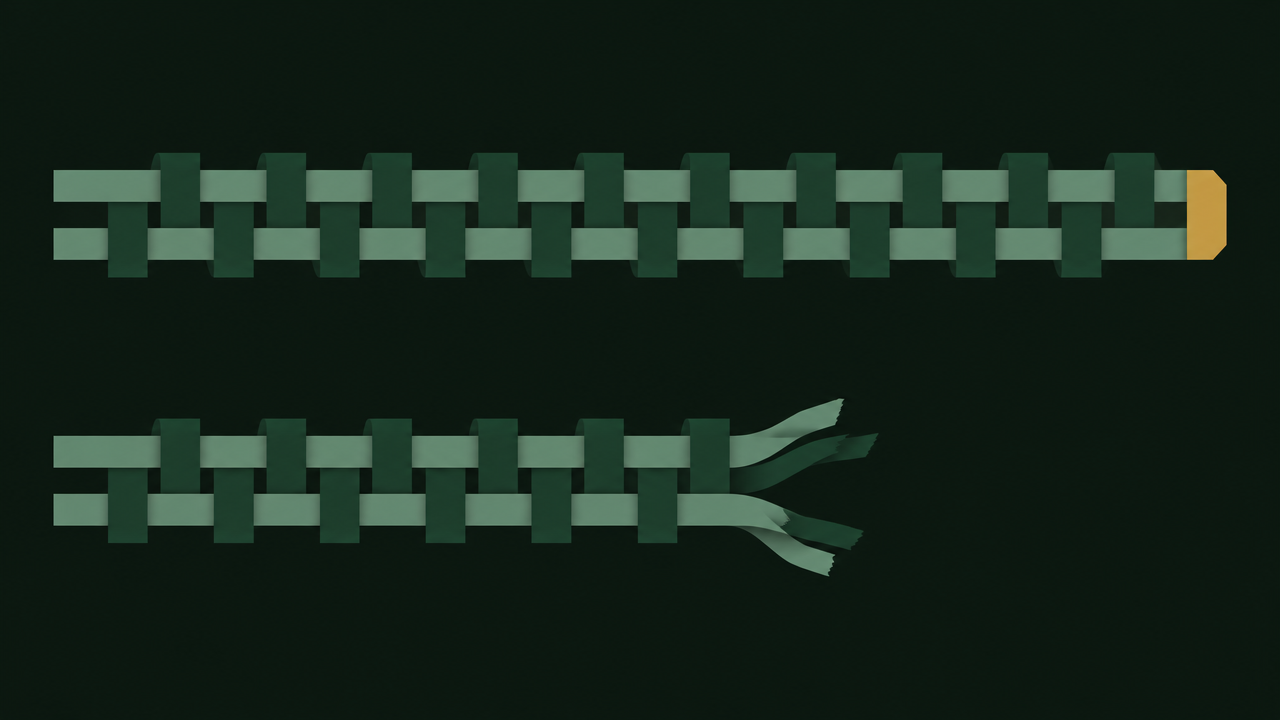
流式模式下,服务端按顺序推送 chunk,SSE 的网络终止标记是 [DONE]。这句话听起来平淡,但它常被误读:[DONE] 只表示这条流结束了,不表示生成成功,也不表示内容完整。
判断终态要看每个 chunk 里的 choices[].finish_reason。当前前端以 finish_reason 非空识别终态;即使收到了 [DONE],缺少 finish_reason 仍应视为中断。流内的 error 帧则表示这次请求失败。
流可能在几种状态下结束:
- 正常完成:
finish_reason为成功终态,随后收到[DONE],累积内容可视为完整结果; - 长度截断:
finish_reason=length,输出因长度上限被截断,内容可能不完整,不能作为 JSON 完整成功; - 其他非成功原因:如内容过滤等,需要分别处理,不能当作正常完成;
- 中途断开:连接关闭、超时,或收到流内
error帧,此时只有部分内容,应标记为失败或未完成。
最后一种情况最容易被写成「拿到什么算什么」。对聊天展示来说这或许可以接受(用户看到半句话,可以重新发送),但对落库、计费、触发下游动作来说就是错的数据。请把「是否收到成功终态 finish_reason」作为完整性的判据,而不是只看 [DONE]。
用量在流结束后汇总
流式模式下,usage 可能出现在 finish_reason 之后的 choices:[] 帧里。客户端应读完整个流后再汇总用量;不可保证 [DONE] 本身携带 usage。
这带来两个直接的编码约束:
- 不要在第一个 chunk 就做计费或配额结算。 那时你既不知道最终输出有多长,也拿不到用量字段。
- 不要在中途块累加用量,也不要把
[DONE]当作用量载体。 中途块里没有可靠的用量数据,任何「估算」都会和最终值偏差。
正确的顺序是:流式过程中只负责累积文本与状态,读完流后,从 choices:[] 帧汇总用量完成一次结算。如果流在中途断开且你已经给用户展示内容,那么这次调用的用量状态是未知的——你需要一个「未完成」的状态位,而不是默认按 0 或按估算值记账。
另外要区分内部元数据与网络字段:response.stream.terminal=done、response.usage.delivery=final_chunk 这类是平台内部元数据标签,不是 SSE 的网络字段,也不是客户端应匹配的终止串。客户端只应依赖 [DONE]、finish_reason、error 帧和 usage 字段本身。
另一个实践细节:累积文本时用列表追加再 join,而不是字符串反复拼接,长输出下性能差异明显。
为什么 POST 重试不是免费幂等
很多重试逻辑是这样写的:请求抛了超时异常,捕获它,等一会儿,重发。本文只讨论对话补全这类 POST 生成操作的语义:这种重试可能造成重复计费和重复副作用,不能把它当作免费幂等。
原因很朴素:超时是客户端的判断,不是服务端的承诺。当你这边计时器响的时候,请求可能已经完整到达服务端、已经开始推理、甚至已经完成并计费,只是响应在回来的路上丢了。客户端无法仅凭异常类型区分这两种局面:
- 请求没到达服务端,重试不会产生第二次执行;
- 请求已被受理并产生效果,重试就是第二次调用。
对话补全的「效果」通常包括 token 消耗与计费,以及你在业务侧基于响应触发的动作(写库、发表单、发消息)。重放一次不确定结果的 POST,等于把这些副作用做两遍。这不是理论风险:网络抖动、网关超时、连接被中间设备重置,都会稳定地制造这类模糊状态。
更麻烦的是,完整 5xx 响应、超时、断连或 JSON 解析失败,都不能证明请求未生成、未扣费或没有副作用。你看到的错误只说明客户端这次没拿到可用结果。
所以,重试的正确前提不是「出错了」,而是「这次请求确定没有执行」。在写任何重试代码之前,先回答这个问题,答不上来就别自动重放。
划定重试边界:哪些情况可以重放
把重试做成一张分级表,比写一个统一的 for retry in range(3) 更靠谱。以下是按错误类型划分的处理策略。
明确未执行,可以重试
- 连接建立失败(DNS 失败、连接被拒绝):请求显然没有到达服务端,属于明确未发送,重试不会产生第二次执行。
- 限流响应(如 429):只有接口文档或响应语义明确保证在执行前拒绝时,才按该语义退避重试;单凭 429 或其他状态码不应推断未执行或未计费。退避要带随机抖动,避免多个客户端同步重试。
- 接口明确提供且服务端实际使用的去重机制:只有在接口文档明确说明、且服务端实际据此去重时,才可按其语义重试。客户端自行生成的请求标识仅用于追踪,不能假设某个请求头或字段具备幂等效果。
结果未知,需要显式处理
- 超时:这是最危险的类别。超时不能证明请求未执行,重发可能产生新的付费生成。客户端自行生成的请求标识只能用于追踪;只有服务端明确支持并实际使用去重机制时,才可能防止重复推理与重复收费。业务侧去重至多防止重复下游动作,不能阻止模型再次生成并收费。若无法确认服务端去重语义,就不要自动重放,转为向用户报错或进入人工/异步补偿流程。
- 完整 5xx 响应:即使响应体完整可读,也不能证明未生成、未扣费或无副作用。只有在明确未执行,或接口文档明确说明服务端会按去重标识实际去重时才能重试;否则按结果未知处理。
- 响应解析失败:包括 JSON 解析失败与 Schema 校验失败。请求可能已成功并已计费,解析失败不能证明未生成。重试可能造成重复扣费与重复副作用,建议显式标记为未知结果并记录,便于事后核对用量。
- 流式中途断连或收到流内
error帧:之前已推送的内容不能与新结果拼接;重放会被视为一次全新的生成。
不要自动重试
- 请求参数错误(4xx 中的参数类错误):重试多少次结果都一样,只会放大错误。
- 内容审核类拒绝:重放不会改变结论。
- 任何你无法确定「是否已生效」且没有服务端去重语义的情况。
把边界写进代码
两条工程约束值得固化下来:重试次数设上限(通常 1 到 2 次足够),且只对明确未发送,或接口文档明确保证在执行前拒绝的情形生效;每次重试都记录请求标识、错误类型与耗时,因为「重试了几次」直接决定你的用量账单和排障路径。流式请求的重试还要额外注意:连接在中途断开后重放,会产生一次全新的付费生成,之前已推送的内容不能与新结果拼接。
如果你还在选型阶段,可以先看看 Kimi K3 的模型页 了解契约细节,再决定重试策略的粒度。
落地检查清单
把前面的规则收敛成一份评审时可逐条对照的清单:
- 客户端是否显式区分流式与非流式两条消费路径,而不是靠隐式判断?
- 非流式解析是否把正文与
reasoning_content分开处理,且reasoning_content不会直接进入用户可见文案? usage是否被单独保存,并与业务记录可关联?- 结构化输出是否只在响应正常完成且内容完整后解析,并对解析失败、Schema 校验失败、业务与证据校验失败以及
finish_reason=length有独立兜底? - 流式读取是否以
finish_reason非空识别终态,而不是只等[DONE]? - 是否把
[DONE]仅当作流结束标记,缺少finish_reason时标记为中断? - 用量是否在读完流后从
choices:[]帧汇总,且不假定[DONE]携带 usage? - 流内
error帧是否被识别为失败,而不是当作正常结束? - 重试是否按错误类型分级,只对明确未发送,或接口文档明确保证在执行前拒绝的情形生效?
- 超时、断连、完整 5xx 或 JSON 解析失败是否被当作「结果未知」显式处理,而不是承诺重试安全?
- 重试次数是否有上限,且每次重试都有日志可用于核对用量?
- 流式中断后的重放是否被视为一次新生成,而非续写?
这份清单不需要一次全部满足,但每一条都对应一个会真实发生的线上问题。先处理 finish_reason 终态判据与重试边界这两条,收益最直接。


