
Guía de uso
Hailuo 2.3 texto a video: flujo de trabajo de video corto basado en la API de hiapi
Prompts reales, costos reales y cómo sortear la limitación de salida solo en horizontal para adaptarse a TikTok y Reels
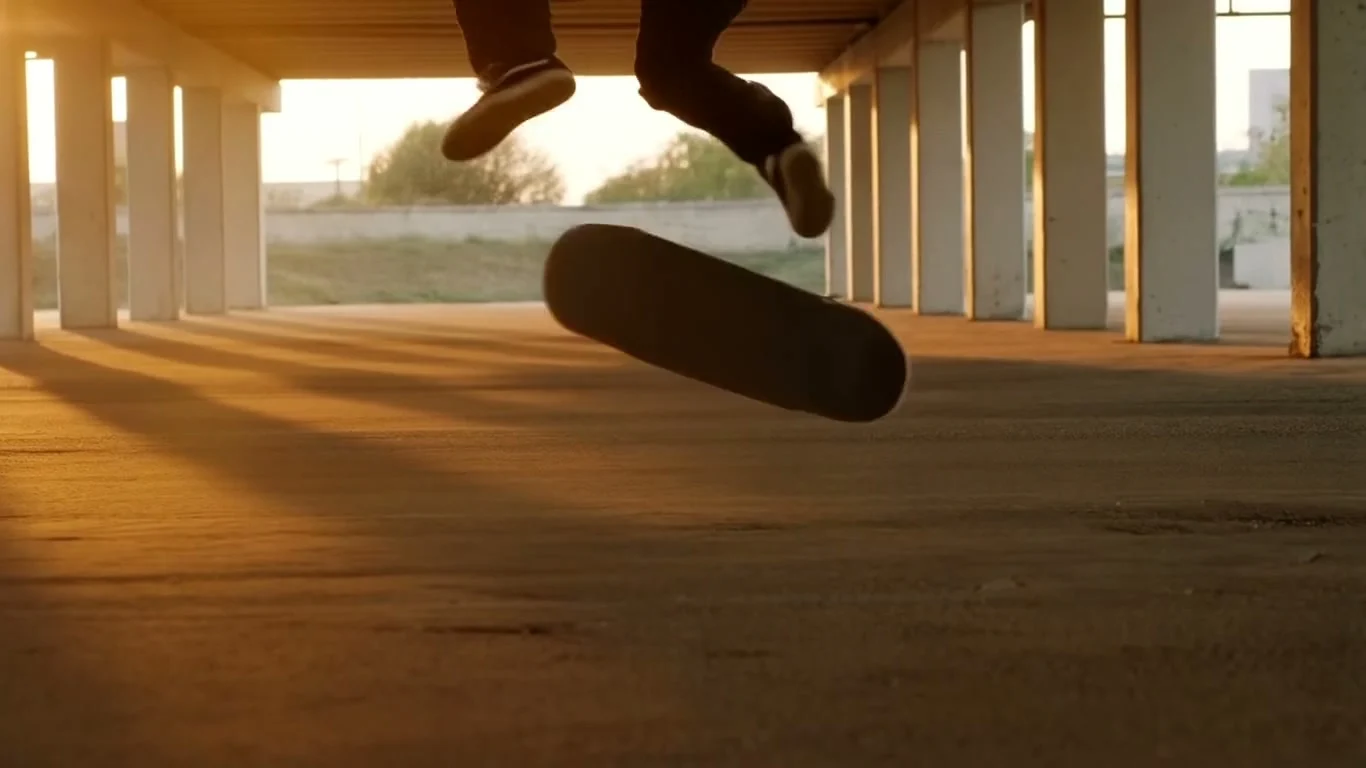
El video corto necesita movimiento que resulte creíble en un segundo de imagen: una patineta girando, una tela ondeando, un paneo rápido. hailuo-2.3/text-to-video está hecho precisamente para eso: envía un prompt de texto al endpoint /v1/tasks de hiapi y obtendrás un clip de 6 o 10 segundos con una sensación realista de movimiento físico, sin necesidad de imagen de referencia. Este artículo recorre de principio a fin un flujo de trabajo real con la API, muestra un clip generado de verdad, explica una limitación de salida que conviene conocer antes de construir un pipeline sobre este modelo y cita directamente los precios en vivo de /api/pricing de hiapi.
Dónde destaca realmente hailuo-2.3/text-to-video
Los modelos de texto a video tienden a romperse con movimientos físicos rápidos: la patineta se dobla, las extremidades se deforman a mitad del giro. hailuo-2.3/text-to-video lleva la etiqueta "Motion Physics" en hiapi, y ese es su verdadero punto fuerte: se mantiene estable con el tipo de acciones que conforman la mayor parte del contenido de video corto: un truco, una revelación, un movimiento rápido de cámara. No supera a los modelos centrados en escenas estáticas en detalles finos, pero para un clip de 6 a 10 segundos que se verá una sola vez en el móvil, el movimiento físicamente creíble importa más que la textura a nivel de píxel.
El prompt y lo que generó realmente
Este es el prompt completo usado para el siguiente video: puedes copiarlo como punto de partida para tus propias tomas de acción:
a skateboarder in an empty downtown parking garage at golden hour attempts a kickflip, the board spinning crisply mid-air with realistic physical rotation, sneaker landing solidly back on the deck as wheels grip the concrete, sunlight flaring low through support pillars, dynamic low-angle tracking shot following the motion, natural motion blur on fast movement, warm saturated color grade, handheld documentary energy
Fíjate en las partes del prompt que realmente hacen la diferencia: un movimiento de cámara con nombre ("dynamic low-angle tracking shot"), una descripción explícita del movimiento ("crisply mid-air with realistic physical rotation") y un momento de aterrizaje ("solidly back on the deck as wheels grip the concrete"). hailuo-2.3/text-to-video no expone parámetros de cámara ni de temporalidad: todo depende de lo específico que seas al describir.
El problema: solo salida horizontal
El esquema de entrada de hailuo-2.3/text-to-video (la lista de parámetros en vivo está en la página del modelo) es deliberadamente limitado: prompt, duration ("6" o "10") y prompt_optimizer. No hay aspect_ratio, no hay resolution ni seed: cada video se renderiza en un formato horizontal fijo de 1366×768.
Esto es un problema real para TikTok, Reels y Shorts, que exigen 9:16. Como no hay opción vertical que solicitar, la solución tiene que venir después de la generación: o recortas el encuadre horizontal a una franja vertical centrada (funciona bien cuando el sujeto se mantiene en el centro, como en el video anterior), o conservas el encuadre completo y rellenas arriba y abajo con una copia ampliada y desenfocada del mismo material, el clásico efecto de "fondo desenfocado" al reeditar clips horizontales. Planifica el paso de recorte/relleno como parte del pipeline, en lugar de suponer que el modelo te entregará directamente un resultado listo para vertical.
Costo: dos duraciones, sin modo económico
Según la página de precios en vivo de hiapi, hailuo-2.3/text-to-video se cobra por video a tarifa fija: $0.40 por un clip de 6 segundos y $0.80 por uno de 10 segundos, exactamente el doble, sin descuentos por volumen integrados. Esto es importante para presupuestar en lote: tres clips de 6 segundos ($1.20 en total, 18 segundos de material) cuestan lo mismo que tres clips de duración casi completa, así que montar varias tomas cortas suele salir más barato que cubrir la misma duración total con una sola toma larga continua.
Un detalle que suele pillar a la gente: Hailuo 2.3 sí tiene un nivel "fast" más económico ($0.27 por 6 s / $0.46 por 10 s), pero solo existe en imagen a video. Texto a video tiene un único nivel de precio, sin alternativa fast/económica. Si necesitas iterar mucho sobre el prompt antes de fijar el render final, suele ser más barato generar primero un fotograma fijo y luego iterar el movimiento con hailuo-2.3-fast/image-to-video a partir de ese fotograma.
Integración en el pipeline
Todos los modelos de video de hiapi siguen el mismo patrón asíncrono de /v1/tasks: crea la tarea, haz polling y descarga la salida de inmediato, porque los enlaces de entrega caducan:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hailuo-2.3/text-to-video",
    "input": {
      "prompt": "a skateboarder in an empty downtown parking garage at golden hour attempts a kickflip...",
      "duration": "6",
      "prompt_optimizer": true
    }
  }'
Haz polling con GET /v1/tasks/{taskId} hasta que el estado llegue a un estado terminal y luego toma output[0].url y descárgalo de inmediato. La estructura completa de solicitud/respuesta y la validación del esquema en vivo están en la página del modelo; los detalles generales de autenticación y ciclo de vida de las tareas están en la documentación de hiapi.
Si vas a montar un pipeline de video corto en torno a más de un modelo de video en lugar de apostar todo a uno solo, merece la pena leer el repaso de los cuatro grandes modelos de video de hiapi: en precio y posicionamiento de calidad, hailuo-2.3 no es lo mismo que modelos como seedance-2.0-mini, y combinar modelos según el tipo de escena suele dar mejores resultados que usar uno solo para todo el calendario de contenidos.
Preguntas frecuentes
¿hailuo-2.3/text-to-video admite salida vertical (9:16)?
No. No hay parámetros aspect_ratio ni resolution: cada video se renderiza en horizontal a unos 1366×768. Para obtener vertical, recorta o rellena la salida después de generarla.
¿Cuánto tarda en generarse un video? Es una tarea asíncrona: envíala y haz polling hasta que el estado llegue a un estado terminal. En un pipeline por lotes, reserva unos minutos por video en lugar de esperar una respuesta síncrona.
¿Hay una versión más barata o más rápida de hailuo-2.3/text-to-video? No. El nivel "fast" con descuento solo aplica a hailuo-2.3-fast/image-to-video. Texto a video tiene un único precio: $0.40 por 6 segundos y $0.80 por 10 segundos.
¿Puedo controlar directamente el movimiento de cámara o los momentos concretos de la secuencia? No mediante parámetros estructurados: el movimiento, los movimientos de cámara y el ritmo provienen de cómo escribes el prompt. El prompt anterior (una toma de seguimiento con nombre, una descripción explícita de la rotación, un momento de aterrizaje) es una plantilla válida para tomas de acción con sensación física.
Resumen de puntos clave
- Todo el esquema de entrada se reduce a
prompt,duration("6"o"10") yprompt_optimizer: no hay aspect_ratio, resolution ni seed que ajustar. - La salida es siempre horizontal a unos 1366×768; si el objetivo son plataformas de video corto verticales, hay que planificar un paso de recorte o relleno.
- Precio fijo: $0.40 por 6 segundos y $0.80 por 10 segundos; el nivel "fast" más económico solo existe en imagen a video.
- Envía la tarea mediante
/v1/tasks, haz polling hasta el estado terminal y descarga de inmediato la URL de salida, porque los enlaces caducan.
¿Listo para probarlo? Genera un video en la página del modelo hailuo-2.3/text-to-video con el prompt anterior y consulta los precios actuales antes de ejecutar todo el conjunto de videos cortos en lote.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores