
Guida all'uso
Hailuo 2.3 Text-to-Video: workflow per video brevi basato sull'API hiapi
Prompt reali, costi reali e come aggirare il limite dell'output solo orizzontale per adattarlo a TikTok e Reels
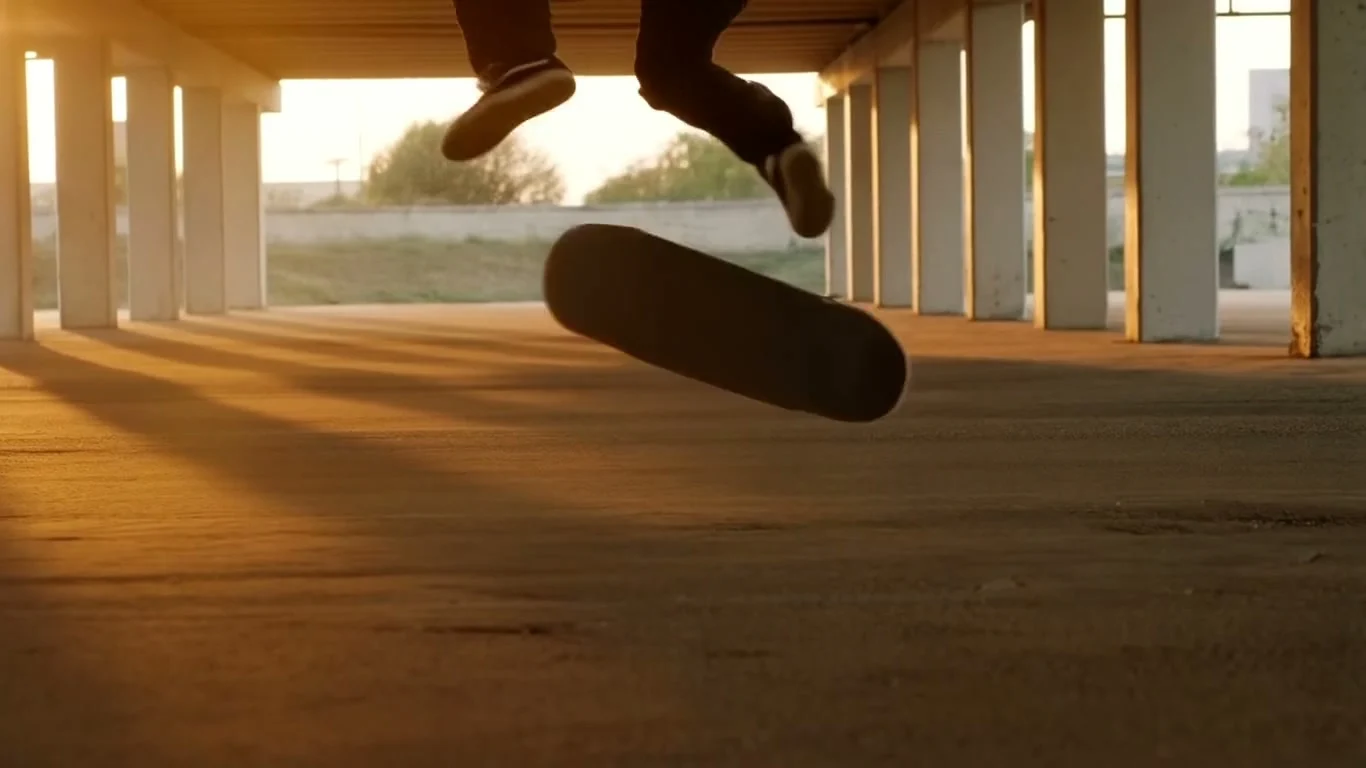
I video brevi richiedono un movimento che risulti credibile nel giro di un secondo di immagine: uno skateboard che si ribalta, un tessuto che ondeggia, una panoramica rapida. hailuo-2.3/text-to-video è progettato proprio per questo: inviando un prompt testuale all'endpoint /v1/tasks di hiapi si ottiene una clip di 6 o 10 secondi con una sensazione di movimento fisico realistico, senza bisogno di immagini di riferimento. Questo articolo percorre l'intero workflow reale dell'API, mostra una clip effettivamente generata, illustra un limite dell'output che vale la pena conoscere prima di costruirci sopra una pipeline e cita direttamente i prezzi in tempo reale di /api/pricing di hiapi.
Dove eccelle davvero hailuo-2.3/text-to-video
I modelli text-to-video tendono a cedere sotto azioni fisiche rapide: lo skateboard si piega, gli arti si deformano a metà del flip. hailuo-2.3/text-to-video su hiapi porta il tag "Motion Physics", ed è questo il suo vero punto di forza: rimane stabile proprio sotto quel tipo di azione che costituisce la maggior parte dei contenuti per video brevi — un trick, una rivelazione, un movimento di camera rapido. Non regge il confronto con i modelli specializzati in scene statiche sui dettagli fini, ma per una clip di 6-10 secondi destinata a essere guardata una sola volta sul telefono, un movimento fisicamente credibile conta più della texture a livello di pixel.
Il prompt e ciò che ha effettivamente generato
Di seguito il prompt completo usato per il video che segue: puoi copiarlo come punto di partenza per le tue riprese d'azione:
a skateboarder in an empty downtown parking garage at golden hour attempts a kickflip, the board spinning crisply mid-air with realistic physical rotation, sneaker landing solidly back on the deck as wheels grip the concrete, sunlight flaring low through support pillars, dynamic low-angle tracking shot following the motion, natural motion blur on fast movement, warm saturated color grade, handheld documentary energy
Nota le parti del prompt che fanno davvero la differenza: un movimento di camera esplicitamente nominato ("dynamic low-angle tracking shot"), una descrizione precisa del movimento ("crisply mid-air with realistic physical rotation") e un momento di atterraggio ("solidly back on the deck as wheels grip the concrete"). hailuo-2.3/text-to-video non espone direttamente parametri per il movimento di camera o la temporizzazione: tutto dipende da quanto è specifica la tua descrizione.
Il problema: solo orizzontale
Lo schema di input di hailuo-2.3/text-to-video (l'elenco dei parametri in tempo reale è nella pagina del modello) è volutamente molto ristretto: prompt, duration ("6" o "10") e prompt_optimizer. Niente aspect_ratio, niente resolution, niente seed: ogni video viene renderizzato in un formato orizzontale fisso di 1366×768.
Per TikTok, Reels e Shorts questo è un vero problema, perché richiedono tutti il 9:16. Poiché non esiste un'opzione verticale da richiedere, la soluzione va cercata dopo la generazione: o ritagliare l'inquadratura orizzontale in una striscia verticale centrata (funziona bene quando il soggetto resta al centro, come nel video sopra), oppure mantenere l'inquadratura completa e riempire sopra e sotto con una copia sfocata e ingrandita dello stesso materiale — il consueto effetto "sfondo sfocato" quando si rifilano clip orizzontali. Pianifica il passaggio di ritaglio/riempimento come parte della pipeline, invece di dare per scontato che il modello ti consegni un prodotto pronto per il verticale.
Costi: due sole durate, nessuna modalità economica
Secondo la pagina dei prezzi in tempo reale di hiapi, hailuo-2.3/text-to-video ha un prezzo fisso per video: clip da 6 secondi a $0.40, clip da 10 secondi a $0.80 — esattamente il doppio, senza sconti per volumi. Questo conta per il budget in batch: tre clip da 6 secondi ($1.20 in totale, 18 secondi di materiale) costano quanto tre clip vicine alla durata massima, quindi montare più clip brevi in sequenza è di solito più economico che coprire la stessa durata totale con un unico piano sequenza lungo.
Un punto facile in cui inciampare: Hailuo 2.3 ha effettivamente una fascia "fast" più economica (6 secondi $0.27 / 10 secondi $0.46), ma esiste solo per image-to-video. Il text-to-video ha un'unica fascia di prezzo, senza alternativa fast/economica. Se prima del render finale hai bisogno di iterare molto sul prompt, spesso conviene generare un fermo immagine e poi iterare il movimento partendo da quel frame con hailuo-2.3-fast/image-to-video.
Integrazione nella pipeline
I modelli video di hiapi seguono tutti lo stesso schema asincrono di /v1/tasks: crea il task, esegui il polling, scarica subito l'output, perché i link di consegna scadono:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hailuo-2.3/text-to-video",
    "input": {
      "prompt": "a skateboarder in an empty downtown parking garage at golden hour attempts a kickflip...",
      "duration": "6",
      "prompt_optimizer": true
    }
  }'
Esegui il polling di GET /v1/tasks/{taskId} finché lo stato non raggiunge quello finale, poi recupera output[0].url e scaricalo subito. La struttura completa di richiesta/risposta e la validazione dello schema in tempo reale sono nella pagina del modello; i dettagli generali su autenticazione e ciclo di vita dei task sono nella documentazione di hiapi.
Se stai costruendo una pipeline per video brevi attorno a più di un modello video, invece di puntare tutto su uno solo, vale la pena leggere la panoramica dei quattro principali modelli video di hiapi: hailuo-2.3 si posiziona diversamente da modelli come seedance-2.0-mini in termini di prezzo e qualità, e combinare modelli diversi in base al tipo di scena di solito funziona meglio che usare un unico modello per tutto il calendario editoriale.
Domande frequenti
hailuo-2.3/text-to-video supporta output verticale (9:16)?
No. Non ci sono parametri aspect_ratio o resolution: ogni video viene renderizzato in orizzontale a circa 1366×768. Per ottenere il verticale bisogna ritagliare o riempire l'output dopo la generazione.
Quanto tempo serve per generare un video? È un task asincrono: dopo l'invio si esegue il polling finché lo stato non diventa finale. In una pipeline in batch, pianifica qualche minuto per video, invece di aspettarti una risposta sincrona.
Esiste una versione più economica o più veloce di hailuo-2.3/text-to-video? No. La fascia scontata "fast" è disponibile solo per hailuo-2.3-fast/image-to-video. Il text-to-video ha un unico prezzo: $0.40 per 6 secondi, $0.80 per 10 secondi.
Posso controllare direttamente il movimento di camera o i singoli momenti della temporizzazione? Non tramite parametri strutturati: movimento, camera e ritmo derivano da come è scritto il prompt. Il prompt qui sopra (movimento di tracking esplicitamente nominato, descrizione precisa della rotazione, un momento di atterraggio) è un modello efficace per riprese d'azione fisiche.
In sintesi
- L'intero schema di input comprende solo
prompt,duration("6"o"10") eprompt_optimizer— nessun aspect_ratio, resolution o seed regolabile. - L'output è sempre orizzontale a circa 1366×768; per le piattaforme di video brevi verticali, prevedi un passaggio di ritaglio o riempimento.
- Prezzo fisso: $0.40 per 6 secondi, $0.80 per 10 secondi — la fascia "fast" più economica esiste solo per image-to-video.
- Invia tramite
/v1/tasks, esegui il polling fino allo stato finale, poi scarica subito l'URL di output, perché i link scadono.
Pronto a provarlo? Genera un video con il prompt qui sopra nella pagina del modello hailuo-2.3/text-to-video e controlla i prezzi attuali prima di lanciare l'intera serie di video brevi in batch.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori