
Black Forest Labs
FLUX.1 Schnell
flux-schnell/text-to-image
Modelo de texto a imagen destilado de Black Forest Labs, transformer de flujo rectificado con 12 mil millones de parámetros, enfocado en la generación rápida de imágenes con baja latencia, ideal para la generación por lotes de imágenes conceptuales y bocetos
Probar flux-schnell/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image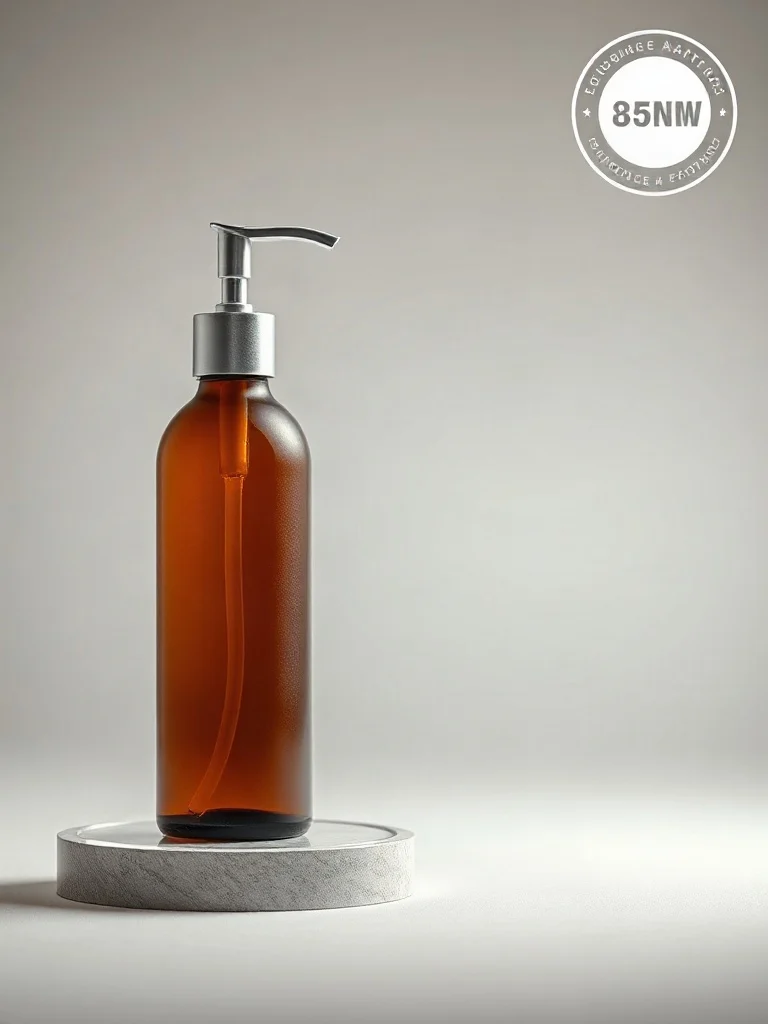
Imágenes de calidad de fotografía de producto de nivel e-commerce con FLUX.1-schnell
Estilo Imagen de producto · ecommerce-studio · Luz suave
Prompt
Fotografía de producto en estudio, una botella de bomba dispensadora de vidrio ámbar mate con cuello de metal cepillado, colocada ligeramente a la izquierda sobre un fondo gris claro sin costuras, apoyada sobre una plataforma elevadora de acrílico apenas perceptible. Un softbox en la parte superior izquierda actúa como luz principal, una tira de luz estrecha en el lado derecho roza en diagonal el borde derecho creando un contorno nítido, y un difusor superior aplana los reflejos especulares sobre el metal. Objetivo equivalente a 85 mm, profundidad de campo reducida, foco sobre la etiqueta, transición suave hacia el fondo, balance de blancos neutro, acabado de retoque comercial limpio, amplio espacio negativo en la esquina superior derecha para el distintivo de e-commerce, composición 16:9.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
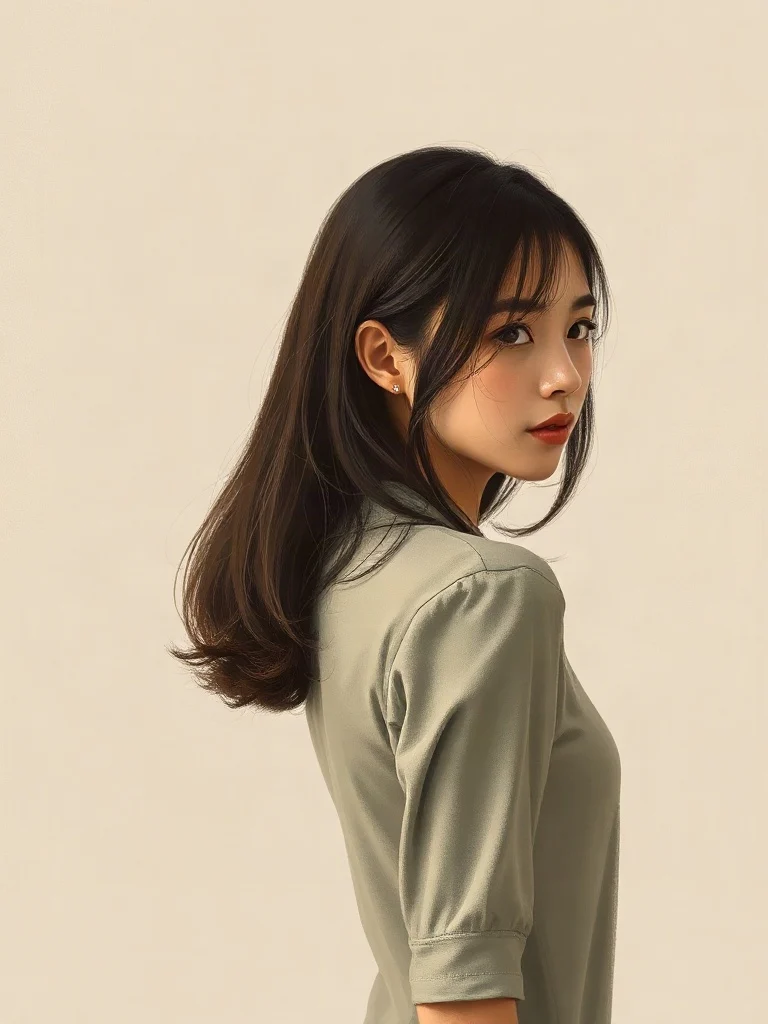
Espectro de estilos de FLUX.1-schnell: del retrato realista de una joven al estilo plano
Estilo Ilustración · style-spectrum · retrato-de-personaje
Prompt
Retrato de medio cuerpo de una mujer joven que mira hacia atrás por encima del hombro, con luz suave de ventana entrando desde la izquierda y un fondo limpio de gris cálido. Presentado en estilo de pintura realista: textura de pincelada visible, luminosidad delicada de la piel, cabellos definidos mechón a mechón, pliegues de la ropa con transiciones suaves de sombra y tonos naturales de baja saturación. Composición 16:9, la figura ligeramente descentrada y con un amplio espacio negativo a la derecha.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
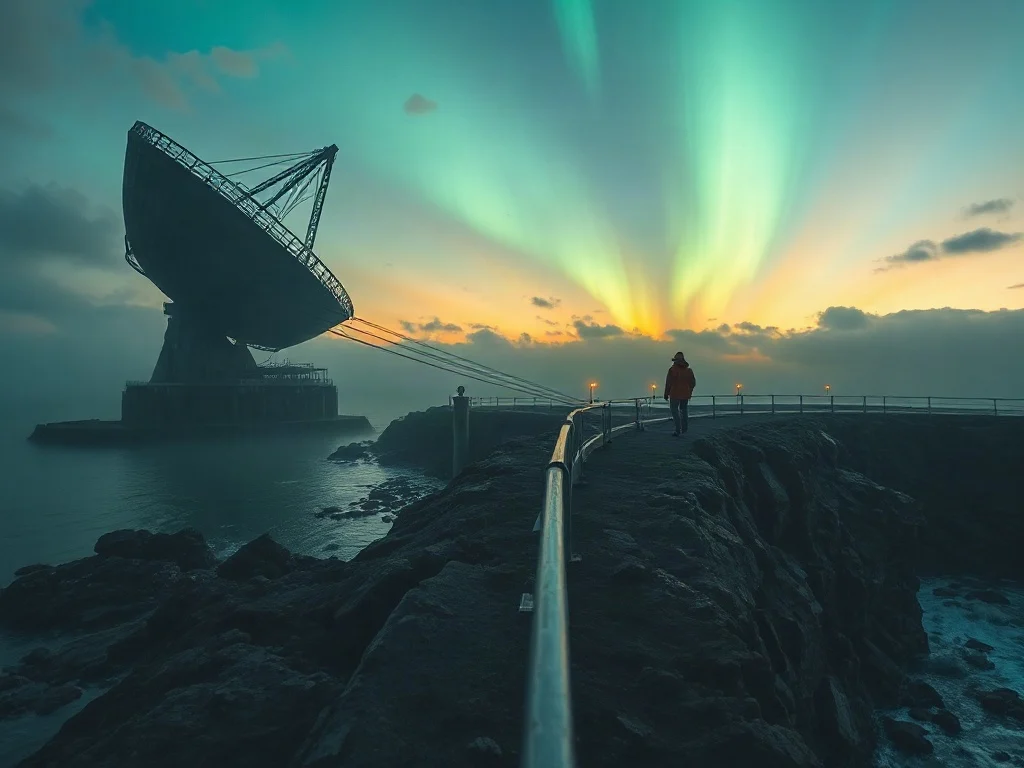
Imagen conceptual de escenario de mundo de FLUX.1-schnell
Estilo Arte conceptual · Construcción del mundo · Ciencia ficción
Prompt
Plano general cinematográfico de establecimiento, al atardecer, una estación de observación costera abandonada encajada en un acantilado de roca volcánica, una enorme antena parabólica de radio corroída semisumergida en una poza de marea, cables finos tensados entre torres de hormigón, una aurora lejana filtra verdes y púrpuras en nubes de tormenta bajas, basalto húmedo que refleja luces de sodio cálidas, una figura solitaria con una chaqueta salvavidas naranja desgastada caminando por el malecón como referencia de escala, niebla atmosférica estratificada y espuma marina, tonos suaves de verde azulado y ámbar con luz de contorno fría, haces de luz volumétricos y sacros, arquitectura de superficie dura y texturas de roca orgánica altamente detalladas, arte conceptual fotorrealista, aspecto de lente anamórfica de 35mm, profundidad de campo reducida en la barandilla en primer plano, composición 16:9, horizonte en el tercio inferior del encuadre
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
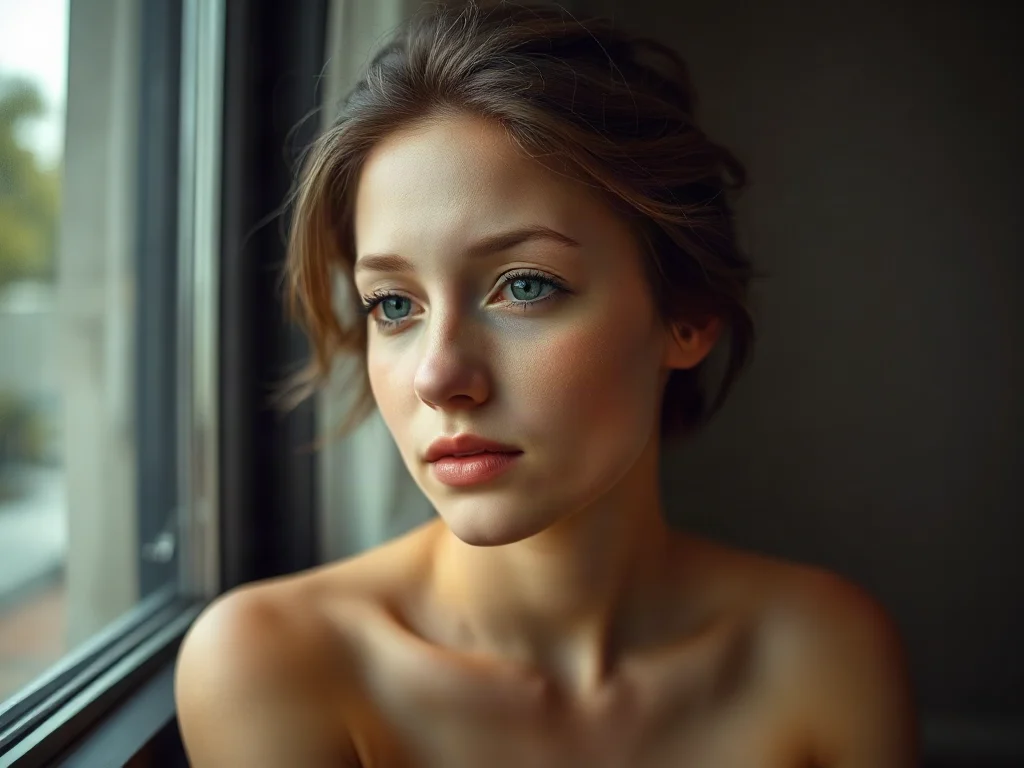
Demostración de estilos de retrato con FLUX.1-schnell: comparación entre realismo y estilización artística
Estilo Retrato y fotografía · Fotorrealismo · Referencia de prompts
Prompt
Retrato de una mujer joven sentada junto a una gran ventana, vista de tres cuartos, mirando serenamente a la cámara, textura de piel natural, poros visibles y cabello fino, luz diurna difusa y suave que entra desde la izquierda, transición gradual y suave hacia un fondo interior en gris cálido y discreto, profundidad de campo reducida, aspecto de objetivo de 85 mm, estilo de color Kodak Portra, grano de película sutil, exposición equilibrada, gran detalle en ojos y labios, sin retoque intensivo, composición vertical 3:4, fotografía.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
flux-schnell/text-to-image per image
| Precio unitario | $0.005 |
|---|
Presentación
FLUX.1-schnell es un modelo de texto a imagen presentado por Black Forest Labs, basado en una arquitectura rectified flow transformer de 12 000 millones de parámetros y optimizado mediante destilación, que genera imágenes de alta calidad con un número reducido de pasos de inferencia y logra un buen equilibrio entre el seguimiento de las indicaciones y la representación de detalles. Se puede invocar este modelo a través de la interfaz unificada de HiAPI.ai, lo que lo hace adecuado para desarrolladores y escenarios de creación de contenido que necesitan producir rápidamente bocetos conceptuales y material visual.
Puntos clave
- Arquitectura destilada que genera imágenes rápidamente con pocos pasos: la recomendación oficial es de 1 a 4 pasos de inferencia para completar la generación con eliminación de ruido, lo que lo hace adecuado para escenarios interactivos que exigen velocidad de respuesta.
- Equilibrio entre seguimiento de indicaciones y representación de detalles: basado en un rectified flow transformer de 12 000 millones de parámetros, ofrece un buen rendimiento en detalles de imagen y alineación con las indicaciones.
- Control flexible de la relación de aspecto y el formato de salida: admite cinco relaciones de aspecto (1:1, 4:3, 3:4, 16:9 y 9:16) y salida en jpeg o png, lo que facilita la adaptación a distintas necesidades de maquetación.
Descripción de capacidades
Generación de texto a imagen: basta con introducir una indicación de texto para generar la imagen correspondiente, ideal para convertir rápidamente descripciones creativas en material visual.
Ajuste de los pasos de inferencia y del coeficiente de guía: se pueden configurar de 1 a 12 pasos de inferencia (la recomendación oficial es de 1 a 4 pasos) y un coeficiente de guía de 1 a 20, para equilibrar según las necesidades la velocidad y el grado de seguimiento de las indicaciones.
Reproducción de resultados con semilla fija: al especificar una semilla aleatoria, se pueden reproducir los resultados de generación con los mismos parámetros, lo que facilita la depuración y la gestión de la coherencia en tareas por lotes.
Interruptor de filtrado de seguridad de contenido: la comprobación de seguridad está activada por defecto, pero también se puede desactivar según sea necesario, lo que permite ajustar con flexibilidad la política de contenido en entornos controlados.
Casos de uso
- Generación rápida de bocetos conceptuales por parte de diseñadores: introducir una descripción de escena o estilo para producir rápidamente varios bocetos conceptuales, utilizados en la comunicación creativa temprana y la selección de direcciones.
- Desarrolladores que crean aplicaciones de texto a imagen: integrar el modelo en el flujo de trabajo de su propio producto para generar en tiempo real imágenes o material visual a partir de la entrada del usuario.
- Generación de imágenes de acompañamiento en la creación de contenido: generar por lotes imágenes de acompañamiento para artículos, redes sociales y otros escenarios con la relación de aspecto y el formato especificados, listas para su publicación directa.
Limitaciones y recomendaciones de selección
Este modelo solo admite la generación de texto a imagen y no cubre otras modalidades como vídeo o texto. Al ser una versión destilada, en escenarios con indicaciones complejas o requisitos de alta precisión su rendimiento podría ser inferior al de los modelos no destilados; los resultados reales dependen de la calidad de las indicaciones, los parámetros de muestreo y el entorno de ejecución. Si se necesitan capacidades multimodales o una generación de imágenes de mayor precisión, se recomienda evaluar otros modelos.
Preguntas frecuentes
Ver todas las preguntas →-
¿Para qué tareas es principalmente adecuado FLUX.1 [schnell]?
Un modelo ultrarrápido de bajo coste con 1-4 pasos, adecuado para bocetos, generación de imágenes por lotes y exploración rápida de prompts.
-
¿FLUX.1 [schnell] admite imágenes de referencia?
La línea actual es de generación de imágenes solo a partir de texto, no acepta imágenes de referencia.
-
¿Qué especificaciones de salida se admiten?
La página actual muestra 1-12 inference steps y 1:1, 16:9, 9:16, 4:3, 3:4; las opciones finales están sujetas a los parámetros del Playground.
-
¿Cómo se factura FLUX.1 [schnell]?
Se factura según la cantidad de imágenes generadas con éxito; si hay diferencias según la resolución o el nivel de calidad, se mostrarán en el precio en tiempo real de la página.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: flux-schnell/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para flux-schnell/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalSemilla aleatoria para reproducir el resultado de la generación; al pasar la misma semilla se obtiene una salida consistente.
promptstringObligatorioIndicación de texto utilizada para la generación de la imagen.
aspect_ratiostringOpcionalPredeterminado: "4:3"Relación de aspecto de la imagen de salida; por defecto 4:3.
1:14:33:416:99:16output_formatstringOpcionalPredeterminado: "jpeg"Formato de la imagen de salida; por defecto jpeg.
jpegpngguidance_scalenumberOpcionalPredeterminado: 3.5min 1max 20Controla en qué medida el resultado generado sigue la indicación; por defecto 3.5.
num_inference_stepsintegerOpcionalPredeterminado: 4min 1max 12Número de pasos de eliminación de ruido; por defecto 4; para el modelo schnell se recomienda 1-4.
enable_safety_checkerbooleanOpcionalPredeterminado: trueIndica si se habilita el filtro de seguridad de contenido; por defecto true.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-schnell/text-to-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "4:3",
    "output_format": "jpeg",
    "guidance_scale": 3.5,
    "num_inference_steps": 4,
    "enable_safety_checker": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-schnell/text-to-image",
input: {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-schnell/text-to-image",
"input": {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 GPT Image 2.5 OpenAI $0.017 /imagen
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagen
-
 BRIA Product Shot Bria $0.058 /imagen
-
 Seedream 4.5 ByteDance $0.045 /imagen
-
 Seedream 5.0 ByteDance $0.025 /imagen
-
 FIBO 1.5 Bria $0.058 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /imagen
-
 Imagen 4 Google $0.030 /imagen
-
 FASHN Tryon v1.6 FASHN $0.107 /imagen
-
 Wan 2.7 Image Alibaba $0.035 /imagen
-
 Google Virtual Try-On Google $0.107 /imagen
Mismo proveedor
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagen
-
 FLUX 3 Max Black Forest Labs $0.061 /segundo
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagen
-
 FLUX 3 Image Black Forest Labs $0.041 /imagen
- FLUX.1 Fill Pro Black Forest Labs $0.071 /imagen
-
 FLUX.2 Black Forest Labs $0.035 /imagen
- FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 FLUX 3 Video Black Forest Labs $0.090 /segundo
- FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagen