
Krea
Krea 3
krea-3/text-to-image
Admite generación a partir de texto y edición con imágenes de referencia, salida nativa en 2K, aproximadamente 8 segundos por edición; ideal para iteraciones visuales de alta frecuencia y reutilización de material.
Probar krea-3/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image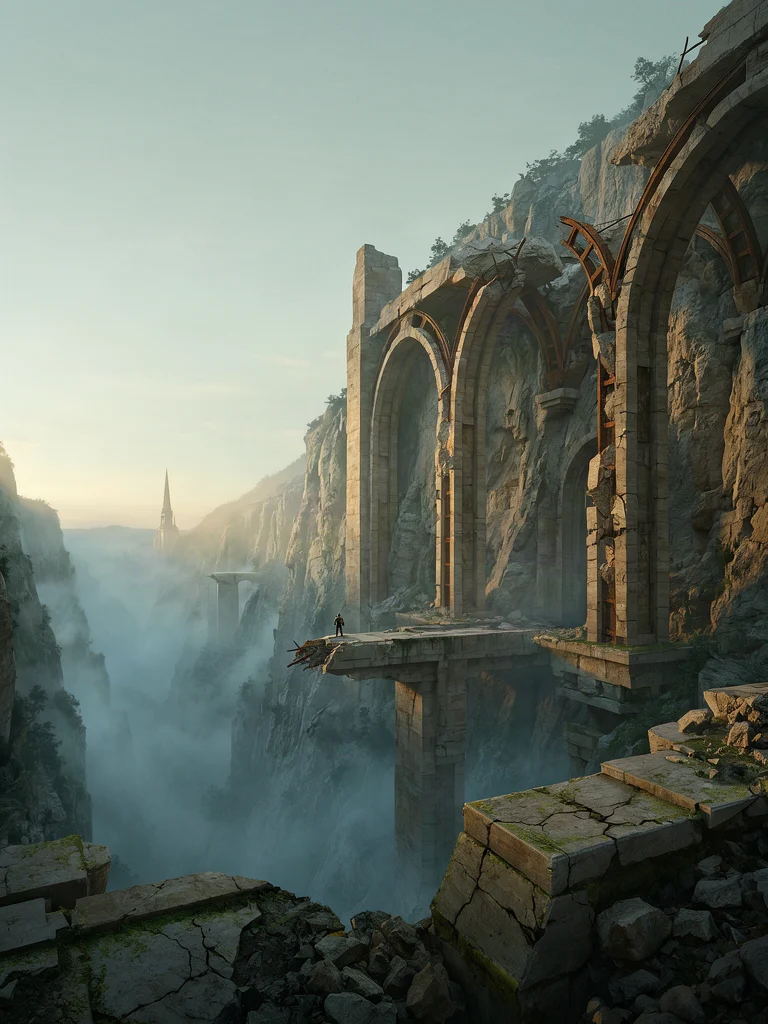
Imagen conceptual de escenario del mundo: niebla matinal del santuario en ruinas
Estilo Arte conceptual · Construcción del mundo · Atmósfera
Prompt
Arte conceptual cinematográfico en formato panorámico de un santuario abandonado al borde de un acantilado al amanecer: enormes arcos de piedra parcialmente derrumbados en un valle cubierto de niebla, un explorador solitario aparece como silueta sobre un puente roto y aporta una referencia de escala a la imagen; profundidad de campo por capas, con escombros en el primer plano, niebla en el plano medio y agujas en el fondo; luz direccional suave que incide en diagonal a través de la niebla matinal; paleta de azul verdoso frío y desaturado combinada con tonos arenisca cálidos; texturas de piedra erosionada y metal oxidado; acabado de pintura mate pictórica con detallado arquitectónico minucioso; composición horizontal 16:9 con una fuerte perspectiva de punto de fuga y amplio espacio negativo en el cielo
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
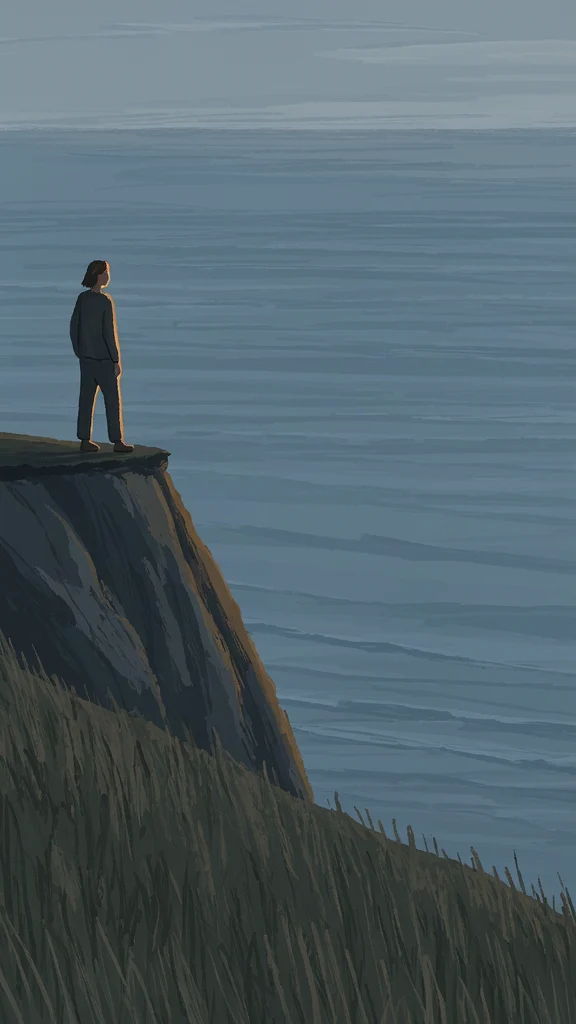
Del realismo al estilo plano: el espectro de estilos de ilustración de Krea 3
Estilo Ilustración · style-spectrum · Editorial
Prompt
Ilustración de estilo editorial: al atardecer, una figura solitaria permanece de pie al borde de un acantilado costero, presentada en un ángulo de tres cuartos y contrapicado, con la composición en un formato horizontal de 16:9 y un amplio espacio negativo reservado a la derecha. Representa la escena con pinceladas pictóricas claramente visibles: el mar y el cielo se expresan con capas superpuestas de masas de azul grisáceo frío, las rocas del acantilado se salpican de ocre cálido, una suave luz de contorno delinea la silueta de la figura, y las formas se simplifican manteniendo una estructura legible pero sin buscar en absoluto un realismo fotográfico. Detalle de densidad media: la vegetación en primer plano con pinceladas expresivas, que se vuelven más amplias cuanto más cerca del horizonte. Paleta general suave y de baja saturación, conservando un único punto focal cálido. Sin texto, sin marca de agua, sin extremidades sobrantes.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
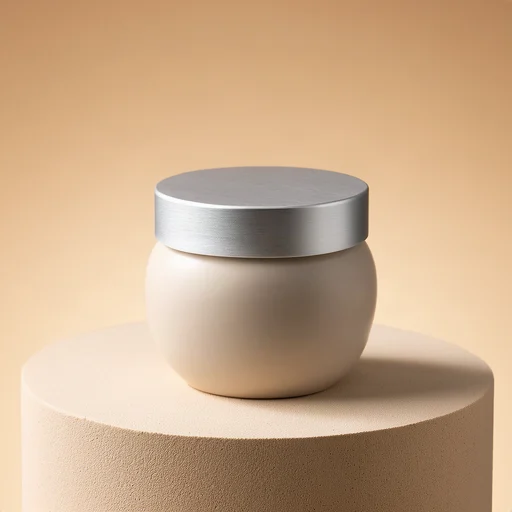
Krea 3 电商产品图:台面光影与材质质感
Estilo Imagen de producto · ecommerce · Iluminación de estudio
Prompt
Fotografía de producto para e-commerce: un tarro de cosmético de cerámica mate con tapa de aluminio cepillado, apoyado sobre un pedestal de yeso en tono beige cálido, vista de tres cuartos centrada, cámara a la altura del producto con un ligero picado, aspecto de objetivo de 85 mm, profundidad de campo reducida, luz principal suave de un softbox grande de gran tamaño desde arriba a la izquierda que crea un degradado suave sobre la superficie cerámica curva, una sutil luz de contorno que separa el borde de la tapa del fondo, una tenue sombra de contacto que asienta la base, fondo degradado sin costuras en tono arena cálido, el esmalte muestra una microtextura nítida, la tapa presenta un fino cepillado metálico, colorimetría comercial limpia, alto detalle, sin texto, sin atrezo desordenado, sin reflejos especulares cegadores
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
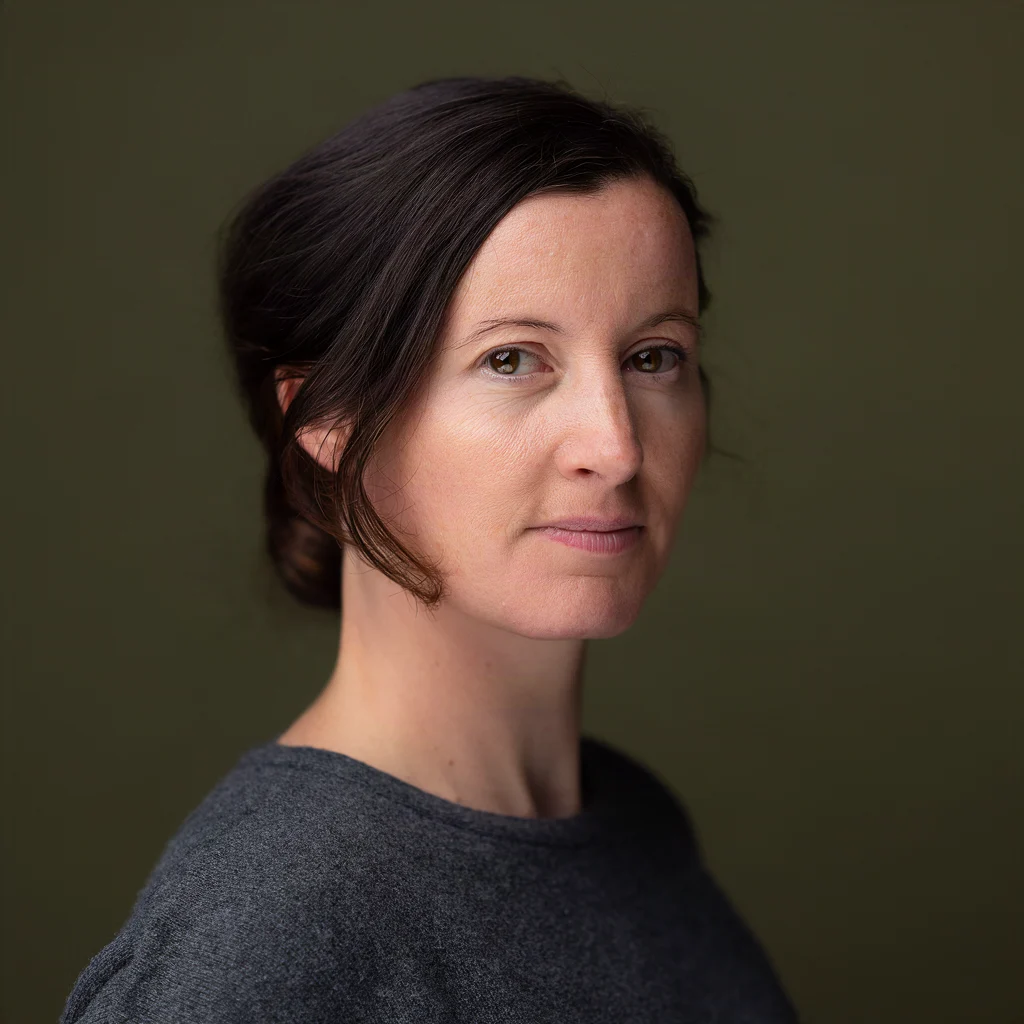
Demostración de doble estilo con prompts de retrato de Krea 3: realismo y artisticidad
Estilo Fotografía de retrato · Ingeniería de prompts · Editorial
Prompt
Fotografía de retrato de una mujer de poco más de treinta años, vista de tres cuartos, mirada ligeramente desviada más allá de la cámara, piel natural sin retocar, poros y texturas finas visibles, luz suave de ventana procedente de la izquierda de la cámara, un sutil rebote de luz fría como relleno en el lado derecho, profundidad de campo reducida de aproximadamente f/2, aspecto de objetivo de 85 mm, tonos neutros de baja saturación, fondo continuo de tela de color verde oliva oscuro, cabello recogido hacia atrás con algunos mechones sueltos, maquillaje ligero, expresión serena y neutra, composición vertical 4:3 con espacio sobre la cabeza, grano fino, sin retoque embellecedor
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
krea-3/text-to-image per image
| Precio unitario | $0.036 |
|---|
Descripción general
krea-3/text-to-image es una línea de modelos de Krea orientada a escenarios de texto a imagen, que se invoca a través de la interfaz unificada de HiAPI.ai. Acepta indicaciones de texto para generar imágenes y ofrece varios preajustes de tamaño, como cuadrado, vertical y horizontal, con salida en PNG o JPEG. La línea admite dos variantes, berry y jam; la primera se inclina por la calidad de imagen y la segunda por la velocidad. Además, permite configurar la intensidad de razonamiento, las indicaciones negativas y una semilla aleatoria fija para facilitar la reproducción del mismo resultado. Es adecuada para equipos de desarrollo que necesitan equilibrar la calidad de imagen y la velocidad de generación según el proyecto, e integrar la generación por lotes en sus propios flujos de trabajo.
Aspectos destacados
- Calidad y velocidad seleccionables por niveles: la variante ofrece las opciones berry y jam; la primera prioriza la calidad y la segunda la velocidad, y se puede alternar entre ambas según la tarea.
- Intensidad de razonamiento ajustable: reasoning_level puede ser low o medium, lo que controla el grado de razonamiento y expansión de la indicación antes de la generación; medium tarda más.
- Tamaño y formato de salida controlables: incluye seis preajustes integrados, cuadrado, vertical 4:3/16:9 y horizontal 4:3/16:9, con un máximo de 1024×1024, y salida en PNG o JPEG.
- Reproducción mediante semilla fija: al pasar seed, las mismas entradas pueden reproducir el mismo resultado, lo que facilita la depuración de indicaciones y la comparación entre versiones.
Descripción de capacidades
Generación de imágenes a partir de indicaciones de texto: una descripción de texto es la única entrada obligatoria y devuelve una sola imagen; la indicación puede tener hasta 5000 caracteres, lo que permite incluir descripciones bastante completas del sujeto, el estilo y la composición.
Exclusión de elementos mediante indicaciones negativas: a través de negative_prompt (hasta 1024 caracteres) se especifica el contenido que no se desea que aparezca en la imagen, lo que añade otra dimensión de control sobre el resultado.
Seis preajustes de tamaño y selección de formato: se elige un preajuste cuadrado, vertical u horizontal según el lugar final de publicación, y se emite directamente en PNG o JPEG, lo que reduce los pasos posteriores de conversión.
Reproducción parametrizada de resultados: una vez fijados parámetros como seed y reasoning_level, las mismas entradas producen de forma estable las mismas salidas, lo que resulta adecuado para establecer una base de generación reproducible.
Escenarios de uso
- Generación por lotes de imágenes ilustrativas para equipos de contenido: se elige el preajuste correspondiente al tamaño de la sección y cada llamada produce una imagen ilustrativa, útil para imágenes de cabecera de artículos, imágenes para redes sociales y otros lugares que requieren una generación estable.
- Ajuste de indicaciones para diseñadores y desarrolladores: tras fijar la semilla, se ajustan uno a uno la indicación y las indicaciones negativas, se comparan las diferencias en la salida y se consolidan plantillas de indicaciones reutilizables.
- Producción del mismo origen para materiales verticales y horizontales: con la misma descripción se alterna entre los preajustes portrait y landscape para obtener materiales del mismo estilo adaptados a móviles y a la web.
- Validación de prototipos sensibles a la velocidad de generación: se elige la variante jam y se reduce la intensidad de razonamiento para obtener rápidamente varias direcciones en las primeras fases del proyecto, y después se produce una versión refinada con berry.
Limitaciones y recomendaciones de selección
Solo admite la generación a partir de indicaciones de texto; no acepta imágenes de referencia ni realiza edición local. Cuando se requiera imagen a imagen o modificaciones por regiones, debe elegirse un modelo con las capacidades correspondientes. El límite de salida es de 1024×1024, por lo que los productos finales de alta resolución requieren un escalado adicional. negative_prompt solo tiene efecto en la variante berry; al elegir jam, este parámetro no surte efecto. Cada llamada devuelve una imagen, por lo que se necesitan varias solicitudes para obtener varias propuestas. Si la tarea exige reproducir con estricta fidelidad la apariencia de un personaje o producto existente, una descripción puramente textual difícilmente garantizará la consistencia.
Preguntas frecuentes
Ver todas las preguntas →-
¿Para qué es adecuado Krea 3?
Es adecuado para fotografía realista, retratos, imágenes de producto, gastronomía, arquitectura y espacios, ilustración y diseño conceptual, y también puede generar carteles con texto de titular. Con prompts cortos también se obtienen imágenes completas, ideal para explorar direcciones rápidamente.
-
¿Cuál es la diferencia entre berry y jam?
Son dos variantes del mismo modelo, con la mayoría de los parámetros idénticos (negative_prompt solo tiene efecto en berry): Krea posiciona berry como prioridad en calidad y jam como prioridad en velocidad, ambos al mismo precio. Se alternan mediante input.variant; por defecto, berry. En comparaciones reales, con la misma seed ambos difieren en composición y tonos de color, con calidad de imagen comparable; conviene probar ambos una vez y luego elegir.
-
¿Qué es reasoning_level? ¿Cuál debería elegir?
Controla cuánto esfuerzo dedica el modelo a comprender y ampliar el prompt antes de generar la imagen; las opciones son low y medium (predeterminado). Usa medium cuando el prompt sea muy corto o abstracto; usa low cuando el prompt ya esté bien detallado y quieras mayor rapidez.
-
¿Qué tamaños son compatibles?
image_size admite 6 opciones: square_hd (1024 × 1024, predeterminado), square (512 × 512), portrait_4_3 (768 × 1024), portrait_16_9 (576 × 1024), landscape_4_3 (1024 × 768), landscape_16_9 (1024 × 576).
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: krea-3/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para krea-3/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria fija para reproducir el mismo resultado de generación; debe ser un número entero, si no se proporciona el servidor la decide aleatoriamente.
promptstringObligatoriominLength 1maxLength 5000Descripción textual de la imagen a generar, que se usa como indicación de entrada para el contenido generado.
variantstringOpcionalPredeterminado: "berry"Nivel de variante de generación; berry prioriza la calidad y jam prioriza la velocidad; por defecto berry.
berryjamimage_sizestringOpcionalPredeterminado: "square_hd"Tamaño de salida predefinido, admite hasta 1024×1024; por defecto square_hd.
square_hdsquareportrait_4_3portrait_16_9landscape_4_3landscape_16_9output_formatstringOpcionalPredeterminado: "png"Formato de la imagen de salida; por defecto png.
pngjpegnegative_promptstringOpcionalmaxLength 1024Especifica el contenido que debe excluirse de la imagen, solo tiene efecto en la variante berry.
reasoning_levelstringOpcionalPredeterminado: "medium"Controla el grado de razonamiento y expansión de la indicación antes de la generación; cuanto mayor sea el valor, más profundo será el procesamiento, y medium es relativamente más lento; por defecto medium.
lowmediumcallbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "krea-3/text-to-image",
  "input": {
    "prompt": "…",
    "variant": "berry",
    "image_size": "square_hd",
    "output_format": "png",
    "reasoning_level": "medium"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "krea-3/text-to-image",
input: {
"prompt": "…",
"variant": "berry",
"image_size": "square_hd",
"output_format": "png",
"reasoning_level": "medium"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "krea-3/text-to-image",
"input": {
"prompt": "…",
"variant": "berry",
"image_size": "square_hd",
"output_format": "png",
"reasoning_level": "medium"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 BRIA Eraser Bria $0.058 /imagen
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Ideogram V4.5 Ideogram $0.011 /imagen
-
 Seedream 4.5 ByteDance $0.045 /imagen
-
 851 Labs Background Remover 851 Labs $0.002 /imagen
-
 Recraft Creative Upscale Recraft $0.357 /imagen
-
 Seedream 5.0 ByteDance $0.025 /imagen
-
 FIBO 1.5 Bria $0.058 /imagen
-
 Krea 2 Medium Turbo Krea $0.021 /imagen
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 Nano Banana 2 Google $0.036 /imagen