
Alibaba
Qwen Image 3.0
qwen-image-3.0/text-to-image
Modelo de generación y edición de imágenes de tercera generación de Alibaba, especializado en maquetación densa y renderizado de texto multilingüe con prompts largos, y compatible con la edición mediante imágenes de referencia
Probar qwen-image-3.0/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image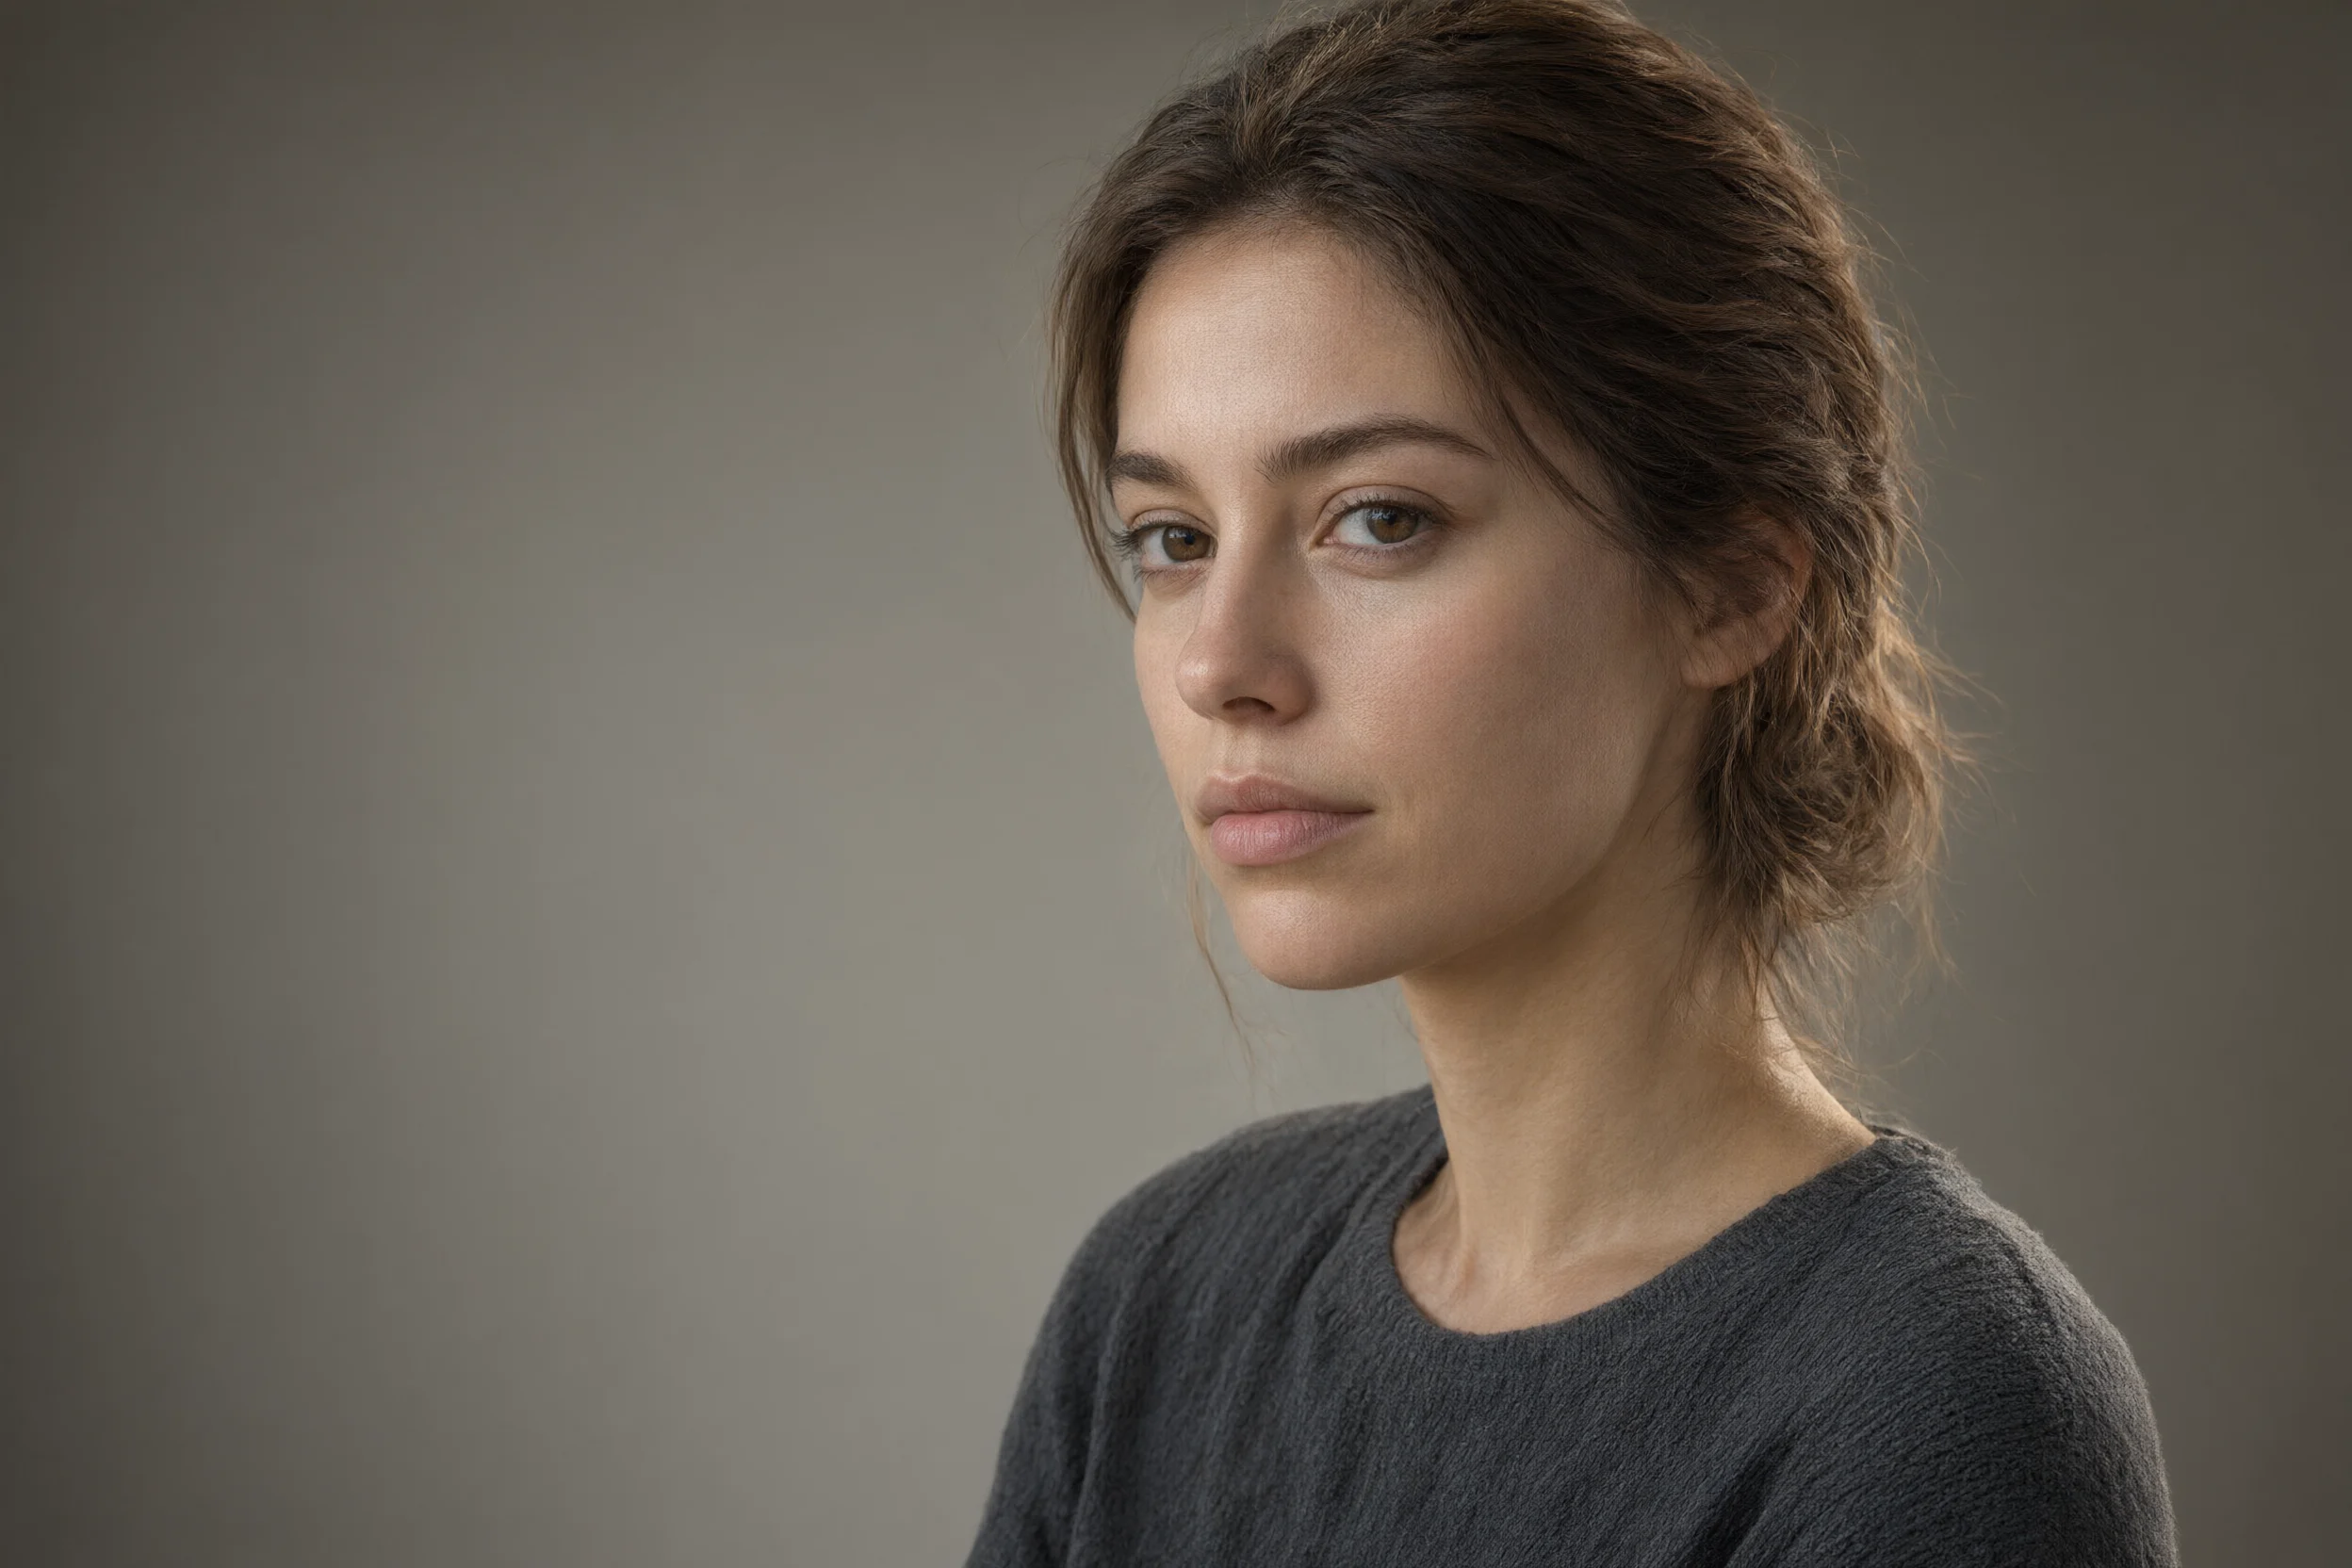
Demostración de doble estilo de retrato con Qwen-Image-3.0: realismo y artisticidad
Estilo Retrato y fotografía · Fotorrealismo · Texto a imagen
Prompt
Retrato en primer plano de una mujer joven de estilo realista, de unos treinta años, con el rostro de tres cuartos y ligeramente girado hacia la izquierda, luz suave de ventana procedente del lado derecho de la cámara, con sutiles reflejos de contorno en los pómulos y el borde de la línea del cabello, textura natural de la piel, poros visibles, vello fino y suave y mechones de cabello individuales claramente distinguibles bajo la luz, expresión serena, labios relajados, maquillaje muy ligero, vestida con un top de punto de color gris carbón liso, poca profundidad de campo, fondo de estudio fotográfico gris cálido suavemente desenfocado, aspecto de lente de 85 mm, luz de transición suave, colores naturales de baja saturación, gran detalle en los ojos y las cejas, sin retoque intensivo, composición horizontal 16:9, figura situada en la línea de los tercios del lado derecho del encuadre
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
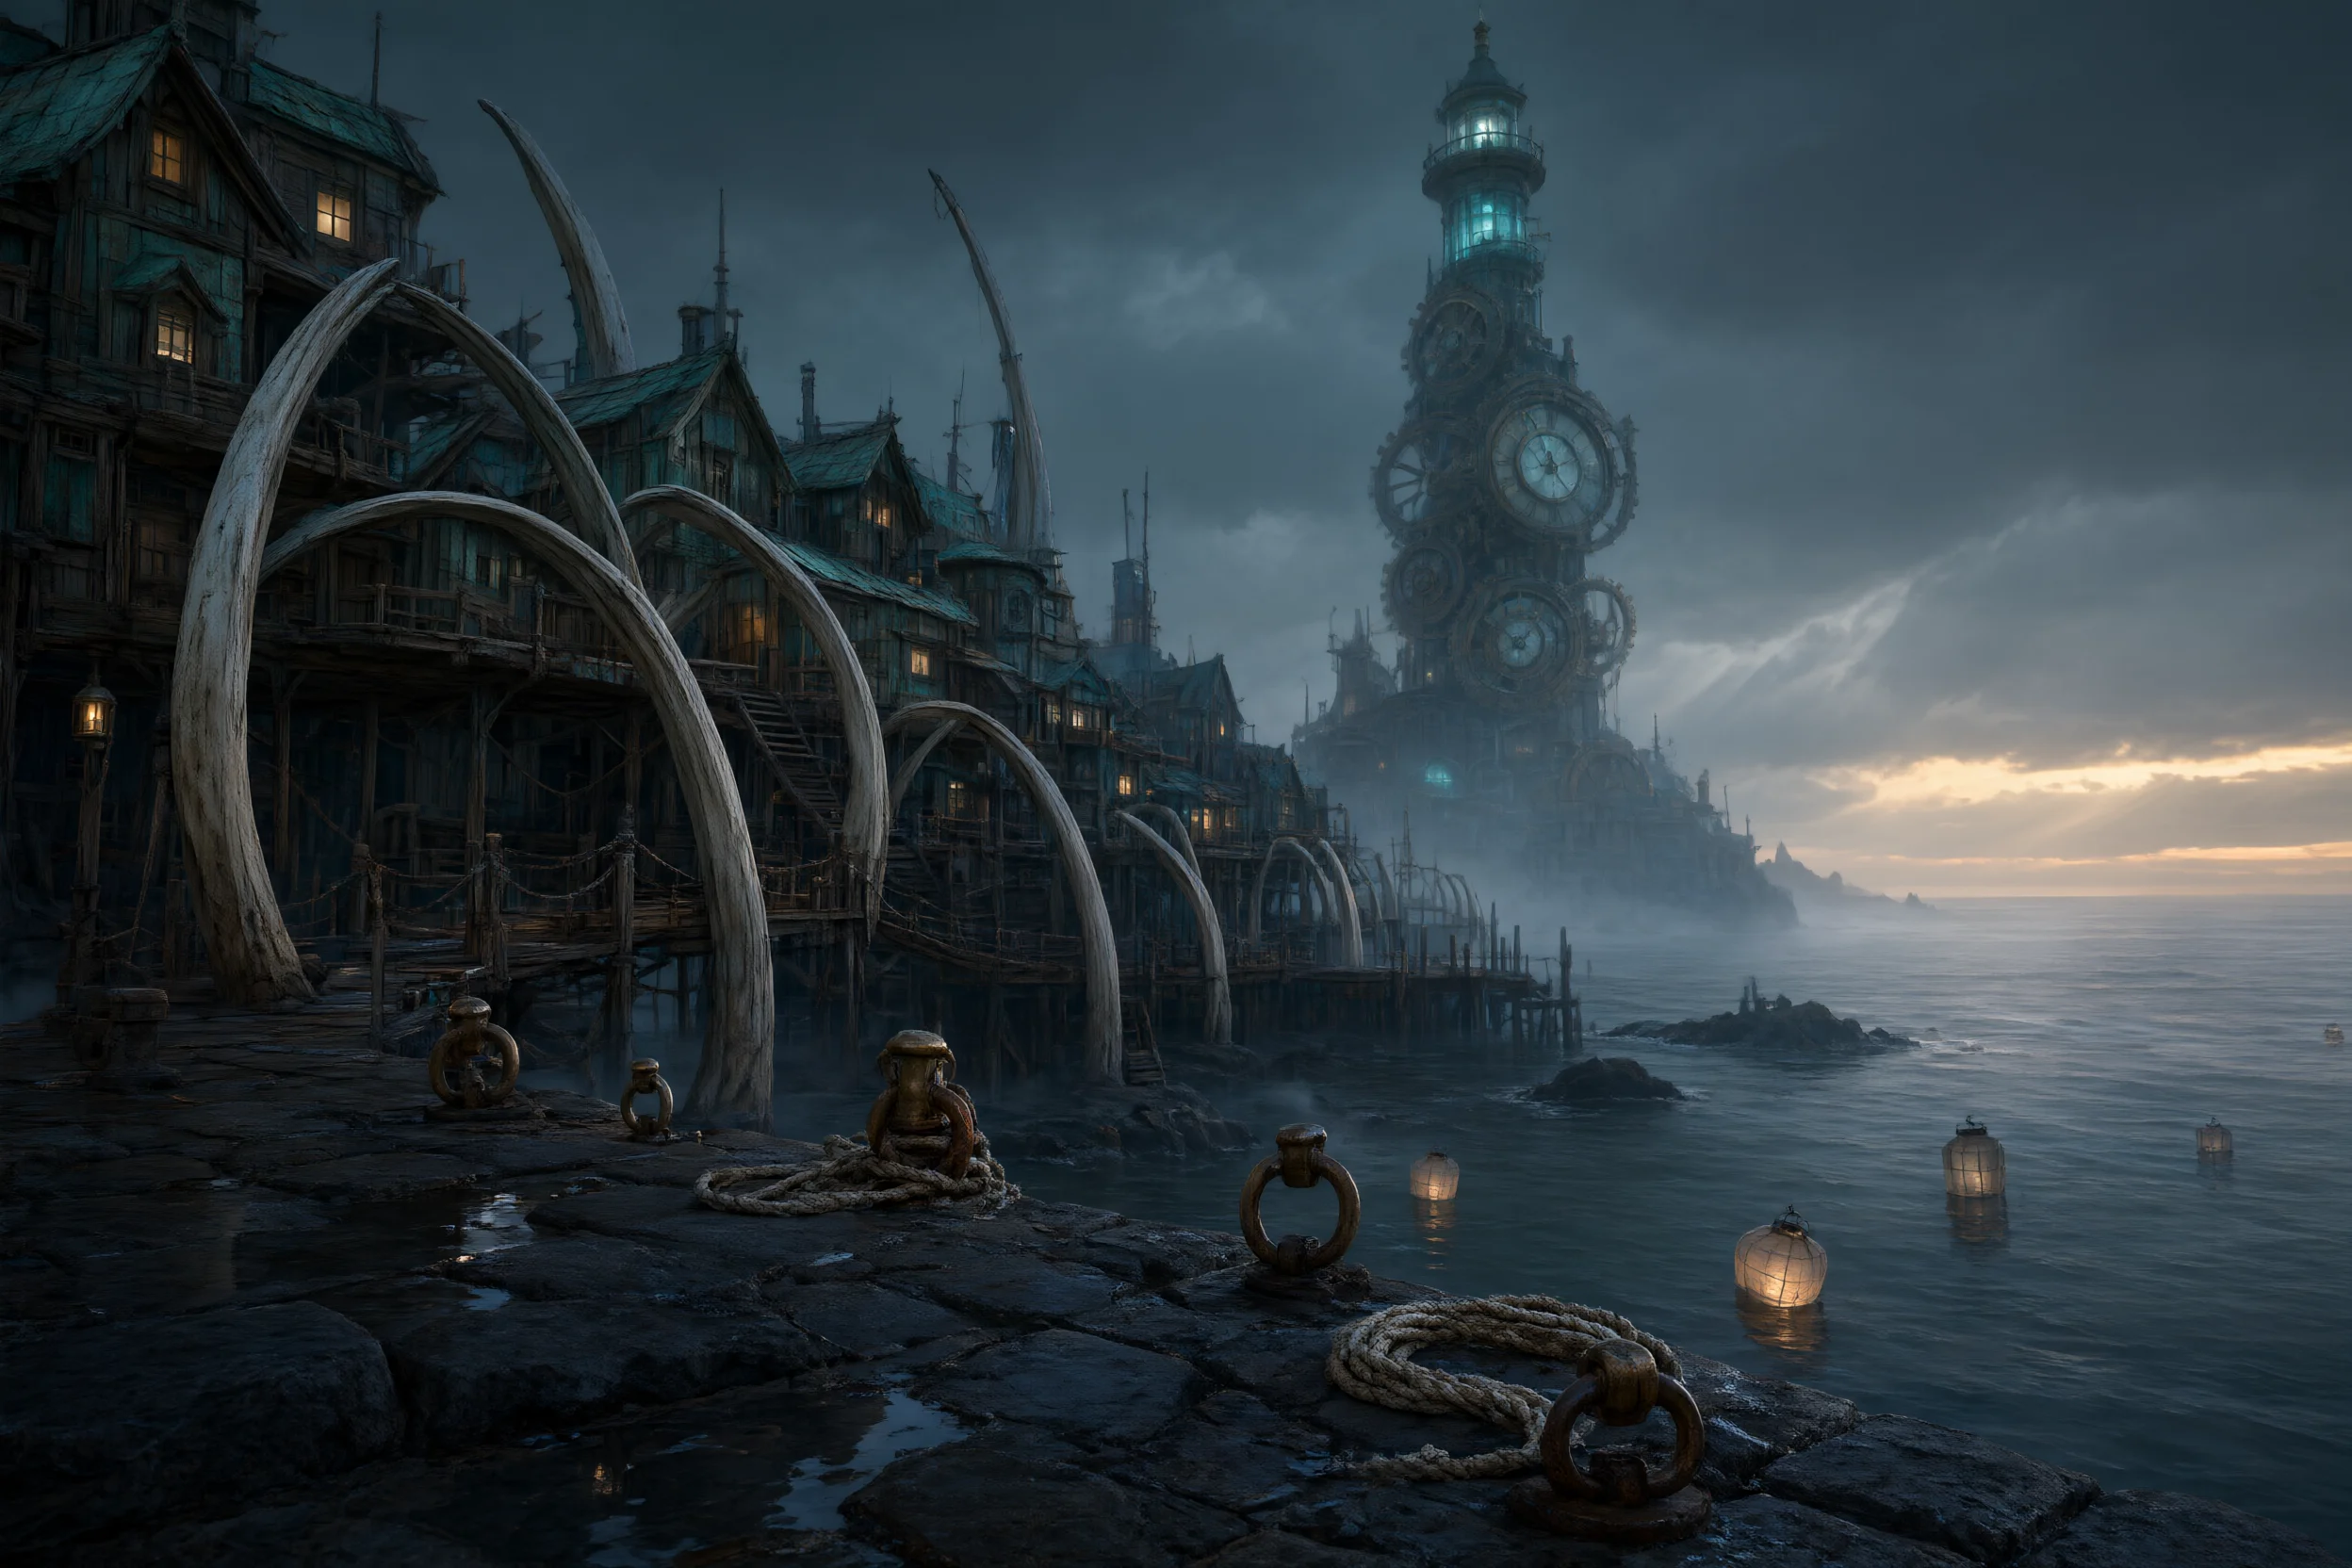
qwen-image-3.0 概念 artística de escena: exploración visual de la atmósfera del worldbuilding
Estilo Arte conceptual · Construcción del mundo · Cinematográfico
Prompt
Un fotograma clave de concept art gran angular con sensación cinematográfica que representa un mundo llamado Puerto de la Memoria de las Mareas, ambientado en la hora azul justo después de una tormenta. Primer plano: mojados bloques de muelle de basalto negro, con charcos poco profundos que devuelven reflejos, anillas de amarre de latón oxidado, cuerdas enrolladas cubiertas de costras de sal y varias linternas de papel flotantes medio hundidas en el agua. Plano medio: una hilera de casas curvas sobre pilotes, construidas con madera de barco reciclada y planchas de cobre oxidado, sostenidas por enormes arcos de costillas de ballena que se extienden sobre pasarelas estrechas; pequeñas ventanas dejan escapar una luz cálida que sugiere que están habitadas; escaleras de madera y puentes de cuerda conectan los distintos niveles. Fondo: una enorme torre con forma de faro, formada por engranajes apilados de relojes de marea y cisternas de vidrio, que emite un tenue resplandor cian y se alza desde la superficie tranquila de un mar gris, mientras las nubes de tormenta lejanas se abren en el horizonte en una fina franja de luz ámbar. Atmósfera: niebla marina baja que rueda entre los edificios, llovizna fina, luz volumétrica que atraviesa la niebla desde la derecha, una paleta de azules verdosos fríos y azul pizarra con acentos contenidos de ámbar, etalonaje cinematográfico desaturado y una sutil aberración cromática en los bordes de la imagen. Estilo: realismo pictórico fusionado con diseño conceptual arquitectónico, alta fidelidad de materiales en la piedra húmeda, la veta de la madera desgastada y el metal oxidado, una profundidad de campo suave que mantiene nítido el plano medio y un espacio negativo ultradetallado en el cielo para facilitar la maquetación de texto posterior. Composición en 16:9, horizonte en el tercio inferior y las líneas guía de la pasarela conduciendo la mirada hacia la torre.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
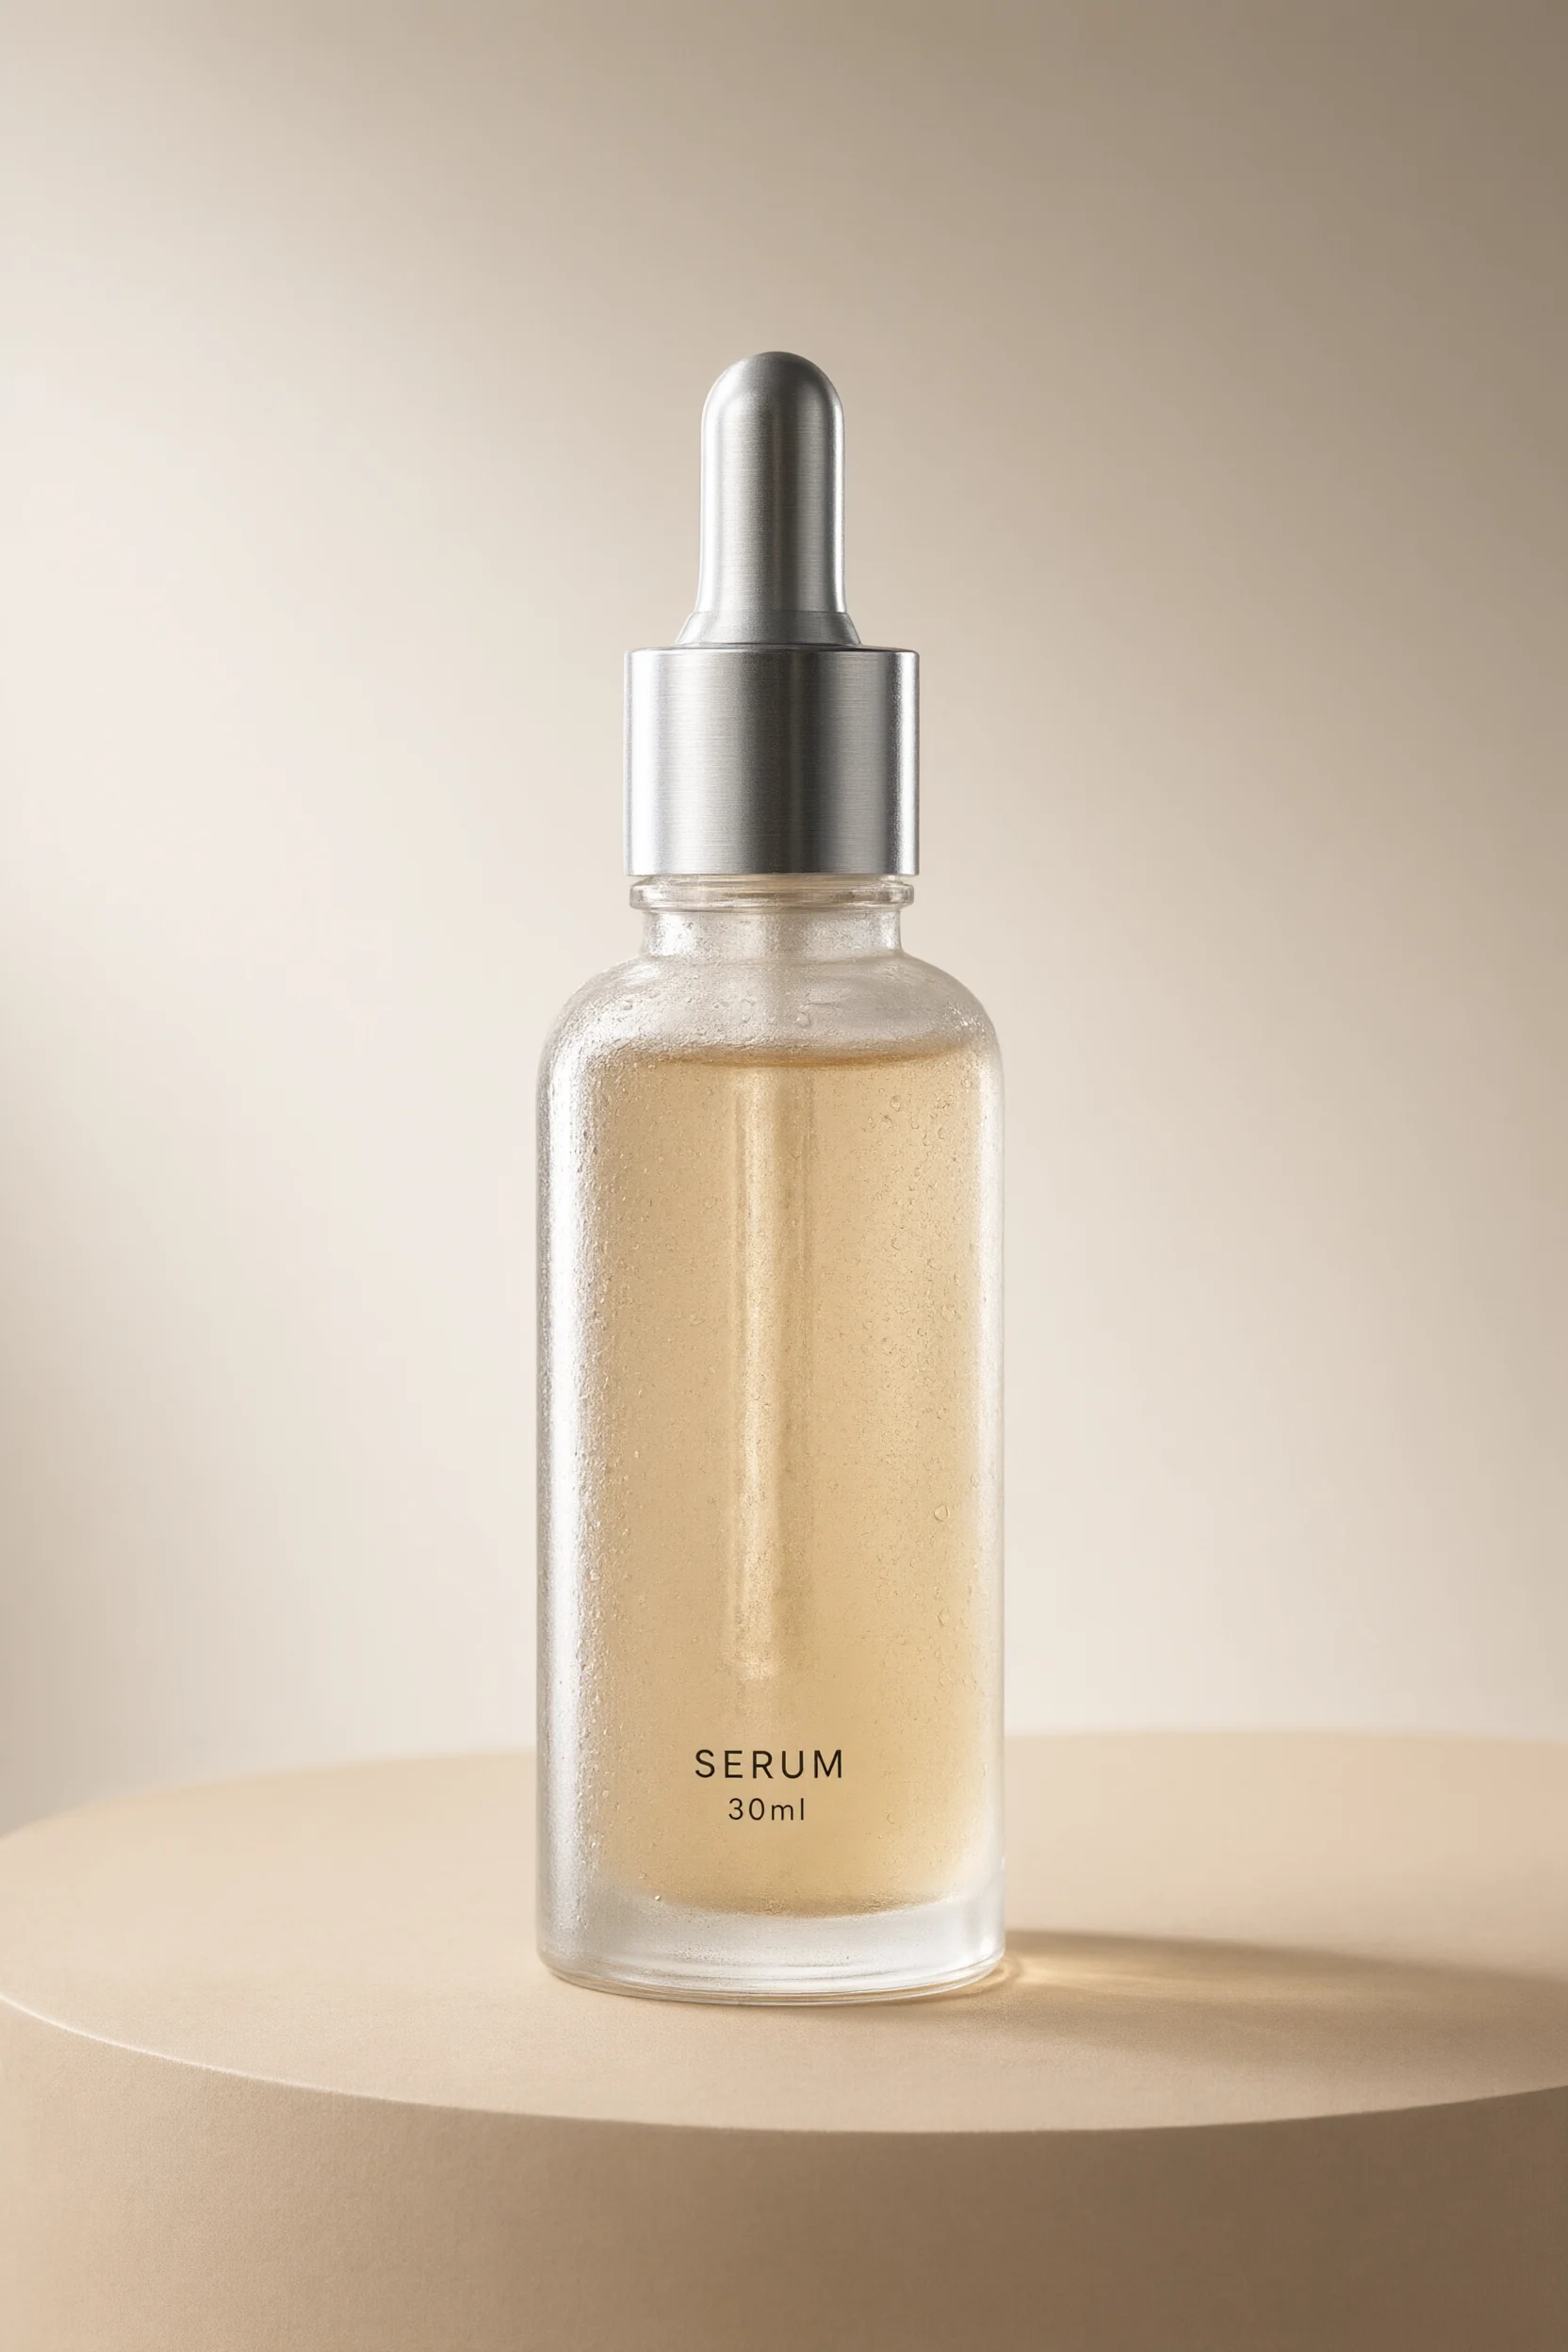
Calidad de fotografía de producto de nivel e-commerce: ejemplos de generación de imágenes con Qwen-Image-3.0
Estilo Imagen de producto · ecommerce · Iluminación de estudio
Prompt
Fotografía de producto de estudio de un único frasco de sérum facial de vidrio esmerilado, con tapón cuentagotas de aluminio cepillado, colocado centrado sobre una plataforma de exhibición mate de color beige cálido, con un fondo de degradado suave de color crema a gris parduzco claro. Iluminación de estudio de tres puntos: un softbox grande en la parte superior izquierda forma un reflejo limpio y alargado en el borde izquierdo del vidrio, el lado derecho se complementa con una luz de contorno sutil en el perfil, y la luz de relleno suave conserva el detalle de las sombras. En la superficie del vidrio se aprecian microgotas de condensación, el líquido presenta un tono ámbar delicado y la base del frasco muestra el grosor real del vidrio y el efecto de refracción. El frasco lleva una etiqueta minimalista muy pequeña, impresa con una tipografía sans serif sencilla que dice "SERUM 30ml", perfectamente horizontal y claramente legible. Profundidad de campo reducida, con la calidad de un objetivo macro de 85 mm, desenfoque suave hacia el fondo, sin apilamiento de objetos, con abundante espacio negativo a la derecha para superponer texto. Calidad de catálogo de e-commerce comercial, enfoque nítido en el tapón y el hombro del frasco, colorimetría neutra, materiales de alta fidelidad, renderizado realista como una fotografía.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
qwen-image-3.0/text-to-image per image
| Precio unitario | $0.0358 |
|---|
Descripción general
La vía de texto a imagen qwen-image-3.0 es el modelo de generación de imágenes de tercera generación de la serie Qwen de Alibaba, orientado a escenarios de desarrollo que requieren que las imágenes transporten información real. Acepta prompts de hasta 18000 caracteres y es experto en generar infografías, maquetas de periódico, bocetos conceptuales de UI, cuadrículas de productos y otras composiciones densas en elementos y con texto. Admite dos niveles de resolución, 1K y 2K, ocho relaciones de aspecto, salida en PNG/JPEG y semilla aleatoria, lo que lo convierte en una herramienta productiva para materiales de diseño, prototipos de interfaz y recursos de marketing.
Puntos clave
- Prompts largos que soportan maquetas complejas: el límite de 18000 caracteres permite restringir en una sola descripción el diseño de múltiples bloques, los elementos y el contenido textual.
- Composición y texto orientados a lo visual informativo: optimiza especialmente la maquetación densa, los cuerpos de letra pequeños y la representación multilingüe, acercando las maquetas e interfaces generadas a recursos directamente utilizables.
- Especificaciones de salida controlables: resolución, relación de aspecto, formato de archivo y semilla aleatoria configurables; junto con el prompt negativo y la optimización automática del prompt, facilitan la producción por lotes de imágenes con un estilo coherente.
Capacidades
Generación de imágenes complejas a partir de textos largos: un solo prompt puede alcanzar los 18000 caracteres, detallando composición, estilo y jerarquía informativa, lo que reduce el coste de complementar el prompt en varias rondas.
Maquetas e interfaces con texto denso: adecuado para generar infografías, diseños de periódico, carteles y conceptos de UI, donde conviven elementos y texto, produciendo resultados más cercanos a materiales de trabajo reales que a imágenes puramente estéticas.
Control preciso de las especificaciones de salida: resolución seleccionable de 1K o 2K, ocho relaciones de aspecto de 1:1 a 21:9, formato PNG o JPEG, y reproducción o ajuste fino de los resultados mediante semilla aleatoria.
Mejora del prompt y restricciones negativas: prompt_extend activado por defecto completa y optimiza automáticamente el prompt; negative_prompt sirve para excluir elementos no deseados y mejorar el control de la imagen generada.
Casos de uso
- Generación de materiales de maquetación para equipos de diseño y contenido: se introducen los textos y la descripción del diseño de infografías, maquetas de periódico o carteles, y se obtienen imágenes utilizables como referencia de maquetación o como ilustración para publicar.
- Bocetos conceptuales de UI para equipos de producto y front-end: se describe con prompts la estructura de interfaces web, de juegos o de transmisión en vivo para generar imágenes conceptuales destinadas a debates de prototipos de alta fidelidad y revisiones de diseño.
- Imágenes de producto y marketing para operaciones de e-commerce: a partir de la información del producto y los requisitos de exhibición, se generan cuadrículas de productos y recursos de marketing para borradores de páginas de detalle y páginas de campaña.
- Ilustraciones para contextos educativos y documentales: se generan materiales con texto e imagen combinados o ilustraciones para documentos según el contenido explicativo, como complemento visual de materiales didácticos, páginas descriptivas y documentación interna.
Limitaciones y recomendaciones de selección
Esta vía solo admite texto a imagen; para modificar una imagen a partir de una referencia hay que usar la vía de imagen a imagen de la misma familia. La información sobre las capacidades del modelo proviene principalmente de los anuncios del fabricante y de páginas de exhibición de terceros, y carece de evaluaciones independientes públicas, por lo que antes de lanzarlo en producción conviene validarlo con una muestra pequeña usando los prompts del propio negocio. Los prompts largos y las maquetas con texto denso exigen una descripción muy precisa; el resultado depende de la densidad de maquetación y del idioma, por lo que se recomienda combinar la semilla aleatoria con varias generaciones y seleccionar los resultados. Si solo se necesitan ilustraciones de estética convencional, se puede usar un modelo de texto a imagen más ligero para controlar costes.
Novedades
Ver el registro de cambios →- Nuevo modelo Nuevo modelo disponible: qwen-image-3.0-pro/text-to-image
- Nuevo modelo Lanzamiento del modelo de imagen a imagen qwen-image-3.0-pro
- Nuevo modelo Se añaden qwen-image-3.0/text-to-image…
Preguntas frecuentes
Ver todas las preguntas →-
¿Cuántas imágenes de referencia admite la edición de imágenes de Qwen Image 3.0?
Admite de 1 a 3 imágenes de referencia. Se requiere al menos una; el campo de la API es input.image_urls.
-
¿Cuál es la diferencia entre la edición de imágenes de la versión estándar y la Pro?
La versión estándar prioriza un menor costo y una iteración rápida; la Pro es más adecuada para el reemplazo preciso de texto, materiales complejos y el diseño final.
-
¿Cómo se facturan 1K, 2K y las imágenes de referencia?
1K y 2K utilizan el mismo nivel de salida, y cada imagen de referencia tiene un cargo adicional; el importe concreto se rige por el precio en tiempo real de esta página.
-
¿Cómo reducir la deriva del sujeto, el diseño o el texto?
En el Prompt, enumera por separado el contenido que se va a cambiar y el sujeto, el texto, la posición, los materiales, el encuadre y la iluminación que deben conservarse; cuando necesites texto exacto, escribe el texto objetivo entre comillas.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: qwen-image-3.0/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para qwen-image-3.0/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria utilizada para controlar la aleatoriedad del resultado generado; debe ser un número entero. Con la misma semilla y el resto de parámetros idénticos se pueden reproducir resultados similares; si no se envía, el servidor la genera de forma aleatoria.
promptstringObligatoriominLength 1maxLength 18000Prompt positivo: describe con texto el contenido, el estilo y la composición de la imagen deseada; es la entrada principal de la generación de imágenes a partir de texto.
resolutionstringOpcionalPredeterminado: "1K"Nivel de resolución de salida; especifica mediante una cadena el nivel de nitidez de la imagen generada. Por defecto, 1K.
1K2Kaspect_ratiostringOpcionalPredeterminado: "1:1"Relación de aspecto de la imagen de salida, especificada como una cadena de proporción. Por defecto, 1:1.
1:13:22:34:33:416:99:1621:9output_formatstringOpcionalPredeterminado: "png"Formato de archivo de la imagen generada, especificado como una cadena. Por defecto, png.
pngjpegprompt_extendbooleanOpcionalPredeterminado: trueIndica si se optimiza automáticamente el prompt; valor booleano. Al activarlo, el servidor amplía y mejora el prompt. Por defecto, true.
negative_promptstringOpcionalPredeterminado: ""maxLength 500Prompt negativo: describe el contenido que no se desea que aparezca en la imagen. Por defecto, una cadena vacía indica que no se aplica ninguna restricción de exclusión.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-3.0/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-3.0/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 FLUX 3 Image Black Forest Labs $0.041 /imagen
-
 Qwen Image 2.0 Alibaba $0.042 /imagen
-
 851 Labs Background Remover 851 Labs $0.002 /imagen
-
 Recraft V4.1 Recraft $0.010 /imagen
-
 BRIA Eraser Bria $0.058 /imagen
-
 Ideogram V4 Ideogram $0.050 /imagen
-
 Ideogram V3 Character Ideogram $0.090 /imagen
-
 Krea 3 Krea $0.036 /imagen
-
 Recraft Crisp Upscale Recraft $0.004 /imagen
-
 Nano Banana Pro Google $0.057 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 Wan 2.7 Image Alibaba $0.035 /imagen
Mismo proveedor
-
 Wan 3.0 Video Alibaba $0.040 /segundo
-
 HappyHorse 1.1 Alibaba $0.160 /segundo
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
- Wan 2.7 Image Alibaba $0.035 /imagen
-
 Qwen Image 2.1 Alibaba $0.020 /imagen
-
 Wan 2.7 Video Alibaba $0.100 /segundo
- Qwen Image 2.0 Alibaba $0.042 /imagen
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caracteres
-
 Z-Image Alibaba $0.008 /imagen