
Alibaba
Qwen Image 3.0
qwen-image-3.0-pro/text-to-image
Modelo de generación y edición de imágenes de tercera generación de Alibaba, especializado en maquetación densa y renderizado de texto multilingüe con prompts largos, y compatible con la edición mediante imágenes de referencia
Probar qwen-image-3.0-pro/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image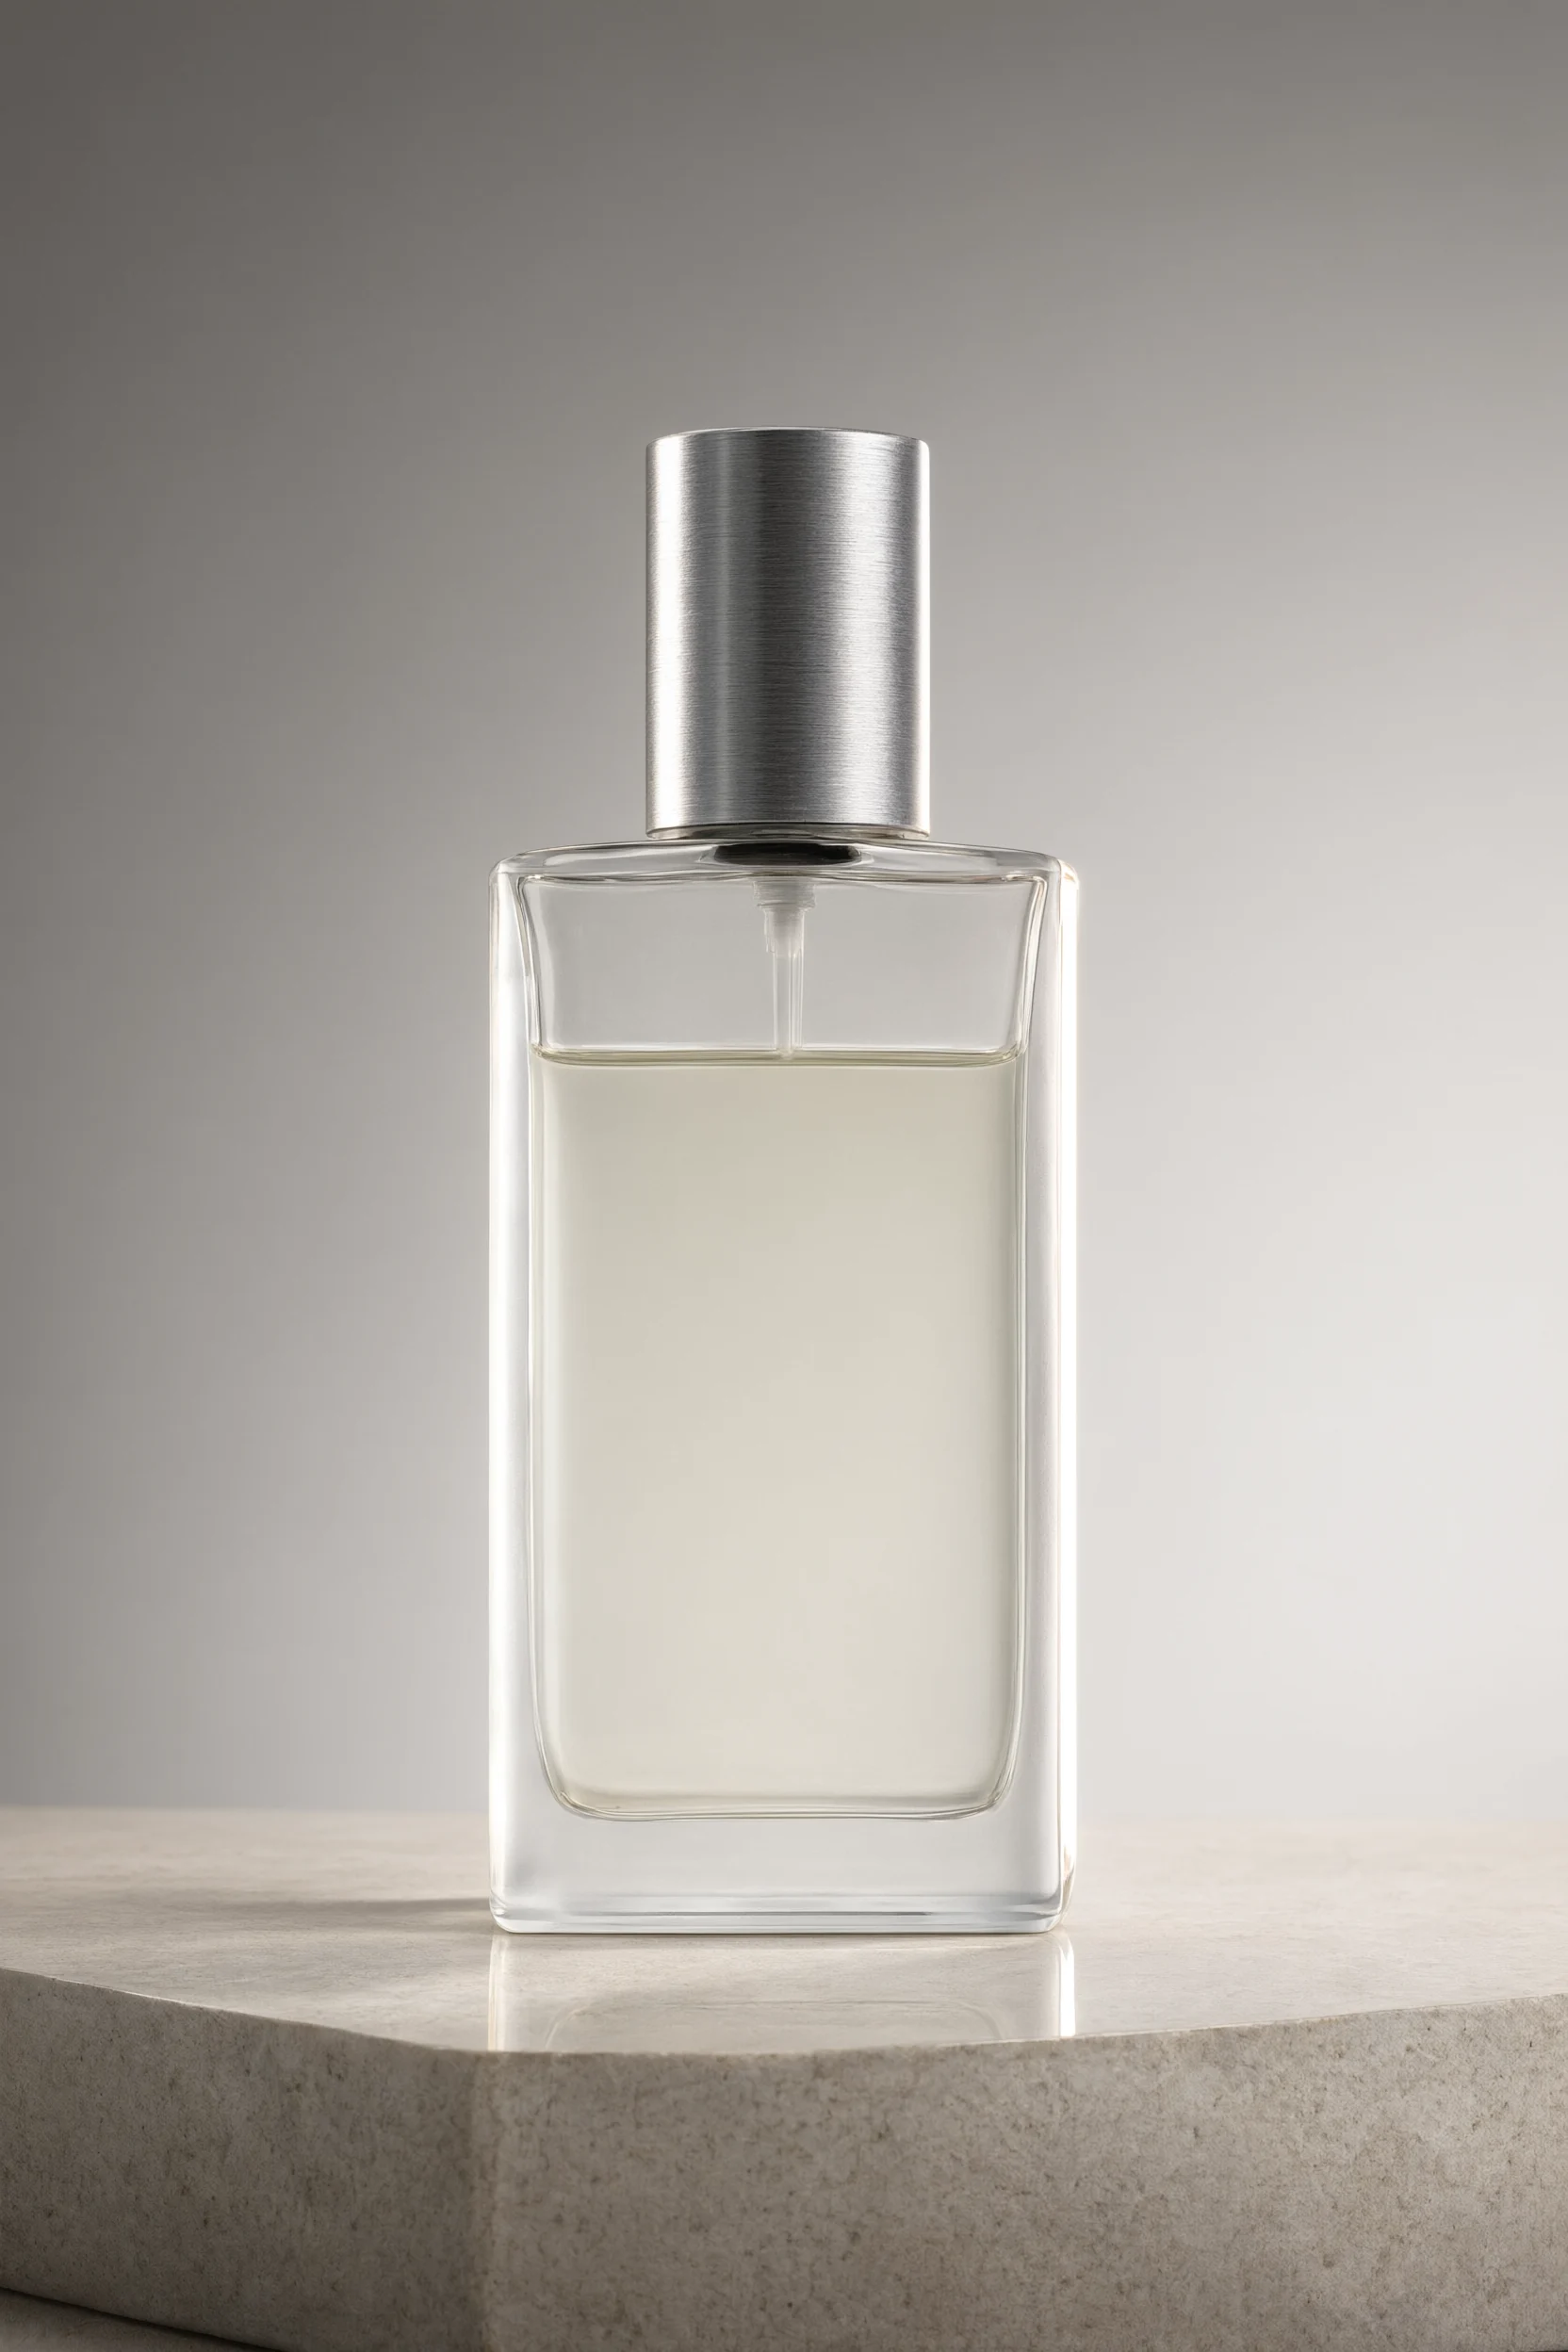
Fotografía de producto de nivel e-commerce: estructura del prompt y calidad de imagen
Estilo Imagen de producto · ecommerce · Iluminación de estudio
Prompt
Fotografía de producto e-commerce: un frasco de perfume de vidrio mate con tapón de aluminio cepillado, centrado sobre un pedestal de piedra gris cálido claro. Esquema de iluminación de estudio: una softbox grande como luz principal desde arriba a la izquierda crea un suave brillo vertical a lo largo del borde izquierdo del frasco, una luz de contorno estrecha a la derecha separa la silueta del frasco del fondo degradado sin costuras, y un tenue relleno de reflexión frontal mantiene legible la zona de la etiqueta. Sobre la superficie de piedra pulida se aprecian una sombra de contacto y un reflejo ligero y controlado. Capturado con objetivo macro de 85 mm y apertura f/8, el producto queda completamente enfocado, con distorsión mínima y una línea de visión ligeramente por encima de la base del frasco. Tonalidades neutras de baja saturación, con un único acento de color desaturado y un espacio limpio en la parte superior para maquetar texto. Renderizado de materiales fotorrealista: el líquido transparente presenta una refracción correcta, el grosor del vidrio es delicado, la superficie metálica muestra una microtextura cepillada y no hay polvo en las superficies. Composición horizontal 16:9, estética de catálogo comercial, alto rango dinámico, sin texto, sin logotipos.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
qwen-image-3.0-pro/text-to-image per image
| Especificaciones | Precio unitario |
|---|---|
| 1K | $0.0497 |
| 2K | $0.0993 |
Introducción y posicionamiento
Qwen Image 3.0 Pro es un modelo de texto a imagen de la serie Qwen de Alibaba, centrado en imágenes de producción que transmiten información real: una sola imagen puede organizar infografías, diseños de páginas de periódico, bocetos conceptuales de interfaces, cuadrículas de productos y otros contenidos densos, además de renderizar texto multilingüe con una maquetación correcta. Está dirigido a desarrolladores que necesitan convertir de forma estable prompts largos en activos visuales utilizables, y es adecuado para la generación masiva de imágenes en aplicaciones de diseño, contenido, comercio electrónico y educación.
Aspectos destacados
- Los prompts largos admiten maquetaciones complejas: el límite del prompt es de 18000 caracteres, suficiente para describir composiciones de varios bloques, jerarquías y los textos de cada bloque.
- El renderizado de texto y maquetación es clave: orientado a la generación de imágenes con elementos densos y texto, reduce el retrabajo de añadir texto y maquetar después de generar la imagen.
- Parámetros controlables para las necesidades habituales de generación: admite relación de aspecto, resolución 1K/2K, formato png/jpeg, prompt negativo y reproducción mediante seed.
Descripción de capacidades
Generación con prompts de texto largo: la descripción completa de la imagen se pasa mediante el campo prompt, que admite descripciones extensas de maquetación y elementos; una sola llamada produce directamente la imagen final y reduce el ensamblaje por pasos.
Resolución y relación de aspecto controladas: resolution permite elegir 1K o 2K, y aspect_ratio cubre 1:1, 3:2, 2:3, 4:3, 3:4, 16:9, 9:16 y 21:9, lo que facilita generar directamente el tamaño correspondiente a cada ubicación de publicación.
Optimización automática del prompt y restricciones negativas: prompt_extend está activado por defecto y puede completar y optimizar automáticamente el prompt; negative_prompt sirve para excluir contenido no deseado y mejorar la estabilidad de la generación.
Reproducción con semilla aleatoria: incluye el parámetro seed; introducir una semilla entre 0 y 2147483647 permite reproducir el mismo resultado, lo que facilita la comparación de ajustes y la estabilidad de los flujos por lotes.
Salida directa en formato: output_format admite png y jpeg, de modo que se elige directamente el formato de archivo según el uso posterior y se evita un paso adicional de transcodificación.
Escenarios de aplicación
- Equipos de contenido: carteles y maquetaciones a partir de textos largos: se escriben el título, el cuerpo del texto y los requisitos de maquetación en el prompt para producir carteles o maquetaciones tipo periódico con texto, listos para publicación de contenido y materiales operativos.
- Desarrolladores de diseño: generación de bocetos conceptuales de interfaz: se generan conceptos de UI y esquemas de alta fidelidad en proporción 16:9 o 9:16 como referencia visual para revisiones de producto y reproducción en frontend.
- Operaciones de comercio electrónico: creación de imágenes de exhibición de productos: se generan cuadrículas de productos e imágenes de exhibición en 1:1 o 4:3 y, junto con una seed fija, se producen por lotes materiales de marketing con estilo uniforme.
- Ámbito educativo: materiales explicativos con texto e imágenes combinados: se describe la estructura del conocimiento con prompts largos y se generan imágenes explicativas con texto e imágenes en paralelo, para ilustrar cursos y materiales de formación.
Limitaciones y recomendaciones de elección
El modelo está orientado a la producción visual informativa, con elementos densos y texto en la imagen; no es la primera opción para ilustración o creación artística puramente estética. El prompt debe especificar con claridad la maquetación y los textos, lo que exige una buena capacidad de descripción; la composición compleja con múltiples imágenes de referencia queda fuera del alcance de esta ruta (esta ruta solo cubre texto a imagen). El resultado depende de la densidad de maquetación y del idioma; antes de generar por lotes en producción conviene validar con muestras pequeñas y controlar la estabilidad mediante una seed fija y prompts negativos.
Novedades
Ver el registro de cambios →- Nuevo modelo Nuevo modelo disponible: qwen-image-3.0-pro/text-to-image
- Nuevo modelo Lanzamiento del modelo de imagen a imagen qwen-image-3.0-pro
- Nuevo modelo Se añaden qwen-image-3.0/text-to-image…
Preguntas frecuentes
Ver todas las preguntas →-
¿Cuántas imágenes de referencia admite la edición de imágenes de Qwen Image 3.0?
Admite de 1 a 3 imágenes de referencia. Se requiere al menos una; el campo de la API es input.image_urls.
-
¿Cuál es la diferencia entre la edición de imágenes de la versión estándar y la Pro?
La versión estándar prioriza un menor costo y una iteración rápida; la Pro es más adecuada para el reemplazo preciso de texto, materiales complejos y el diseño final.
-
¿Cómo se facturan 1K, 2K y las imágenes de referencia?
1K y 2K utilizan el mismo nivel de salida, y cada imagen de referencia tiene un cargo adicional; el importe concreto se rige por el precio en tiempo real de esta página.
-
¿Cómo reducir la deriva del sujeto, el diseño o el texto?
En el Prompt, enumera por separado el contenido que se va a cambiar y el sujeto, el texto, la posición, los materiales, el encuadre y la iluminación que deben conservarse; cuando necesites texto exacto, escribe el texto objetivo entre comillas.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: qwen-image-3.0-pro/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para qwen-image-3.0-pro/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria utilizada para controlar la aleatoriedad de la generación; su valor es un número entero y una misma semilla permite reproducir resultados de generación similares.
promptstringObligatoriominLength 1maxLength 18000Prompt positivo: describe mediante una cadena de texto el contenido, el estilo y la composición de la imagen deseada, y es la base principal para generar la imagen.
resolutionstringOpcionalPredeterminado: "1K"Nivel de resolución de salida: especifica mediante una cadena el nivel de resolución de la imagen generada; por defecto, 1K.
1K2Kaspect_ratiostringOpcionalPredeterminado: "1:1"Relación de aspecto (ancho/alto) de la imagen de salida, especificada como cadena; por defecto, 1:1.
1:13:22:34:33:416:99:1621:9output_formatstringOpcionalPredeterminado: "png"Formato de archivo de la imagen generada, especificado como cadena; por defecto, png.
pngjpegprompt_extendbooleanOpcionalPredeterminado: trueIndica si se optimiza automáticamente el prompt; valor booleano, por defecto true. Al activarlo, el prompt de entrada se amplía y optimiza automáticamente.
negative_promptstringOpcionalPredeterminado: ""maxLength 500Prompt negativo: describe mediante una cadena el contenido que no se desea que aparezca en la imagen; por defecto, cadena vacía.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0-pro/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-3.0-pro/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-3.0-pro/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Seedream 5.0 ByteDance $0.025 /imagen
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagen
-
 Ideogram V3 Character Ideogram $0.090 /imagen
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagen
-
 Grok Imagine Quality xAI $0.070 /imagen
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /imagen
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Recraft V4.1 Recraft $0.010 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 FASHN Tryon v1.6 FASHN $0.107 /imagen
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagen
-
 Qwen Image 2.1 Alibaba $0.020 /imagen
Mismo proveedor
-
 Wan 2.7 Image Alibaba $0.035 /imagen
-
 Wan 3.0 Video Alibaba $0.040 /segundo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Qwen Image 2.0 Alibaba $0.042 /imagen
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 Z-Image Alibaba $0.008 /imagen
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caracteres
- Qwen Image 2.1 Alibaba $0.020 /imagen
-
 HappyHorse 1.1 Alibaba $0.160 /segundo
- Qwen Image 3.0 Alibaba $0.036 /imagen