
ByteDance
Seedream 5.0
seedream-5.0-pro/text-to-image
Modelo de generación de imágenes de nivel de producción de ByteDance, compatible con búsqueda en internet y razonamiento lógico de varios pasos, salida en 4K y edición por ejemplos, ideal para crear imágenes de productos e infografías
Probar seedream-5.0-pro/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image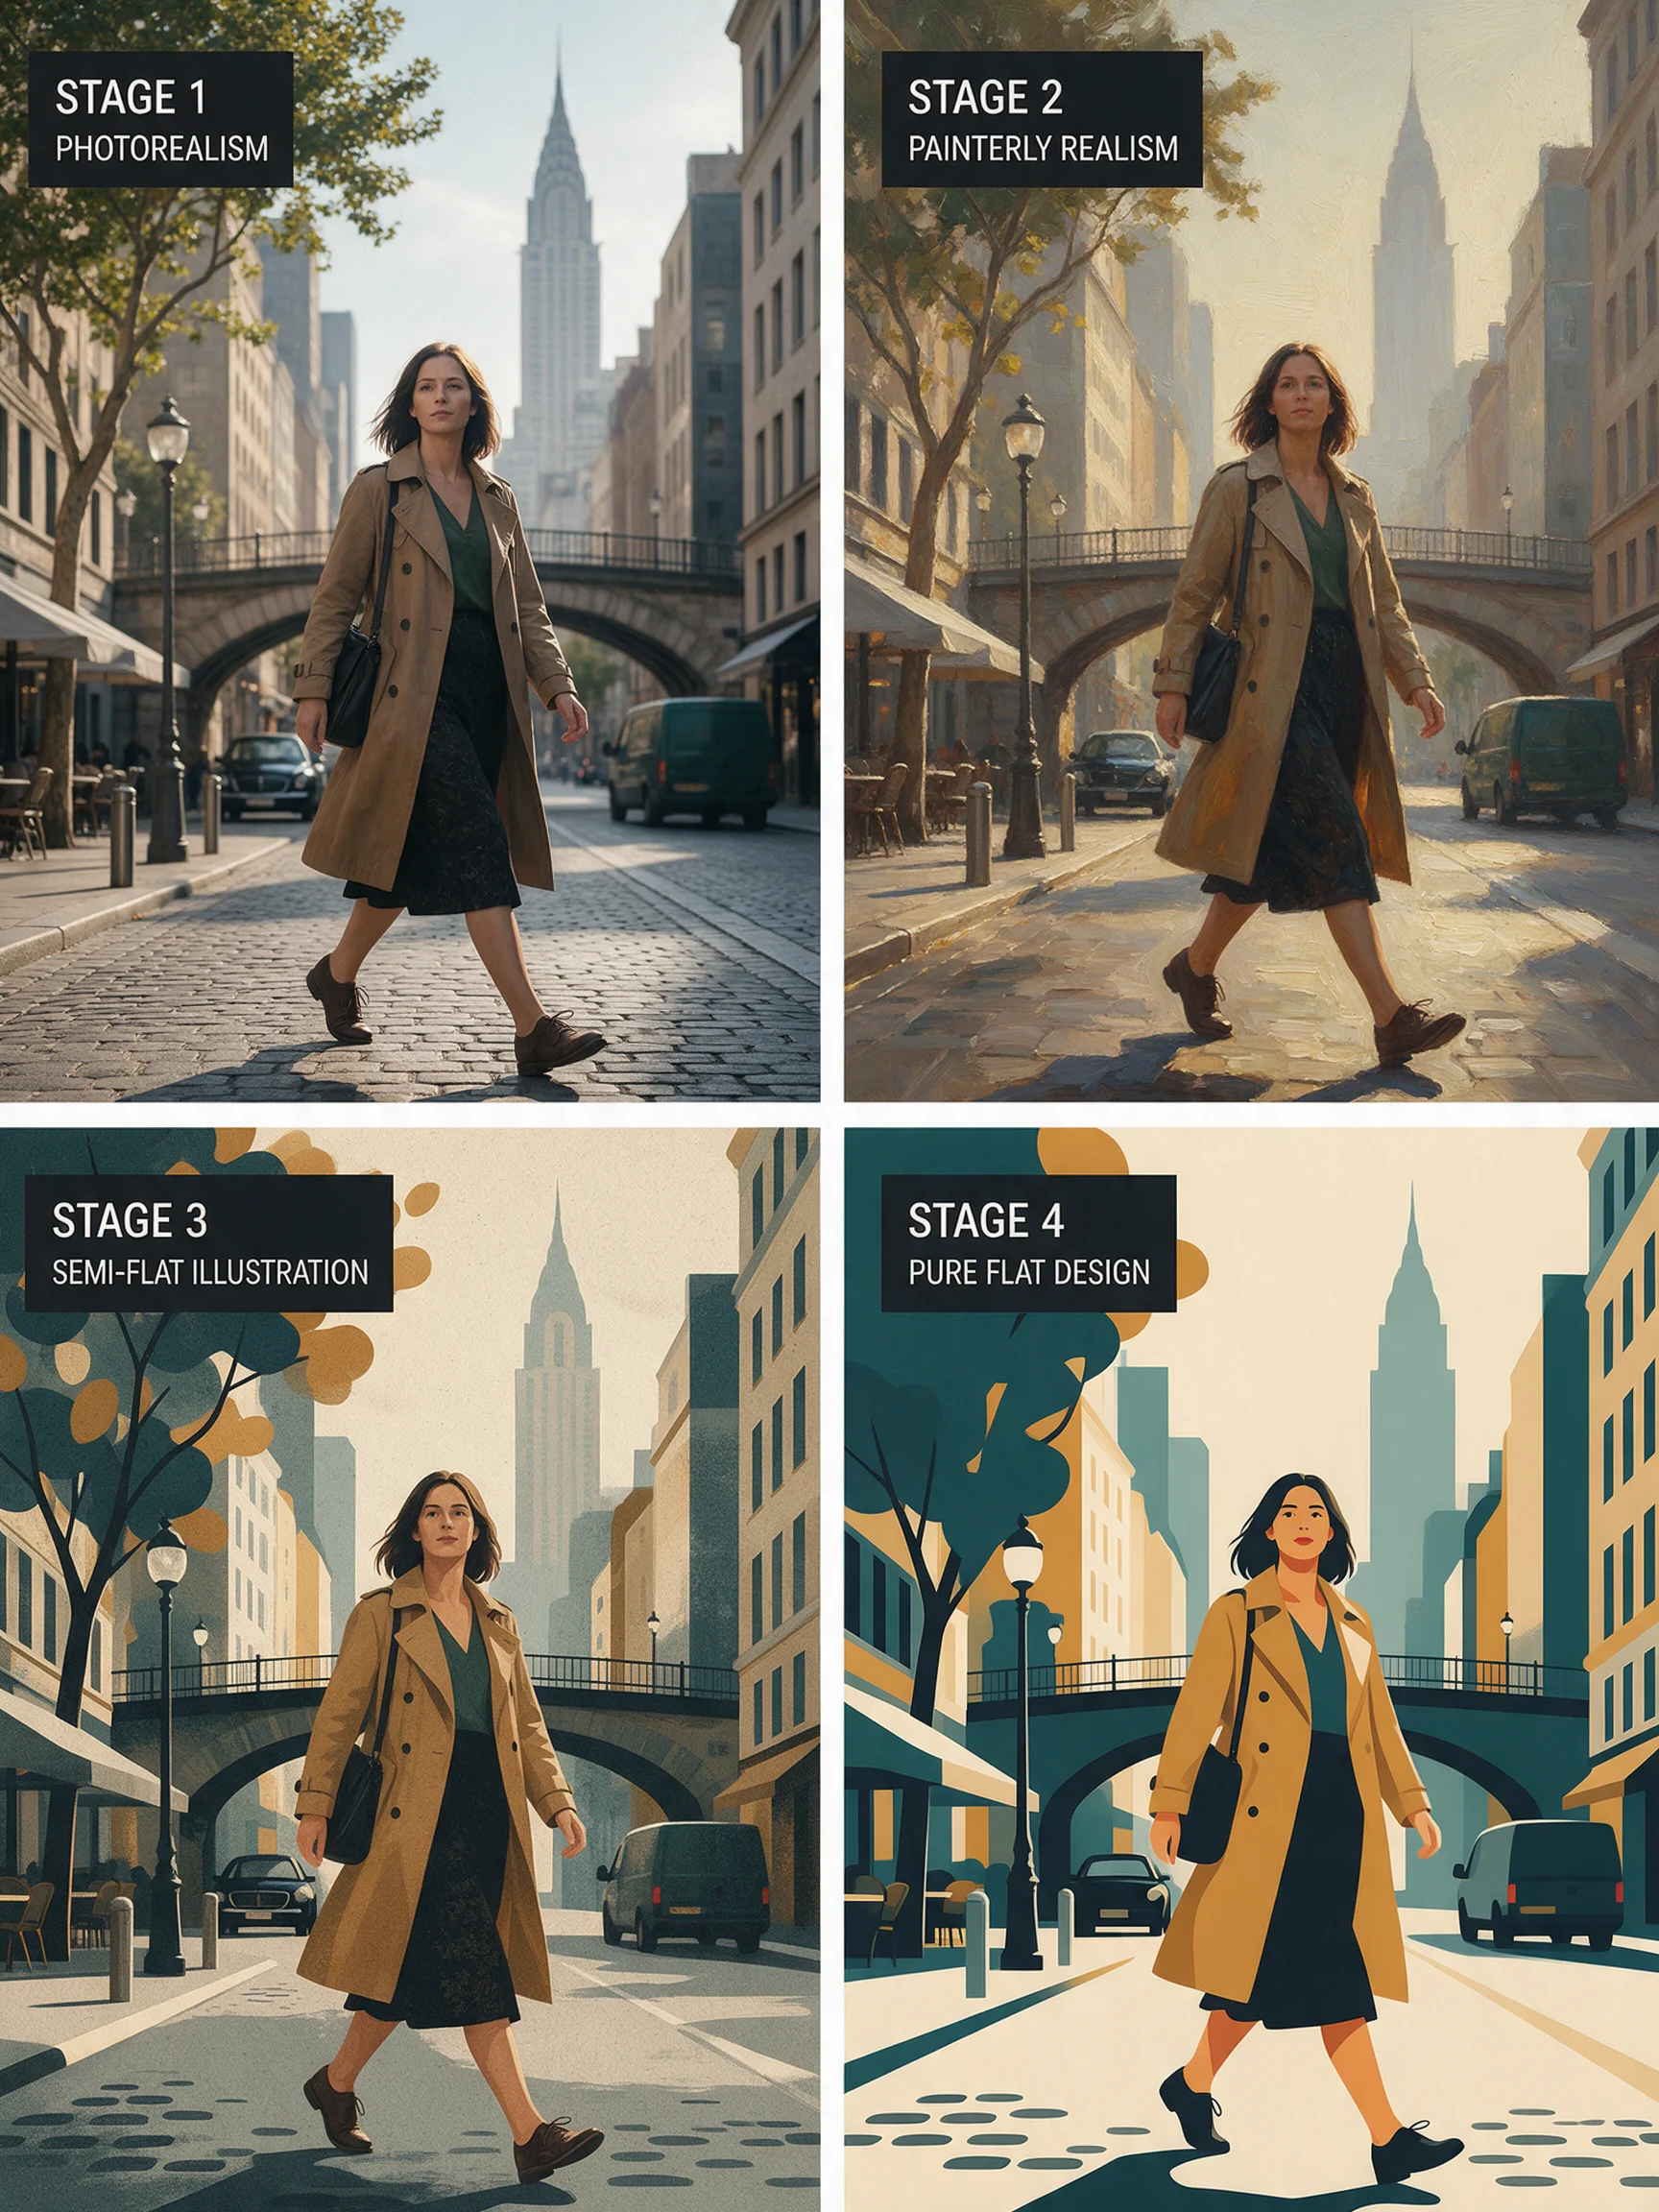
Del realismo al flat: comparación en cuatro niveles del espectro de estilos de ilustración
Estilo Ilustración · Estudio de estilo · Diseño plano
Prompt
Estudio del espectro de estilos en cuatro fases presentado sobre la misma composición: figura caminando en primer plano, calle urbana en plano medio, horizonte al fondo. Primera fase, realismo fotográfico: luz natural, textura de piel y tejido visibles, profundidad de campo real, grano de lente sutil. Segunda fase, realismo pictórico: misma escena, pero con pinceladas visibles, bordes suavizados, luz reflejada cálida y saturación ligeramente reducida. Tercera fase, ilustración semiflat: volumen simplificado, claroscuro a dos tonos, siluetas nítidas, paleta limitada compuesta por verde azulado suave, ocre y crema. Cuarta fase, diseño flat puro: bloques de color geométricos, sin degradados, formas de bordes duros, paleta flat audaz. Todas las fases mantienen una composición y una postura del sujeto coherentes, composición horizontal 3:2, calidad de imagen de referencia de dirección artística editorial.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
seedream-5.0-pro/text-to-image per image
| Especificaciones | Precio unitario |
|---|---|
| 1K | $0.050 |
| 2K | $0.100 |
Descripción general
Seedream 5.0 Pro es el modelo avanzado de texto a imagen de la serie Seedream 5.0 de ByteDance, invocado mediante la interfaz unificada de HiAPI.ai. Está orientado a desarrolladores que necesitan integrar la generación de imágenes en flujos de producción y, además de la calidad visual, hace hincapié en la precisión factual y lógica: admite búsqueda en línea en tiempo real, razonamiento de varios pasos y renderización de texto de alta densidad, y puede generar imágenes PNG/JPEG en resolución 1K o 2K con hasta 8 relaciones de aspecto habituales. Resulta adecuado para materiales de comercio electrónico, infografías y carteles multilingües con texto, entre otros escenarios que exigen alta precisión de contenido y composición.
Aspectos clave
- Integración de búsqueda y razonamiento en el proceso de generación: cuando la indicación (prompt) aborda temas de actualidad, puede buscar automáticamente información en la web y usarla en la generación, lo que reduce las desviaciones factuales.
- Renderización de texto de alta densidad y multilingüe: se ha optimizado específicamente la disposición del texto y la comprensión multilingüe, lo que permite abarcar escenas complejas del tipo infografía.
- Resolución y relación de aspecto seleccionables: admite dos niveles de resolución, 1K y 2K, y 8 relaciones de aspecto, lo que equilibra la iteración rápida y la salida de producto final.
- Capacidad para prompts largos: el límite del prompt es de 4000 caracteres, lo que facilita controlar estructuras y composiciones complejas mediante descripciones completas.
Descripción de capacidades
Generación de texto a imagen: basta con introducir una descripción de texto de entre 3 y 4000 caracteres para generar una imagen; cuanto más completa sea la indicación, mejor se podrá controlar la estructura y la relación entre los elementos de la escena.
Control de resolución y relación de aspecto: se puede elegir 1K (aprox. 2 MP) para iteración rápida o 2K (aprox. 4 MP, máximo 2048x2048) para piezas finales detalladas, y admite 8 relaciones que van de 1:1 a 21:9 para adaptarse a distintos formatos.
Selección del formato de salida: se puede elegir entre PNG y JPEG, lo que facilita la conexión directa con procesos posteriores de recorte, compresión o incorporación de materiales al archivo.
Alineación imagen-texto y comprensión de la estructura: según la documentación oficial, la versión Pro mejora la alineación imagen-texto y la coherencia estructural respecto a la generación anterior, por lo que resulta adecuada para tareas de generación que exigen precisión de composición.
Casos de uso
- Operaciones de comercio electrónico: generar la imagen principal a partir del texto de ventajas del producto: generar directamente la imagen promocional del producto con el título y la descripción de ventajas, y usar la salida directamente en la página de detalles o en materiales publicitarios.
- Equipos de diseño: carteles multilingües e infografías con texto: incluir en el prompt el texto y la disposición que se desean mostrar, generar un borrador del cartel o la infografía con texto y pasar después a la fase de retoque.
- Equipos de contenido: imágenes para temas de actualidad: cuando la indicación aborda temas de actualidad, el modelo busca información en la web, lo que sirve para imágenes de noticias o eventos que deben ajustarse al contexto actual.
- Desarrollo de producto: imágenes de relleno y bocetos visuales en lote: generar rápidamente bocetos en lote a resolución 1K, validar la composición y la dirección visual y pasar después a la salida en 2K.
Limitaciones y recomendaciones de selección
Este modelo solo admite texto a imagen, con un límite de entrada de un único prompt de texto, y no permite introducir imágenes de referencia para hacer imagen a imagen o edición por ejemplos; si se necesita edición de imágenes y transferencia de estilo, conviene elegir la vía image-to-image de la misma serie. La documentación oficial también reconoce que aún hay margen de mejora en la renderización de texto de grano más fino y en la consistencia de la edición a nivel de píxel, por lo que se recomienda revisar manualmente las imágenes con mucho texto de tamaño pequeño. Los prompts sensibles al tiempo activan la búsqueda en línea y la salida se ve influida por el contenido recuperado; en escenarios que exigen alta estabilidad de resultados, conviene sustituir las expresiones de actualidad por descripciones claras y coherentes.
Novedades
Ver el registro de cambios →- Nuevo modelo seedream-5.0-pro/image-to-image ya disponible
- Nuevo modelo Nuevo modelo disponible: seedream-5.0-pro/text-to-image
- Nuevo modelo Modelo seedream-5.0-lite/image-to-image ya disponible
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: seedream-5.0-pro/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para seedream-5.0-pro/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
promptstringObligatoriominLength 3maxLength 4000Texto de indicación que describe la imagen que se desea generar; su longitud debe estar entre 3 y 4000 caracteres.
resolutionstringObligatorioPredeterminado: "2K"Resolución de la imagen de salida. 1K (aprox. 2 MP) es adecuado para iteraciones rápidas; 2K (aprox. 4 MP, hasta 2048x2048) es adecuado para generaciones con mayor detalle. Valor predeterminado: 2K.
1K2Kaspect_ratiostringObligatorioPredeterminado: "1:1"Relación de aspecto de la imagen generada. Valor predeterminado: 1:1.
1:14:33:416:99:162:33:221:9output_formatstringOpcionalPredeterminado: "png"Formato de la imagen de salida. Valor predeterminado: png.
pngjpegcallbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "seedream-5.0-pro/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "output_format": "png"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "seedream-5.0-pro/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "png"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "seedream-5.0-pro/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "png"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Recraft Creative Upscale Recraft $0.357 /imagen
-
 FLUX.2 Black Forest Labs $0.035 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 Ideogram V4 Ideogram $0.050 /imagen
-
 Muse Image 1.0 Meta $0.015 per task
-
 GPT Image 2.5 OpenAI $0.017 /imagen
-
 Google Virtual Try-On Google $0.107 /imagen
-
 BRIA Eraser Bria $0.058 /imagen
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagen
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Qwen Image 2.1 Alibaba $0.020 /imagen
-
 Nano Banana 2 Lite Google $0.033 /imagen



