
Guide d'utilisation
Génération d'images ChatGPT : ce qui a changé et comment la construire par programmation
Analyse détaillée des dernières fonctionnalités d'image de ChatGPT et comment obtenir le même résultat depuis votre propre code
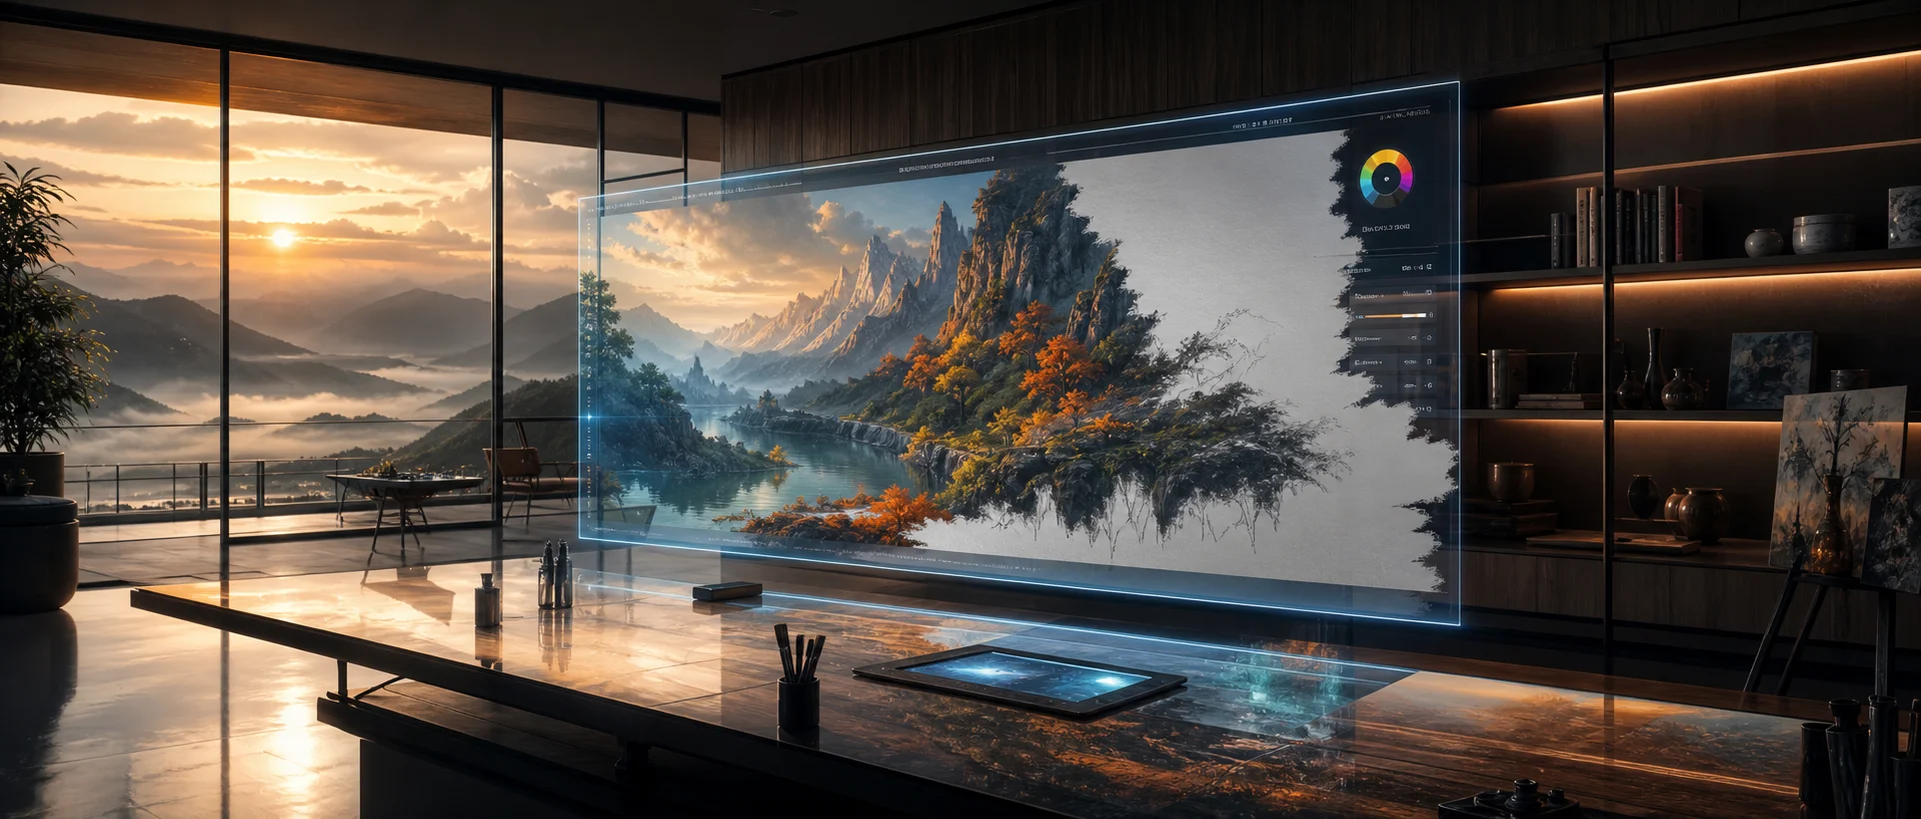
Si vous avez récemment utilisé ChatGPT pour la génération d'images, vous avez remarqué que l'expérience a changé. Le rendu du texte est net et précis, au lieu de se fondre en traits brouillons. Les personnages restent cohérents au fil des éditions. Les ratios d'aspect sont plus faciles à contrôler. Le résultat ressemble davantage à une livraison de designer senior qu'à un brouillon chaotique.
Cette finesse sous-jacente provient de la série GPT Image 2 — la génération de modèles d'image d'OpenAI qui remplace la précédente GPT Image 1.5 (retirée de la plateforme en juin 2026). La bonne nouvelle pour les développeurs : vous n'avez pas besoin de passer par ChatGPT pour obtenir les mêmes sorties. Les mêmes modèles sont disponibles via une simple API de tâches asynchrones. Ce guide passe en revue les changements concrets et fournit le code minimal pour reproduire des résultats équivalents depuis votre propre application.
Ce qui a changé dans la génération d'images ChatGPT
Les améliorations visibles dans le produit ChatGPT découlent de trois évolutions au niveau des modèles :
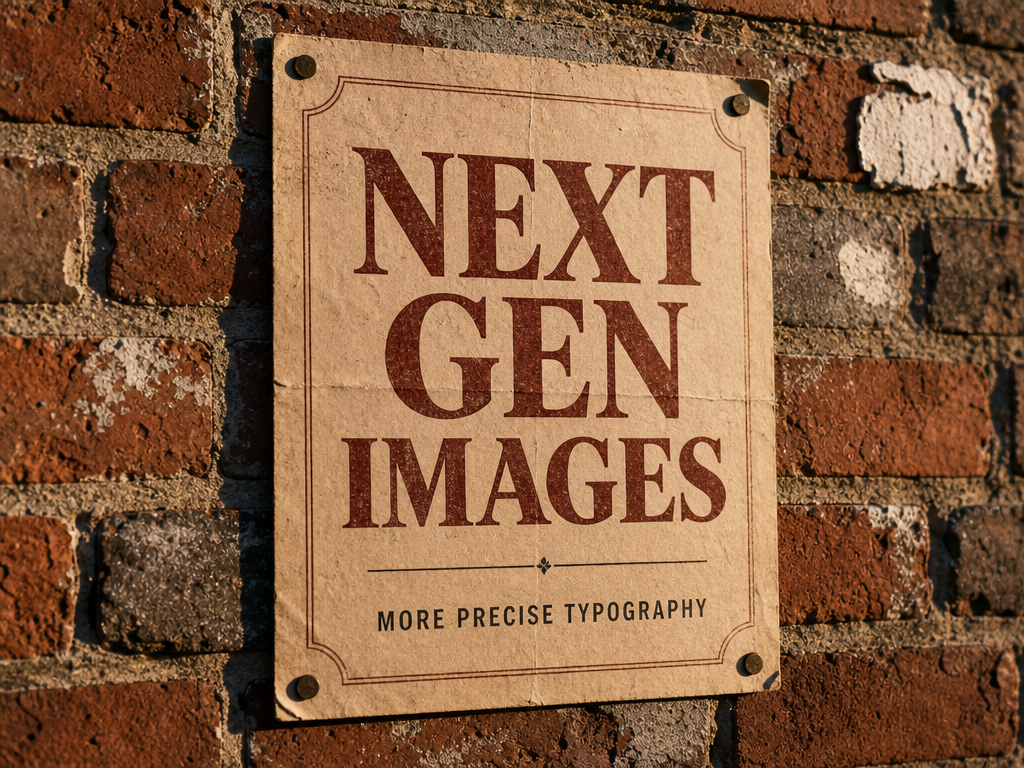
- Un rendu de texte plus net. Les anciens modèles d'image ne faisaient qu'approcher les lettres et produisaient rarement des titres lisibles. La nouvelle série rend la typographie de manière fiable — y compris les casses personnalisées, le multi-ligne et les polices stylisées. Les affiches, les maquettes et les schémas annotés sont enfin exploitables.
- Une meilleure cohérence des personnages et des scènes. Les entrées de référence et les sorties précédentes sont suivies plus attentivement. Les éditions itératives (même personnage, nouvelle pose ; même affiche, nouveau titre) ne nécessitent plus de régénérer toute la composition.
- Une résolution et un niveau de détail plus élevés. Les sorties atteignent désormais jusqu'à 4K, avec un traitement des textures nettement plus fin — pores, tissus, feuillages, graviers — qui se brouillaient auparavant.
Un test de résistance rapide sur ce point de typographie, généré via l'appel API présenté ci-dessous :
Les modèles derrière la mise à jour
La série GPT Image 2 anime la nouvelle expérience d'image de ChatGPT, chaque variante étant exposée via la même API. Voici les compromis :
| Modèle | Idéal pour | Prix par image (1K) |
|---|---|---|
gpt-image-2-beta |
Prototypage rapide, variantes de brouillon, pipelines à gros volume | $0.02 |
gpt-image-2 |
Production générale, équilibre qualité/coût | $0.03 |
gpt-image-2-pro |
Sorties exigeantes, où la fiabilité prime sur le coût | $0.35 |
Quelques points moins intuitifs :
gpt-image-2est moins cher au lancement que le modèle qu'il remplace — GPT Image 1.5 coûtait $0.05 par image avant son retrait. La baisse de prix reflète un pipeline plus efficace, et non un compromis sur la qualité —gpt-image-2est le fleuron actuel de la plupart des workflows.gpt-image-2-proest une variante optimisée pour la stabilité : variance plus faible entre exécutions, meilleur respect des prompts, moins de nouvelles tentatives en production. Utilisez-la lorsque « la première génération doit être livrable » est un véritable besoin.- Chaque variante reçoit les mêmes champs de prompt via le même point de terminaison de tâche, donc changer de modèle se limite à changer le nom du modèle et à consulter le champ
inputde cette variante.
Pour le détail complet par résolution de ces paliers — tarification 1K, 2K et 4K — consultez le guide tarifaire de l'API GPT Image 2.
Appeler le modèle depuis votre code
Tous les modèles de la plateforme hiapi — images comme vidéos — utilisent la même API de tâches asynchrones unifiée : POST /v1/tasks crée une tâche de génération et renvoie immédiatement un ID de tâche, puis GET /v1/tasks/:id rapporte le statut et fournit une URL de sortie une fois terminé. Les paramètres spécifiques au modèle sont placés dans l'objet input. Deux appels, aucun SDK.
Python
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

# 1. Créer la tâche
resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": "A modern minimalist digital art studio at dawn, "
                  "a floating holographic canvas displaying a half-painted "
                  "vibrant landscape, cinematic ultrawide, photorealistic",
        "aspect_ratio": "3:2",
        "resolution": "1K",
    },
})
task_id = resp.json()["data"]["taskId"]

# 2. Interroger jusqu'à l'état terminal
while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

# 3. Télécharger le résultat
image_url = task["output"][0]["url"]
open("output.png", "wb").write(requests.get(image_url).content)
C'est toute l'intégration. L'image terminée est placée sous forme d'URL téléchargeable dans output[] — aucun décodage base64 nécessaire. Un point à noter : chaque sortie porte un horodatage expireAt, donc téléchargez le fichier (ou restockez-le) plutôt que de chaîner l'URL. Si vous ne voulez pas interroger du tout, vous pouvez passer un objet callback à la création de la tâche, et hiapi enverra une requête POST à votre serveur à la fin de la tâche.
curl
# Créer la tâche
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2/text-to-image",
    "input": {
      "prompt": "An aerial view of a Japanese zen garden in autumn, raked white gravel, koi pond, painterly impressionist style",
      "aspect_ratio": "1:1",
      "resolution": "1K"
    }
  }'
# => { "code": 200, "data": { "taskId": "tk-hiapi-..." } }

# Interroger le résultat, puis télécharger
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_KEY" \
| jq -r '.data.output[0].url' \
| xargs curl -o output.png
Le résultat de l'exécution de ce prompt de bout en bout :
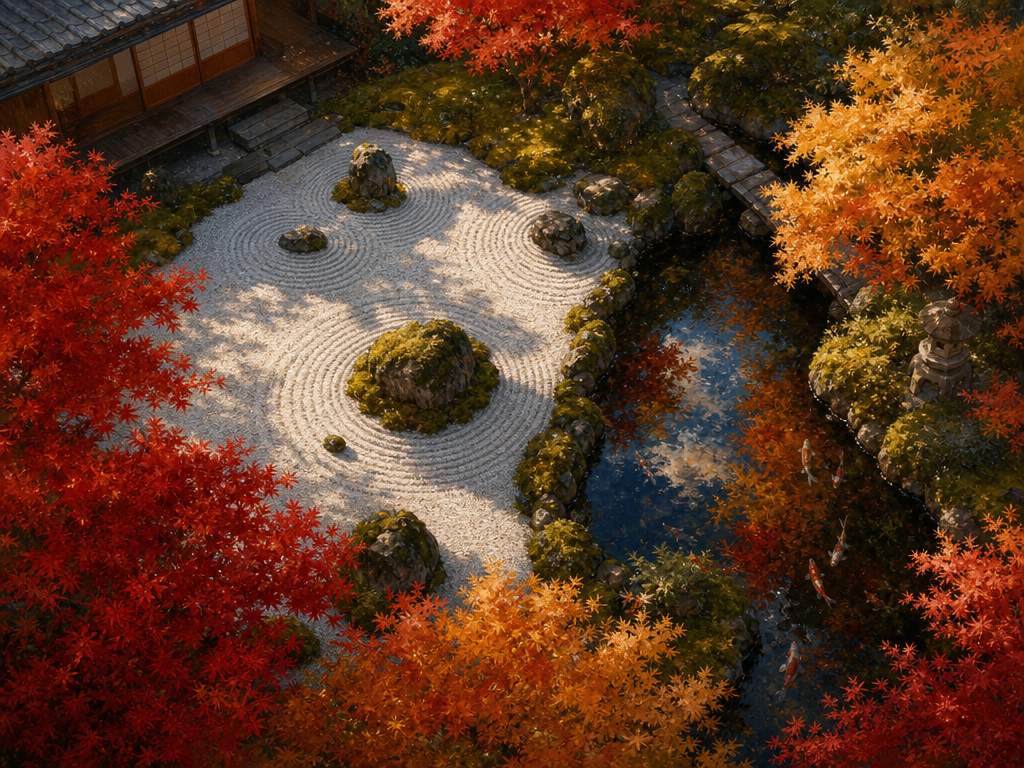
Remarquez comment le détail des textures du gravier, de la mousse et des reflets tient toujours à pleine résolution — c'est précisément l'effet des améliorations de résolution et de traitement des détails.
Choisir le ratio d'aspect et la résolution
La forme de la sortie est contrôlée par deux champs input, et non par une seule chaîne de pixels : aspect_ratio définit la forme du canevas, resolution définit le palier de détail (1K, 2K, 4K). Les trois formes les plus courantes :
"aspect_ratio": "1:1"— carré. Valeur par défaut pour les posts sociaux, les vignettes, les aperçus in-app."aspect_ratio": "3:2"— paysage. Bannières principales, couvertures de blog, compositions larges."aspect_ratio": "2:3"— portrait. Images mobile-first, affiches, fiches produit.
Le prix par image augmente avec le palier de résolution (1K → 2K environ +33 %, 1K → 4K environ du double). Restez à 1K par défaut et ne montez d'un cran que si le cas d'usage final l'exige réellement — impression, affichage grand format ou photographie produit extrêmement détaillée. Choisir systématiquement 4K revient à payer double pour des pixels que personne ne verra.
Là où le modèle démontre son étendue
Ce qui fait de gpt-image-2 un remplaçant dans les anciens workflows n'est pas la sortie photoréaliste — c'est l'étendue. Le même modèle peut, à partir de la même structure de prompt, traiter l'impressionnisme pictural, l'illustration décorative, les maquettes de packaging et la photographie éditoriale. Vous n'avez plus besoin de pré-sélectionner un « modèle de style » comme avant.
Un seul prompt de style illustratif, sans fine-tuning, sans adaptateur de style dédié :
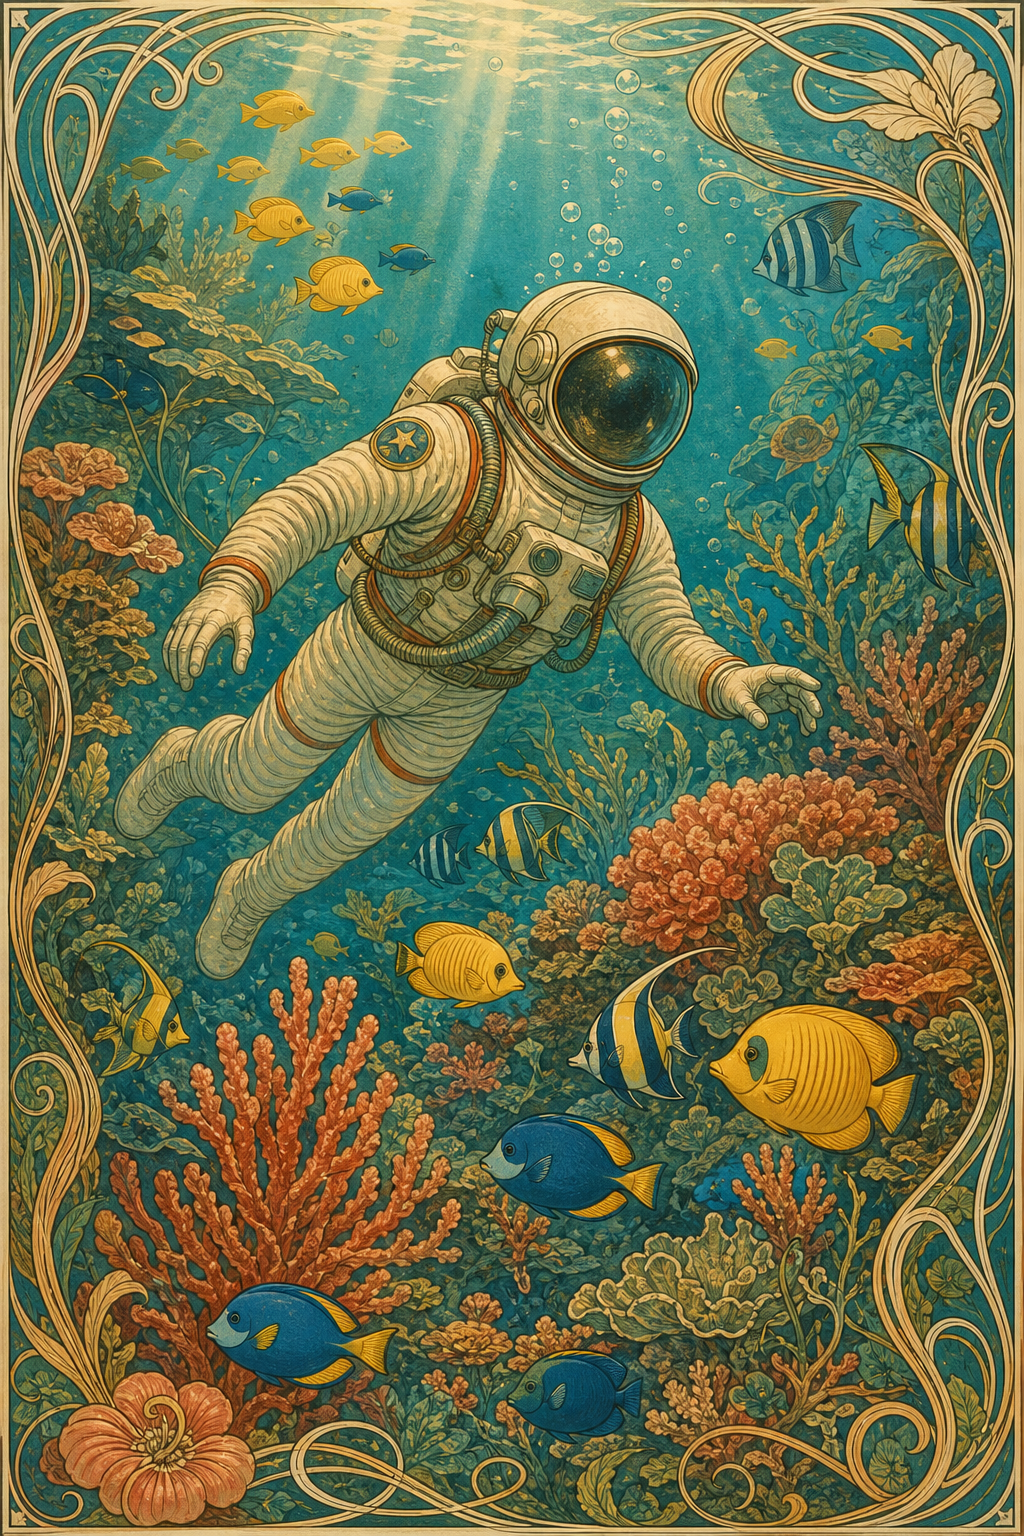
Pour les workflows qui dépendent de cette flexibilité de style — par exemple générer à la fois des photos produit photoréalistes et des images lifestyle illustrées pour une même fiche produit — conserver un seul modèle de bout en bout signifie un seul template de prompt, une seule ligne de coût, un seul chemin de montée en gamme.
Conseils pratiques pour migrer de ChatGPT vers l'API
Avant de l'intégrer dans un produit, quelques points méritent d'être connus :
- Reprendre les prompts de ChatGPT tels quels fonctionne généralement. Si vous avez déjà itéré dans ChatGPT sur un prompt qui donne satisfaction, collez-le dans l'appel API — le modèle est le même. Vous n'avez pas besoin d'un « prompt de style API » séparé.
- Interrogez avec patience — ou utilisez un callback. Selon le modèle et la résolution, la génération prend encore 1 à 3 minutes de bout en bout, mais l'API asynchrone signifie qu'aucune connexion HTTP longue durée ne finira par expirer. Interrogez toutes les quelques secondes, ou définissez
callback.urlà la création de la tâche pour que hiapi vous notifie à la fin. - Cachez par prompt + ratio d'aspect + résolution. Si votre produit répète des prompts courants (maquettes pilotées par template, génération de variantes A/B), conservez un cache adressé par contenu — mêmes octets d'entrée, même sortie, sans payer deux fois.
- Choisissez le palier par cas d'usage, et non par application. Pour les aperçus in-app et les brouillons à gros volume où le coût prime sur les derniers 5 % de qualité, utilisez
gpt-image-2-beta($0.02) ; pour les assets finaux, utilisezgpt-image-2(ou pro). Les prompts restent identiques — vérifiez simplement le champinputde la variante (beta acceptesizeen pixels, le fleuron accepteaspect_ratio+resolution). - Testez le rendu du texte avant de publier vos visuels. La nouvelle série gère bien la typographie, mais les polices très inhabituelles et les chaînes très longues peuvent encore dériver occasionnellement. Si le titre d'une affiche est critique pour la marque, générez deux ou trois versions et choisissez la meilleure — c'est bien moins coûteux que de découvrir le problème après publication.
En résumé
La nouvelle expérience d'image de ChatGPT, au niveau de l'API, est en réalité la série gpt-image-2 — gpt-image-2, gpt-image-2-pro et la variante économique gpt-image-2-beta — servie par un point de terminaison de tâches asynchrones. Si vous attendiez d'intégrer cette génération de qualité d'image dans votre propre produit, le volume d'intégration est minime : POSTez le prompt sur /v1/tasks, interrogez l'ID de tâche, téléchargez l'URL. Les sorties ci-dessus ont été générées exactement ainsi.
Commencez par gpt-image-2 en 1:1 / 1K — à $0.03 par génération, il couvre la plupart des cas d'usage réels. Parcourez la gamme complète de modèles d'image et de vidéo sur la page tarifaire hiapi, ou rendez-vous directement sur la page du modèle GPT Image 2 pour envoyer votre première requête.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax