
Guía de uso
Generación de imágenes con ChatGPT: qué ha cambiado y cómo crearla por programación
Análisis detallado de las últimas funciones de imagen de ChatGPT y cómo entregar desde tu propio código resultados equivalentes
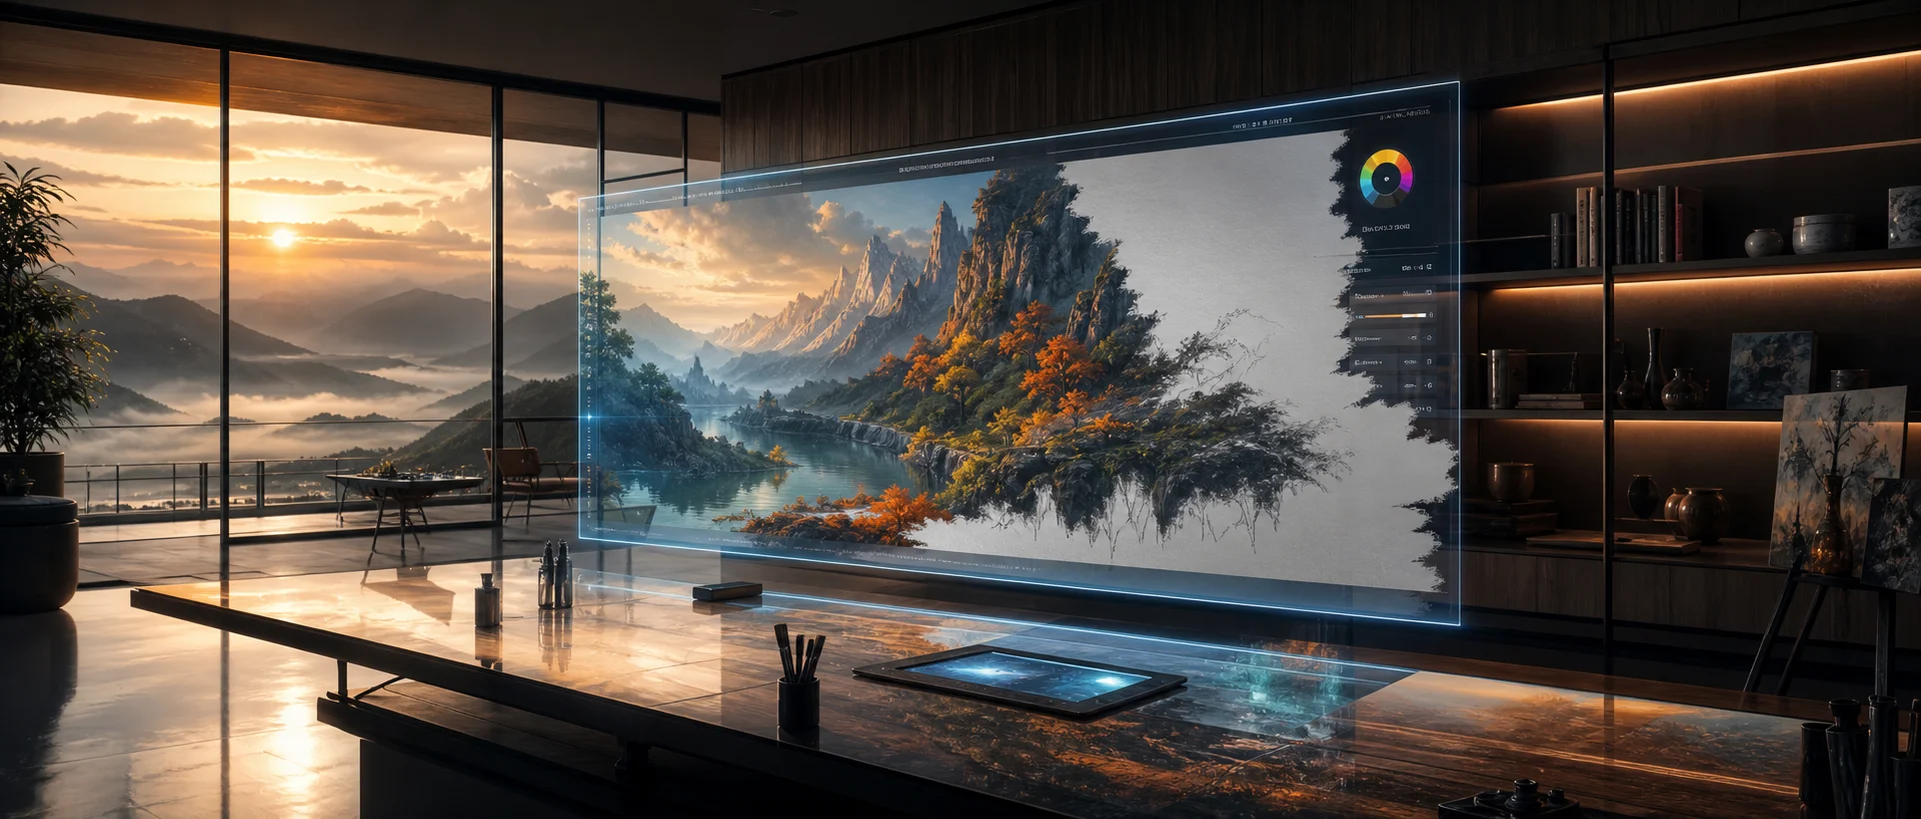
Si has usado ChatGPT recientemente para generar imágenes, notarás que la experiencia ya es distinta. El renderizado del texto es nítido y definido, en lugar de fundirse en líneas caóticas. Los personajes se mantienen consistentes a través de varias ediciones. La relación de aspecto es más fácil de controlar. La salida se parece más al producto final de un diseñador experimentado —y no a un borrador caótico.
Esa sensación de refinamiento subyacente proviene de la familia GPT Image 2 —la generación de modelos de imagen de OpenAI que reemplaza al anterior GPT Image 1.5 (retirado de la plataforma en junio de 2026). La buena noticia para los desarrolladores es que no necesitas pasar por ChatGPT para obtener las mismas salidas. Los mismos modelos están disponibles a través de una sencilla API asíncrona de tareas. Esta guía repasa los cambios reales y ofrece el código mínimo para que reproduzcas resultados equivalentes desde tu propia aplicación.
Qué ha cambiado en la generación de imágenes de ChatGPT
Las mejoras visibles en el producto ChatGPT provienen de tres actualizaciones a nivel de modelo:
- Renderizado de texto más nítido. Los modelos de imagen anteriores apenas aproximaban las letras y rara vez generaban títulos legibles. La nueva familia renderiza tipografía de forma fiable —incluidos tamaños de caja personalizados, varias líneas y fuentes estilizadas. Los carteles, las maquetas y los diagramas con anotaciones por fin son utilizables.
- Mejor consistencia de personajes y escenas. Las entradas de referencia y las salidas previas se respetan con más cuidado. Para hacer ediciones iterativas (mismo personaje, nueva pose; mismo cartel, nuevo título) ya no hace falta regenerar toda la composición.
- Mayor resolución y detalle. Las salidas ahora llegan hasta 4K y el tratamiento de texturas es notablemente más fino —poros, tejidos, follaje, vetas de grava—, detalles que antes se emborronaban.
Una prueba de estrés rápida centrada en la tipografía, generada con la llamada a la API que se muestra a continuación:
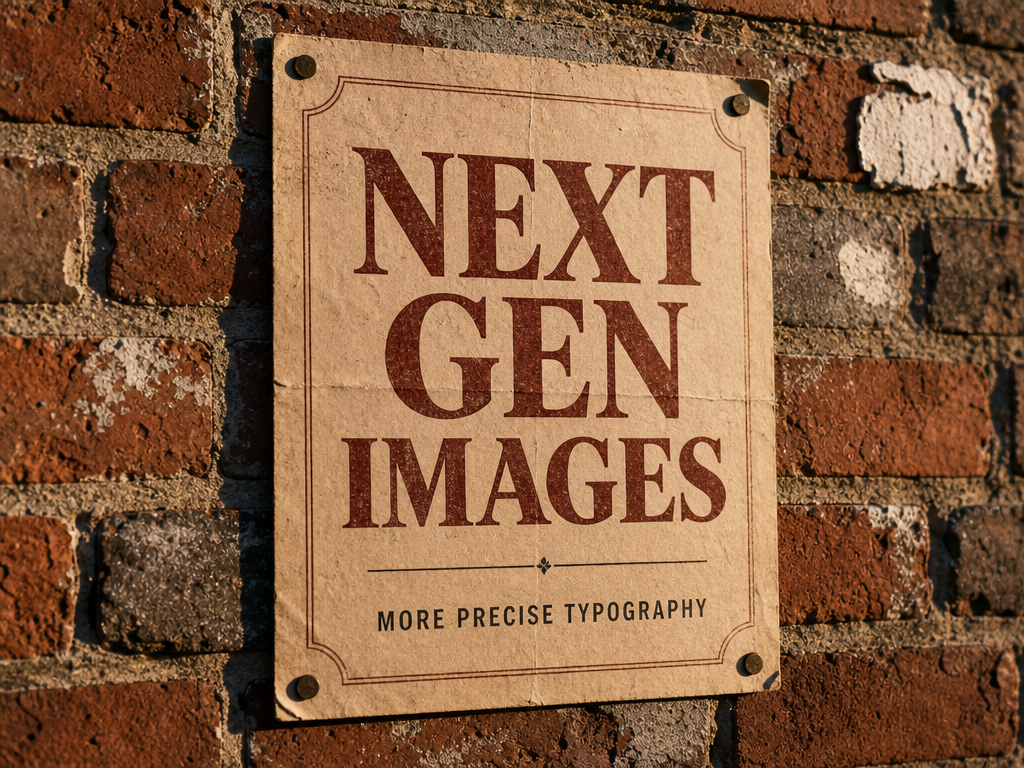
Cada letra es correcta. Sin palabras incompletas ni glifos deformados. Esa es la diferencia principal respecto a la generación anterior.
Los modelos detrás de la actualización
La familia GPT Image 2 impulsa la nueva experiencia de imagen de ChatGPT, y cada variante está disponible a través de la misma API. Los compromisos son los siguientes:
| Modelo | Ideal para | Precio por imagen (1K) |
|---|---|---|
gpt-image-2-beta |
Prototipado rápido, variantes de borrador, canalizaciones de gran volumen | $0.02 |
gpt-image-2 |
Producción general, equilibrio entre calidad y coste | $0.03 |
gpt-image-2-pro |
Salidas exigentes, donde la fiabilidad importa más que el coste | $0.35 |
Algunos puntos poco intuitivos:
gpt-image-2es más barato en su lanzamiento que el modelo al que reemplaza —GPT Image 1.5 costaba $0.05 por imagen antes de su retirada. La bajada de precio refleja una canalización más eficiente, no una cesión en calidad —gpt-image-2es el buque insignia actual para la mayoría de los flujos de trabajo.gpt-image-2-proes la variante ajustada para la estabilidad: menor varianza entre ejecuciones, mayor adherencia a las instrucciones y menos reintentos necesarios en producción. Úsala cuando «la primera generación debe ser entregable» sea un requisito real.- Cada variante recibe los mismos campos de prompt a través del mismo endpoint de tareas, así que cambiar de modelo solo requiere cambiar el nombre del modelo y consultar el campo
inputde esa variante.
Para ver el desglose completo por resolución de estos niveles —precios de 1K, 2K y 4K— consulta la guía de precios de la API de GPT Image 2.
Llamar al modelo desde tu código
Todos los modelos de la plataforma hiapi —tanto de imagen como de vídeo— usan la misma API asíncrona unificada de tareas: POST /v1/tasks crea la tarea de generación y devuelve inmediatamente un ID de tarea; después, GET /v1/tasks/:id informa del estado y, al terminar, entrega la URL de salida. Los parámetros específicos de cada modelo van dentro del objeto input. Dos llamadas, sin SDK.
Python
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

# 1. Crear la tarea
resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": "A modern minimalist digital art studio at dawn, "
                  "a floating holographic canvas displaying a half-painted "
                  "vibrant landscape, cinematic ultrawide, photorealistic",
        "aspect_ratio": "3:2",
        "resolution": "1K",
    },
})
task_id = resp.json()["data"]["taskId"]

# 2. Sondear hasta que la tarea llegue a un estado terminal
while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

# 3. Descargar el resultado
image_url = task["output"][0]["url"]
open("output.png", "wb").write(requests.get(image_url).content)
Eso es toda la integración. La imagen terminada aparece en output[] como una URL descargable —sin decodificación base64. Un detalle a tener en cuenta: cada salida lleva una marca de tiempo expireAt, así que descarga el archivo (o vuelve a almacenarlo) en lugar de enlazar directamente esa URL. Si no quieres sondear en absoluto, puedes pasar un objeto callback al crear la tarea y hiapi enviará una solicitud POST a tu servidor cuando la tarea termine.
curl
# Crear la tarea
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2/text-to-image",
    "input": {
      "prompt": "An aerial view of a Japanese zen garden in autumn, raked white gravel, koi pond, painterly impressionist style",
      "aspect_ratio": "1:1",
      "resolution": "1K"
    }
  }'
# => { "code": 200, "data": { "taskId": "tk-hiapi-..." } }

# Sondear el resultado y luego descargar
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_KEY" \
| jq -r '.data.output[0].url' \
| xargs curl -o output.png
El resultado tras ejecutar ese prompt de principio a fin:
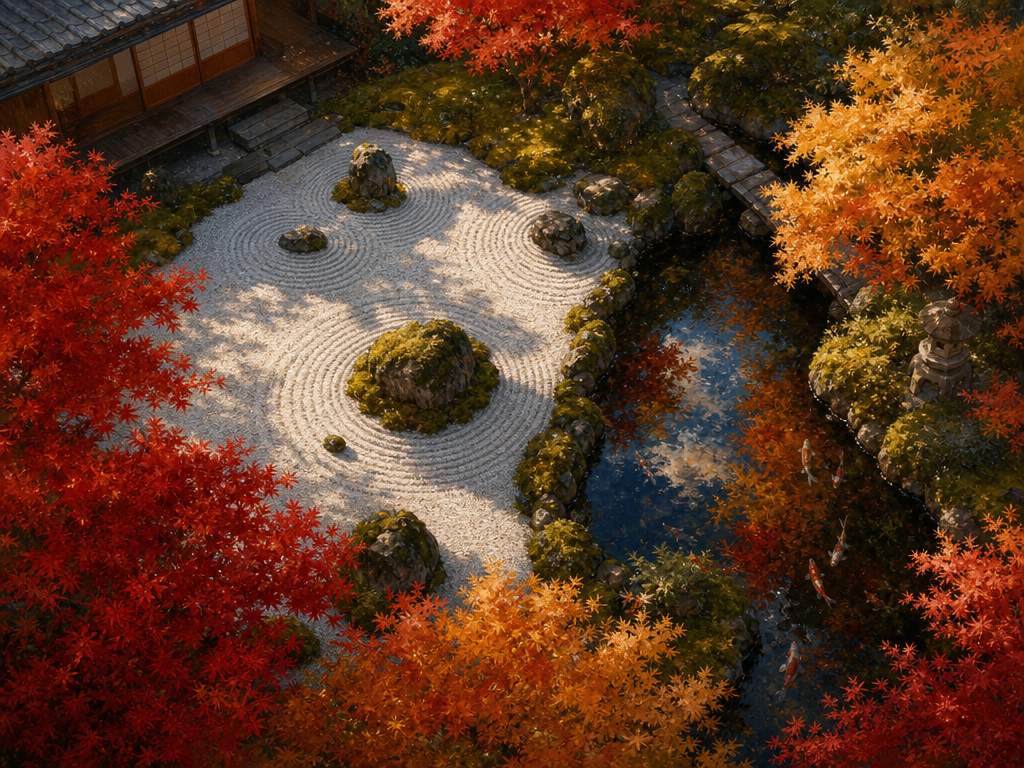
Fíjate en que el detalle de textura de la grava, el musgo y los reflejos sigue resistiendo el examen a recorte completo —ese es el efecto de las mejoras en resolución y tratamiento del detalle.
Elegir relación de aspecto y resolución
La forma de la salida se controla con dos campos de input, no con una única cadena de píxeles: aspect_ratio define la forma del lienzo y resolution define el nivel de detalle (1K, 2K, 4K). Las tres formas más comunes:
"aspect_ratio": "1:1"—cuadrado. El valor predeterminado para publicaciones en redes sociales, miniaturas y vistas previas dentro de la aplicación."aspect_ratio": "3:2"—horizontal. Banners principales, portadas de blog, composiciones panorámicas."aspect_ratio": "2:3"—vertical. Imágenes con prioridad móvil, carteles, tarjetas de producto.
El precio por imagen aumenta con el nivel de resolución (de 1K a 2K, aproximadamente +33 %; de 1K a 4K, aproximadamente el doble). Usa 1K por defecto y sube de nivel solo cuando el caso de uso final realmente lo exija —impresión, exhibición a gran formato o fotografía de producto con requisitos de detalle muy altos. Elegir 4K por costumbre supone pagar el doble por píxeles que nadie va a ver.
Donde el modelo demuestra su amplitud
Una de las razones por las que gpt-image-2 está reemplazando flujos de trabajo anteriores no es la salida fotorrealista —sino la amplitud. El mismo modelo puede abordar, con la misma estructura de prompt, impresionismo pictórico, ilustración decorativa, maquetas de packaging y fotografía editorial. Ya no necesitas preseleccionar «modelos de estilo» como antes.
Un único prompt de estilo ilustrativo, sin ajuste fino, sin adaptadores específicos de estilo:
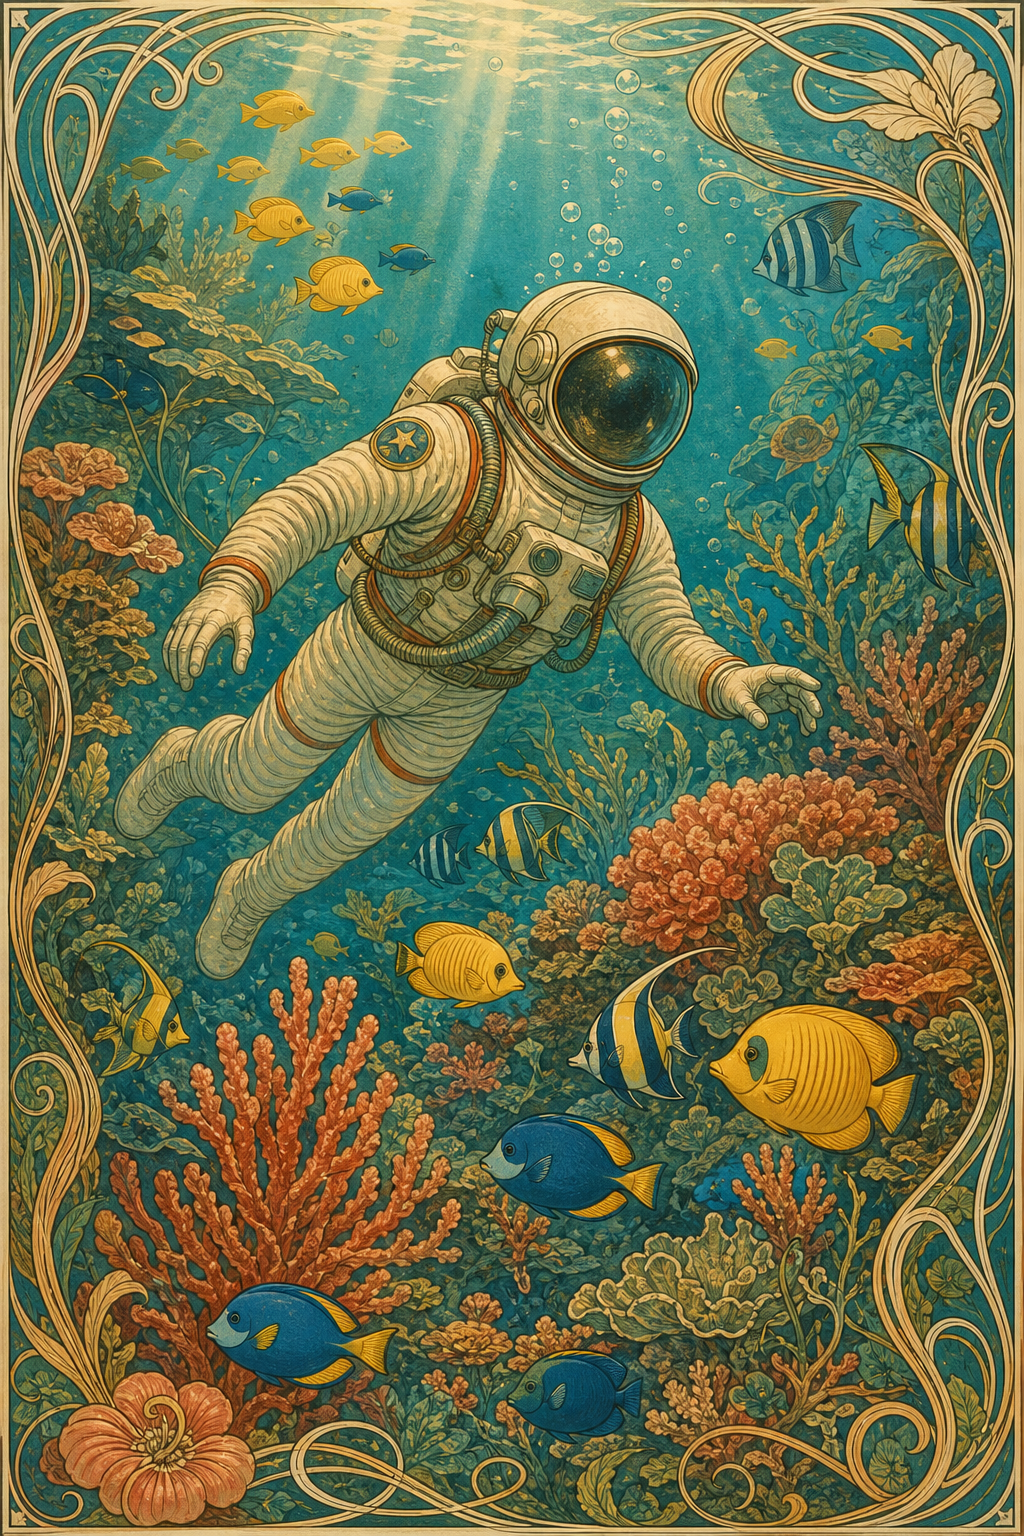
Para flujos de trabajo que dependen de esa flexibilidad de estilo —por ejemplo, generar a la vez una imagen de producto fotorrealista y una imagen de estilo de vida ilustrada para el mismo anuncio de producto—, mantener un único modelo de principio a fin significa una sola plantilla de prompt, una sola línea de coste y una sola ruta de actualización.
Consejos prácticos para migrar de ChatGPT a la API
Antes de integrarlo en tu producto, hay algunas cosas que conviene saber:
- Copiar los prompts de ChatGPT tal cual suele funcionar. Si ya has iterado en ChatGPT un prompt que produce buenos resultados, pégalo en la llamada a la API —el modelo es el mismo. No necesitas un «prompt de estilo API» aparte.
- Sondea con paciencia —o usa callback. Según el modelo y la resolución, la generación de principio a fin aún tarda de 1 a 3 minutos, pero la API asíncrona implica que ninguna conexión HTTP de larga duración vaya a expirar. Sondea cada pocos segundos, o configura
callback.urlal crear la tarea para que hiapi te notifique al terminar. - Cachea por prompt + relación de aspecto + resolución. Si tu producto solicita repetidamente prompts habituales (maquetas basadas en plantillas, generación de variantes A/B), mantén una caché direccionada por contenido —mismas entradas, mismas salidas, sin pagar dos veces.
- Elige el nivel según el caso de uso, no según la aplicación. Para vistas previas dentro del producto y borradores de gran volumen, donde el coste importa más que el último 5 % de calidad, usa
gpt-image-2-beta($0.02); para el material final, usagpt-image-2(o pro). Los prompts se pueden reutilizar tal cual —solo revisa el campoinputde la variante (beta aceptasizeen píxeles; la versión insignia aceptaaspect_ratio+resolution). - Prueba el renderizado de texto antes de publicar el copy. La nueva familia maneja muy bien la tipografía, pero las fuentes poco habituales y las cadenas muy largas aún pueden desviarse ocasionalmente. Si el titular de un cartel es crítico para la marca, genera dos o tres y elige el mejor —es mucho más barato que descubrir el problema después de publicar.
En resumen
La nueva experiencia de imagen de ChatGPT es, a nivel de API, la familia gpt-image-2 —gpt-image-2, gpt-image-2-pro y la económica gpt-image-2-beta— servida por un endpoint asíncrono de tareas. Si llevabas tiempo esperando incorporar esta generación de calidad de imagen a tu propio producto, la integración es mínima: envía el prompt por POST a /v1/tasks, sondea el ID de tarea y descarga la URL. Las salidas anteriores se generaron exactamente así.
Empieza con gpt-image-2 en 1:1 / 1K —$0.03 por generación, suficiente para la mayoría de los casos de uso reales. Explora la gama completa de modelos de imagen y vídeo en la página de precios de hiapi, o ve directamente a la página del modelo GPT Image 2 para enviar tu primera solicitud.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores