
使用ガイド
ChatGPT 画像生成:何が変わったか、そしてプログラムで構築する方法
最新の ChatGPT 画像機能を詳しく解説し、自分のコードから同等の出力を届ける方法を紹介します
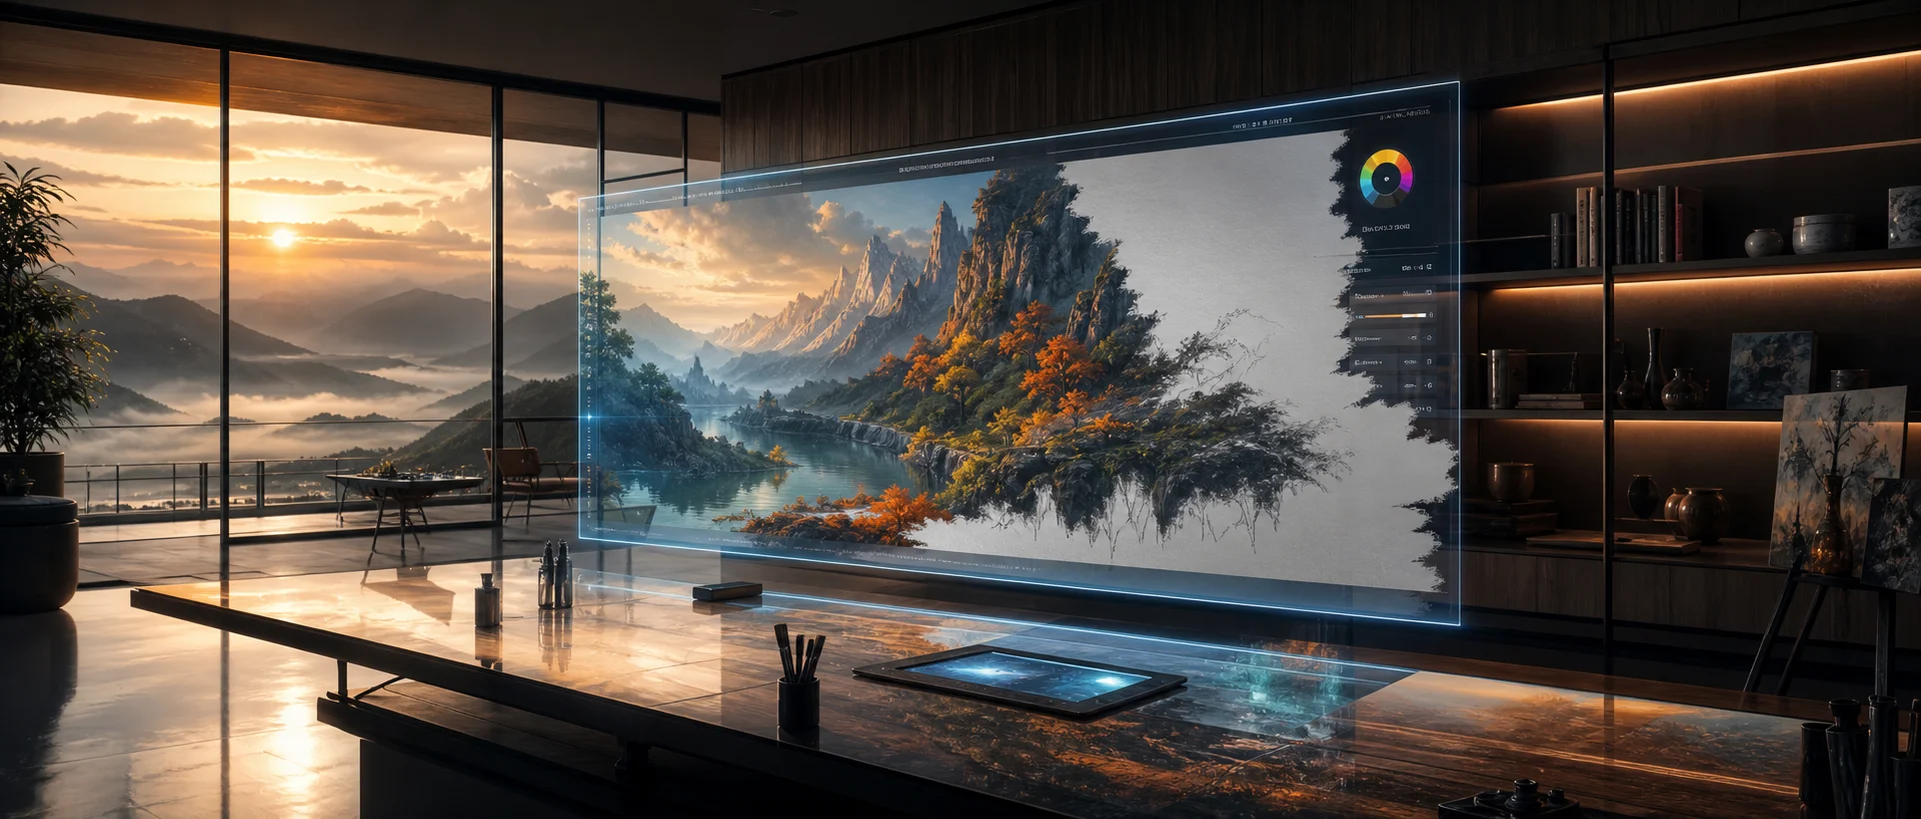
最近 ChatGPT で画像生成を使ったことがあるなら、体験がすでに変わっていることに気づくでしょう。テキストのレンダリングはくっきりとシャープになり、乱れた線に溶け込むことはなくなりました。キャラクターは複数回の編集を通じて一貫性を保ちます。アスペクト比も制御しやすくなりました。出力は混沌とした初期ドラフトではなく、ベテランデザイナーが納品する完成品に近いものに見えます。
この洗練された感覚の根底にあるのは GPT Image 2 シリーズです。これは、より初期の GPT Image 1.5(2026 年 6 月にプラットフォームから退役)に取って代わった OpenAI の画像モデル世代です。開発者にとって嬉しいニュースは、ChatGPT を経由しなくても同じ出力が得られることです。同じモデルはシンプルな非同期タスク API を通じて利用できます。本ガイドでは実際の変更点を整理し、自分のアプリから同等の結果を再現するための最小限のコードを示します。
ChatGPT の画像生成で何が変わったか
ChatGPT 製品で見られる改善は、3 つのモデルレベルのアップグレードに由来します:
- より鮮明なテキストレンダリング。 初期の画像モデルは文字を近似することしかできず、読み取れる見出しを生成することはほとんどありませんでした。新しいシリーズは、カスタムの大文字小文字、複数行、スタイル化されたフォントを含むタイポグラフィを確実にレンダリングします。ポスター、モックアップ、注釈付きの図がついに実用になりました。
- キャラクターとシーンの一貫性の向上。 参照入力と以前の出力がより注意深く尊重されます。反復的な編集(同じキャラクターで新しいポーズ、同じポスターで新しい見出し)では、構図全体を再生成する必要がなくなりました。
- より高い解像度とディテール。 出力は最大 4K になり、テクスチャの処理が明らかに繊細になりました。毛穴、布地の質感、枝葉、砂利の模様など、以前はぼやけてしまう要素です。
タイポグラフィに関するこの点の簡易ストレステストを、以下に示す API 呼び出しで生成しました:
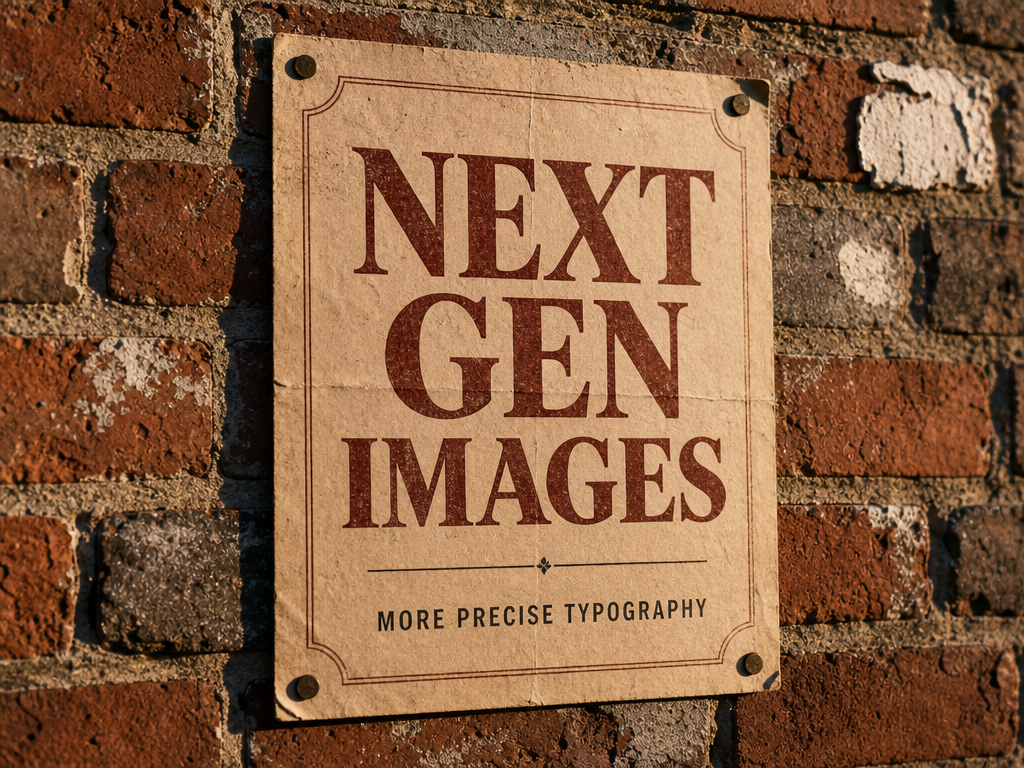
すべての文字が正しく表示されています。崩れたスペルも、歪んだ字形もありません。これが前世代と比べた最大の違いです。
アップデートを支えるモデル
GPT Image 2 シリーズが新しい ChatGPT の画像体験を牽引しており、各バリアントは同一の API を通じて公開されています。トレードオフは以下のとおりです:
| モデル | 最適な用途 | 画像 1 枚あたりの価格(1K) |
|---|---|---|
gpt-image-2-beta |
迅速なプロトタイピング、ドラフトバリアント、大規模バッチパイプライン | $0.02 |
gpt-image-2 |
汎用の本番用途、品質とコストのバランス | $0.03 |
gpt-image-2-pro |
要求の厳しい出力、コストよりも信頼性が重要な場合 | $0.35 |
やや直感的でないポイントをいくつか挙げます:
gpt-image-2は、それが置き換えたモデルよりも安くリリースされました。GPT Image 1.5 は退役前、1 枚あたり $0.05 で販売されていました。価格の低下は品質の妥協ではなく、より効率的なパイプラインを反映しています。gpt-image-2はほとんどのワークフローにおける現行のフラッグシップです。gpt-image-2-proは安定性にチューニングされたバリアントです。複数回実行した際のばらつきが少なく、プロンプトへの追従性が高く、本番で必要となるリトライ回数が少なくなります。「最初の生成で必ず納品可能でなければならない」ことが真の要件である場合に使用してください。- すべてのバリアントは同じタスクエンドポイントを通じて同じ prompt フィールドを受け取るため、モデルの切り替えはモデル名を変更するだけで済みます。そのバリアントの
inputフィールドを確認してください。
これらのティアの解像度別の完全な内訳(1K、2K、4K の価格)については、GPT Image 2 API 価格ガイドを参照してください。
自分のコードからモデルを呼び出す
hiapi プラットフォーム上のすべてのモデル(画像も動画も同様)は、統一された非同期タスク API を使用します:POST /v1/tasks で生成タスクを作成してタスク ID を即座に返し、その後 GET /v1/tasks/:id でステータスを報告し、完了時に出力 URL を提供します。モデル固有のパラメータは input オブジェクト内に置きます。呼び出しは 2 回だけで、SDK は不要です。
Python
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

# 1. タスクを作成
resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": "A modern minimalist digital art studio at dawn, "
                  "a floating holographic canvas displaying a half-painted "
                  "vibrant landscape, cinematic ultrawide, photorealistic",
        "aspect_ratio": "3:2",
        "resolution": "1K",
    },
})
task_id = resp.json()["data"]["taskId"]

# 2. タスクが終了状態になるまでポーリング
while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

# 3. 結果をダウンロード
image_url = task["output"][0]["url"]
open("output.png", "wb").write(requests.get(image_url).content)
統合はこれだけです。完成した画像はダウンロード可能な URL として output[] に格納されます。base64 デコードは不要です。注意点が 1 つあります。各出力には expireAt タイムスタンプが付いているため、URL をホットリンクするのではなく、ファイルをダウンロードする(または再保存する)ようにしてください。ポーリングを一切したくない場合は、タスク作成時に callback オブジェクトを渡すと、hiapi がタスク完了時にサーバーへ POST リクエストを送信します。
curl
# タスクを作成
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2/text-to-image",
    "input": {
      "prompt": "An aerial view of a Japanese zen garden in autumn, raked white gravel, koi pond, painterly impressionist style",
      "aspect_ratio": "1:1",
      "resolution": "1K"
    }
  }'
# => { "code": 200, "data": { "taskId": "tk-hiapi-..." } }

# 結果をポーリングしてダウンロード
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_KEY" \
| jq -r '.data.output[0].url' \
| xargs curl -o output.png
このプロンプトをエンドツーエンドで実行した結果:
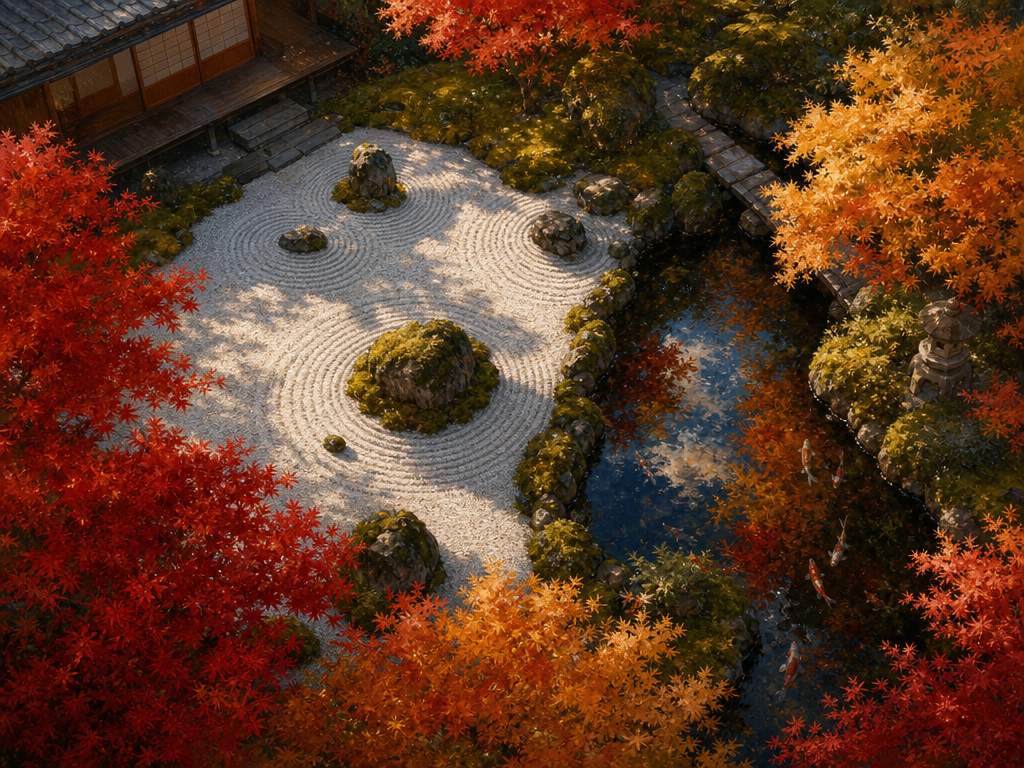
砂利、苔、反射の中のテクスチャのディテールが、フルクロップでも十分に見応えがあることに注目してください。これこそが解像度とディテール処理の改善の効果です。
アスペクト比と解像度を選択する
出力の形状は、単一のピクセル文字列ではなく 2 つの input フィールドで制御します。aspect_ratio がキャンバスの形状を設定し、resolution がディテールのティア(1K、2K、4K)を設定します。最も一般的な 3 つの形状:
"aspect_ratio": "1:1"— 正方形。ソーシャルメディアの投稿、サムネイル、アプリ内プレビューのデフォルト。"aspect_ratio": "3:2"— 横向き。ヒーローバナー、ブログのカバー、ワイドな構図。"aspect_ratio": "2:3"— 縦向き。モバイルファーストの画像、ポスター、商品カード。
画像 1 枚あたりの価格は解像度ティアが上がると増加します(1K → 2K で約 +33%、1K → 4K で約 2 倍)。デフォルトでは 1K を使用し、最終的な用途で本当に必要な場合にのみアップグレードしてください。印刷、大判展示、細部に極めて厳しい商品撮影などです。習慣的に 4K を選ぶと、誰も見ないピクセルに 2 倍のコストを支払うことになります。
モデルが幅広さを発揮する場面
gpt-image-2 が初期のワークフローに取って代わりつつある理由の 1 つは、写真のようなリアルな出力ではなく、幅広さです。同じモデルが、同じプロンプト構造から絵画的な印象派、装飾的なイラスト、パッケージのモックアップ、編集写真を処理できます。以前のように「スタイルモデル」を事前に選ぶ必要はもうありません。
単一のイラストスタイルのプロンプトで、微調整もスタイル専用アダプターも不要:
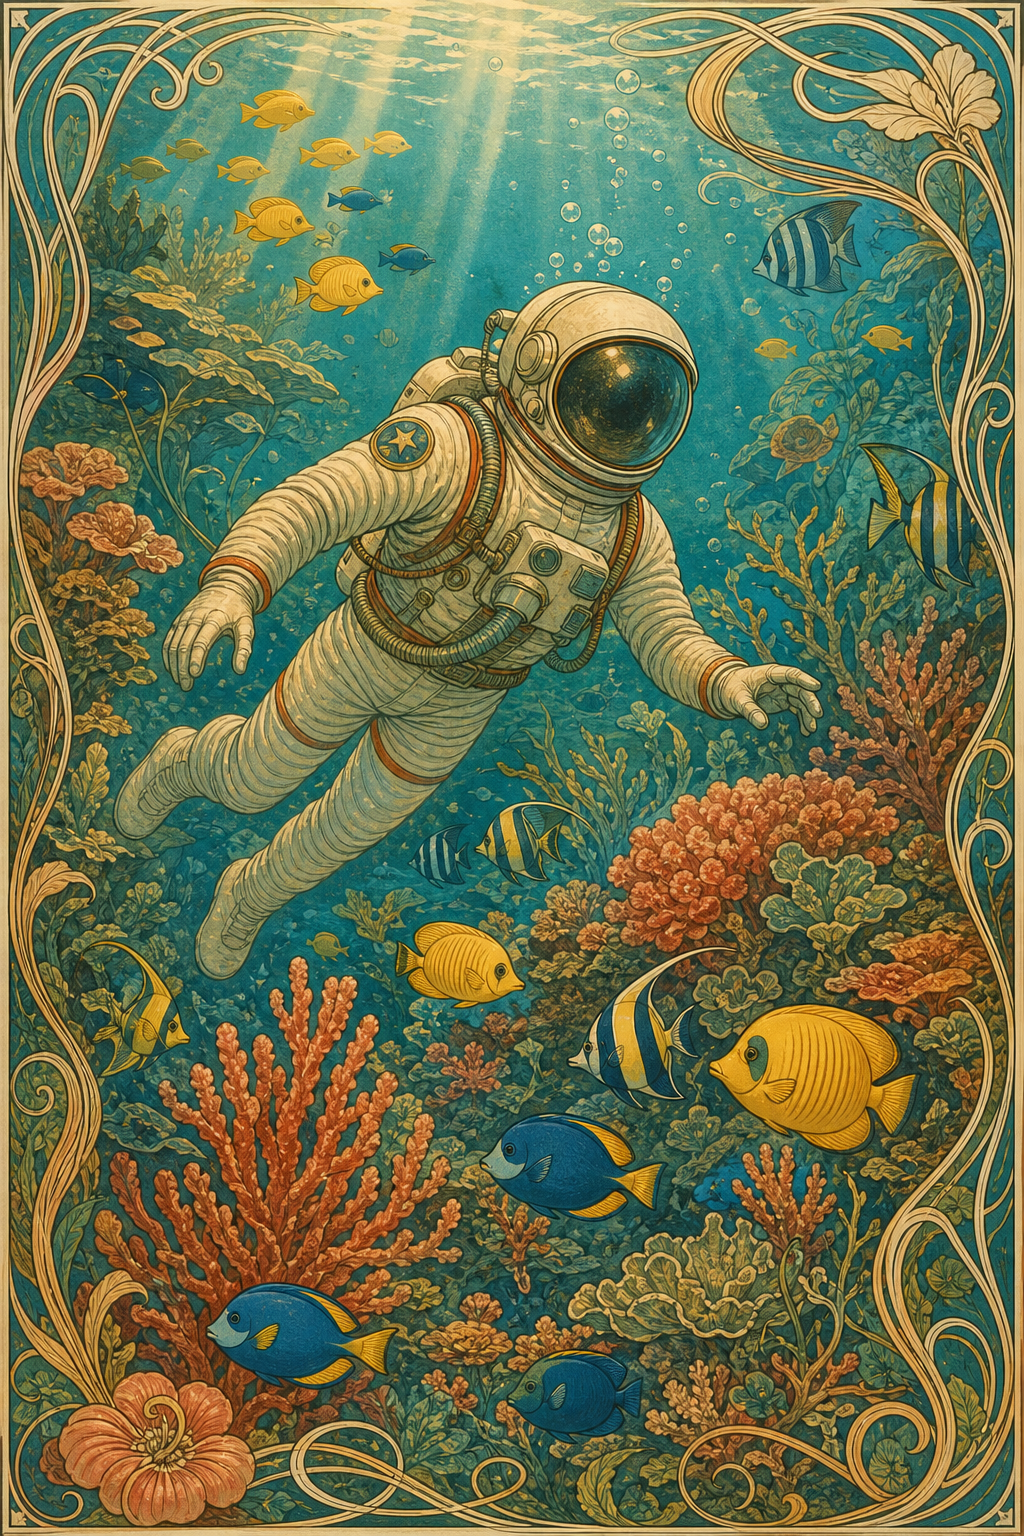
このスタイルの柔軟性に依存するワークフロー、たとえば同じ商品リスティングに対して写真のような商品画像とイラスト風のライフスタイル画像を同時に生成する場合などでは、単一のモデルをエンドツーエンドで維持することで、1 つのプロンプトテンプレート、1 つのコストライン、1 つのアップグレードパスを保てます。
ChatGPT から API への移行に関する実践的なヒント
製品に組み込む前に、知っておく価値のあることがいくつかあります:
- ChatGPT のプロンプトをそのまま持ち込んでも通常は機能します。 ChatGPT で満足のいく結果を生み出すプロンプトをすでに反復して作り上げているなら、それを API 呼び出しに貼り付けてください。モデルは同じです。別途「API スタイルのプロンプト」は必要ありません。
- 根気よくポーリングするか、コールバックを使いましょう。 モデルと解像度によって異なりますが、生成にはエンドツーエンドで 1〜3 分かかります。ただし非同期 API のおかげで、長時間保持される HTTP 接続がタイムアウトすることはありません。数秒ごとにポーリングするか、タスク作成時に
callback.urlを設定して、hiapi が完了時に通知するようにしてください。 - プロンプト + アスペクト比 + 解像度でキャッシュする。 製品がよくあるプロンプト(テンプレート駆動のモックアップ、A/B バリアント生成など)を繰り返しリクエストする場合、コンテンツアドレス型のキャッシュを保持しましょう。同じ入力バイトなら同じ出力になるため、二重に支払う必要はありません。
- ティアはアプリ単位ではなくユースケース単位で選ぶ。 コストが最後の 5% の品質よりも重要な製品内プレビューや大規模バッチのドラフトには
gpt-image-2-beta($0.02)を、最終素材にはgpt-image-2(または pro)を使用します。プロンプトはそのまま流用できます。バリアントのinputフィールドを確認するだけです(beta はピクセル単位のsizeを受け付け、フラッグシップはaspect_ratio+resolutionを受け付けます)。 - コピーを公開する前にテキストレンダリングをテストする。 新しいシリーズはタイポグラフィをうまく処理しますが、通常と異なるフォントや極端に長い文字列は時折ずれることがあります。ポスターの見出しがブランドにとって重要なら、2〜3 枚生成して最良のものを選びましょう。公開後に問題に気づくよりずっと安上がりです。
まとめ
新しい ChatGPT の画像体験は、API レベルでは実に gpt-image-2 シリーズ、すなわち gpt-image-2、gpt-image-2-pro、そして経済的な gpt-image-2-beta であり、1 つの非同期タスクエンドポイントから提供されます。この世代の画質を自分の製品に取り入れたいと考えていたなら、統合はわずかです。プロンプトを /v1/tasks に POST し、タスク ID をポーリングし、URL をダウンロードするだけです。上記の出力はまさにこの方法で生成されました。
まずは 1:1 / 1K の gpt-image-2 から始めましょう。1 回の生成で $0.03 で、ほとんどの実用的なユースケースに対応できます。hiapi の価格ページで画像・動画モデルの完全なラインナップを閲覧するか、GPT Image 2 モデルページに直接アクセスして最初のリクエストを送信してください。


