
Benutzerhandbuch
ChatGPT-Bildgenerierung: Was sich geändert hat und wie man sie programmatisch aufbaut
Ein detaillierter Blick auf die neuesten ChatGPT-Bildfunktionen und darauf, wie man dieselbe Ausgabequalität aus dem eigenen Code liefert
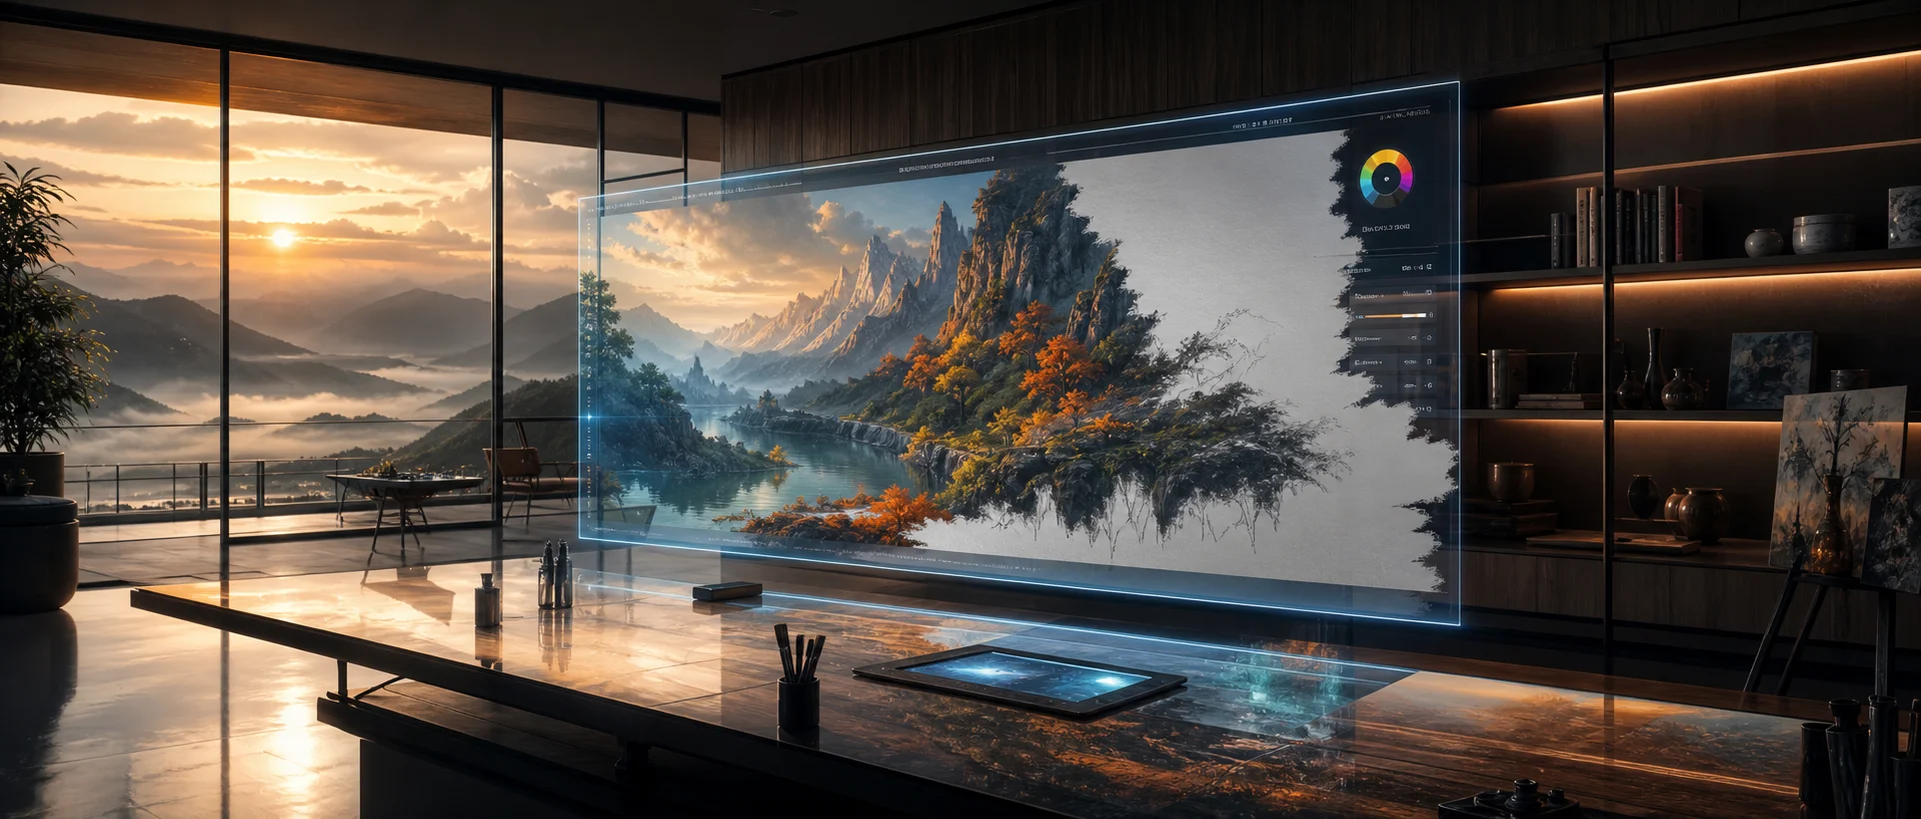
Wer ChatGPT in letzter Zeit zur Bildgenerierung genutzt hat, wird bemerkt haben, dass sich die Erfahrung verändert hat. Text wird scharf und klar gerendert, statt zu einem unruhigen Liniengewirr zu verschwimmen. Figuren bleiben über mehrere Bearbeitungen hinweg konsistent. Das Seitenverhältnis lässt sich leichter steuern. Die Ausgabe wirkt eher wie das fertige Ergebnis einer erfahrenen Designerin – und nicht wie ein chaotischer Erstentwurf.
Diese zugrunde liegende Feinheit stammt aus der GPT Image 2-Serie – der OpenAI-Bildmodellgeneration, die das ältere GPT Image 1.5 ablöst (das im Juni 2026 von der Plattform zurückgezogen wurde). Die gute Nachricht für Entwickler: Man muss nicht ChatGPT nutzen, um dieselbe Ausgabe zu erhalten. Dieselben Modelle sind über eine einfache asynchrone Task-API verfügbar. Dieser Leitfaden fasst die tatsächlichen Änderungen zusammen und liefert den minimalen Code, um dieselben Ergebnisse aus der eigenen Anwendung zu reproduzieren.
Was sich bei der ChatGPT-Bildgenerierung geändert hat
Die im ChatGPT-Produkt sichtbaren Verbesserungen stammen aus drei Upgrades auf Modellebene:
- Klarere Textdarstellung. Frühere Bildmodelle konnten Buchstaben nur annähern und erzeugten selten lesbare Überschriften. Die neue Serie rendert Typografie zuverlässig – einschließlich benutzerdefinierter Groß-/Kleinschreibung, mehrerer Zeilen und stilisierter Schriftarten. Poster, Mockups und beschriftete Diagramme sind endlich brauchbar.
- Bessere Konsistenz von Figuren und Szenen. Referenzeingaben und frühere Ausgaben werden sorgfältiger befolgt. Iterative Bearbeitungen (dieselbe Figur, neue Pose; dasselbe Poster, neue Überschrift) erfordern kein erneutes Generieren der gesamten Komposition mehr.
- Höhere Auflösung und mehr Detail. Ausgaben sind jetzt bis zu 4K möglich, mit deutlich feinerer Texturbehandlung – Poren, Stoffgewebe, Blattwerk, Kiesstrukturen –, die früher verschwommen sind.
Ein schneller Stresstest speziell für die Typografie, erzeugt mit dem unten gezeigten API-Aufruf:
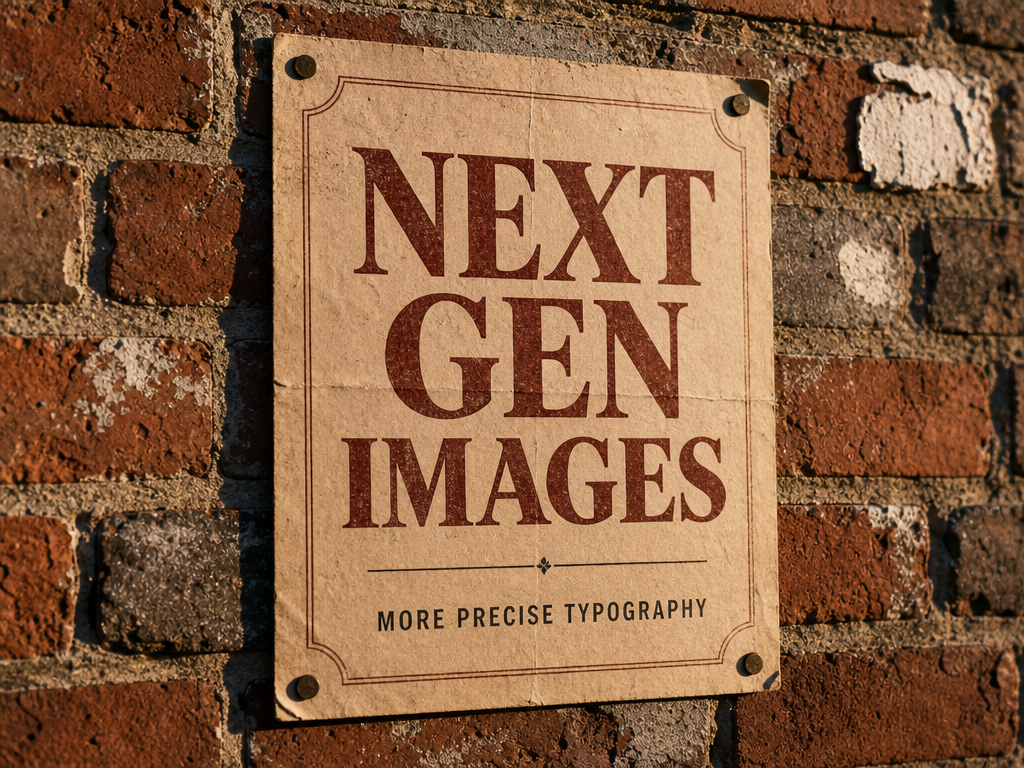
Jeder Buchstabe ist korrekt. Keine fehlerhaften Schreibweisen, keine verzerrten Glyphen. Das ist der wichtigste Unterschied zur vorherigen Generation.
Die Modelle hinter dem Update
Die GPT Image 2-Serie treibt die neue ChatGPT-Bilderfahrung an, und jede Variante ist über dieselbe API verfügbar. Die Abwägungen:
| Modell | Am besten für | Preis pro Bild (1K) |
|---|---|---|
gpt-image-2-beta |
Schnelle Prototypen, Entwurfsvarianten, Pipelines mit hohem Volumen | $0.02 |
gpt-image-2 |
Allgemeine Produktion, ausgewogenes Verhältnis von Qualität und Kosten | $0.03 |
gpt-image-2-pro |
Anspruchsvolle Ausgaben, bei denen Zuverlässigkeit wichtiger ist als Kosten | $0.35 |
Einige weniger offensichtliche Punkte:
gpt-image-2ist zum Start günstiger als das Modell, das es ersetzt – GPT Image 1.5 kostete vor dem Rückzug $0.05 pro Bild. Der Preisrückgang spiegelt eine effizientere Pipeline wider, keine Qualitätskompromisse –gpt-image-2ist das aktuelle Flaggschiff für die meisten Workflows.gpt-image-2-proist die auf Zuverlässigkeit abgestimmte Variante: geringere Varianz über mehrere Läufe, höhere Prompt-Treue, weniger Wiederholungsversuche im Produktivbetrieb. Verwenden Sie sie, wenn „der erste Durchlauf muss lieferbar sein“ eine echte Anforderung ist.- Jede Variante empfängt über denselben Task-Endpunkt dieselben Prompt-Felder, sodass ein Modellwechsel nur den Modellnamen ändert – und einen Blick auf das
input-Feld der jeweiligen Variante erfordert.
Eine vollständige Aufschlüsselung dieser Stufen nach Auflösung – 1K-, 2K- und 4K-Preise – finden Sie im GPT Image 2 API-Preisleitfaden.
Das Modell aus Ihrem Code aufrufen
Alle Modelle auf der hiapi-Plattform – Bilder wie Videos gleichermaßen – nutzen dieselbe einheitliche asynchrone Task-API: POST /v1/tasks erstellt einen Generierungsauftrag und gibt sofort eine Task-ID zurück, dann meldet GET /v1/tasks/:id den Status und liefert nach Abschluss eine Ausgabe-URL. Modellspezifische Parameter liegen im input-Objekt. Zwei Aufrufe, kein SDK.
Python
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

# 1. Aufgabe erstellen
resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": "A modern minimalist digital art studio at dawn, "
                  "a floating holographic canvas displaying a half-painted "
                  "vibrant landscape, cinematic ultrawide, photorealistic",
        "aspect_ratio": "3:2",
        "resolution": "1K",
    },
})
task_id = resp.json()["data"]["taskId"]

# 2. Abfragen, bis die Aufgabe einen Endzustand erreicht
while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

# 3. Ergebnis herunterladen
image_url = task["output"][0]["url"]
open("output.png", "wb").write(requests.get(image_url).content)
Das ist die gesamte Integration. Fertige Bilder liegen als herunterladbare URLs im output[] – keine Base64-Dekodierung nötig. Ein Punkt ist zu beachten: Jede Ausgabe trägt einen expireAt-Zeitstempel, daher sollten Sie die Datei herunterladen (oder neu speichern), statt die URL direkt zu verlinken. Wenn Sie überhaupt nicht abfragen möchten, können Sie beim Erstellen der Aufgabe ein callback-Objekt übergeben, und hiapi sendet bei Abschluss der Aufgabe eine POST-Anfrage an Ihren Server.
curl
# Aufgabe erstellen
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2/text-to-image",
    "input": {
      "prompt": "An aerial view of a Japanese zen garden in autumn, raked white gravel, koi pond, painterly impressionist style",
      "aspect_ratio": "1:1",
      "resolution": "1K"
    }
  }'
# => { "code": 200, "data": { "taskId": "tk-hiapi-..." } }

# Ergebnis abfragen, dann herunterladen
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_KEY" \
| jq -r '.data.output[0].url' \
| xargs curl -o output.png
Das Ergebnis, nachdem dieser Prompt von Anfang bis Ende ausgeführt wurde:
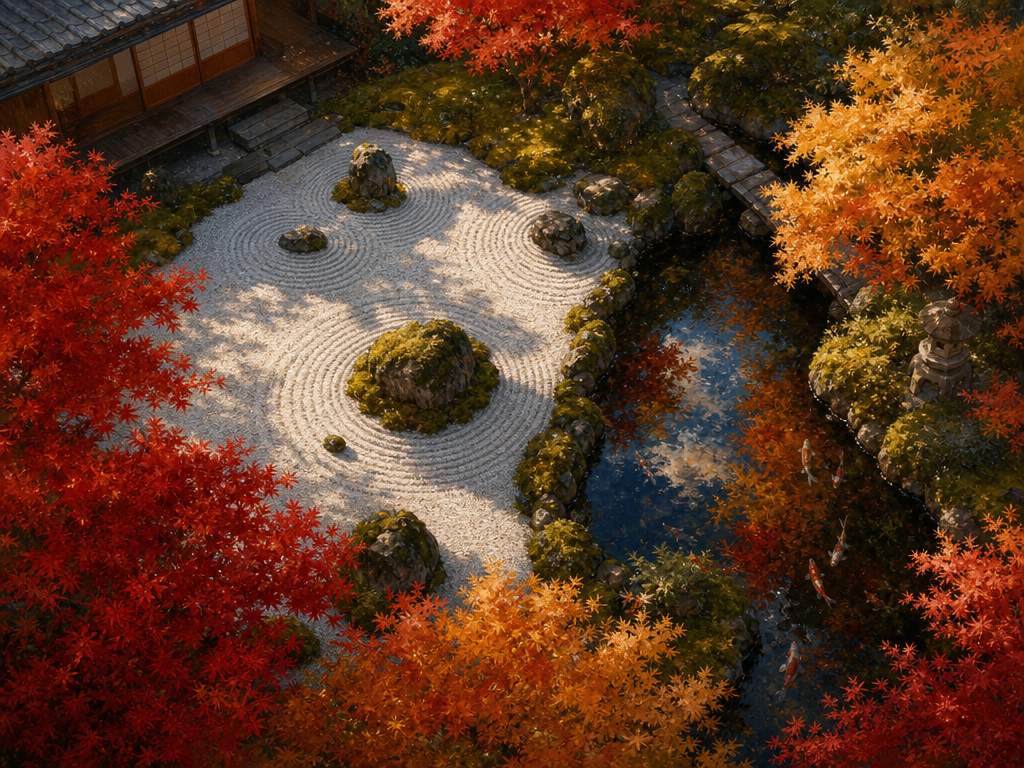
Beachten Sie, wie die Texturdetails in Kies, Moos und Spiegelungen auch bei voller Ausschnittgröße einer genauen Betrachtung standhalten – genau das ist der Effekt der Verbesserungen bei Auflösung und Detailbehandlung.
Seitenverhältnis und Auflösung wählen
Die Ausgabeform wird von zwei input-Feldern gesteuert, nicht von einem einzelnen Pixel-String: aspect_ratio legt die Leinwandform fest, resolution die Detailstufe (1K, 2K, 4K). Die drei häufigsten Formen:
"aspect_ratio": "1:1"– quadratisch. Der Standard für Social-Media-Posts, Thumbnails und In-App-Vorschauen."aspect_ratio": "3:2"– quer. Hero-Banner, Blog-Cover, breite Kompositionen."aspect_ratio": "2:3"– hochkant. Mobile-First-Bilder, Poster, Produktkarten.
Der Preis pro Bild steigt mit der Auflösungsstufe (1K → 2K etwa +33 %, 1K → 4K etwa doppelt so viel). Standardmäßig 1K verwenden und nur dann hochstufen, wenn der endgültige Verwendungszweck es wirklich erfordert – Druck, großformatige Displays oder Produktfotografie mit extrem hohen Detailanforderungen. Wer gewohnheitsmäßig 4K wählt, zahlt doppelt für Pixel, die niemand zu sehen bekommt.
Wo das Modell seine Bandbreite zeigt
Ein Grund, warum gpt-image-2 frühere Workflows ablöst, ist nicht die fotorealistische Ausgabe – sondern die Bandbreite. Dasselbe Modell verarbeitet aus derselben Prompt-Struktur malerischen Impressionismus, dekorative Illustration, Verpackungs-Mockups und redaktionelle Fotografie. Man muss nicht mehr wie früher im Voraus ein „Stilmodell“ auswählen.
Ein einzelner Illustrationsstil-Prompt, ohne Fine-Tuning, ohne stilspezifischen Adapter:
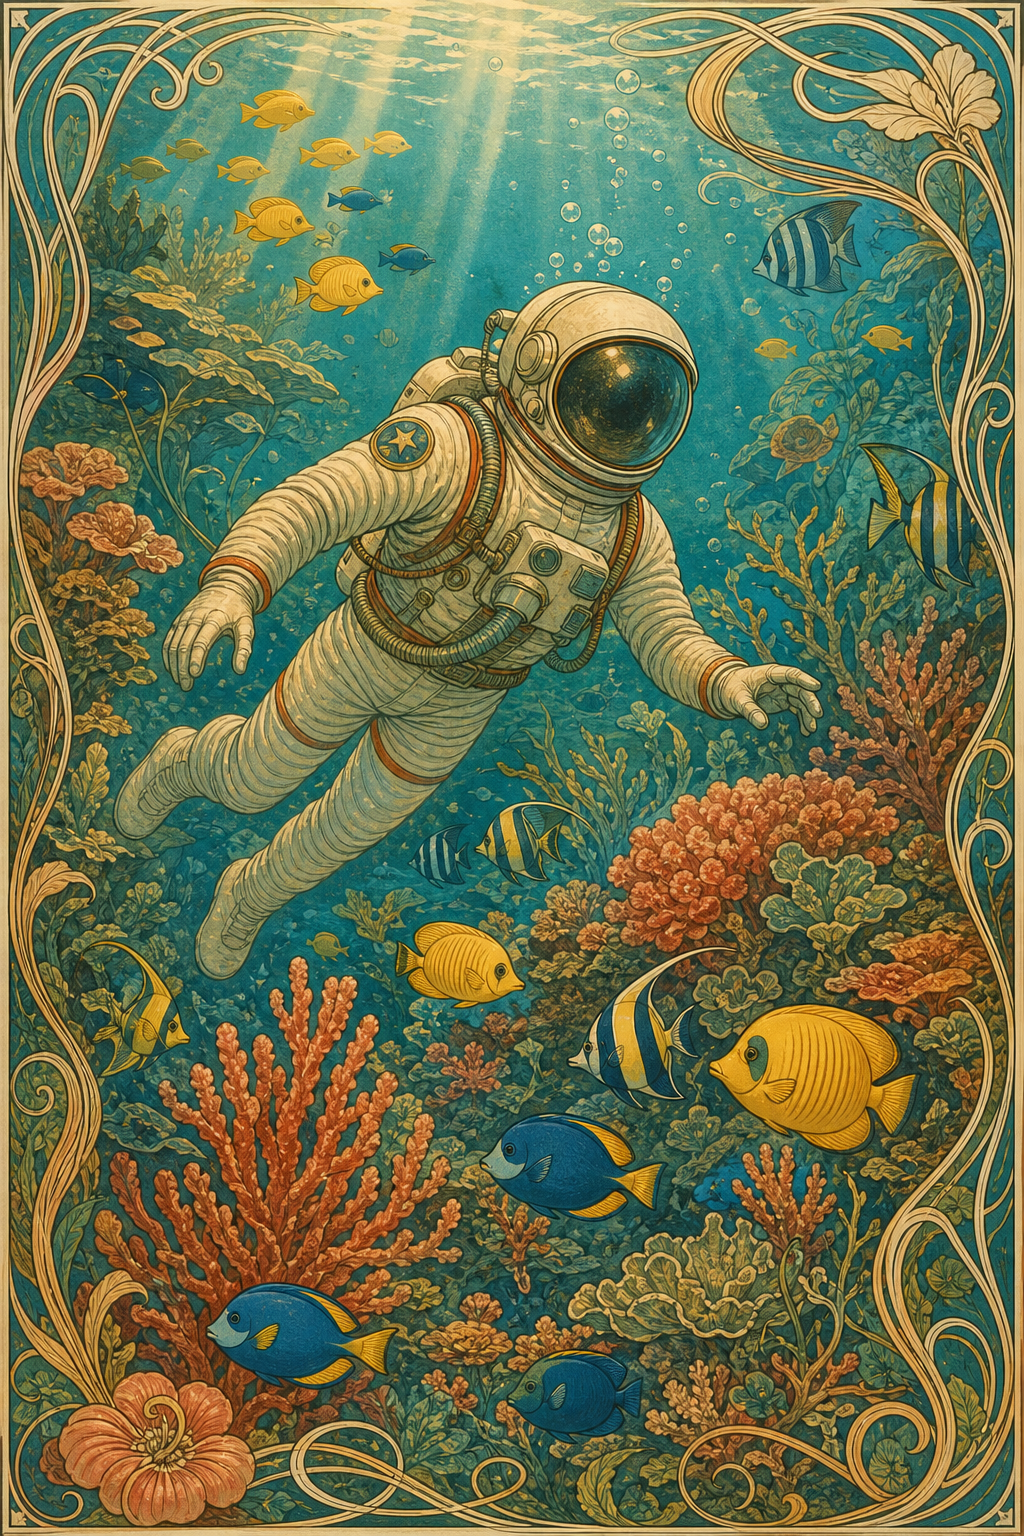
Für Workflows, die auf diese Stilflexibilität angewiesen sind – etwa um für dasselbe Produktlisting sowohl fotorealistische Produktbilder als auch illustrierte Lifestyle-Bilder zu erzeugen – bedeutet ein einziges Modell von Anfang bis Ende eine Prompt-Vorlage, eine Kostenlinie, einen Upgrade-Pfad.
Praktische Tipps für die Migration von ChatGPT zur API
Bevor Sie dies in ein Produkt einbauen, lohnt es sich, einige Dinge zu wissen:
- Prompts unverändert aus ChatGPT zu übernehmen funktioniert meist. Wenn Sie in ChatGPT bereits einen Prompt iteriert haben, der zufriedenstellende Ergebnisse liefert, fügen Sie ihn in den API-Aufruf ein – das Modell ist dasselbe. Sie brauchen keinen separaten „API-Stil-Prompt“.
- Geduldig abfragen – oder Callback verwenden. Je nach Modell und Auflösung dauert die Generierung von Anfang bis Ende weiterhin 1–3 Minuten, aber die asynchrone API bedeutet, dass keine lang geöffnete HTTP-Verbindung in ein Timeout läuft. Fragen Sie alle paar Sekunden ab oder setzen Sie beim Erstellen der Aufgabe
callback.url, damit hiapi Sie bei Abschluss benachrichtigt. - Nach Prompt + Seitenverhältnis + Auflösung cachen. Wenn Ihr Produkt häufig dieselben Prompts anfordert (vorlagenbasierte Mockups, A/B-Variantengenerierung), halten Sie einen inhaltsadressierten Cache bereit – gleiche Eingabebytes, gleiche Ausgabe, ohne doppelt zu zahlen.
- Stufe nach Anwendungsfall wählen, nicht nach Anwendung. Für In-App-Vorschauen und Massenentwürfe, bei denen Kosten wichtiger sind als die letzten 5 % Qualität,
gpt-image-2-beta($0.02) verwenden; für finales Materialgpt-image-2(oder pro). Der Prompt bleibt unverändert – prüfen Sie nur dasinput-Feld der Variante (Beta akzeptiert Pixel-size, das Flaggschiff akzeptiertaspect_ratio+resolution). - Textdarstellung testen, bevor Sie Text veröffentlichen. Die neue Serie meistert Typografie gut, aber ungewöhnliche Schriftarten und extrem lange Zeichenketten driften gelegentlich noch ab. Wenn eine Posterüberschrift markenkritisch ist, generieren Sie zwei bis drei und wählen Sie die beste aus – das ist weit günstiger, als das Problem erst nach der Veröffentlichung zu entdecken.
Fazit
Die neue ChatGPT-Bilderfahrung ist auf API-Ebene tatsächlich die gpt-image-2-Serie – gpt-image-2, gpt-image-2-pro und die günstige Variante gpt-image-2-beta –, bereitgestellt über einen asynchronen Task-Endpunkt. Wenn Sie darauf gewartet haben, diese Bildqualitätsgeneration in Ihr eigenes Produkt zu bringen, ist der Integrationsaufwand gering: Prompt an /v1/tasks senden, Task-ID abfragen, URL herunterladen. Die oben gezeigten Ausgaben wurden genau so erzeugt.
Beginnen Sie mit gpt-image-2 bei 1:1 / 1K – $0.03 pro Generierung, was die meisten realen Anwendungsfälle abdeckt. Durchsuchen Sie die vollständige Aufstellung der Bild- und Videomodelle auf der hiapi-Preisseite oder gehen Sie direkt zur GPT Image 2-Modellseite, um Ihre erste Anfrage zu senden.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte