
Guia de uso
Geração de imagens do ChatGPT: o que mudou e como criá-la programaticamente
Detalhamento dos recursos mais recentes de imagem do ChatGPT e de como entregar resultados equivalentes a partir do seu próprio código
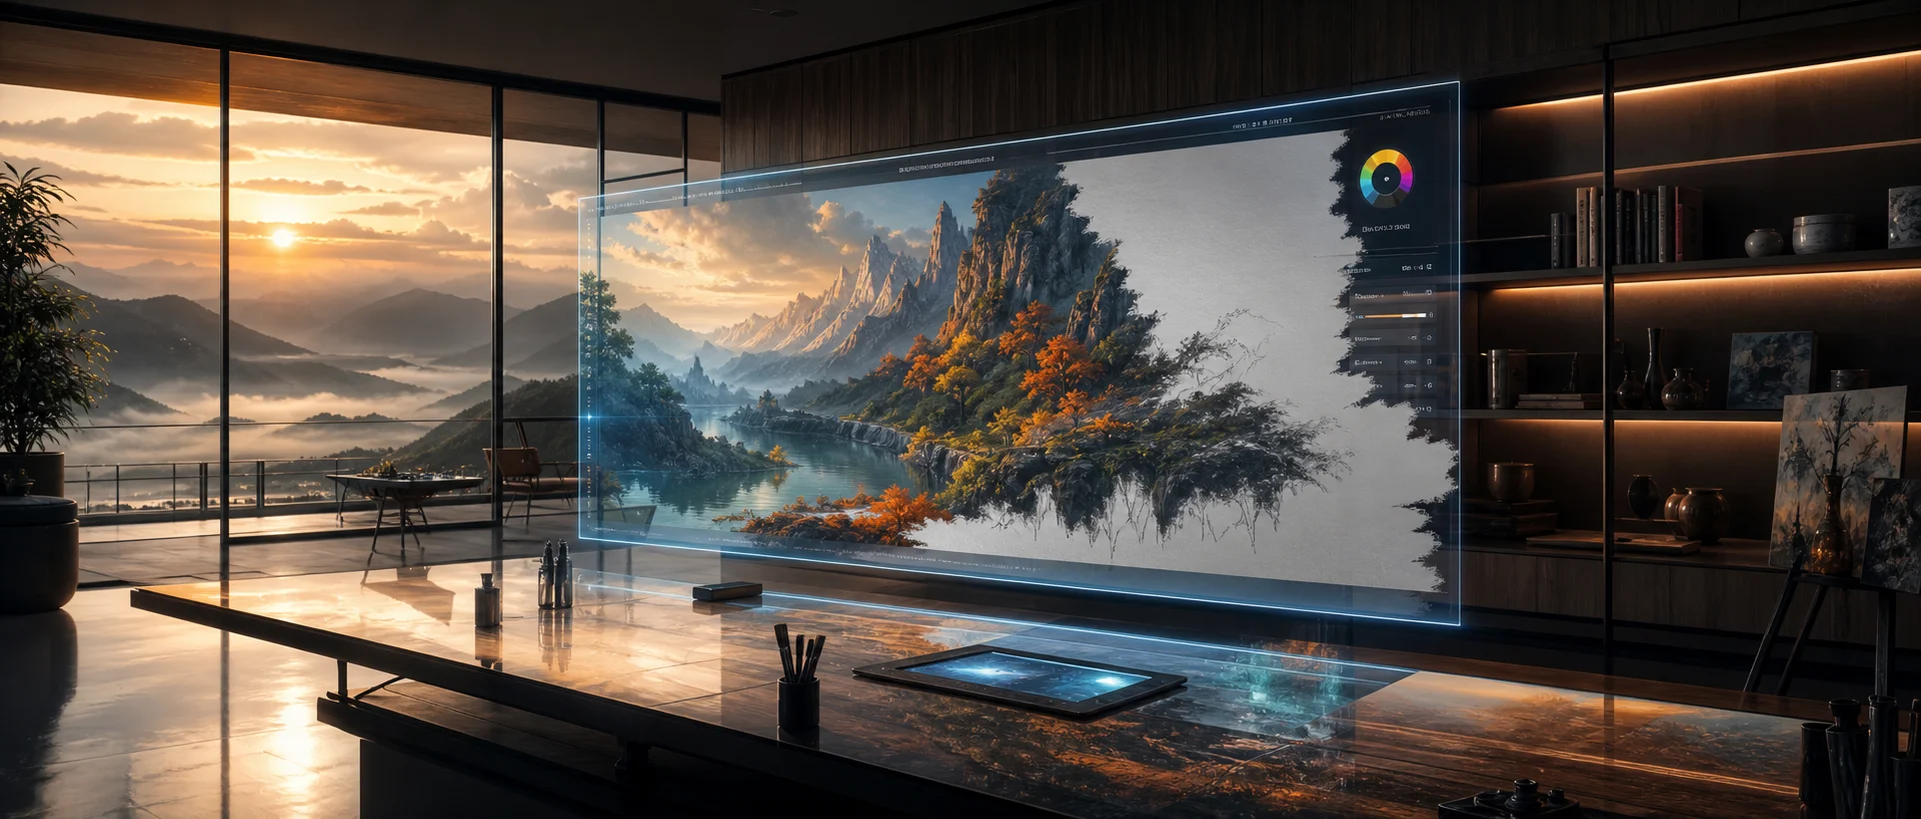
Se você usou o ChatGPT recentemente para geração de imagens, notará que a experiência mudou. A renderização de texto agora é nítida e limpa, em vez de derreter em rabiscos confusos. Os personagens permanecem consistentes entre várias edições. A proporção de aspecto é mais fácil de controlar. A saída parece mais próxima de um trabalho final entregue por um designer experiente — e não de um rascunho confuso.
Esse refinamento subjacente vem da família GPT Image 2 — a geração de modelos de imagem da OpenAI que substituiu a anterior GPT Image 1.5 (retirada da plataforma em junho de 2026). A boa notícia para desenvolvedores é: você não precisa passar pelo ChatGPT para obter a mesma saída. Os mesmos modelos estão disponíveis por meio de uma API de tarefa assíncrona simples. Este guia detalha as mudanças reais e fornece o código mínimo para reproduzir resultados equivalentes a partir do seu próprio aplicativo.
O que mudou na geração de imagens do ChatGPT
As melhorias visíveis no produto ChatGPT derivam de três atualizações no nível do modelo:
- Renderização de texto mais nítida. Os modelos de imagem anteriores apenas aproximavam letras e raramente produziam títulos legíveis. A nova série renderiza tipografia de forma confiável — incluindo maiúsculas/minúsculas personalizadas, várias linhas e fontes estilizadas. Pôsteres, mockups e diagramas anotados finalmente se tornaram utilizáveis.
- Melhor consistência de personagens e cenas. As entradas de referência e as saídas anteriores são seguidas com mais cuidado. Fazer edições iterativas (mesmo personagem, nova pose; mesmo pôster, novo título) não exige mais regenerar toda a composição.
- Resolução e detalhes mais altos. A saída agora pode chegar a 4K, com tratamento de textura visivelmente mais refinado — poros, tecidos, folhagens, ranhuras de cascalho — coisas que antes ficavam embaçadas.
Um teste de estresse rápido para o ponto da tipografia, gerado pela chamada de API mostrada abaixo:
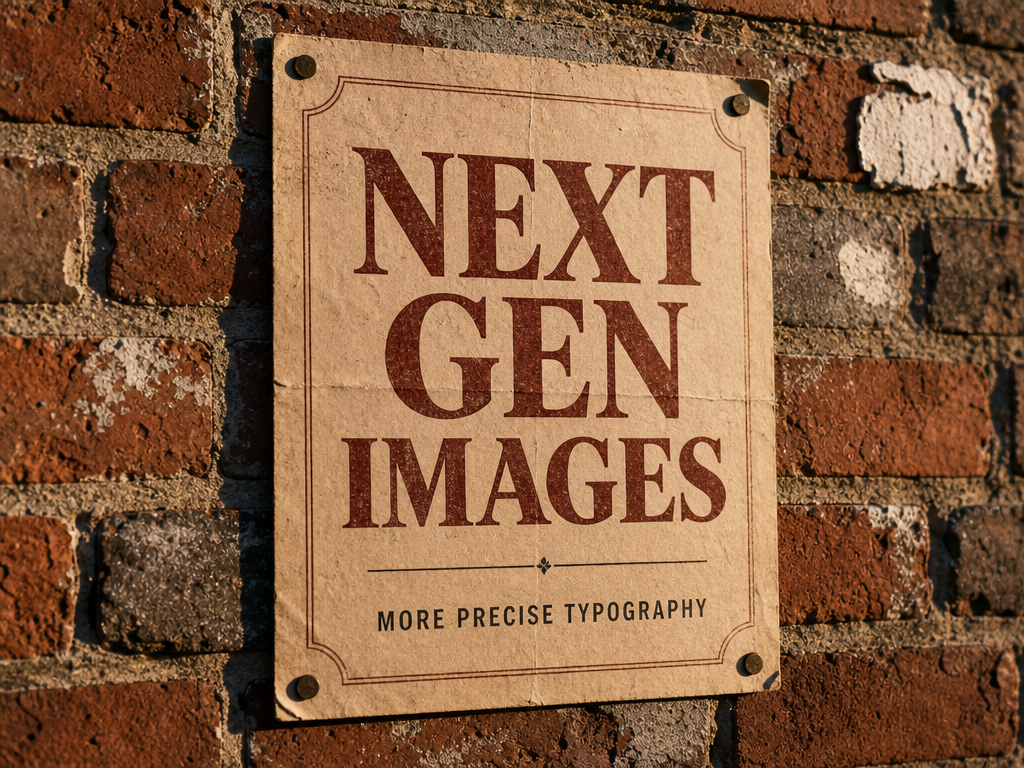
Cada letra está correta. Sem grafias quebradas, sem glifos distorcidos. Essa é a principal diferença em relação à geração anterior.
Os modelos por trás da atualização
A família GPT Image 2 impulsiona a nova experiência de imagem do ChatGPT, e cada variante está disponível pela mesma API. As compensações são:
| Modelo | Mais adequado para | Preço por imagem (1K) |
|---|---|---|
gpt-image-2-beta |
Prototipagem rápida, variantes de rascunho, pipelines de alto volume | $0.02 |
gpt-image-2 |
Produção geral, equilíbrio entre qualidade e custo | $0.03 |
gpt-image-2-pro |
Saídas exigentes, onde confiabilidade importa mais que custo | $0.35 |
Alguns pontos menos intuitivos:
gpt-image-2foi lançado mais barato do que o modelo que substituiu — o GPT Image 1.5 custava $0.05 por imagem antes de ser retirado. A queda de preço reflete um pipeline mais eficiente, não uma concessão de qualidade —gpt-image-2é o carro-chefe atual para a maioria dos fluxos de trabalho.gpt-image-2-proé a variante ajustada para estabilidade: menor variância entre execuções, maior aderência ao prompt e menos tentativas necessárias em produção. Use-a quando “a primeira geração precisa ser entregável” for uma necessidade real.- Cada variante recebe os mesmos campos de prompt pelo mesmo endpoint de tarefas, então trocar de modelo exige apenas alterar o nome do modelo e verificar o campo
inputdessa variante.
Para o detalhamento completo por resolução desses níveis — preços em 1K, 2K e 4K — consulte o guia de preços da API GPT Image 2.
Chamando os modelos a partir do seu código
Todos os modelos na plataforma hiapi — imagem e vídeo igualmente — usam a mesma API de tarefa assíncrona unificada: POST /v1/tasks cria uma tarefa de geração e retorna imediatamente o ID da tarefa, depois GET /v1/tasks/:id informa o status e fornece a URL de saída quando concluída. Os parâmetros específicos do modelo ficam dentro do objeto input. Duas chamadas, sem SDK.
Python
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

# 1. Criar a tarefa
resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": "A modern minimalist digital art studio at dawn, "
                  "a floating holographic canvas displaying a half-painted "
                  "vibrant landscape, cinematic ultrawide, photorealistic",
        "aspect_ratio": "3:2",
        "resolution": "1K",
    },
})
task_id = resp.json()["data"]["taskId"]

# 2. Consultar até a tarefa entrar em estado terminal
while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

# 3. Baixar o resultado
image_url = task["output"][0]["url"]
open("output.png", "wb").write(requests.get(image_url).content)
Essa é a integração completa. As imagens concluídas chegam em output[] como URLs para download — sem decodificação base64. Um ponto de atenção: cada saída traz um carimbo de data/hora expireAt, então baixe o arquivo (ou armazene novamente) em vez de fazer hotlink da URL. Se você preferir não fazer polling, pode passar um objeto callback ao criar a tarefa, e o hiapi enviará um POST ao seu servidor quando a tarefa for concluída.
curl
# Criar a tarefa
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2/text-to-image",
    "input": {
      "prompt": "An aerial view of a Japanese zen garden in autumn, raked white gravel, koi pond, painterly impressionist style",
      "aspect_ratio": "1:1",
      "resolution": "1K"
    }
  }'
# => { "code": 200, "data": { "taskId": "tk-hiapi-..." } }

# Consultar o resultado e depois baixar
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_KEY" \
| jq -r '.data.output[0].url' \
| xargs curl -o output.png
O resultado da execução ponta a ponta desse prompt:
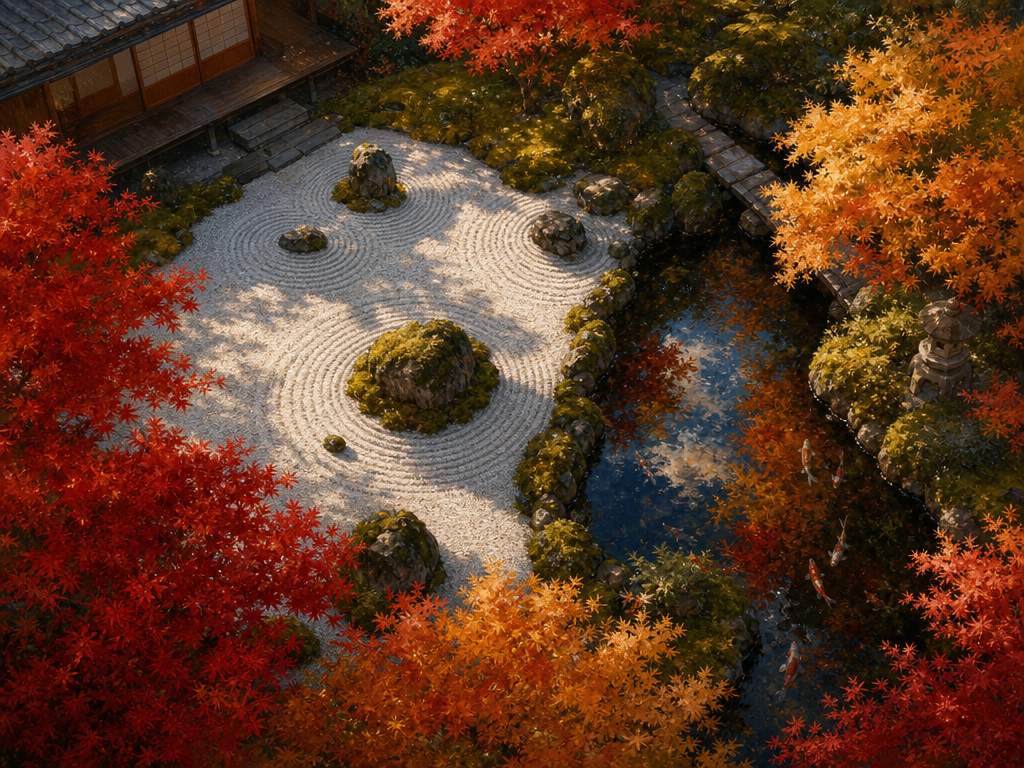
Observe como os detalhes de textura no cascalho, no musgo e nos reflexos resistem a um recorte completo — esse é o efeito das melhorias de resolução e tratamento de detalhes.
Escolhendo proporção de aspecto e resolução
A forma da saída é controlada por dois campos de input, em vez de uma única string de pixels: aspect_ratio define a forma da tela, e resolution define o nível de detalhe (1K, 2K, 4K). As três formas mais comuns:
"aspect_ratio": "1:1"— quadrado. Padrão para posts em redes sociais, miniaturas e pré-visualizações em apps."aspect_ratio": "3:2"— horizontal. Banners principais, capas de blog, composições amplas."aspect_ratio": "2:3"— vertical. Imagens com foco em mobile, pôsteres, cartões de produto.
O preço por imagem aumenta com o nível de resolução (1K → 2K cerca de +33%, 1K → 4K aproximadamente o dobro). Use 1K por padrão e só suba de nível quando o uso final realmente exigir — impressão, exibição em grande formato ou fotografia de produto com requisitos extremos de detalhe. Escolher 4K por hábito gera uma conta dobrada por pixels que ninguém verá.
Onde o modelo mostra sua amplitude
Um dos motivos pelos quais gpt-image-2 está substituindo fluxos de trabalho anteriores não é a saída fotorrealista — é a amplitude. O mesmo modelo consegue lidar com impressionismo pictórico, ilustração decorativa, mockups de embalagem e fotografia editorial com a mesma estrutura de prompt. Você não precisa mais pré-selecionar um “modelo de estilo” como antes.
Um único prompt de estilo de ilustração, sem ajuste fino, sem adaptador específico de estilo:
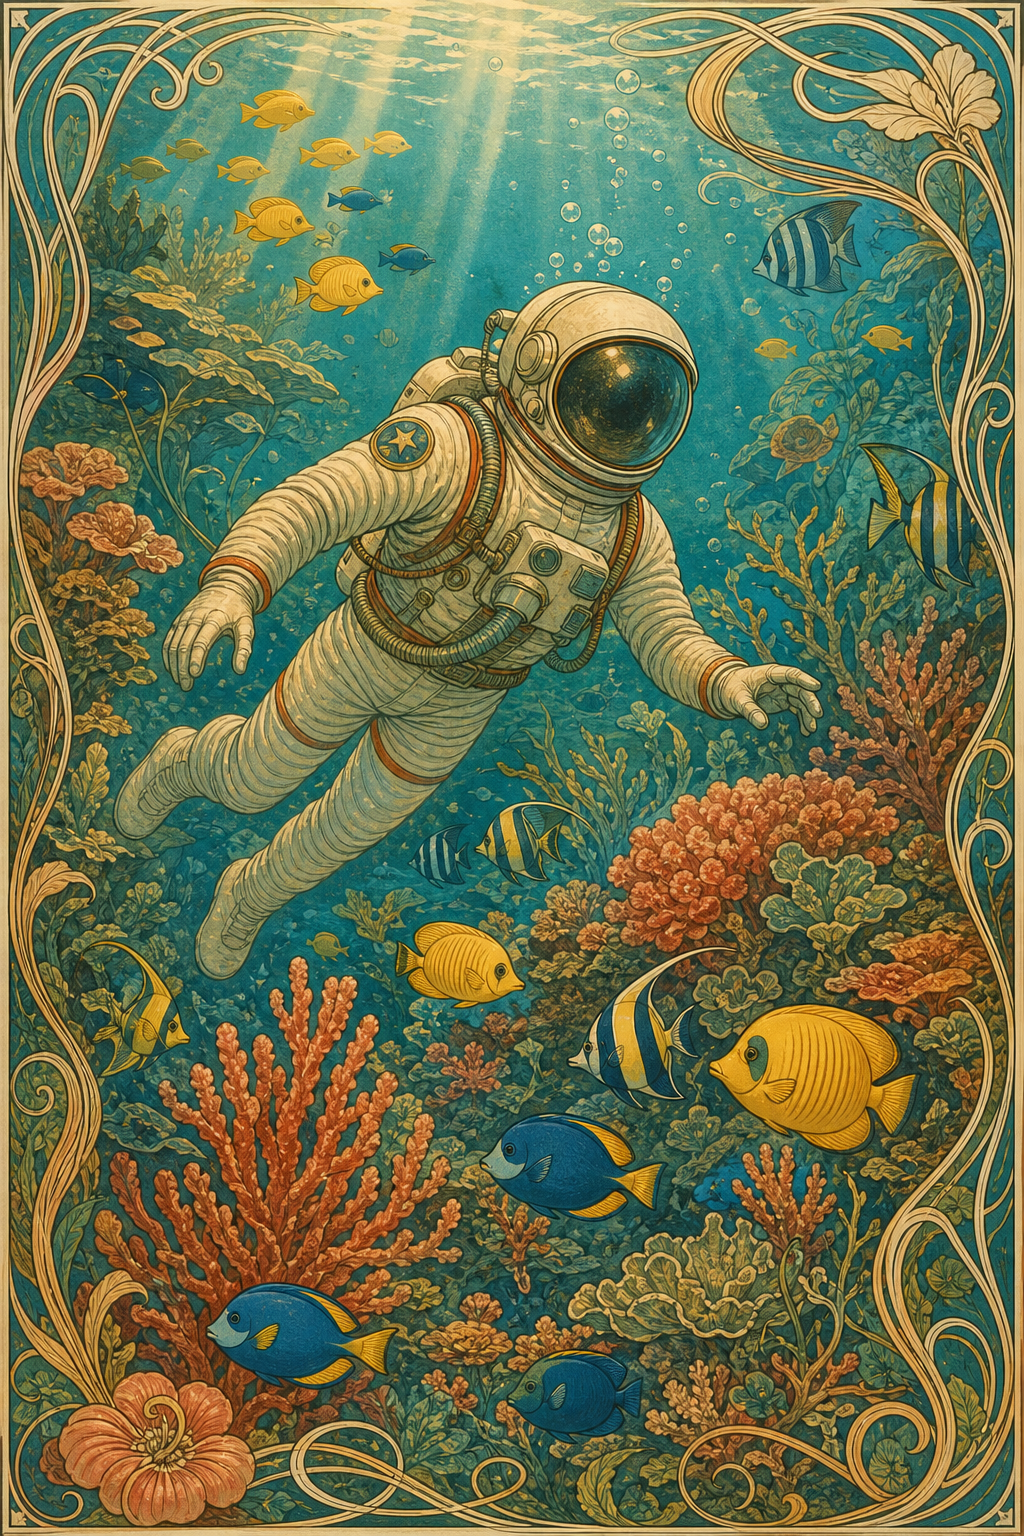
Para fluxos de trabalho que dependem dessa flexibilidade de estilo — por exemplo, gerar ao mesmo tempo uma imagem de produto fotorrealista e uma imagem de estilo de vida ilustrada para o mesmo anúncio de produto — manter um único modelo de ponta a ponta significa um único template de prompt, uma linha de custo e um caminho de upgrade.
Dicas práticas para migrar do ChatGPT para a API
Antes de integrar isso ao seu produto, vale saber algumas coisas:
- Copiar prompts do ChatGPT normalmente funciona. Se você já iterou no ChatGPT um prompt que produz resultados satisfatórios, cole-o na chamada de API — o modelo é o mesmo. Você não precisa de um “prompt no estilo da API” separado.
- Faça polling com paciência — ou use callback. Dependendo do modelo e da resolução, a geração ainda leva de 1 a 3 minutos de ponta a ponta, mas a API assíncrona significa que nenhuma conexão HTTP de longa duração vai expirar. Faça polling a cada poucos segundos ou configure
callback.urlao criar a tarefa e deixe o hiapi notificar você na conclusão. - Faça cache por prompt + proporção de aspecto + resolução. Se o seu produto solicita prompts comuns repetidamente (mockups orientados por template, geração de variantes A/B), mantenha um cache endereçado por conteúdo — mesmos bytes de entrada, mesma saída, sem pagar duas vezes.
- Escolha o nível por caso de uso, não por aplicação. Para pré-visualizações no produto e rascunhos em alto volume, onde custo importa mais que os últimos 5% de qualidade, use
gpt-image-2-beta($0.02); para material final, usegpt-image-2(ou pro). Os prompts podem ser os mesmos — basta verificar o campoinputda variante (beta aceitasizeem pixels, o carro-chefe aceitaaspect_ratio+resolution). - Teste a renderização de texto antes de publicar o material. A nova série lida bem com tipografia, mas fontes não convencionais e strings muito longas ainda podem variar ocasionalmente. Se o título de um pôster for crítico para a marca, gere duas ou três imagens e escolha a melhor — isso custa muito menos do que descobrir o problema depois de publicar.
Resumo
A nova experiência de imagem do ChatGPT, no nível da API, é na prática a família gpt-image-2 — gpt-image-2, gpt-image-2-pro e a versão econômica gpt-image-2-beta — servida por um endpoint de tarefa assíncrona. Se você estava esperando para trazer essa geração de qualidade de imagem para o seu próprio produto, a integração é pequena: envie o prompt por POST para /v1/tasks, consulte o ID da tarefa e baixe a URL. As saídas acima foram geradas exatamente assim.
Comece com gpt-image-2 em 1:1 / 1K — $0.03 por geração, o que cobre a maioria dos casos de uso reais. Navegue pela linha completa de modelos de imagem e vídeo na página de preços do hiapi, ou vá direto à página do modelo GPT Image 2 para enviar sua primeira requisição.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores