
Tutoriel
flux-3-video en pratique : 5 cas d'usage à forte valeur et points clés de mise en œuvre
Des trois modes d'entrée aux 5 scénarios concrets, avec coûts et liste de dépannage
Pourquoi distinguer les trois modes de génération vidéo dès la phase de sélection
Un modèle vidéo semble se résumer à « on saisit une description, il sort une vidéo », mais flux-3-video propose simultanément trois modes d'entrée : text-to-video, image-to-video et video-to-video. Ces trois voies diffèrent fortement en termes de sémantique produit, d'exigences sur les médias, de modes d'échec et de structure de coûts. Si l'on ne fait pas cette distinction au moment du choix, la conséquence la plus fréquente est la suivante : l'API est branchée, la démo tourne, mais au moment de l'intégration réelle en production, on découvre que la chaîne de médias ne correspond pas et il faut tout recommencer.
Le contrat d'entrée et de sortie des trois modes
- text-to-video : l'entrée est un prompt purement textuel, la sortie est une vidéo générée librement par le modèle. Aucun média préalable n'est nécessaire, le plafond créatif est élevé, mais la contrôlabilité est la plus faible — plusieurs appels avec le même prompt produisent naturellement des contenus visuels divergents. Adapté aux cas où « aucun média n'est disponible » ou « il faut une grande quantité d'images non répétitives ».
- image-to-video : l'entrée est une image de référence (ou un ensemble d'images) accompagnée d'un prompt textuel, la sortie est une vidéo qui prend cette image comme point d'ancrage visuel. La contrôlabilité vient de l'image elle-même : le sujet, la composition et les teintes sont verrouillés par l'image, le modèle se charge d'y insuffler le mouvement. Adapté aux équipes disposant déjà d'une banque d'images et devant maintenir une cohérence visuelle de marque.
- video-to-video : l'entrée est une vidéo source accompagnée d'instructions de transformation, la sortie conserve la structure temporelle et le rythme de mouvement de la source, mais réécrit le style ou les spécifications. C'est la voie la plus « industrialisée », car la structure de durée en entrée et en sortie est prévisible, ce qui facilite le traitement par lots et la validation.
Utiliser « le média existe-t-il ? » comme premier filtre
En pratique, le critère de tri le plus rapide n'est pas la capacité technique, mais une simple question : de quels médias l'équipe dispose-t-elle aujourd'hui ?
Sans aucun média, avec seulement un texte et une direction créative, text-to-video est le point de départ le moins coûteux ; avec des visuels de produits, des affiches, des illustrations et autres ressources statiques, image-to-video augmente sensiblement le taux de réutilisation de ces ressources ; avec des films déjà montés qu'il faut adapter à plusieurs canaux ou unifier stylistiquement, c'est le terrain de video-to-video. À l'inverse, si l'équipe ne dispose que de texte et force video-to-video, ou ne dispose que de films montés et espère répliquer un contenu existant via text-to-video, elle multipliera les retouches au stade de la validation.
Le compromis entre contrôlabilité et coût d'itération
Les coûts d'itération des trois modes ne sont pas identiques. Pour text-to-video, chaque ajustement impose de modifier le prompt et de régénérer : le coût d'essai-erreur est élevé, mais le seuil d'un appel individuel est bas ; pour image-to-video, le levier d'ajustement est l'image, et changer d'image est souvent plus efficace que modifier le texte ; pour video-to-video, l'ajustement est le plus localisé, il suffit généralement de préciser ce qu'il faut changer. Intégrer dans le choix la question « combien de cycles de retouche prévoyons-nous par média ? » rapproche davantage du coût réel de mise en œuvre que la simple comparaison des résultats.
Une fois ces trois frontières clarifiées, les cinq scénarios ci-dessous trouvent chacun leur place.
Scénario 1 : production en série de vidéos courtes produit et marketing
C'est le type de scénario où le retour sur investissement du modèle vidéo est le plus direct : convertir en série des médias produits et des textes marketing en vidéos courtes, destinées au placement en fil d'actualité, aux pages de détail produit et à la diffusion sur les réseaux sociaux. Le processus traditionnel exige tournage, montage et musique, autant d'étapes que la génération par modèle compresse en « médias + prompt → vidéo ».
Quel mode choisir
Les équipes disposant d'images produit privilégient image-to-video : avec l'image principale du produit comme point d'ancrage, on fait naître un léger mouvement orbital, des jeux de lumière ou des changements de scène, sans déformer le sujet et en gardant la cohérence visuelle de marque. Pour un produit entièrement nouveau ou conceptuel, sans même d'image, on utilise text-to-video pour générer d'abord une vidéo d'ambiance conceptuelle, comme présentation du projet avant tournage.
Les points d'ingénierie de la production en série
L'essence de la production en série n'est pas « l'appel en boucle », mais la paramétrisation des parties variables. Il est conseillé de décomposer une vidéo produit en trois couches :
- Couche immuable : teintes de marque, ratio d'image, éléments interdits, inscrits dans un préfixe de prompt unifié.
- Couche variable : nom du produit, arguments de vente, description de scène, injectés ligne par ligne depuis la table de données produit.
- Couche de post-traitement : générique d'ouverture et de fin, sous-titres, filigrane, à superposer après la génération, afin d'éviter de consommer à chaque fois de la durée de génération.
Pilotez les tâches par lots via une file d'attente : l'échec d'une tâche individuelle ne doit pas bloquer tout le lot ; chaque enregistrement conserve le prompt, l'identifiant du média d'entrée et l'adresse de sortie, pour pouvoir retracer quelle version de média donne le meilleur résultat.
Critères de validation
La validation de la production en série doit être quantifiable : le sujet produit est-il identifiable, y a-t-il des déformations manifestes, des textes illisibles indésirables apparaissent-ils à l'image, la durée respecte-t-elle les limites de la plateforme de diffusion. Il est conseillé de lancer d'abord un petit lot avec contrôle manuel par échantillonnage, de confirmer la stabilité du modèle de prompt, puis d'augmenter les volumes.
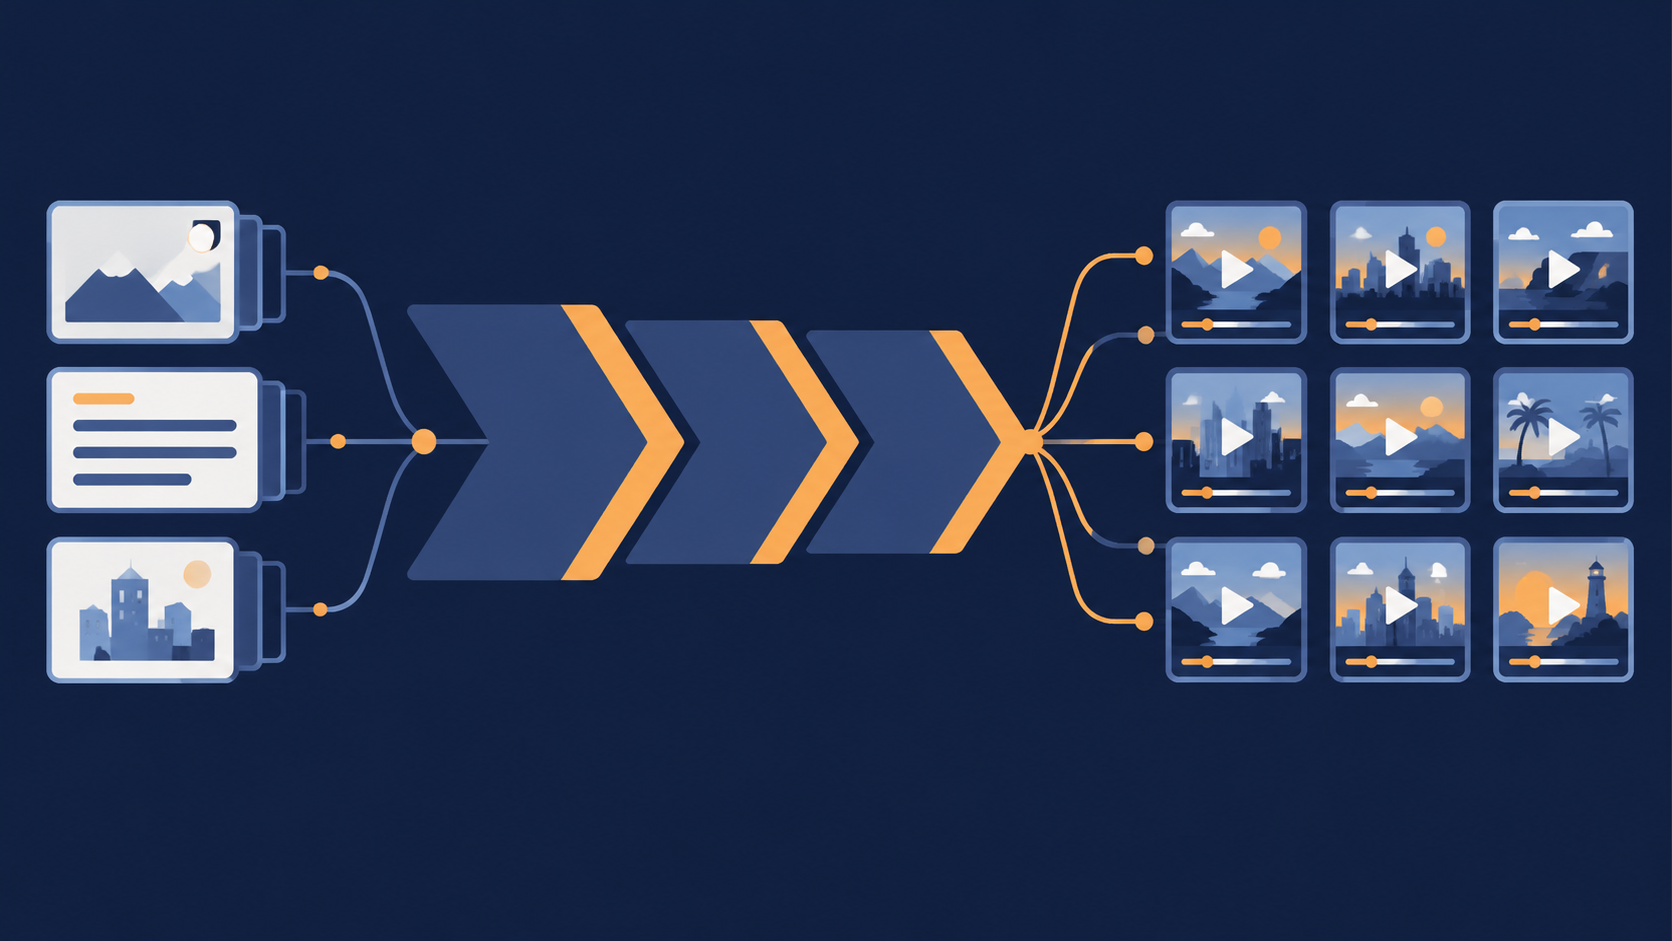
Scénario 2 : animer des médias statiques avec image-to-video
Beaucoup d'équipes ne disposent pas de médias vidéo, mais accumulent une grande quantité de ressources statiques : images produit, illustrations, affiches, couvertures de cours, visuels principaux d'événements. Ces médias sont naturellement désavantagés dans les fils d'actualité — une image statique est souvent balayée d'un geste dans un flux à lecture automatique. Les animer est le type d'usage au coût le plus faible et à l'effet le plus rapide.
Où réside la valeur
Le bénéfice principal de l'animation n'est pas de « rendre plus beau », mais d'augmenter le temps d'arrêt et le taux de clic des médias dans le fil. Une vidéo courte dérivée d'une même image principale peut participer indépendamment à un test AB comme média de diffusion, ce qui ajoute une dimension de test sur un même actif. Pour les activités à base de banques d'images (e-commerce, contenu, éducation), cela équivaut à libérer à nouveau la valeur résiduelle des médias historiques.
Points d'attention pour la mise en œuvre
- Dosez l'amplitude du mouvement. Le piège le plus fréquent d'image-to-video est une amplitude excessive qui déforme le sujet. Le prompt doit préciser des limites comme « léger », « lent », et décrire la source du mouvement (travelling de caméra, variation de lumière, flottement d'éléments locaux), plutôt que de demander vaguement de « faire bouger ».
- La première image est la couverture. Dans un fil d'actualité, c'est la première image de la vidéo qui est vue en premier ; il faut donc sélectionner l'image selon le critère « cette image fonctionne-t-elle seule comme couverture ? », et non choisir une image qui n'est belle qu'en mouvement.
- Prévoyez de l'espace dans la composition. Si l'image d'origine est très remplie, le mouvement risque de rogner des informations en bordure ; privilégiez les médias dont le sujet est centré avec des marges autour.
Comment évaluer le bénéfice
Il est conseillé d'évaluer selon deux dimensions : le « taux de réutilisation des médias » et le « coût de test par média ». Quelle proportion d'un lot d'images existantes se prête à l'animation, et de combien le coût de génération d'un média animé baisse-t-il par rapport à un nouveau tournage. Une fois ces deux chiffres établis, les équipes à base de banques d'images en font généralement un processus de production de médias régulier, plutôt qu'une expérience ponctuelle.
Scénario 3 : adapter le style et les spécifications des médias via video-to-video
Lorsqu'une équipe dispose déjà d'un média vidéo performant, la vraie question devient souvent : comment l'adapter à tous les canaux. Passer du paysage au portrait, raccourcir un long film, unifier le style visuel, produire des versions localisées par région — ces tâches étaient traditionnellement traitées une à une par un monteur, et video-to-video en fait un traitement par lots orchestr able.
Usages typiques
- Un montage, plusieurs canaux : à partir d'un film principal comme source, produire en série des versions adaptées aux différents emplacements de diffusion, en conservant le rythme et la structure narrative de l'original, en ne modifiant que le ratio d'image et le centre de gravité de la composition.
- Unification stylistique : aligner des médias historiques au ton hétérogène sur le style de marque actuel, pour réduire les ruptures visuelles dans la banque de médias.
- Adaptation aux spécifications : réécrire uniformément selon les exigences de durée, de format et de définition de chaque plateforme.
Confirmer les contraintes en amont
La sortie de video-to-video est la plus contrainte par la vidéo source : la durée, la complexité du mouvement et la qualité d'image de la source se transmettent à la sortie. Il faut donc, avant la mise en ligne, préciser les exigences métier sur la durée maximale de sortie et le format d'image, puis décider comment découper la source. Surtout, pour transformer un long film en court, il est conseillé de faire un pré-montage grossier côté source, plutôt que de confier tout le long film au modèle pour qu'il fasse lui-même le tri — le modèle ne comprend pas vos priorités narratives.
Conception du traitement par lots
Abstraire une conversion en un triplet « ID de la source + spécifications cibles + instructions de style », consigné dans une table de tâches. Une ligne par canal cible, les résultats nommés et archivés par canal. Ajouter un canal ne revient alors qu'à ajouter une ligne de configuration, et non à refaire tout le processus de montage. Conservez également la correspondance entre source et sortie, pour identifier quel type de réécriture pose problème lorsqu'un canal remonte un mauvais résultat.
Scénario 4 : production rapide de démos produit et d'annonces de fonctionnalités
Les équipes SaaS et outils ont un point de douleur récurrent : chaque version nécessite une vidéo de démonstration, mais les captures d'écran attendent la stabilisation du produit, et le script attend la validation du marketing ; au final, la date de publication est retardée par la vidéo. Le modèle vidéo peut faire passer la première version d'une « démo » de plusieurs jours à quelques heures.
Processus recommandé
- Découper le script en plans : décomposer une démo produit en plusieurs plans d'environ 5 secondes, chaque plan correspondant à une fonctionnalité ou à un cas d'usage. Le découpage en plans est la clé de cette étape, car le modèle contrôle bien mieux le contenu de plans courts que d'une longue narration.
- Générer en mixant texte et images : pour les fonctionnalités abstraites (flux de données, processus collaboratif), utiliser text-to-video pour générer des images conceptuelles ; pour les interfaces réelles et les formes produit, utiliser image-to-video avec une capture d'écran ou une maquette comme point d'ancrage, afin de garantir que l'image produit présentée à l'extérieur reste fidèle.
- Assemblage et voix off : assembler les extraits en post-production, avec voix off, sous-titres et transitions. Ne pas chercher à obtenir « un seul plan continu » au stade de la génération, ce serait à la fois difficile à contrôler et coûteux.
La relecture humaine est indispensable
La priorité absolue d'une vidéo de démonstration produit est de ne pas induire l'utilisateur en erreur. Les images générées par le modèle peuvent faire apparaître des boutons inexistants, des mises en page erronées ou des fonctionnalités fictives. Chaque version d'extrait généré doit donc passer par une relecture humaine côté produit, pour confirmer que les éléments présents à l'image existent dans le produit réel ou sont explicitement signalés comme illustratifs. Il est conseillé d'inscrire la « vérification des éléments visuels » comme point de contrôle fixe, plutôt que de compter sur un coup d'œil au montage.
Limites d'application
Cette voie convient aux annonces de fonctionnalités, démonstrations conceptuelles, médias de compte à rebours de lancement et vidéos de présentation interne ; elle ne convient pas aux tutoriels nécessitant une reproduction précise des étapes d'opération. Les contenus de type tutoriel doivent rester principalement des captures d'écran réelles, la génération par modèle ne servant qu'à l'habillage et aux transitions.
Scénario 5 : médias dynamiques et expérimentations créatives pour les plateformes de contenu
Les besoins des équipes contenu et croissance diffèrent des quatre catégories précédentes : elles ne manquent pas d'un bon média, mais de nombreuses directions testables. La facturation à la seconde des modèles vidéo s'accorde justement avec ce rythme d'essai-erreur à petite échelle — extraits courts, directions multiples, élimination rapide.
Faire de l'expérimentation une boucle fermée
Un processus d'expérimentation créative durable se déroule généralement ainsi : à partir d'un thème ou d'un sujet d'actualité, générer en une fois plusieurs extraits courts, chacun représentant une direction visuelle ou un angle narratif différent ; après diffusion, observer les premières données, conserver les directions prometteuses pour itérer, abandonner directement les autres. L'essentiel est que chaque cycle d'expérimentation soit de petite taille et chaque extrait court, pour que le coût d'un cycle d'essai-erreur soit suffisamment bas, assez bas pour être répété à haute fréquence.
Trois conseils d'ingénierie
- Fixer les variables : ne modifier qu'une seule dimension par cycle d'expérimentation (style visuel, mode d'ouverture ou rythme), sinon les données ne permettent pas d'attribuer les résultats.
- Consigner les prompts : archiver le prompt et les paramètres de chaque extrait, pour pouvoir reproduire en cas de bon résultat et écarter en cas de mauvais.
- Privilégier les extraits courts : générer des formats courts en phase d'expérimentation, puis allonger et multiplier la direction gagnante une fois qu'elle est validée.
Ce qui convient et ce qui ne convient pas
Convient pour les accroches d'ouverture, les extraits d'ambiance, les visuels de sujets et les animations de couverture ; ne convient pas aux contenus longs nécessitant une narration continue. Positionner le modèle comme une « sonde créative » et non comme une « chaîne de production de contenu » rend les attentes et les critères de validation de l'équipe plus sains.
Estimation des coûts et stratégie d'appel en facturation à la seconde
La facturation des modèles vidéo se fait à la seconde de sortie, ce qui signifie que le coût est directement lié à « durée × nombre de vidéos ». Pour le prix unitaire précis, se référer au panneau tarifaire du site ; nous ne traitons ici que des méthodes de conversion et des leviers de contrôle.
Convertir la facturation en coût métier unitaire
La formule est simple : coût unitaire = nombre de secondes en sortie × prix unitaire par seconde. Multipliez ensuite par les facteurs côté métier — un média de diffusion nécessite généralement plusieurs versions pour les tests AB, le coût réel est donc « coût unitaire × nombre de versions × nombre de cycles d'itération ». Ce sont ces deux derniers multiplicateurs que la plupart des équipes sous-estiment : les générations répétées avant la validation finale coûtent souvent bien plus cher que les quelques vidéos livrées au final.
Quatre leviers de maîtrise des coûts
- Réduire la durée : valider d'abord la direction avec des extraits courts, puis générer la durée complète une fois le choix arrêté. C'est le moyen d'économie le plus efficace, car le coût est linéaire en durée.
- Maîtriser les itérations : peaufiner le modèle de prompt sur de petits lots jusqu'à stabilité, puis augmenter les volumes. Une génération par lots avec un modèle instable est presque un pur gaspillage.
- Procéder par phases : en phase d'exploration, permettre la divergence ; en phase de production, fixer impérativement les paramètres. Les deux phases utilisent des tailles de lots et des critères de validation différents.
- Calculer la concurrence : la limite de concurrence des tâches par lots doit être fixée en fonction du plafond budgétaire ; définir un seuil de coût par lot, suspendre et confirmer manuellement au-delà du seuil, pour éviter qu'un script ne s'emballe.
Définir la stratégie d'appel
Il est conseillé de rendre la « durée » et le « nombre de vidéos » configurables dans le code métier, plutôt que codés en dur. Ainsi, lorsque le budget de diffusion se resserre, il suffit d'ajuster la configuration pour réduire le coût d'un lot, sans modifier le code. Enregistrez également dans les logs la durée et le nombre de vidéos de chaque appel, pour constituer une facture de coûts consultable, facile à répartir par projet ou par canal.
Dépannage de l'intégration et liste de contrôle avant mise en ligne
Les échecs des API vidéo ne se manifestent souvent pas par une « erreur », mais par de la « lenteur » et de l'« instabilité ». Passer en revue les points suivants avant la mise en ligne permet d'éviter la plupart des problèmes en production.
Modes d'échec courants
- Délai d'attente dépassé : la génération vidéo prend nettement plus de temps que le texte et l'image, et le délai d'attente par défaut du client est vite insuffisant. Il faut régler le délai d'attente de la requête à un ordre de grandeur correspondant à la durée de la vidéo, et passer à un mode tâche asynchrone + interrogation périodique, plutôt qu'à une attente synchrone.
- Soumission en double : les nouvelles tentatives automatiques en cas de perturbation réseau peuvent provoquer des générations en double, ce qui amplifie directement le coût. Générez une clé d'idempotence pour chaque tâche, et dédupliquez côté serveur selon cette clé.
- Contenu non conforme ou inutilisable : la sortie peut présenter des déformations du sujet, des textes illisibles ou des images non conformes aux exigences métier. Ces problèmes ne lèvent pas d'exception et ne peuvent être interceptés qu'au stade de la validation.
- Problèmes de médias d'entrée : une image de référence de résolution trop faible ou une composition trop remplie pour image-to-video, un débit insuffisant de la vidéo source pour video-to-video — tout cela dégrade nettement la qualité de sortie. Les médias doivent être vérifiés avant d'entrer dans la file d'attente.
Conception des délais d'attente, des nouvelles tentatives et de la dégradation
Les nouvelles tentatives doivent avoir des limites : ne réessayer que pour les erreurs réseau explicites et les 5xx, avec un nombre maximal et un intervalle d'attente croissant ; ne pas réessayer automatiquement les échecs de contenu, mais passer en traitement manuel. Le plan de dégradation doit être anticipé — en cas d'échec de génération, faut-il revenir à un média statique, à la dernière version disponible, ou simplement ignorer la tâche ? La réponse diffère selon la ligne métier, mais doit être déterminée dès la conception.
Liste de contrôle avant mise en ligne
- La chaîne de tâches asynchrones est-elle complète : soumission, interrogation périodique, délai d'attente, idempotence, enregistrement des résultats.
- La durée et le nombre de vidéos sont-ils configurables, un seuil de coût par lot est-il défini.
- Les médias d'entrée font-ils l'objet d'une vérification de résolution et de format.
- La sortie passe-t-elle par une étape de validation manuelle ou automatique, les critères sont-ils quantifiés.
- Les logs enregistrent-ils le prompt, les paramètres, la durée et l'état de la tâche, permettant de remonter le fil.
- Le chemin de dégradation a-t-il été testé, et pas seulement documenté.
Considérez cette liste comme un garde-fou de publication : le rythme de mise en ligne des fonctionnalités vidéo sera bien plus stable qu'une correction au fil de l'eau. Pour mieux comprendre les limites de flux-3-video, commencez par faire tourner une chaîne minimale sur la page du modèle, puis étendez couche par couche selon les scénarios ci-dessus.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat