
Tutorial
flux-3-video na prática: 5 casos de uso de alto valor e pontos-chave de implementação
Dos três modos de entrada a 5 casos de uso reais, com checklist de custos e solução de problemas
Por que distinguir os três modos de geração de vídeo já na fase de seleção
Um modelo de vídeo parece apenas "inserir uma descrição e receber um vídeo", mas o flux-3-video oferece simultaneamente três modos de entrada: text-to-video, image-to-video e video-to-video. Esses três caminhos diferem muito em semântica de produto, requisitos de material, modos de falha e estrutura de custos. Se não forem bem distinguidos na fase de seleção, a consequência mais comum é: a interface é conectada, o demo funciona, mas na hora de integrar de verdade ao negócio descobre-se que a cadeia de materiais não corresponde, sendo necessário refazer tudo.
Contratos de entrada e saída dos três modos
- text-to-video: a entrada é um prompt puramente textual, a saída é um vídeo gerado livremente pelo modelo. Não requer nenhum material prévio, o teto criativo é alto, mas a controlabilidade é mínima — o mesmo prompt chamado várias vezes gera conteúdos visuais naturalmente divergentes. Adequado a cenários "sem material disponível" ou "necessidade de muitas imagens não repetidas".
- image-to-video: a entrada é uma (ou um conjunto de) imagem de referência mais um prompt textual, a saída é um vídeo que usa essa imagem como âncora visual. A controlabilidade vem da própria imagem: o sujeito, a composição e o tom são fixados pela imagem, e o modelo se encarrega de dar movimento. Adequado a equipes que já possuem um banco de imagens e precisam manter consistência visual da marca.
- video-to-video: a entrada é um vídeo de origem mais uma instrução de conversão, a saída preserva a estrutura temporal e o ritmo de movimento do vídeo de origem, mas reescreve estilo ou especificações. É o caminho mais "engenheirado", pois a estrutura de duração de entrada e saída é previsível, facilitando processamento em lote e validação.
Usar "o material existe?" como primeiro critério de triagem
Na prática, o critério mais rápido de triagem não é olhar a capacidade técnica, mas perguntar: que material o negócio tem em mãos agora?
Sem nenhum material, apenas texto e direção criativa, começar com text-to-video tem o menor custo; com ativos estáticos como fotos de produto, pôsteres e ilustrações, image-to-video eleva significativamente a taxa de reuso desses ativos; já com filmes prontos, precisando de adaptação multicanal ou unificação de estilo, é o território do video-to-video. Por outro lado, se a equipe só tem texto e força o video-to-video, ou só tem filmes prontos e espera replicar conteúdo existente via text-to-video, haverá retrabalho repetido na validação.
Trade-off entre controlabilidade e custo de iteração
Os custos de iteração dos três não são iguais. No text-to-video, cada ajuste exige alterar o prompt e gerar novamente: custo de tentativa e erro alto, mas barreira de chamada individual baixa; no image-to-video, a alavanca de ajuste está na imagem, trocar a imagem costuma ser mais eficaz que mudar o texto; no video-to-video, o ajuste é o mais localizado, geralmente basta indicar o que mudar. Ao selecionar, considerar "quantas rodadas de ajuste prevemos por material" aproxima-se mais do custo real de implementação do que simplesmente comparar resultados.
Definidas essas três fronteiras, os cinco cenários a seguir podem ocupar seus lugares.
Cenário 1: Produção em lote de vídeos curtos de produto e marketing
Este é o tipo de cenário com retorno mais direto do modelo de vídeo: converter em lote materiais de produto e textos de marketing em vídeos curtos, para veiculação em feeds, páginas de detalhe de produto e distribuição em redes sociais. O fluxo tradicional exige filmagem, edição e trilha sonora em várias etapas, enquanto a geração por modelo comprime essa cadeia em "material + prompt → vídeo final"
Qual modo usar
Equipes com fotos de produto devem priorizar image-to-video: usando a foto principal do produto como âncora, gerar movimento lento de órbita, fluxo de luz e sombra ou mudança de cenário, sem deformar o produto e mantendo a consistência visual da marca. Para produtos novos ou conceituais, sem nem imagem, usar text-to-video para gerar primeiro um vídeo de atmosfera conceitual, como demonstração de proposta antes da filmagem.
Pontos de engenharia para lote
A essência do lote não é "chamada em loop", mas parametrizar as partes variáveis. Recomenda-se dividir um vídeo de produto em três camadas:
- Camada imutável: tom da marca, proporção da imagem, elementos proibidos, escritos em um prefixo de prompt unificado.
- Camada variável: nome do produto, argumentos de venda, descrição de cenário, injetados linha a linha a partir da tabela de dados de produto.
- Camada de pós-processamento: abertura e encerramento, legendas, marca d'água; recomenda-se sobrepor após a geração, evitando consumir duração repetidamente a cada geração.
Usar filas para impulsionar tarefas em lote; a falha de uma tarefa individual não deve bloquear o lote inteiro; cada registro deve salvar prompt, identificador do material de entrada e endereço de saída, para rastrear qual versão de material teve melhor resultado.
Critérios de aceitação
A aceitação da produção em lote deve ser quantificável: o sujeito do produto é reconhecível, há deformações evidentes, aparecem textos corrompidos indevidos na imagem, a duração atende aos limites da plataforma de veiculação. Recomenda-se rodar primeiro um pequeno lote com inspeção manual, confirmar a estabilidade do template de prompt e só então liberar o volume.
Cenário 2: Image-to-video para dar movimento a materiais estáticos
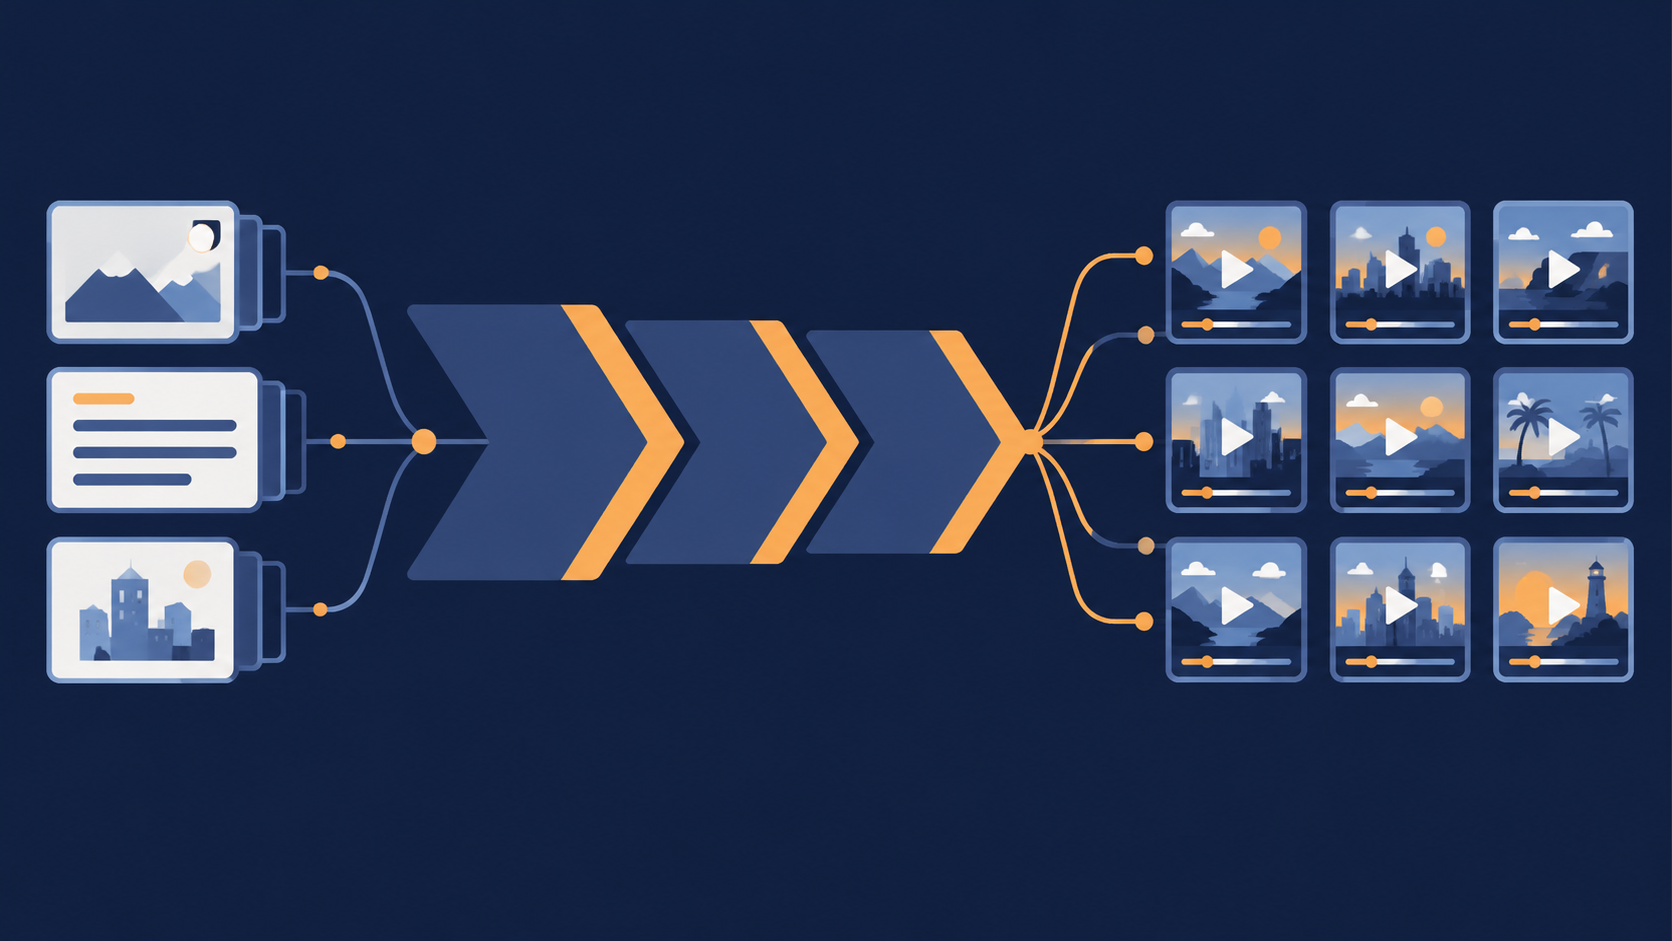
Muitas equipes não têm material de vídeo, mas acumulam muitos ativos estáticos: fotos de produto, ilustrações, pôsteres, capas de cursos, visuais principais de campanhas. Esses materiais naturalmente perdem no feed — imagens estáticas em feeds com reprodução automática costumam ser simplesmente ignoradas. Dar-lhes movimento é o tipo de uso com menor investimento e resultado mais rápido.
Onde está o valor
O benefício central da animação não é "ficar mais bonito", mas aumentar a retenção e o clique do material no feed. Um vídeo curto derivado da mesma imagem principal pode participar independentemente como um material de veiculação em testes AB, adicionando uma dimensão de teste sobre o mesmo ativo. Para negócios baseados em banco de imagens (e-commerce, conteúdo, educação), isso equivale a liberar novamente o valor residual de materiais históricos.
Pontos de atenção na implementação
- Amplitude de movimento contida. O ponto mais propenso a falhas no image-to-video é a amplitude excessiva distorcer o sujeito. O prompt deve explicitar qualificadores como "leve" e "lento", e descrever a fonte do movimento (deslocamento de câmera, variação de luz e sombra, flutuação de elementos locais), em vez de pedir genericamente "mexa-se".
- O primeiro quadro é a capa. No feed, o primeiro quadro do vídeo é o que se vê primeiro; ao escolher a imagem, deve-se filtrar por "esta imagem funciona sozinha como capa?", e não escolher uma imagem que só fica boa em movimento.
- Espaço negativo na composição. Se a imagem original é de composição cheia, após o movimento é fácil cortar informações das bordas; priorizar materiais com sujeito centralizado e margem ao redor.
Como avaliar o retorno
Recomenda-se avaliar por duas dimensões: "taxa de reuso de material" e "custo de teste por material": qual proporção de um lote de imagens existentes é adequada para animação, quanto o custo de geração de um material animado caiu em relação a refilmar. Uma vez confirmados esses dois números, equipes de banco de imagens costumam transformar isso em um processo regular de produção de materiais, e não em um experimento único.
Cenário 3: Adaptação de estilo e especificação de material via video-to-video
Quando uma equipe já tem um vídeo de material forte, a verdadeira questão costuma ser: como adaptá-lo a todos os canais. Horizontal para vertical, longa para curto, unificação de estilo visual, versões localizadas para diferentes regiões — tradicionalmente esse trabalho é feito editor por editor; o video-to-video transforma essa etapa em processamento em lote orquestrável.
Usos típicos
- Um master para vários canais: usar um filme principal como fonte, produzir em lote versões adaptadas a diferentes posicionamentos, preservando o ritmo e a estrutura narrativa do original, alterando apenas proporção e centro de gravidade da composição.
- Unificação de estilo: alinhar materiais históricos de tom inconsistente ao estilo atual da marca, reduzindo a fragmentação visual no banco de materiais.
- Adaptação de especificação: reescrever uniformemente para atender requisitos de duração, formato e resolução de diferentes plataformas.
Restrições a confirmar antecipadamente
A saída do video-to-video é a mais restrita pelo vídeo de origem: duração, complexidade de movimento e qualidade de imagem do original se propagam para a saída. Portanto, antes de ir ao ar, é preciso definir claramente os requisitos de negócio para limite máximo de duração da saída e formato, e só então decidir como cortar o original. Especialmente ao converter longa em curta, recomenda-se fazer um corte bruto no lado do original, em vez de entregar o filme inteiro ao modelo para ele decidir — o modelo não entende seu foco narrativo.
Design de processamento em lote
Abstrair uma conversão como uma tripla "ID do original + especificação alvo + instrução de estilo" e registrá-la em uma tabela de tarefas. Uma linha por canal de destino, resultados gerados nomeados e arquivados por canal. Assim, adicionar um canal é apenas acrescentar uma linha de configuração, em vez de refazer todo o fluxo de edição. Ao mesmo tempo, manter a correspondência entre original e saída, para localizar qual tipo de reescrita causou problema quando o canal reportar resultado insatisfatório.
Cenário 4: Produção rápida de demonstrações de produto e prévias de funcionalidades
Equipes de SaaS e ferramentas têm uma dor de longa data: a cada lançamento é preciso produzir vídeo de demonstração, mas o material de gravação de tela costuma esperar o produto estabilizar, o roteiro espera aprovação de marketing, e no fim o lançamento é atrasado pelo vídeo. O modelo de vídeo pode comprimir a primeira versão de um "vídeo de demonstração" de dias para horas.
Fluxo recomendado
- Dividir o roteiro em tomadas: dividir uma demonstração de produto em várias tomadas de cerca de 5 segundos, cada tomada correspondendo a um ponto de funcionalidade ou um cenário de uso. A tomada é a chave desta etapa, pois o modelo controla conteúdo de tomadas curtas claramente melhor que narrativas longas.
- Gerar misturando texto e imagem: funcionalidades abstratas (como fluxo de dados, processos de colaboração) com text-to-video para gerar imagens conceituais; interface real e forma do produto com image-to-video, usando capturas de tela ou designs como âncora, garantindo que a imagem do produto apresentada externamente não saia distorcida.
- Montagem e dublagem: os clipes gerados são montados na pós-produção, com narração, legendas e transições. Não buscar "tudo em um único take" na fase de geração, pois é difícil de controlar e caro.
Revisão humana indispensável
A primeira prioridade do vídeo de demonstração de produto é não enganar o usuário. As imagens geradas pelo modelo podem apresentar botões inexistentes, layout de interface errado ou funcionalidades fictícias. Portanto, cada versão de clipe gerado deve passar por revisão humana do lado do produto, confirmando que os elementos presentes na imagem existem no produto real ou estão claramente marcados como ilustrativos. Recomenda-se incluir a "verificação de elementos da imagem" como item de checagem fixo, e não apenas um olhar casual durante a edição.
Limites de aplicação
Este caminho é adequado para prévias de funcionalidades, demonstrações conceituais, materiais de contagem regressiva de lançamento e vídeos de relatórios internos; não é adequado para tutoriais que exigem reprodução precisa de passos de operação. Conteúdo de tutorial deve continuar baseado em gravação de tela real, com geração por modelo apenas para embalagem e transições.
Cenário 5: Materiais dinâmicos e experimentos criativos para plataformas de conteúdo
A necessidade de equipes de conteúdo e crescimento difere das quatro categorias anteriores: elas não precisam de um bom material, mas de muitas direções testáveis. A cobrança por segundo do modelo de vídeo combina exatamente com esse ritmo de tentativa e erro em pequenos lotes — clipes curtos, muitas direções, descarte rápido.
Fazer do experimento um ciclo fechado
Um processo sustentável de experimentação criativa costuma ser assim: a partir de um tema ou tendência, gerar de uma vez vários clipes curtos, cada um representando uma direção visual ou ângulo narrativo diferente; após a veiculação, observar o desempenho inicial dos dados, manter as direções promissoras para iterar e descartar as demais. O ponto-chave é que o lote de cada rodada seja pequeno e cada clipe seja curto, tornando o custo de tentativa e erro por rodada baixo o suficiente para repetição de alta frequência.
Três sugestões de engenharia
- Variável fixa: em uma rodada de experimento, alterar apenas uma dimensão (estilo visual, forma de abertura ou ritmo), caso contrário os dados não permitem atribuição.
- Registrar prompts: arquivar prompt e parâmetros de cada clipe, para reproduzir quando o resultado for bom e descartar quando for ruim.
- Priorizar clipes curtos: na fase de experimento, gerar com duração curta; após validar a direção, alongar e ampliar a direção vencedora.
Adequado e inadequado
Adequado para ganchos de abertura, clipes de atmosfera, visuais de tópicos, animação de capa; inadequado para conteúdo longo que exige narrativa contínua. Posicionar o modelo como "sonda criativa" e não como "linha de produção de conteúdo" torna as expectativas e critérios de aceitação da equipe mais saudáveis.
Estimação de custos e estratégia de chamadas sob cobrança por segundo
A métrica de cobrança do modelo de vídeo é por segundos de saída, o que significa que o custo está diretamente ligado a "duração × quantidade". O preço unitário específico deve ser consultado no painel de preços do site; aqui tratamos apenas do método de conversão e dos meios de controle.
Converter a cobrança em custo por item de negócio
A fórmula de conversão é simples: custo por item = segundos de saída × preço unitário por segundo. Sobre isso, multiplicar pelos fatores do lado do negócio — um material de veiculação geralmente precisa de várias versões para teste AB, o custo real é "custo por item × número de versões × rodadas de iteração". O que a maioria das equipes subestima são justamente os dois últimos multiplicadores: a geração repetida antes da definição do efeito costuma custar muito mais que os poucos itens finais entregues.
Quatro alavancas de controle de custos
- Comprimir duração: validar a direção com clipes curtos primeiro, gerar a duração completa após a definição. É o meio mais eficaz de economizar, pois o custo é linear em relação à duração.
- Controlar iteração: polir o template de prompt em pequenos lotes até estabilizar, e só então ampliar. Geração em lote com template instável é quase desperdício puro.
- Faseamento: permitir divergência na fase de exploração, fixar parâmetros na fase de produção. As duas fases usam tamanhos de lote e critérios de aceitação diferentes.
- Calcular concorrência: o limite de concorrência de tarefas em lote deve ser definido junto com o teto de orçamento, estabelecendo um limiar de custo por lote; ao ultrapassar, pausar e confirmar manualmente, evitando que o script dispare.
Definir estratégia de chamadas
Recomenda-se tornar "duração" e "quantidade" itens configuráveis no código de negócio, em vez de fixos. Assim, quando o orçamento de veiculação apertar, basta ajustar a configuração para reduzir o custo por lote, sem alterar código. Ao mesmo tempo, registrar em log a duração e a quantidade de cada chamada, formando uma fatura de custos consultável, facilitando a alocação por projeto ou canal.
Solução de problemas de integração e checklist pré-lançamento
Falhas em interfaces de vídeo muitas vezes não são "erros", mas "lentidão" e "instabilidade". Passar pelos pontos abaixo antes do lançamento evita a maior parte dos problemas em produção.
Modos de falha comuns
- Timeout: a geração de vídeo leva claramente mais tempo que texto e imagem, e o timeout padrão do cliente facilmente não é suficiente. Deve-se definir o timeout da requisição em uma ordem compatível com a duração do vídeo e adotar o modelo de tarefa assíncrona + polling, em vez de espera síncrona.
- Envio duplicado: retentativas automáticas sob oscilação de rede podem causar geração duplicada, ampliando diretamente o custo. Gerar uma chave de idempotência para cada tarefa e deduplicar no servidor pela chave.
- Conteúdo não conforme ou inutilizável: a saída pode apresentar deformação do sujeito, texto corrompido, imagens que não atendem ao negócio. Esses problemas não lançam exceção, só podem ser barrados na etapa de aceitação.
- Problemas no material de entrada: imagem de referência de baixa resolução ou composição muito cheia no image-to-video, taxa de bits insuficiente no original do video-to-video, tudo isso degrada visivelmente a qualidade da saída. O lado do material deve validar antes de entrar na fila.
Design de timeout, retentativa e degradação
A retentativa deve ter limites: apenas para erros de rede claros e 5xx, com número máximo e intervalo de backoff; para falhas de conteúdo, não fazer retentativa automática, encaminhar para humano. O plano de degradação deve ser pensado antecipadamente — em caso de falha de geração, reverter para material estático, reverter para a última versão disponível, ou simplesmente pular a tarefa; a resposta varia por linha de negócio, mas todas devem ser definidas na fase de design.
Checklist pré-lançamento
- A cadeia de tarefas assíncronas está completa: submissão, polling, timeout, idempotência, persistência de resultados.
- Duração e quantidade são configuráveis, há limiar de custo por lote.
- Os materiais de entrada passaram por validação de resolução e formato.
- A saída tem etapa de aceitação humana ou automática, com critérios quantificados.
- Os logs registram prompt, parâmetros, duração e status da tarefa, permitindo rastreamento.
- O caminho de degradação foi ensaiado, não apenas escrito na documentação.
Usar este checklist como portão de lançamento torna o ritmo de implementação de funcionalidades de vídeo muito mais estável do que corrigir enquanto roda. Para conhecer melhor os limites de capacidade do flux-3-video, pode-se primeiro executar uma cadeia mínima na página do modelo e depois expandir camada por camada conforme os cenários acima.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado